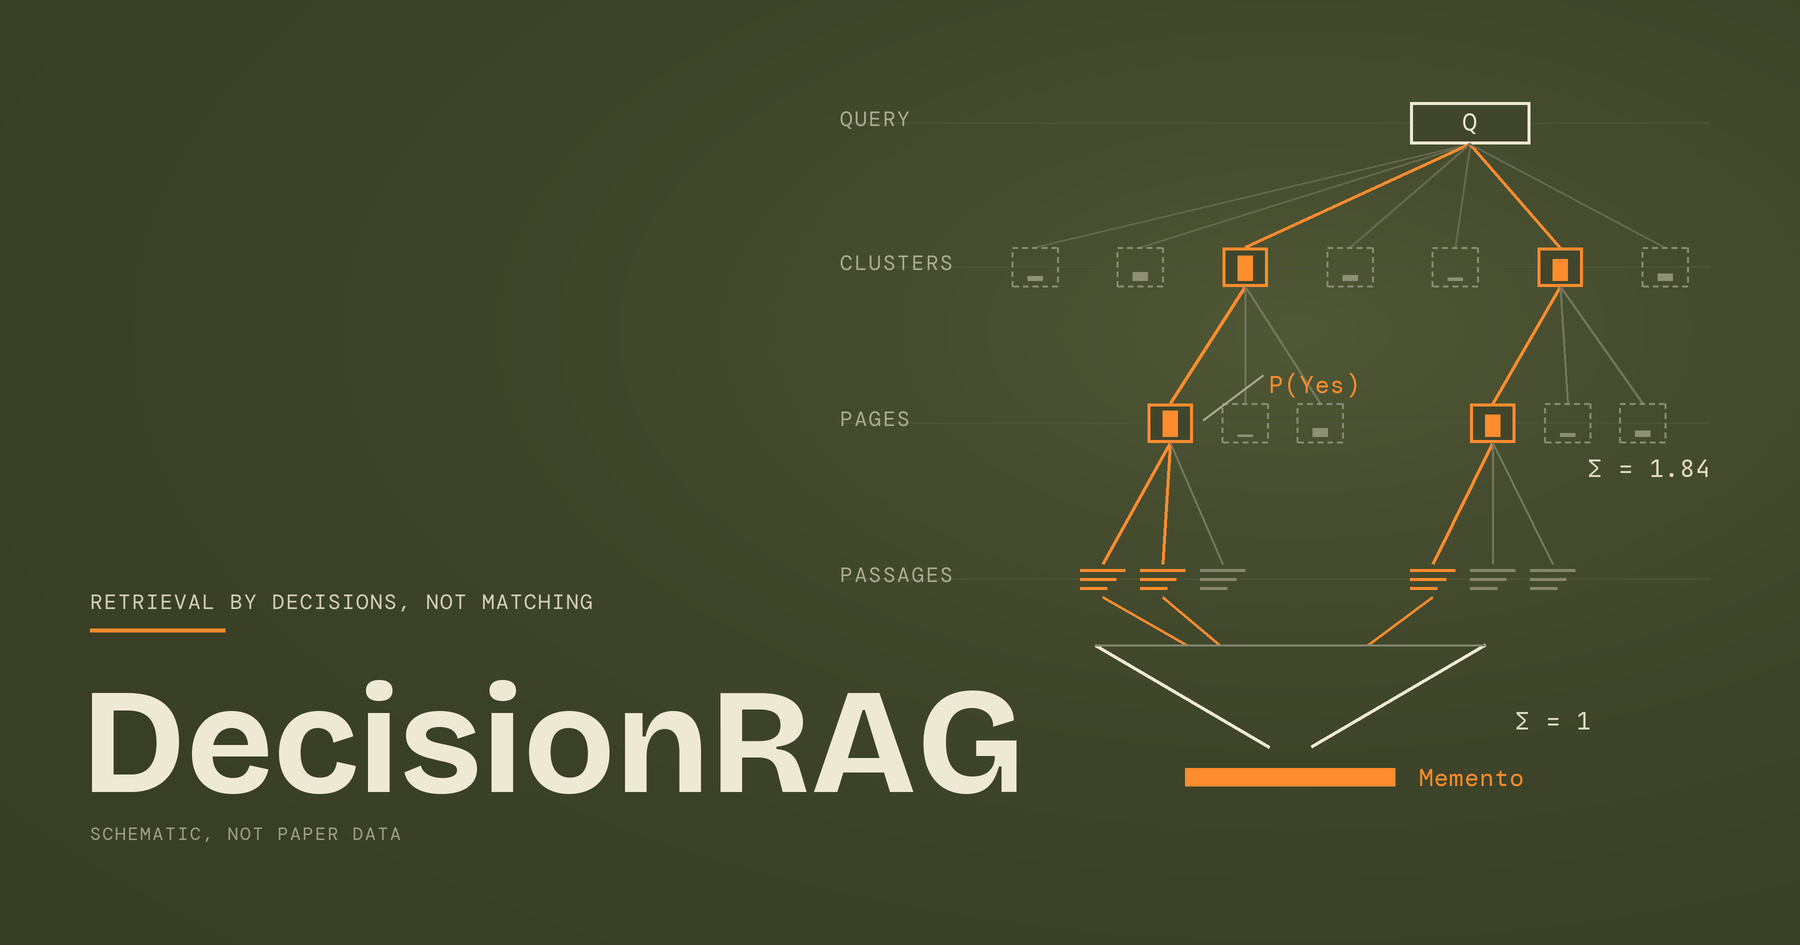
RAG 的生成模型越換越強,決定它看到什麼的檢索器卻還是 BM25。DecisionRAG 把語料整理成一棵樹,讓決策模型一層層出是非題、只留值得翻的分支:準確度和「向量檢索 + GPT-5 重排」大約打平,延遲快一個數量級。本文拆解機制、實驗與該打折的地方。
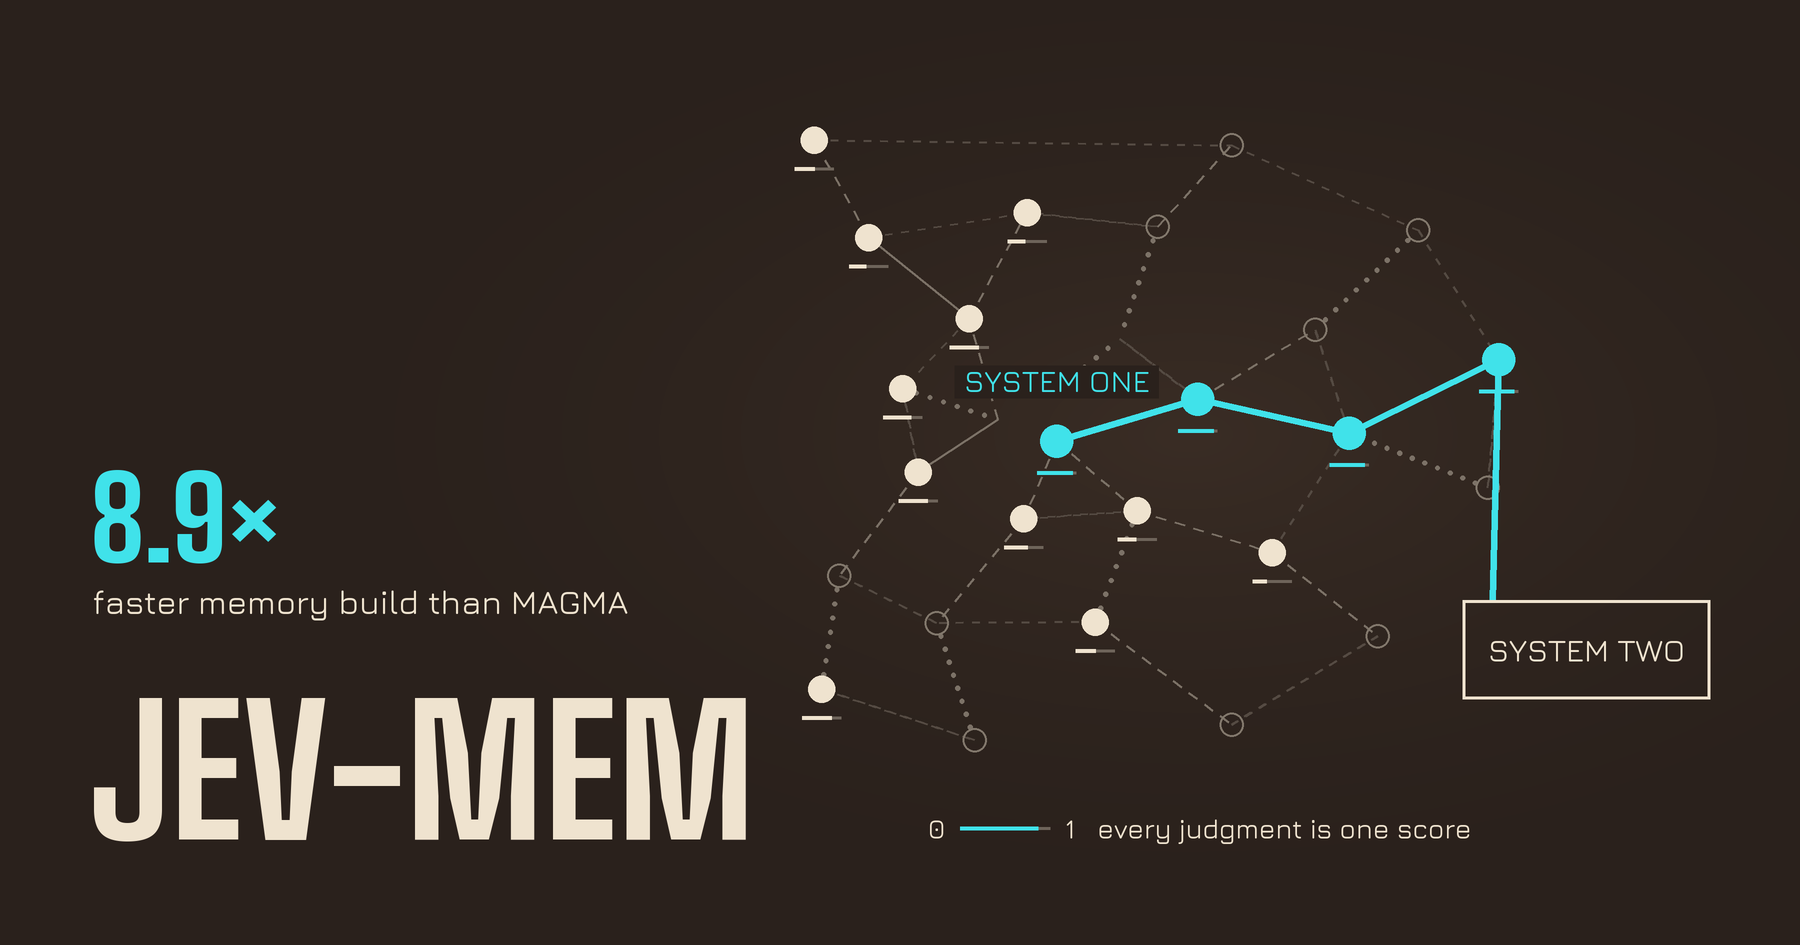
有長期記憶的 AI agent,每存一句、每答一題都要做一串小判斷。Jev-Mem 把它們全交給只輸出 0 到 1 分數的小模型 Jev,大 LLM 只寫答案。和同一組作者先前的記憶系統 MAGMA 比,建構快約 8.9 倍、延遲少 37%,準確度提升大半來自對抗題;本文拆解記憶圖、寫入、讀取、停止規則與通用技巧 RRF。
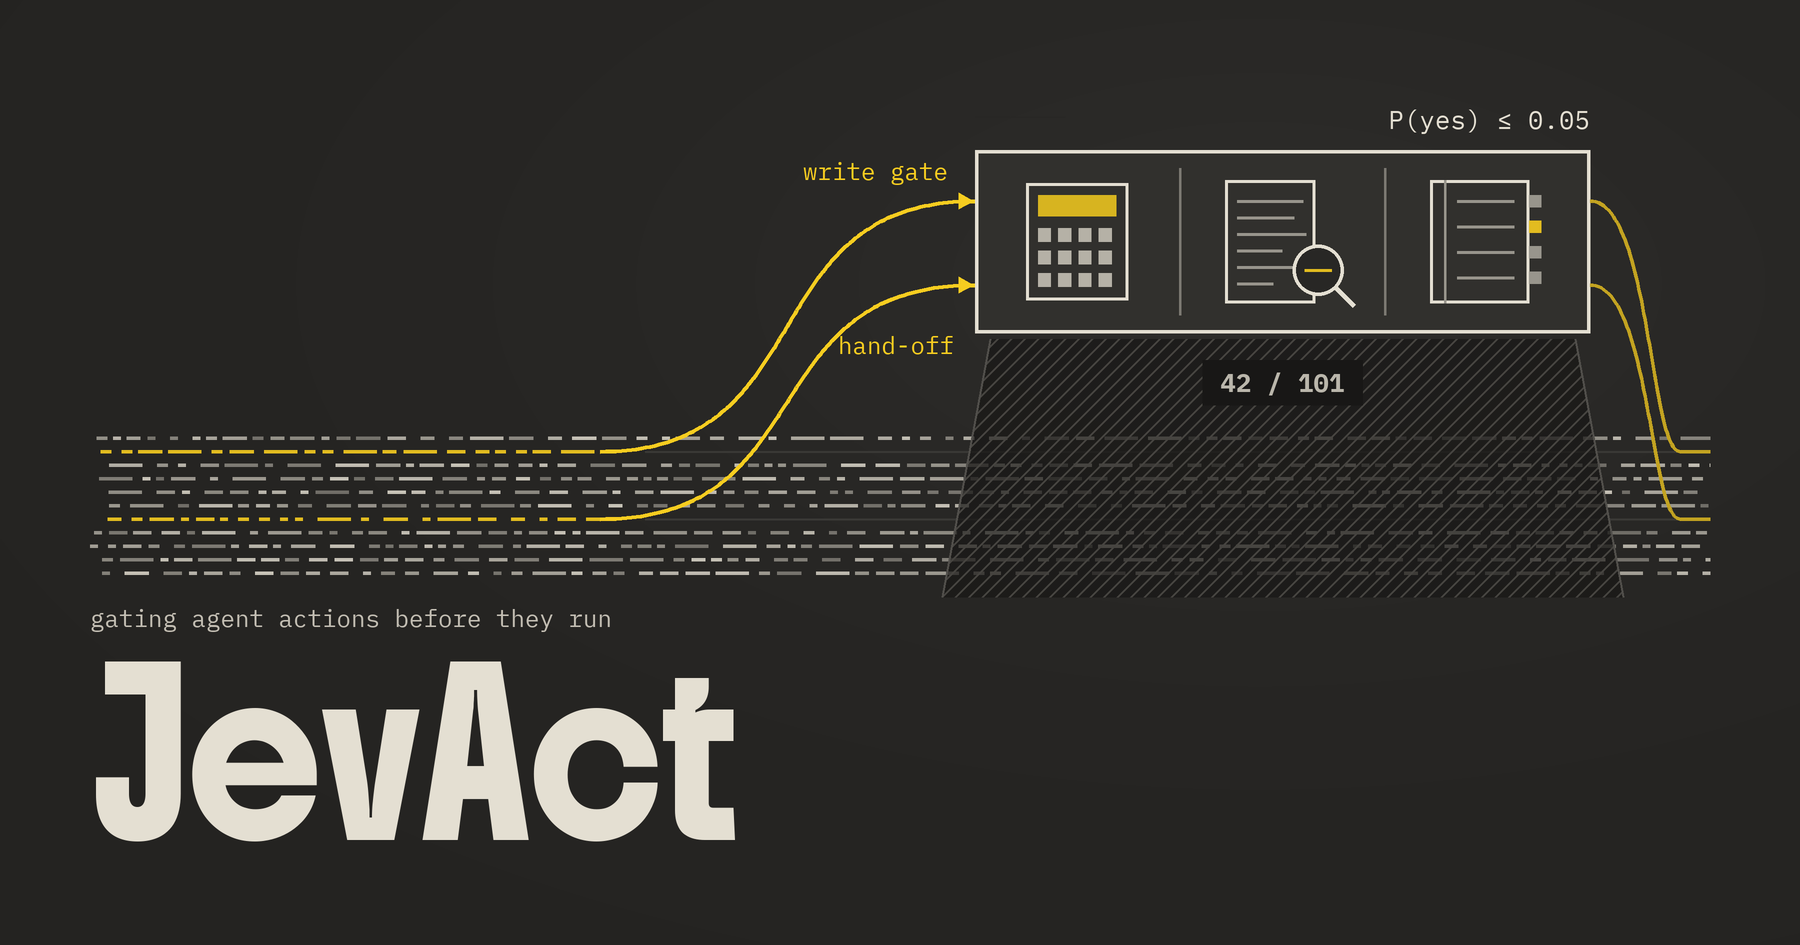
LLM agent 最怕訂錯票、太早放棄。IBM 的 JevAct 在 agent 執行前加一道閘門:把政策事先編成程式檢查與 yes/no 題,交給便宜的 Kev 決策模型判斷,只在有把握時擋下。本文拆解它的機制,以及實驗裡增益多來自程式、101 個錯誤呼叫有 42 個抓不到的真相。
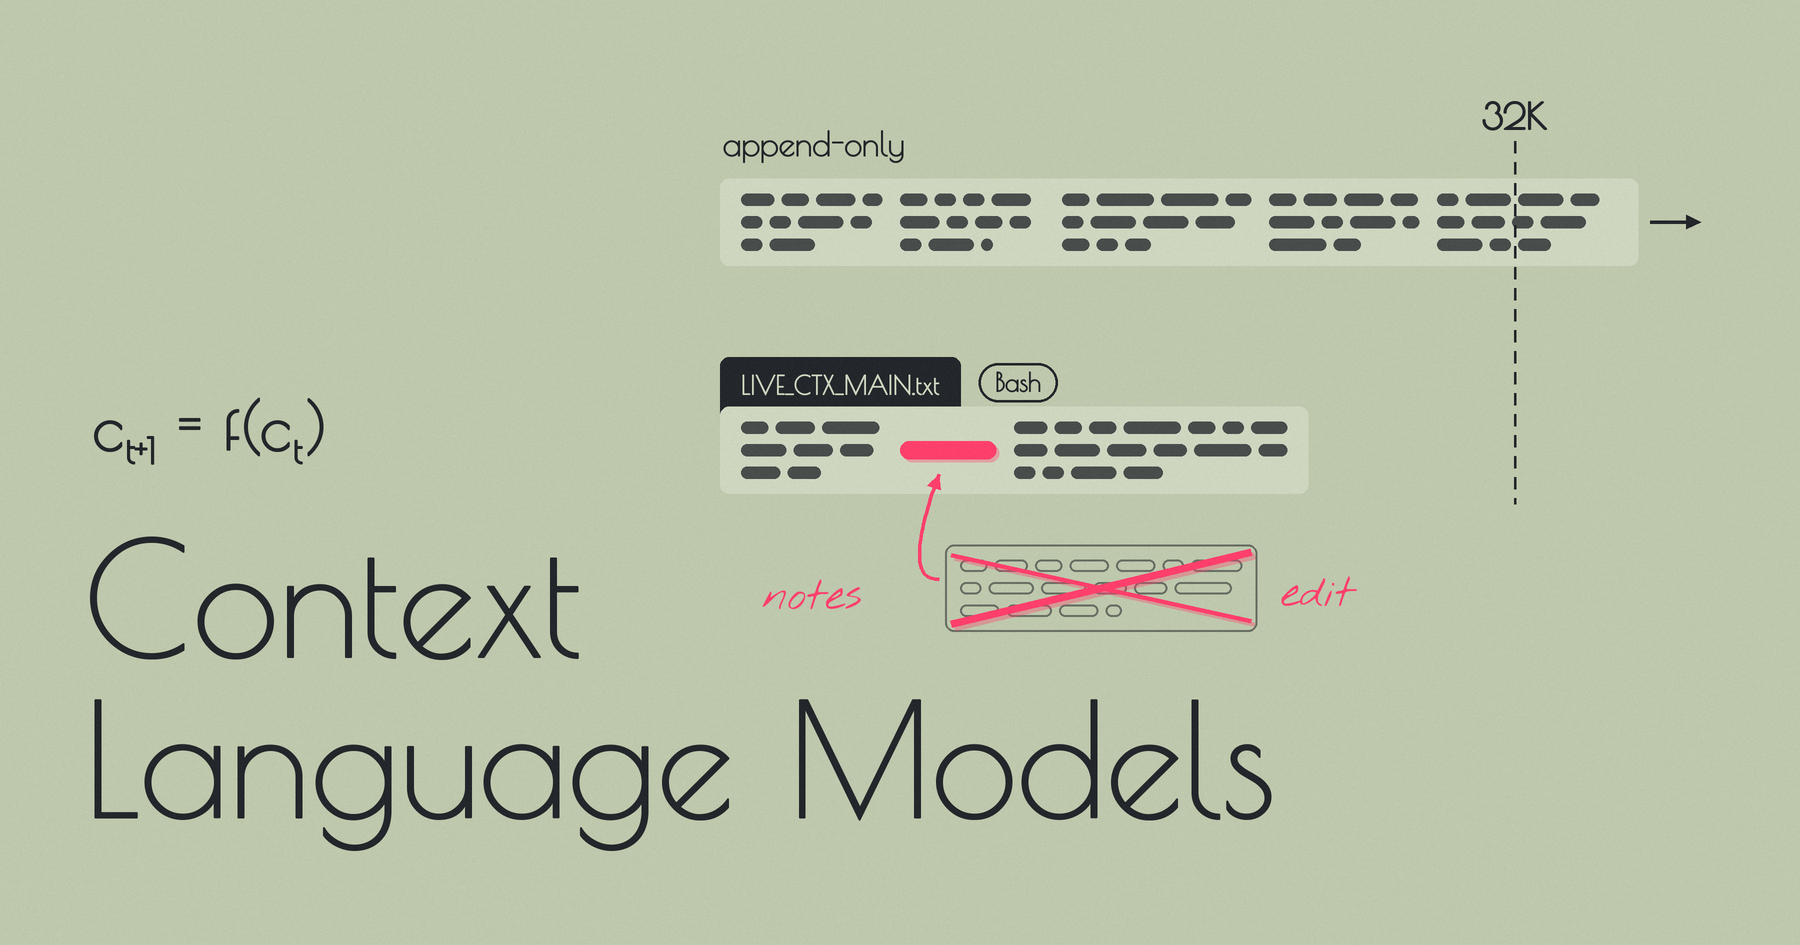
LLM agent 跑久了 context 一定會爆,多半由 harness 用固定規則摘要。Context Language Models(CLM)把模型的 context 鏡像成一個檔案,讓模型用 Bash 想改哪裡就改哪裡。32K 的緊預算下,27B 現成模型零樣本就以較低成本達到相當或稍好的準確率;但論文摘要的大數字多是相對值,本文逐項換回絕對值。
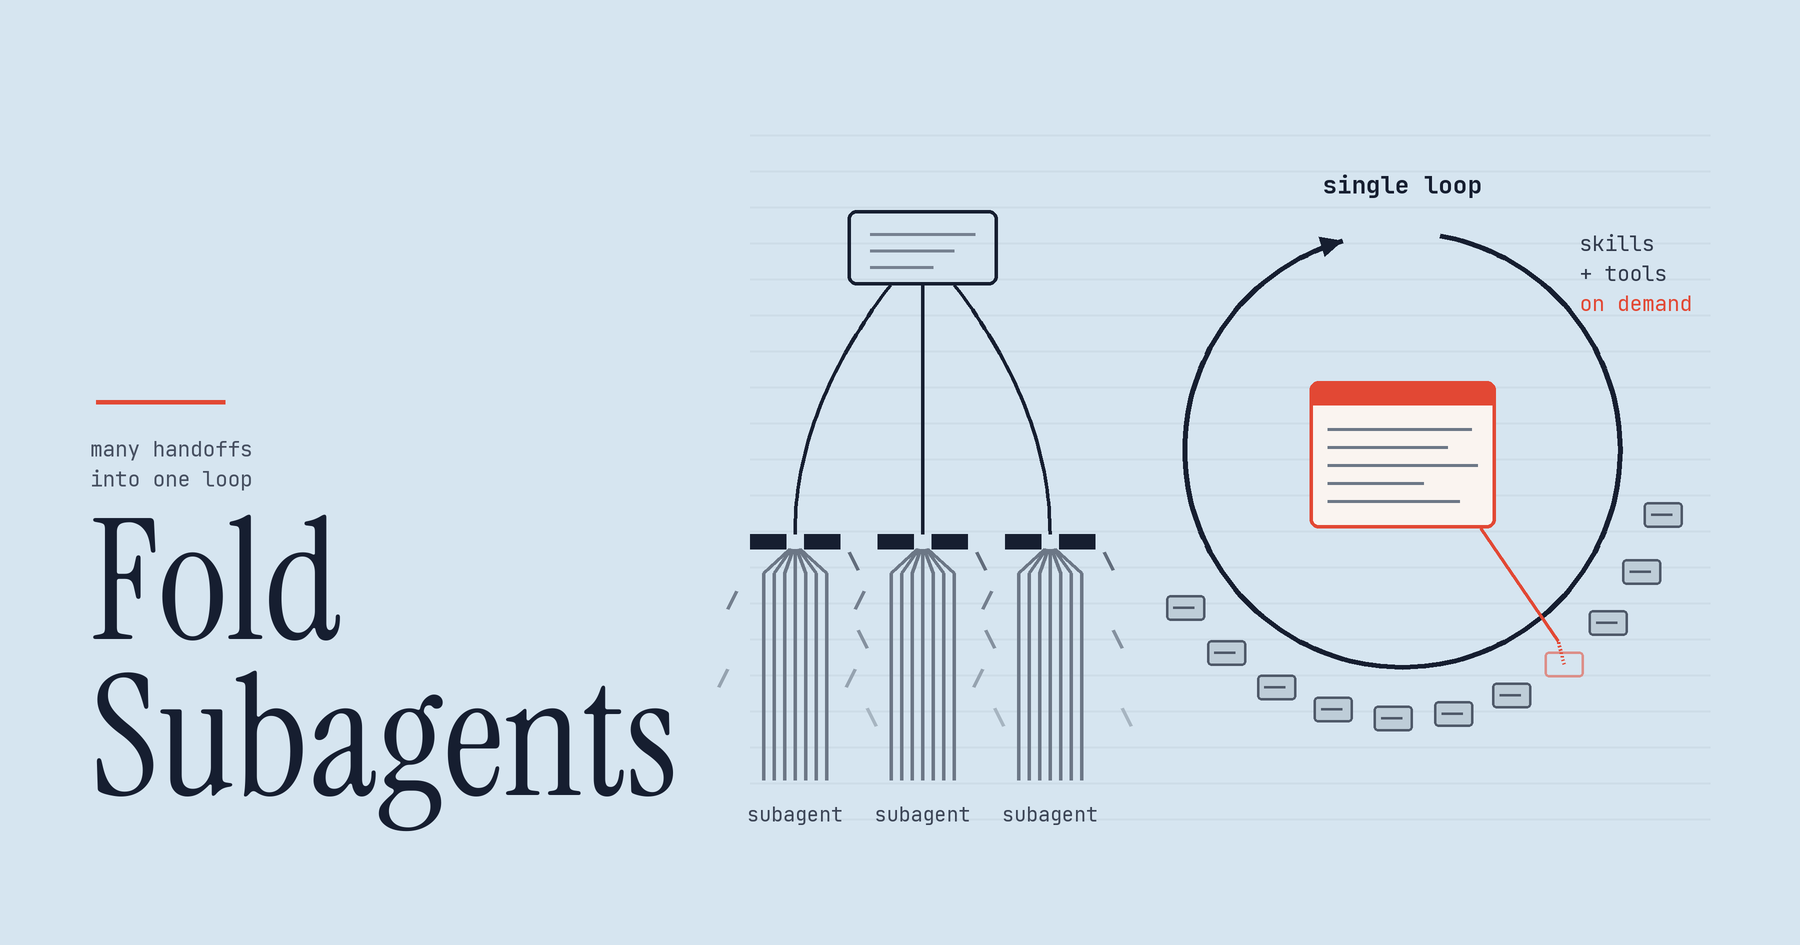
企業 agent 常是每個團隊一個 subagent,再疊一個 orchestrator,但每次交接都是一次有損摘要。整理 Anthropic 的做法:單一 agent loop 搭配按需載入的 skills 與 tools、用 eval 分階段折疊,以及 Conway's law 為什麼讓 agent 長成組織圖。
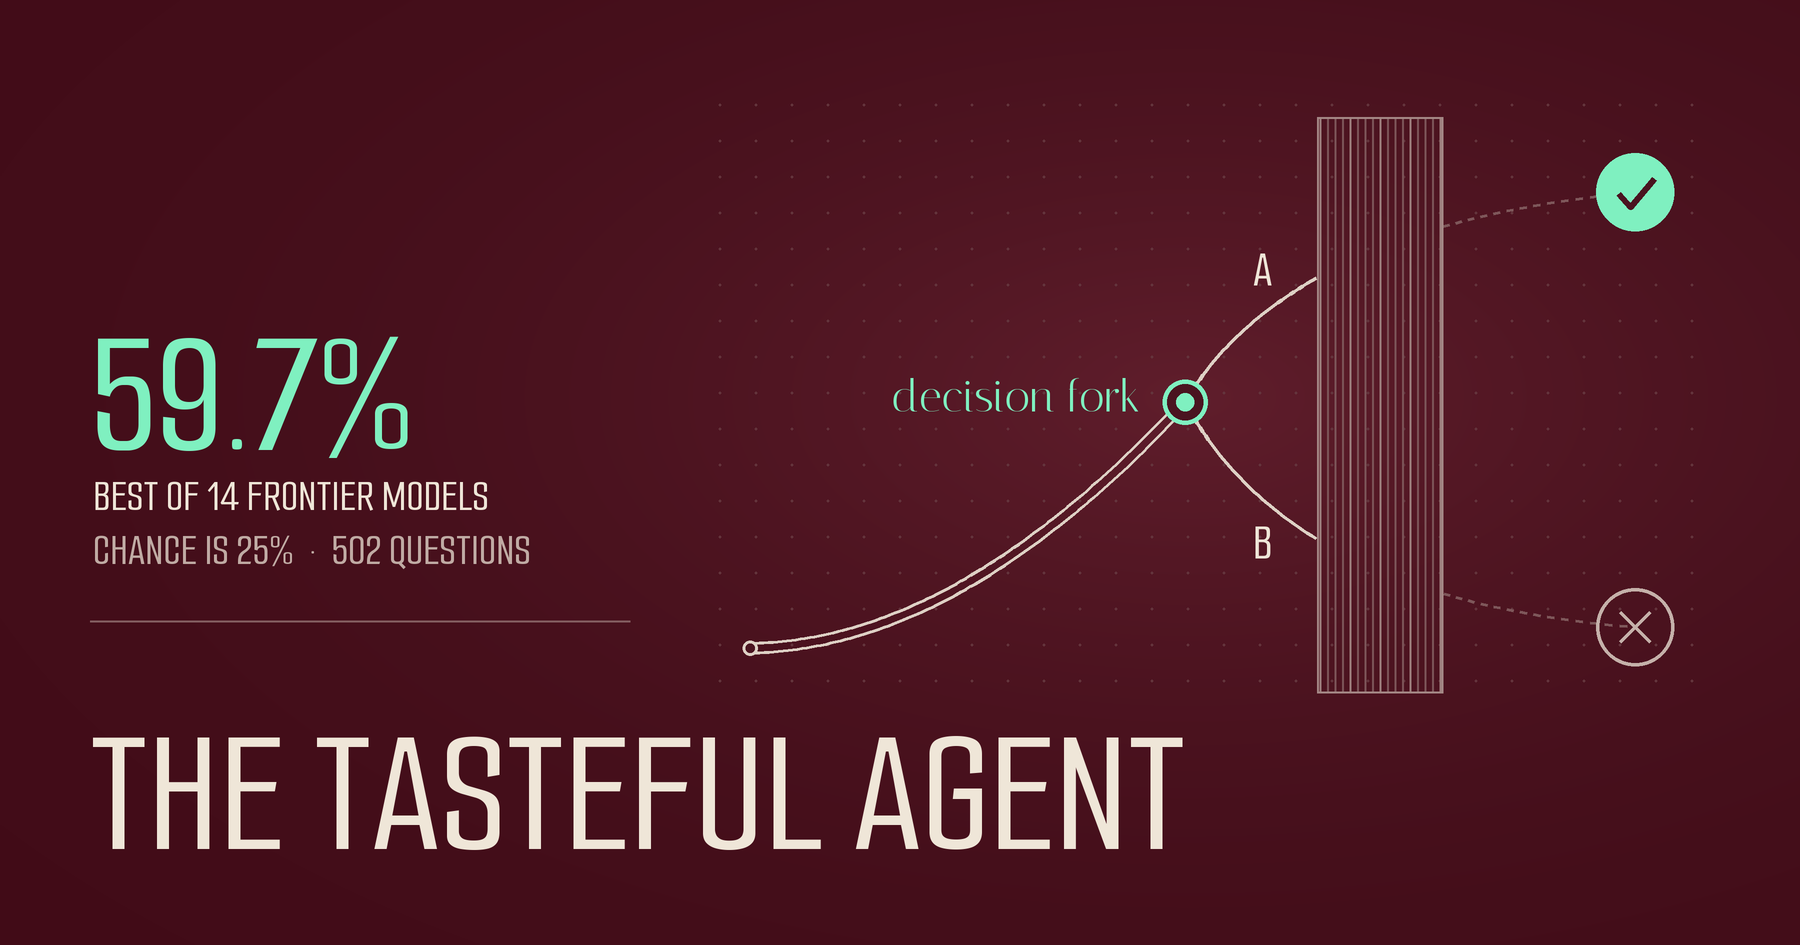
LLM agent 做長任務時,成敗常取決於中途的決策,評測卻只看最後有沒有做完。The Tasteful Agent 把同一任務分歧的嘗試變成二選一考題,造出 502 題 Taste-Bench:14 個前沿模型最高只有 59.7%,隨機猜是 25%;把偷看答案的老師蒸餾給學生,準確率從 30.0% 升到 47.9%。
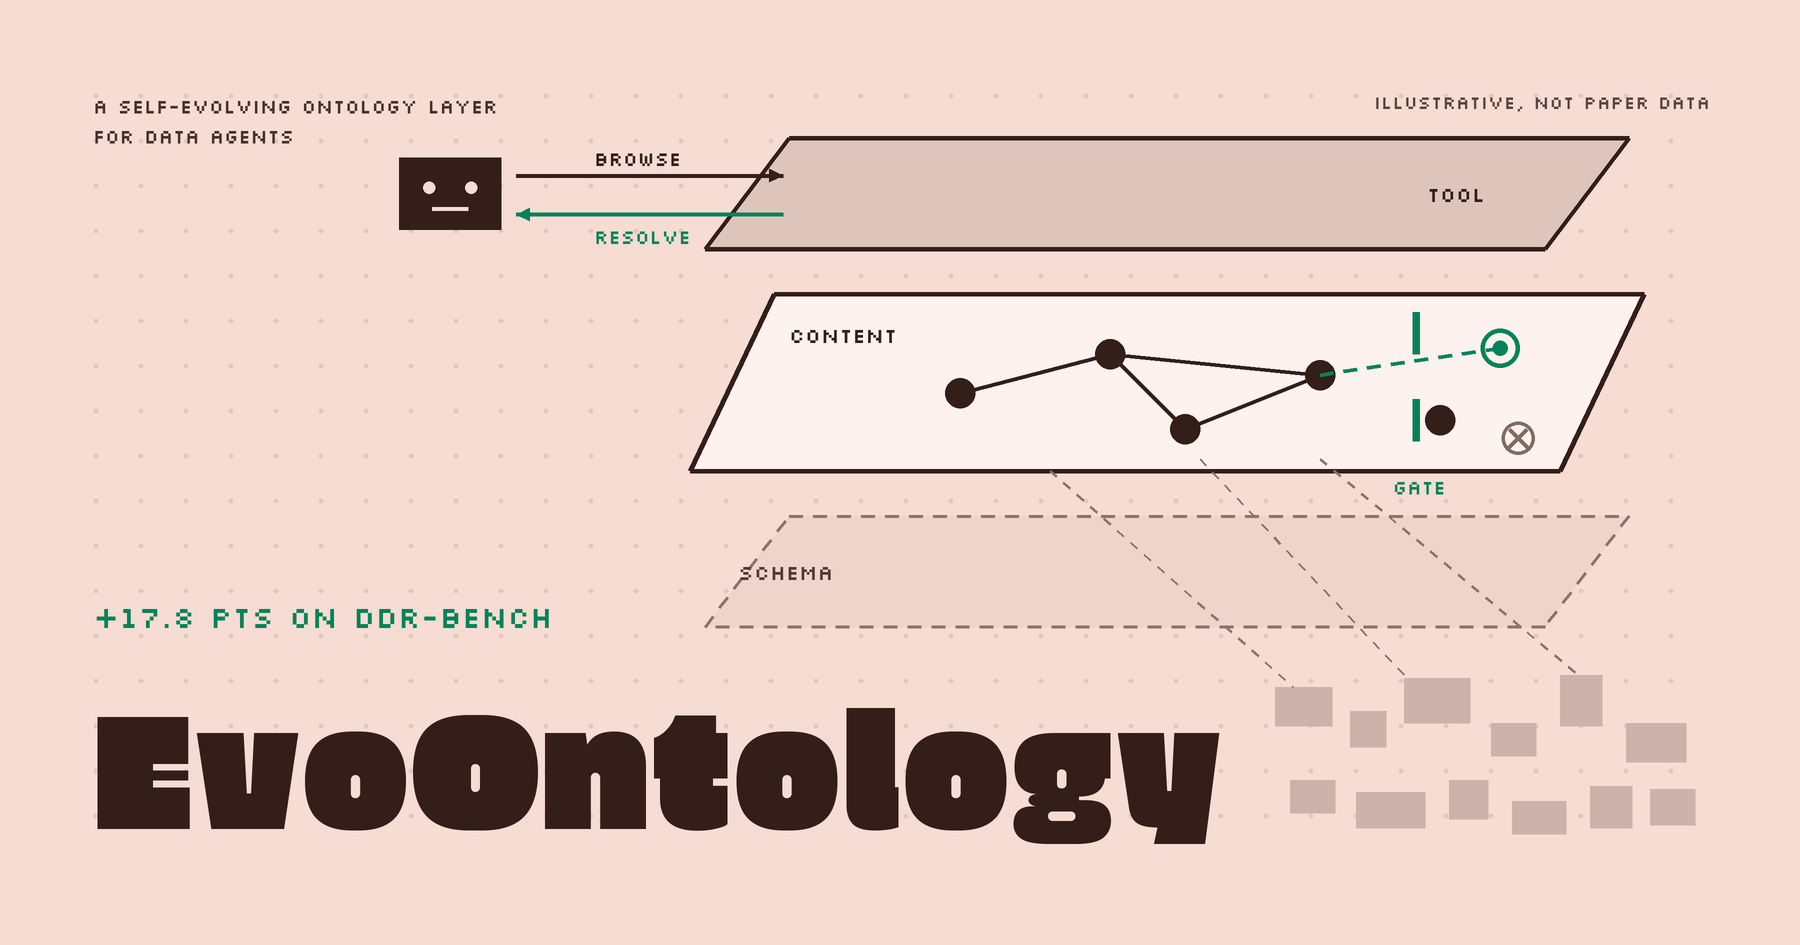
data agent 每次任務都得重新摸索資料長什麼樣子。EvoOntology 在 agent 與資料之間加一層可查詢、會自我修補的 ontology:DDR-Bench 六個 backbone 平均 +17.8 分,把 semantic layer 整包塞進 prompt 反而退步,但換模型就得重新演化。