使用機器學習解決問題:探索書籍風格
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
這篇是「機器學習基礎觀念」系列的第 9 篇。前一篇我們用機器學習五步驟(定義問題、建立資料集、模型訓練、模型評估、模型推論)走完「房價預測」這個例子,而房價預測是典型的監督式學習(Supervised Learning):每一筆資料都有正確答案,模型照著答案學就好。
這篇要換一種情境。同樣是那五個步驟,但這次手上完全沒有標準答案,要解的是「探索書籍風格」——把一批書籍的摘要丟進模型,讓模型自己找出哪些書調性相近。這屬於非監督式學習(Unsupervised Learning)中的分群(Clustering)任務,也是實務上很常遇到的一類問題:你知道資料裡有結構,但你事先講不出那個結構長什麼樣子。
2 步驟 1:定義問題
假設你是一間大型書店的店長,想搞清楚過去一年賣出去的書到底是什麼調性。每本書當然都有既定的分類,像是英文證照、程式語言、自然科學,但這種分類太粗了,你想知道的是更細的東西:同樣掛在「程式語言」底下,客人買的是入門教學,還是進階的架構設計?
如果去年生意很慘只賣出 10 本書,那好辦,毛起來把這十本讀完就知道客人的口味。問題是銷量破 1000 本的時候怎麼辦?沒有人讀得完。這正是機器學習派得上用場的地方——讓模型幫你把這 1000 本書的潛在風格整理出來。
做法是這樣:假設每本書都附有摘要,摘要大致能概括書的內容,我們就把這 1000 份摘要輸入模型,讓模型根據摘要探索其中的風格,把風格相近的書歸在同一個群組。
這裡有兩個關鍵字要先釘下來,因為它們決定了後面要挑什麼模型:
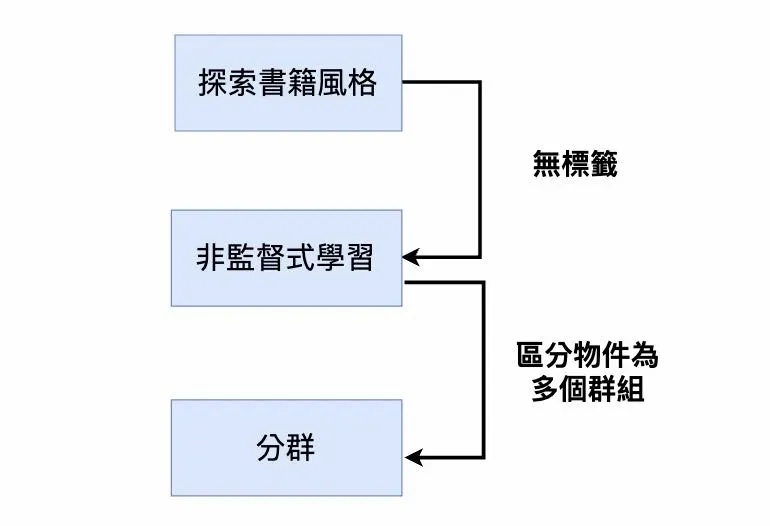
- 非監督式學習:整個過程中我們只輸入摘要,並沒有事先替每份摘要標好「這本是硬派技術書」、「這本是輕鬆科普」。風格是模型自己摸索出來的。因為沒有提供正確答案(標籤)給模型,所以屬於非監督式學習。
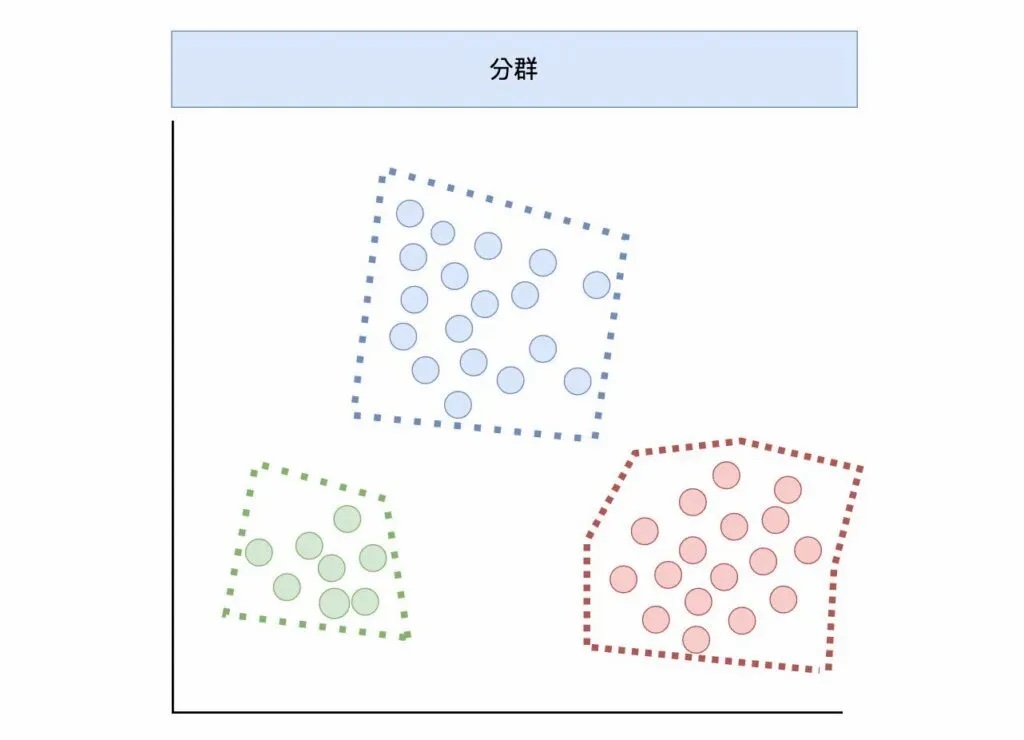
- 分群(Clustering)任務:模型要做的是找出書籍與書籍之間的潛在關係,把關係較接近的書歸在同一個群組,這就是分群。
3 步驟 2:建立資料集
問題定義完,接著是把資料準備好。這個階段大致可以拆成以下幾個部分:
收集資料(Data Collection) 方法相當多元,可以聘請工讀生把每本書的摘要在電腦上打出來,或是以爬蟲的方式到網路上把這些摘要抓回來。
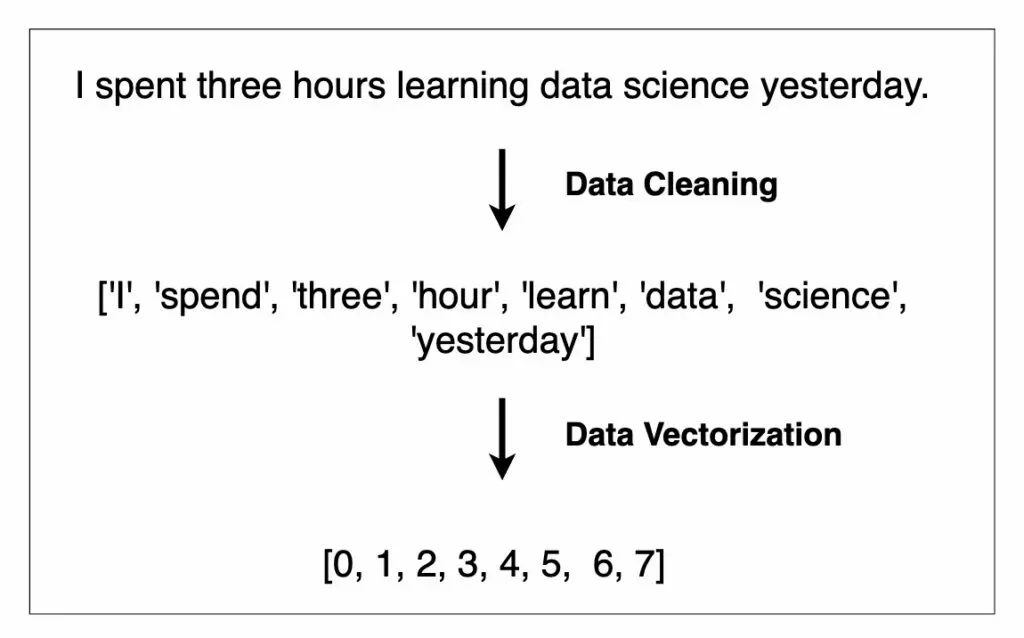
資料探索(Data Exploration)與資料清理(Data Cleaning) 這個階段要深入理解收集到的資料,並把它處理成適合輸入模型的形式。我們手上的資料是「摘要」,由許多句子組成,而句子裡往往夾著一堆對判斷風格沒有幫助的元素,可以先剔除掉。以英文語句來說,常見的處理有:
- 刪除標點符號(
,.!?) - 刪除不重要的字詞(a、an、the)
- 將大寫轉為小寫(White => white)
- 將動詞的時態統一轉為現在式(did => does)
清理完之後還有最後一道手續:模型吃不下文字,必須把資料由「字串類型」轉為「數值類型」才能輸入模型,這個過程稱為 Data Vectorization。
- 刪除標點符號(
4 步驟 3:模型訓練
資料集備妥後,就進入模型的建立與訓練階段。在第一步我們已經確認「探索書籍風格」屬於分群問題,而解決分群問題最常見的模型就是 K-Means。K-Means 的數學原理不在這篇的範圍內,這裡先掌握它做的事情是什麼就夠了。
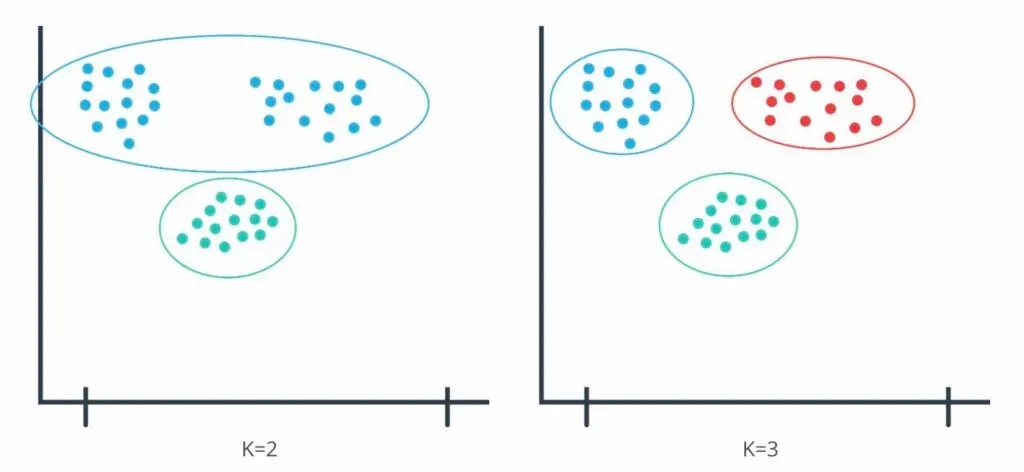
如上圖所示,每一個點都代表一本書籍的摘要(也就是前面 Data Vectorization 之後的數值向量),透過 K-Means 模型可以把這些點分成多個群組。K-Means 名字裡的 k 就是「要分成幾群」:指定 k=2 時會把所有點分成兩群(如上圖左),設定 k=3 時則分成三群(如上圖右)。
換句話說,k 是我們要自己決定的參數,而模型的分群結果好不好,很大一部分就取決於這個 k 選得對不對。
5 步驟 4:模型評估
k 該設多少?這就是模型評估階段要回答的問題。我們希望找到最適合的 Cluster 數目,使得所有風格類似的書籍都能被歸到同一個群組——分得太少,不同調性的書會被硬塞在一起;分得太多,同一種風格又會被切得零零碎碎。
評估分群品質有多種統計指標(metrics),這裡使用的是 silhouette coefficient。它衡量的是「每個點跟自己群組內其他點有多接近,相對於跟隔壁群組有多接近」,數值越高代表分群分得越乾淨。
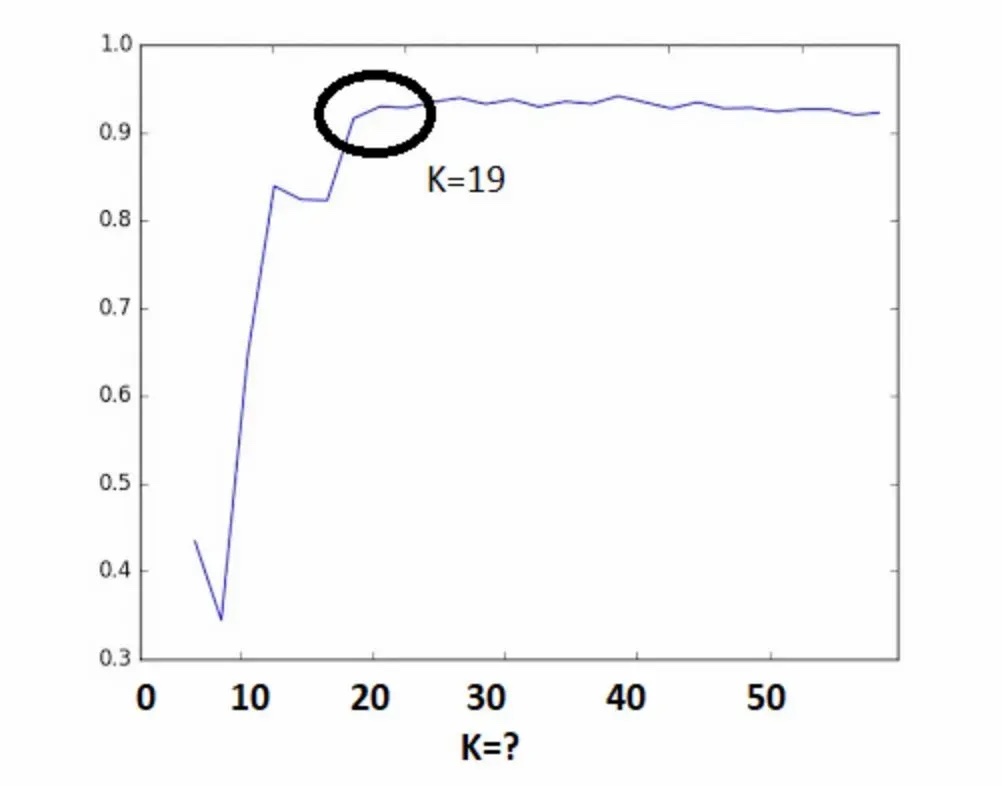
把不同的 k 值各跑一次、各算一次 silhouette coefficient,就能看出模型在哪個 k 下表現最好。以上圖這個例子來說,最佳的 k 值為 19。
找到最適合的 k 之後,接著就可以去觀察最大的 Cluster,也就是包含最多樣本(書籍)的那一群。翻一翻該 Cluster 裡的書籍摘要,就能具體看出最熱門的書籍風格到底是什麼樣子——這才是店長真正想要的答案。
6 步驟 5:模型推論
最後一步是實際使用這個模型。輸入一份新的書籍摘要,看看它被分到哪一個 Cluster,你就知道這本新書跟過去哪一批書調性相近。
反過來用也很有價值:挑一個 Cluster,把裡面的書籍摘要拿出來讀,理解同一群裡的書到底共享了什麼特質,才會被模型判定為同一種風格。分群模型不會幫你替每一群取名字,那部分的解讀還是得由人來做。
7 結論
這篇文章用機器學習五步驟走完了「探索書籍風格」這個非監督式學習的例子:從定義問題確認它是分群任務,到把文字摘要清理並向量化,接著用 K-Means 進行分群,再靠 silhouette coefficient 挑出最適合的 k,最後拿模型來解讀書籍風格。
跟前一篇的房價預測比起來,流程一模一樣,差別只在沒有標籤可用,因此模型與評估指標都得換一套。下一篇文章會介紹更厲害的模型(Neural Network),用來解決更困難的問題。