模型的估計誤差 (Estimation Error) 與近似誤差 (Approximation Error)
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
在「機器學習基本觀念:Bias-Variance Tradeoff」一文中,我們把機器學習模型的 Error 拆成 Bias Error 與 Variance Error 兩塊。模型的 Bias 很高時稱為 Underfitting,Variance 很高時則稱為 Overfitting。
這篇文章要換一個角度來看同一件事。同樣是「模型不夠準」,我們可以先問:這個誤差是因為模型架構本身就搆不到答案,還是因為訓練沒把模型帶到它該去的位置?前者叫近似誤差 (Approximation Error),後者叫估計誤差 (Estimation Error)。建議先熟悉 Bias-Variance Tradeoff 的概念再往下讀,兩者最後會接在一起。
2 訓練一個模型
先從一個大家都做過的流程開始。假設我們想要一個完美的模型,能夠 100% 準確地分類貓狗圖片,這是相當基本的二元分類問題,通常會用監督式學習的方式來訓練。
在訓練之前,我們得先建立一個模型。模型架構的設計因人而異,也許是 5 層 CNN 再接上全連接層。此時模型中的參數可能是隨機的,也可能是由某一個機率分佈初始化而來,無論是哪一種,這時候的模型都還沒有能力分辨貓和狗。
接著我們拿準備好的資料集開始訓練。訓練過程中,模型內部的參數不斷被調整,模型的 Error 也隨之下降。直到我們滿意為止,停止訓練,得到一個訓練後的模型。這個模型內部的參數已經和一開始截然不同,也能夠針對大多數的貓狗圖像做出正確的分類。
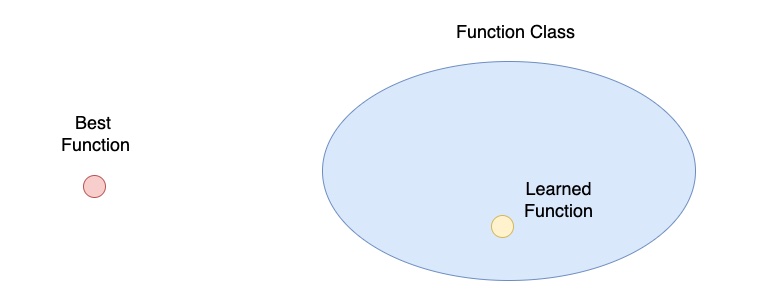
上面這段敘述其實經歷了三個步驟:
- 想要一個完美的模型
- 建立一個模型
- 訓練後的模型
這三個步驟正好對應到上圖中的每一個元素。我們所希望得到的「完美模型」就是圖中的 Best Function。當我們「建立一個模型」時,可以設計不同的模型架構,此時模型中的參數有無限多種可能,這一整片可能性就對應到圖中的 Function Class。訓練結束後模型的參數固定下來,得到的「訓練後的模型」則對應到圖中的 Learned Function。
換句話說,決定模型架構這個動作,等於是先在所有可能的函數裡圈出一塊範圍;訓練這個動作,則是在這塊範圍裡挑出一個點。
3 估計誤差 (Estimation Error) 與近似誤差 (Approximation Error)
由上圖可以發現,Learned Function 其實與 Best Function 之間還有一大段的誤差。這段誤差可以再拆成兩塊:估計誤差 (Estimation Error) 與近似誤差 (Approximation Error)。
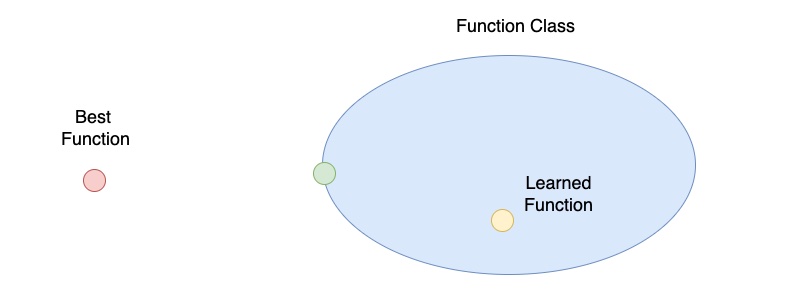
在上圖中,我們多標上了一個「綠色點」,用來表示在我們所定義的 Function Class 中,與 Best Function 最接近的那個 Function。它代表這個架構在最理想的情況下能做到的極限:就算訓練過程完美無缺,也只能走到這裡。
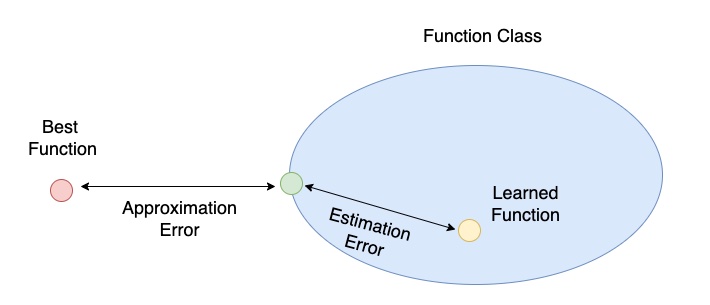
有了綠色點當分界,兩種誤差就好定義了:
- 近似誤差 (Approximation Error):綠色點到 Best Function 的距離。這是模型架構本身造成的落差,跟訓練得好不好無關。
- 估計誤差 (Estimation Error):綠色點到 Learned Function 的距離。這是訓練過程沒能把模型帶到該去的位置所造成的落差。
如果我們定義一個非常複雜的模型,也就是一個很大的 Function Set,大到把 Best Function 都包覆進去了,那麼此時的 Approximation Error 會為零,但是 Estimation Error 可能會變得更大。範圍太大,訓練時要在裡面找到那個最好的點也就更難。相反的,如果我們定義一個非常簡單的模型,也就是一個很小的 Function Set,那麼此時的 Estimation Error 會很小,但是 Approximation Error 卻會變得很大:範圍小到很好找,可惜答案根本不在裡面。
不覺得 Approximation Error 與 Estimation Error 的關係,就像是 Bias-Variance Tradeoff 嗎!模型愈複雜,架構造成的誤差愈小、訓練造成的誤差愈大,兩邊往相反方向跑,這正是同一個取捨換了一套語言來描述。
4 參考資料
- Stanford CS221 Lecture 3
- Estimation versus approximation error
- What does the term “Estimation error” mean?
5 結論
本篇文章介紹了模型的估計誤差 (Estimation Error) 與近似誤差 (Approximation Error):把 Function Class 裡最接近 Best Function 的那個點當作分界,一邊是架構的極限,一邊是訓練的落差。隨著模型愈複雜,Approximation Error 降低,Estimation Error 上升。
下次調整模型大小卻發現效果沒有變好時,不妨用這個角度想一下:問題是出在架構搆不到答案,還是訓練沒把模型帶到位?答案不同,該動的地方也不一樣。