人臉辨識為什麼比房價預測難?機器學習五步驟走向神經網路
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
這篇是「機器學習基礎觀念」系列的第 10 篇。前面幾篇我們把機器學習解題的五個步驟走過一輪(定義問題、建立資料集、模型訓練、模型評估、模型推論),也分別套用在「房價預測」這個監督式學習問題,以及「探索書籍風格」這個非監督式學習問題上。
那兩個問題用的是 Linear Regression Model 與 K-Means Clustering Model,都算是比較傳統的機器學習模型。這篇要換一個難度高一階的題目:人臉辨識 (Face Recognition)。同樣的五個步驟不會變,變的是中間那個「模型」——傳統模型在這題上會卡住,得換成神經網路才做得動。
2 Step 1:定義問題
人臉辨識這項技術早就滲進日常生活了,解鎖手機、進出社區大門,背後都是它。
先設定一個具體的情境,後面每個步驟都會回到這個情境上。假設你是個很在意隱私的人,希望白天上班的時候,調皮的弟弟不能隨便進你房間。打一把鑰匙給自己你又嫌麻煩,因為你很清楚自己一定會弄丟。於是你決定做一套人臉辨識系統:只有辨識出「是你」的時候,電子門鎖才會開。
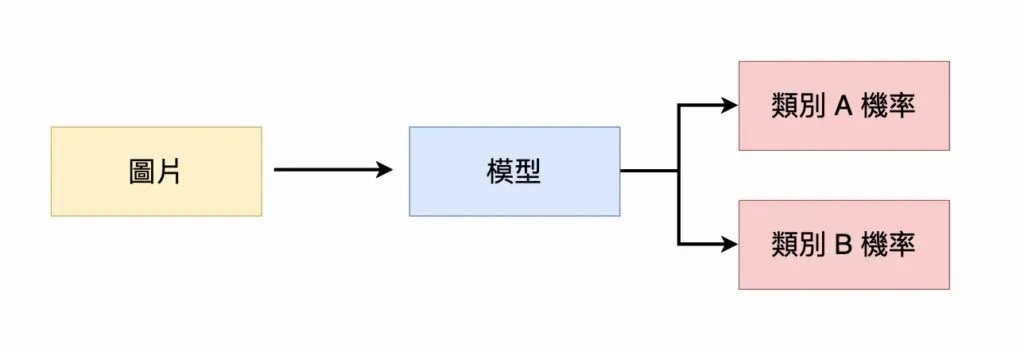
要做出這套系統,核心是訓練出一個能分辨「你的人臉」的模型。輸入是「一張圖片」,輸出是這張圖片所屬的「類別」。我們事先把類別定義成兩種:
- 類別 A:圖片中包含你的人臉
- 類別 B:圖片中不包含你的人臉
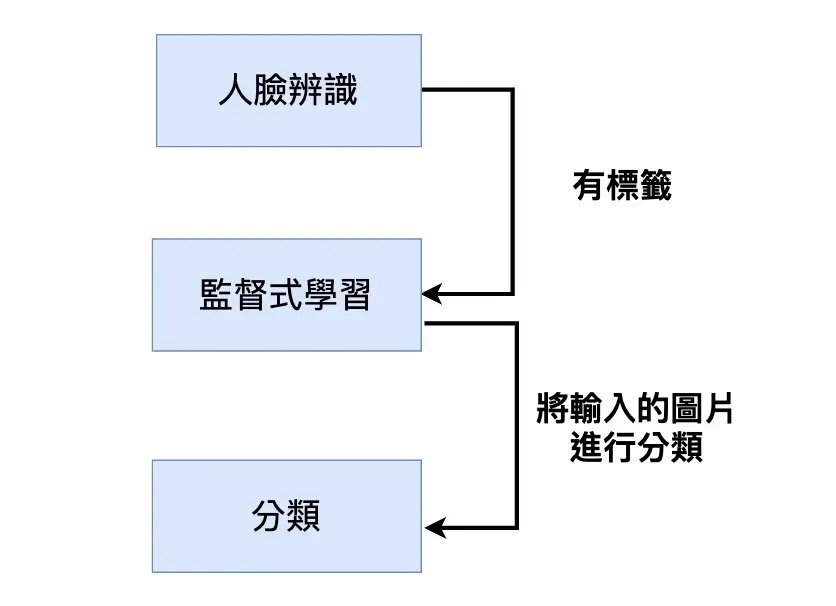
為了訓練這個模型,我們要準備大量圖片,每張不是類別 A 就是類別 B。因為這些圖片的類別是我們事先標注好的,等於有標準答案在旁邊盯著模型學,所以這題屬於監督式學習 (Supervised Learning)。而模型的輸出是一個「類別」而不是一個連續數值,所以任務型態是分類 (Classification)。
定義問題這一步看起來很像在講廢話,但它決定了後面三步該怎麼走:知道是監督式學習,才知道資料一定得帶標籤;知道是分類任務,才知道評估時該看準確率而不是誤差值。
3 Step 2:建立資料集
資料集的準備大致可以拆成四個階段。
- 收集資料 (Data Collection) 如果要「從零」訓練一個模型,就得準備大量已經標注好類別的圖片。資料量不夠的話,模型很容易在訓練過程中出現「過擬合」(Overfitting)——白話一點說,就是模型把訓練資料背起來了,考古題答得很漂亮,換一張沒看過的照片就開始亂猜。這時候可以用 Data Augmentation 技術來緩解:把既有的圖片旋轉、翻轉、裁切、調整亮度,變出更多樣的訓練樣本。
- 資料探索 (Data Exploration) 與資料清理 (Data Cleaning) 資料集的品質會直接決定模型的上限,所以這一步要盡可能提升圖片品質、確保標注正確。例如把模糊的照片挑掉、檢查標籤有沒有貼錯。也可以寫個程式把所有圖片的尺寸與格式統一,方便後面訓練。
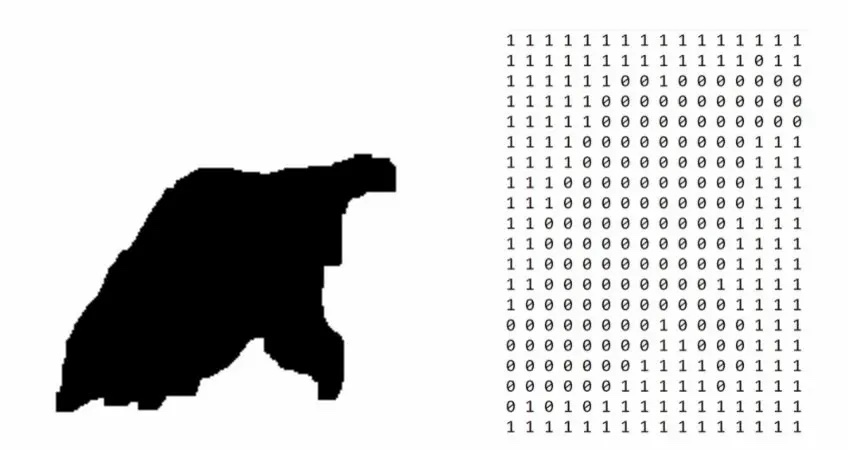
- 資料向量化 (Data Vectorization) 模型吃的是「數值」不是「圖片」,所以要先把圖片轉成矩陣。以下圖為例,左邊是一張黑白圖片,右邊是表示這張圖片的矩陣,矩陣中的 0 表示該 Pixel 為「黑」、1 表示該 Pixel 為「白」。彩色圖片則是由 RGB 三個 Channel 組成,所以會用三個矩陣來表示。
- 分割資料 (Split Data) 模型訓練完之後,我們需要用「模型沒看過的資料」來評估它的好壞,所以要先把整個 Dataset 拆成 Training Dataset 與 Testing Dataset,常見比例是 80% : 20%。用 Training Dataset 訓練,用 Testing Dataset 評估。如果拿訓練用過的資料來評估,就像讓學生考他剛剛才對過答案的考卷,分數再高也沒有參考價值。
4 Step 3:模型訓練
前兩篇文章用的是傳統機器學習模型(Linear Regression Model、K-Means Clustering Model),但在人臉辨識這題,我們改用神經網路模型 (Neural Network)。
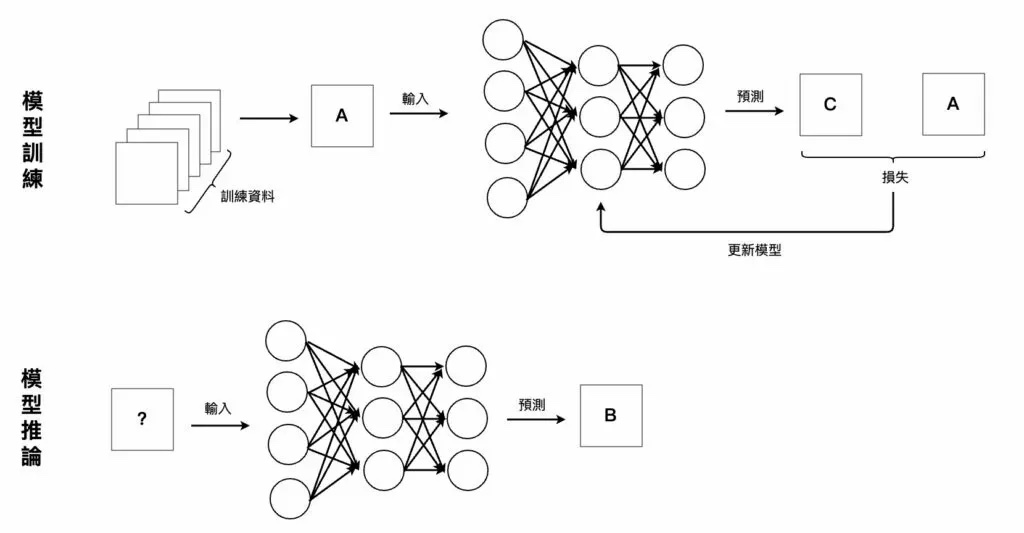
原因很直接:傳統模型需要人類先幫它整理出「有意義的特徵」,可是人臉的特徵實在太難用手寫規則描述——眼距、膚色、輪廓,再加上拍攝角度與光線變化,寫一輩子也寫不完。神經網路的強項就是自己從原始像素裡把這些特徵學出來,能處理的問題也因此比傳統模型更廣、更難。神經網路本身的細節不在這篇的範圍內,之後會有專門的文章談。
神經網路底下還分成很多種模型,各自擅長不同任務。前面定義問題時,我們已經把人臉辨識視為「圖像分類」(Image Classification),而面對「圖像」這種輸入資料,卷積神經網路 (Convolutional Neural Network, CNN) 是第一首選。CNN 擅長把圖像中重要的特徵萃取出來,例如邊緣、輪廓這類局部圖樣,再一層一層組合成更完整的概念,進而拉高圖像分類模型的預測準確度。
5 Step 4:模型評估
模型訓練完之後,我們會拿 Testing Dataset 搭配統計指標 (Statistical Metrics) 來衡量品質。最直覺的是 Accuracy,也就是單純算模型答對的比例。
但只看 Accuracy 常常會被騙。回到我們的房門情境:如果攝影機拍到的畫面大多數時間是空的(類別 B),一個什麼都不學、永遠回答「不是你」的模型,Accuracy 也可以衝到很高——但它完全沒用,因為你也永遠進不了自己房間。正因為這種特性,才會有 Confusion Matrix、Precision、Recall 與 ROC Curve 這些指標,這部分留到之後的文章介紹。
6 Step 5:模型推論
模型評估過關之後,就可以正式上線當你的「房間守衛」了。攝影機每拍一張圖片,就丟進模型,由模型預測類別,再依照結果採取對應的動作。
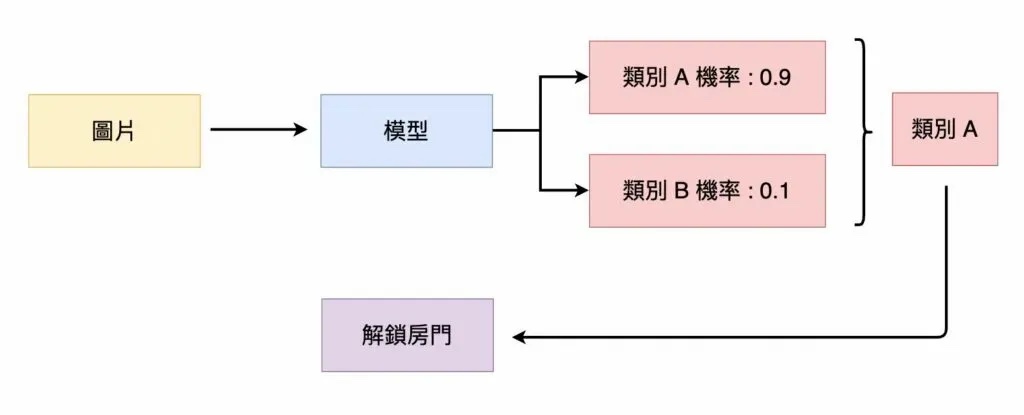
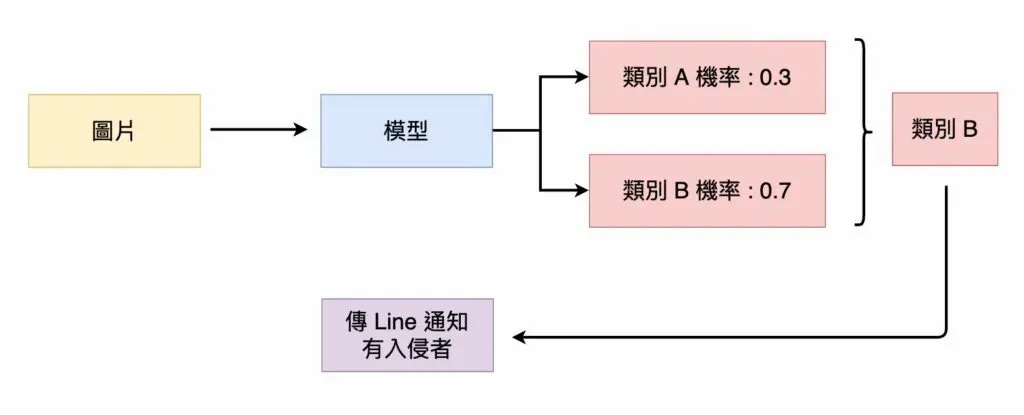
判斷是類別 A 的機率比較高,就解鎖房門;判斷是類別 B 的機率比較高,就發出警報。到這裡,五個步驟才算真正閉環:定義出來的問題,最後變成一個會做決定的系統。
7 結論
這篇我們再一次走完機器學習的五個步驟,只是這次解的是「人臉辨識」。對電腦來說,認人臉一直是相當困難的任務,直到神經網路 (Neural Network) 出現才大幅拉高準確度,也讓人臉辨識能真的落地到手機解鎖、門禁這些日常場景。
整篇看下來,五個步驟本身沒有變,變的只是中間選用的模型。下一篇會往神經網路裡面走,看看它到底是怎麼運作的。