Deep Learning 原理:Neural Network 如何分類圖像
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
在前一篇文章「Deep Learning 第一站:Neural Network 名詞介紹」中,我們認識了 Neural Network 的基本組成,以及 Input Layer 與 Output Layer 的設計理念,也分清楚了 Feedforward Neural Network 與 Recurrent Neural Network 的差別。
這篇文章換個角度,從一個很具體的題目下手:手寫數字圖像分類。我們會實際設計一個能解這個問題的 Neural Network,接著站到 Neural Network 的視角,看它究竟是怎麼「看懂」圖像裡的那個數字。
- 問題本身:把一張 28 × 28 的灰階圖像,分類成單一個手寫數字 (0 ~ 9)。
- 設計方式:784 個 Neuron 的 Input Layer (每個 Pixel 對應一個 Neuron,數值正規化到 0.0 ~ 1.0)、1 層 15 個 Neuron 的 Hidden Layer,以及 10 個 Neuron 的 Output Layer,每個數字對應一個 Neuron。
- 為什麼是 10 個 Output Neuron 而不是 4 個:4 個 Neuron 理論上就能用 Bit 表示 16 種數字,綽綽有餘;但實驗顯示 10 個 Neuron 的辨識效果更好,原因要從 Hidden Layer 如何表示形狀特徵說起。
- Neural Network 如何「看」:Hidden Layer 中的每個 Neuron 都靠自己的權重,專門負責偵測圖像中的某個局部特徵,Output Layer 再把這些特徵組合成最終的分類結果。
2 手寫數字圖像分類問題
「手寫數字圖像分類」是 Deep Learning 領域中相當常見的問題,很多剛踏入這個領域的初學者,第一個 Deep Learning 專案就是拿它來練手。原因也很單純:題目夠小,小到可以完整想清楚每一步在做什麼,但又保留了圖像分類問題的完整輪廓。
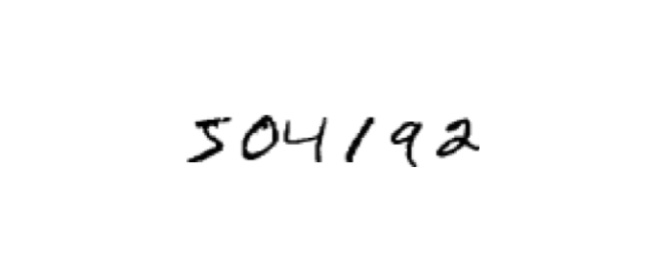
上圖就是一張手寫數字的圖像。我們希望訓練一個 Neural Network,能夠精確地辨識出裡面的每一個數字,也就是 504192。以這張圖來說,辨識的過程可以拆成兩個步驟:第一步是圖像分割,把每一個數字切開來;第二步才是針對每一個數字圖像進行分類 (0 ~ 9)。
本篇文章不討論第一步的圖像分割,我們把焦點放在第二步的圖像分類。因此,接下來都假設每一張圖像中都只包含一個數字,而且每張圖像的尺寸都相同 (28 × 28)。那麼,我們該如何設計一個 Neural Network 來辨識這個數字呢?
3 Neural Network 的設計
先前在介紹 Neural Network 組成的那篇文章中,我們討論過這個問題。針對這個題目本身,Input Layer 與 Output Layer 的設計其實可以很直觀地推導出來。
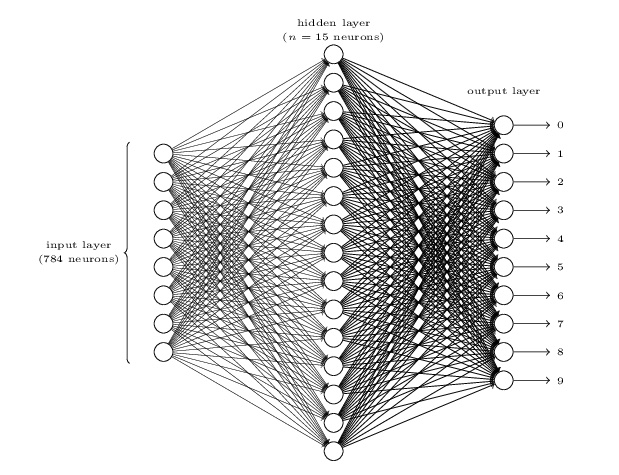
如上圖所示,Input Layer 中的每一個 Neuron 代表圖像中每一個 Pixel 的數值。因為圖像的尺寸都是 28 × 28,總共會有 784 個 Pixel,所以 Input Layer 中總共會有 784 個 Neuron (上圖為了畫得下,並沒有真的把 784 個 Neuron 都畫出來)。
另外,因為每一張圖像都是灰階 (Grayscale) 圖像,每一個 Pixel 只會有一個通道 (Channel),用來表示這個 Pixel「有多黑」。舉例來說,Pixel 數值是 0 表示「全白」,255 表示「全黑」,介於 0 與 255 之間的數字,就是黑白混出來的各種灰。
不過,我們通常不會把 Pixel 的原始數值直接丟進 Neural Network。為了提升訓練的速度與品質,習慣上會先把輸入數值壓縮到 0 到 1 的區間,做法就是把每一個 Pixel 數值除以 255,讓每個 Input Neuron 的數值落在 0.0 到 1.0 之間。這個動作叫做 normalization,Stack Overflow 上這串討論 對背後的原因有不錯的整理。
至於中間的部分,上圖的 Neural Network 只用了一個 Hidden Layer,裡面包含 15 個 Neuron。
Output Layer 則包含 10 個 Neuron,分別代表數字 0 到 9。舉例來說,輸入一張圖片之後,如果代表數字 6 的那個 Neuron 數值最大,就表示 Neural Network 認為這張圖像是「6」。
4 Output Layer 為什麼不使用 4 個 Neuron 就好
既然 Output Layer 最終只是要表示 0 ~ 9 其中一個數字,那為什麼不用 4 個 Neuron 就好?每一個 Neuron 都可以表示 0 或 1,4 個 Neuron 就可以表示 2 × 2 × 2 × 2 = 16 種數字,拿來裝 10 個數字綽綽有餘,還省下 6 個 Neuron。
要正面回答這個問題並不容易,因為我們得先把自己當成 Neural Network,搞懂它是怎麼理解圖像中的資訊的。不過在那之前,也可以先用更務實的方式回答:實驗結果證實,10 個 Neuron 的 Output Layer 比 4 個 Neuron 的 Output Layer 有更好的辨識結果。
5 Neural Network 如何理解圖像資訊
接著就來體會一下 Neural Network 是怎麼理解圖像資訊的。我們把焦點放在 Output Layer 的第 1 個 Neuron,也就是負責「輸出 0」的那一個。假設這個 Neural Network 已經訓練完成,當我們輸入一張「手寫數字 0」的圖像時,這個 Neuron 應該要比 Output Layer 中其他 Neuron 輸出更大的數值才對。
這個 Neuron 做的事情,說白了就是把 Hidden Layer 中所有 Neuron 的輸出各自乘上一個權重 w,然後加總起來。那麼,Hidden Layer 的 Neuron 又在做什麼?
Hidden Layer 中的每一個 Neuron,都負責辨識輸入圖像中的某一種特徵。如果輸入圖像裡包含該 Neuron 負責的特徵,這個 Neuron 的輸出就會特別大。舉例來說:
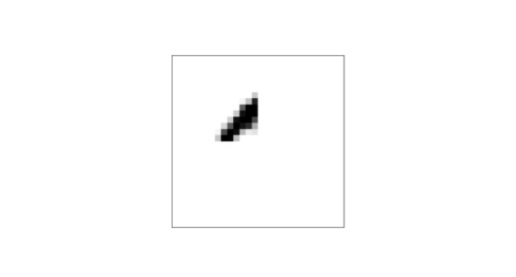
如果 Hidden Layer 中的第 1 個 Neuron 負責辨識上圖那樣的特徵,那麼它在對每一個 Input Neuron 計算權重乘積的總和時,就會給予左上角那一部分的 Input Neuron 特別大的權重,其餘部分的權重則比較小。換句話說,「負責某個特徵」這件事,實際上是靠權重的分佈做到的。
同理,下方 3 種特徵分別由 Hidden Layer 的第 2、3 與 4 個 Neuron 負責。
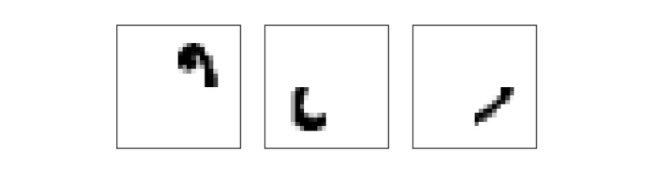
如果把這 4 種特徵合在一起,其實就是一張數字 0 的手寫圖像!
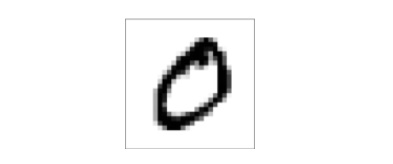
所以,當我們把這張數字 0 的手寫圖像輸入 Neural Network 時,Hidden Layer 中的前 4 個 Neuron 會分別偵測到自己負責的特徵,因此輸出特別大的數值。接著就可以推測,Output Layer 的第一個 Neuron 在對 Hidden Layer 所有 Neuron 計算權重乘積的總和時,勢必會給前 4 個 Neuron 比較大的權重,因為它知道這 4 個特徵組合在一起就是在辨識數字 0。
理解了這個過程,再回頭看前面那個問題 (Output Layer 為什麼是 10 個 Neuron 而不是 4 個),就比較好想像了。當 Output Layer 有 10 個 Neuron 時,每一個 Output Neuron 都象徵一個數字,它會不會被激發 (輸出很大的數值),取決於前面的 Hidden Layer 捕捉到了哪些形狀特徵,兩者的關聯很直接。但當 Output Layer 只有 4 個 Neuron 時,每一個 Output Neuron 象徵的是一個 Bit,「Hidden Layer 捕捉到了哪些形狀特徵」與「這個 Bit 該是 0 還是 1」之間,就很難建立起這麼自然的關聯了。
6 結論
這篇文章我們進到 Neural Network 的視角,看它如何把一張 28 × 28 的手寫數字圖像,一路從 Pixel 數值、Hidden Layer 的形狀特徵,推到 Output Layer 的分類結果,也順帶解釋了 Output Layer 為什麼用 10 個 Neuron 而不是 4 個。
不過到目前為止,我們都假設這個 Neural Network「已經訓練完成」,權重剛好都調在對的位置上。下一篇文章「Deep Learning 基本功:認識 MNIST 資料集與損失函數」會接著談 Neural Network 如何學習,也就是它怎麼調整自己的參數 (weight 與 bias),讓輸出愈來愈正確。本文的圖像與例子皆出自 Neural Networks and Deep Learning 第一章,想看更完整的推導可以直接讀原文。