用房價預測,把機器學習五步驟串成一個完整範例
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
本篇是「機器學習基礎觀念」系列的第 8 篇文章。在先前的文章中,我們已經依序走過機器學習的五個步驟:定義問題、建立資料集、模型訓練、模型評估與模型推論。這五步驟拆開來看都不難,但真正要動手時,最容易卡住的往往是「這個問題到底該怎麼對應到這五步」。
所以這篇不再談新觀念,而是拿「房價預測」這個經典題目,把五步驟從頭到尾重跑一次,看看每個步驟在實際任務裡各自負責什麼事。
房價預測之所以常被當成入門例子,是因為它的目標很直覺:給你一間房子的條件,猜它值多少錢。如果你已經有基本觀念,想再往下練,可以直接參加 Kaggle 上的 House Prices – Advanced Regression Techniques 競賽,用真實資料集把觀念磨得更扎實。
2 步驟 1:定義問題
在房價預測的任務中,我們希望模型能觀察房子本身的「屬性」,例如房間數量、衛浴數量、坪數、地理位置,再由這些屬性去預測房子的價格。
因此我們要收集的是一批樣本,每個樣本代表一間房子,裡面記錄著該房子的種種屬性以及目前的售價。整理出來大致長這樣:
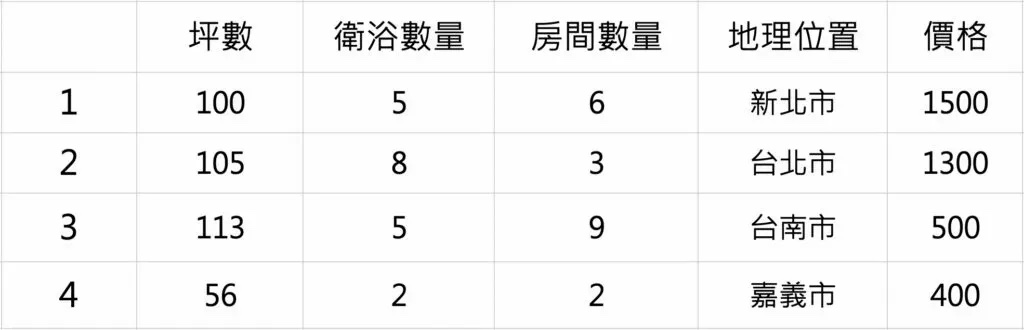
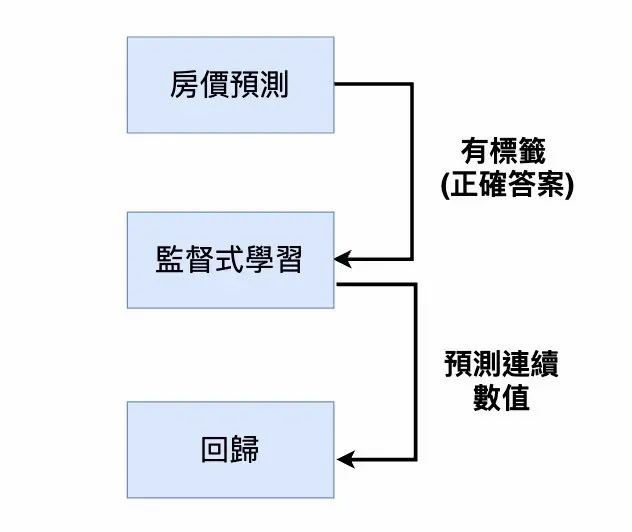
有了這張表,問題的性質就能定調了。因為每一間房子的「價格」我們手上都有,等於每筆資料都附帶正確答案,所以這是一個監督式學習 (Supervised Learning) 的問題。
再看模型要輸出什麼:房價是一個連續數值(1,280 萬、1,283 萬都是合法答案),不是「貴/便宜」這種類別,所以它屬於回歸 (Regression) 問題,而不是分類問題。這兩個判斷會直接決定後面選什麼模型、用什麼指標評估,所以第一步值得花時間想清楚。
3 步驟 2:建立資料集
問題定義完,接著就是把資料準備到「可以餵進模型」的狀態。這個階段主要包含以下幾件事:
- 收集資料 (Data Collection) 資料集的取得管道非常多元,最簡單的方式就是在網路上找現成的。例如 Kaggle Dataset 就存放了大量可直接拿來訓練模型的資料集。
- 資料探索 (Data Exploration / Data Inspection) 目的在於更了解資料內容,尤其是搞清楚每一個屬性的型態。如果某個欄位是字串(例如地理位置寫成「信義區」),就必須先轉成數字,模型才吃得下去。
- 資料清理 (Data Cleaning) 探索的過程中,常會發現某些樣本的數值有缺失。例如第 043 個樣本缺「價格」、第 103 個樣本缺「坪數」。我們可以用一些統計方法把缺失值補起來,也可以乾脆把該樣本從資料集中刪掉。
- 概述統計 (Summary Statistics) 與資料視覺化 (Data Visualization) 清理完之後,透過統計指標總結資料集的整體樣貌,或是把樣本的分布畫成圖表,讓自己對手上這份資料有個大致的感覺。
4 步驟 3:模型訓練
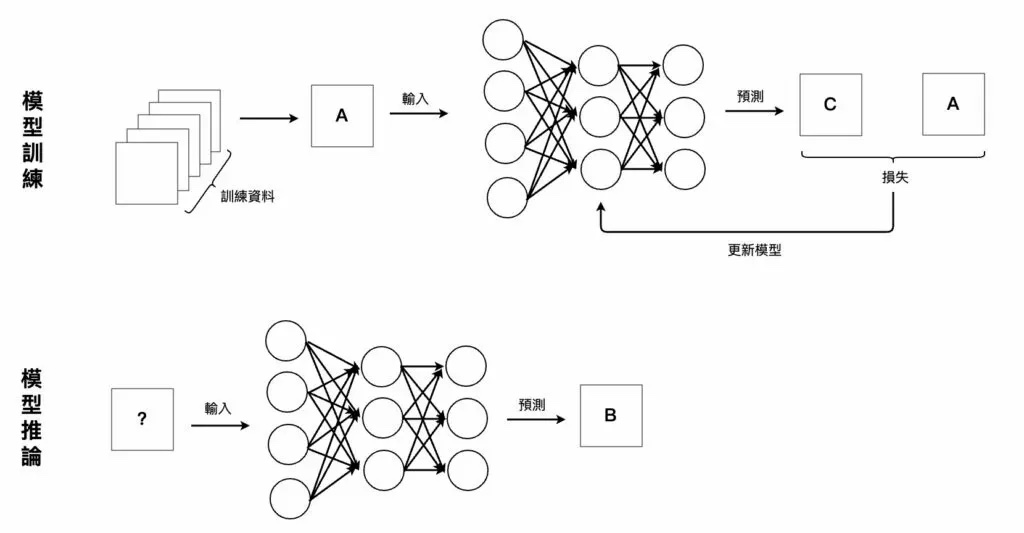
資料集建立好之後,就可以建立模型並開始訓練。動手之前通常會先把整份資料集切成「訓練資料集」(80%) 與「測試資料集」(20%),目的是留一批模型沒看過的資料在手上,訓練結束後才有辦法公正地評估它的預測品質。如果全部拿去訓練,模型考的是自己讀過的考古題,分數再高也不代表什麼。
在定義問題的階段,我們已經確認房價預測屬於回歸問題,所以這裡自然會選用回歸模型 (Regression Model) 來訓練。
實作回歸模型的工具很多:想用傳統機器學習的做法,可以使用 scikit-learn;想改用深度學習的做法,則可以使用 TensorFlow 或 PyTorch。
5 步驟 4:模型評估
訓練完成後,就輪到前面刻意留下來的「測試資料集」(Testing Dataset) 上場,用它來評估模型的好壞。在〈使用機器學習解決問題的五步驟:模型評估〉那篇文章中曾提到,分類模型與回歸模型各自有一整套評估指標可以選。
房價預測是回歸問題,常見的評估指標有 MAE (Mean Absolute Error)、MSE (Mean Squared Error) 與 RMSE (Root Mean Squared Error)。
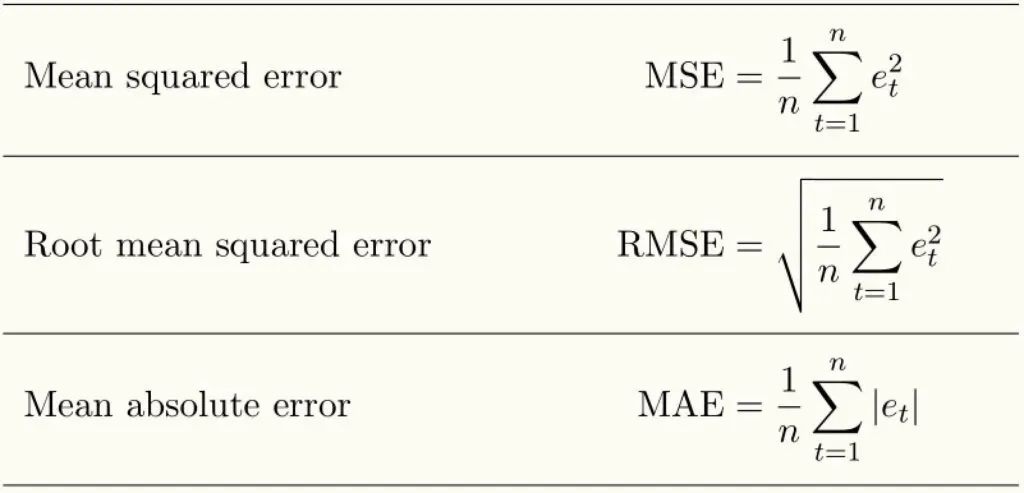
這個系列不會深入數學的部分,不過方向抓住就夠用了:不管是 MAE、MSE 還是 RMSE,它們要算的都是同一件事——模型的「預測值」跟實際的「正確數值」差得有多遠。差距越小,代表模型預測得越準。
6 步驟 5:模型推論
模型評估過、確認品質可以接受之後,就能實際拿它來預測房價了。把模型在訓練階段沒見過的樣本輸入進去,得到模型輸出的預測值,這就是模型推論 (Model Inference)。到這一步,前面四步的工才真正變成可以用的東西。
7 結論
這篇文章用「房價預測」的例子,把機器學習五步驟從頭複習了一次,也看到每個步驟在實際解題時各自扮演的角色:定義問題決定了這是監督式學習中的回歸任務,建立資料集把原始資料整理成模型吃得下的形式,訓練與評估負責產出並驗證模型,最後由推論把模型送上場。
房價預測是監督式學習的例子。下一篇文章會同樣套用這五步驟,來看一個生活中「非監督式學習」的例子。