TypeSafe AI 的 Jev 號稱快 193.6 倍?第三方實測只到約 25 倍
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
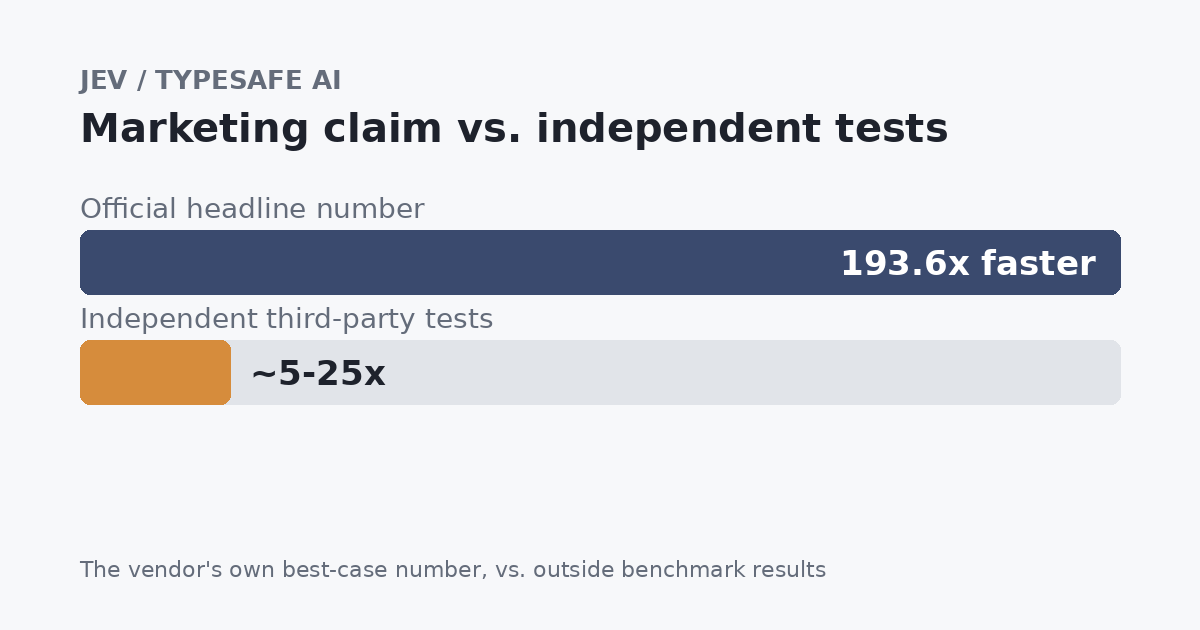
2026 年 9 月,新創公司 TypeSafe AI 結束兩年隱身期,推出一款叫做 Jev 的產品,自稱是「System One Model」——官方沒有進一步解釋這個命名本身的意涵,下文一律以「Jev」稱呼這個產品。官方的頭條數字很聳動:比前沿大模型快 193.6 倍、便宜 444.6 倍,還宣稱「不會產生幻覺」。這種數字乍看之下很難不讓人懷疑是話術。
但把 Jev 的技術定位、訓練方法、第三方查證數字都攤開來看之後,會發現故事比「又一個誇大其詞的新創」複雜一些。Jev 想補的空隙是真的存在的,官方公布的 4-workflow benchmark 和多個獨立第三方測試也都證實了它的效率優勢方向不假——只是幅度被大幅美化。這篇文章會照著「Jev 想解決什麼問題 → 技術怎麼運作 → 怎麼訓練出來的 → 數字站不站得住腳 → 適合用在哪裡、不適合用在哪裡 → 商業敘事上的爭議」這條線,把值得留下的技術判斷,跟該打折扣的行銷包裝分開講清楚。
- Jev 想補的空隙是真的存在的:傳統分類器太死板,直接叫 LLM 又慢又貴還不可靠,Jev 想同時拿到 LLM 的彈性跟分類器的速度、成本、型別安全。
- 速度與成本優勢的方向也是真的,但第三方獨立測試普遍落在 5 到 25 倍之間,遠不如官方頭條的 193.6 倍與 444.6 倍。
- 「不會幻覺」只保證輸出格式合法,不保證答案正確;準確率是中段班,而且隨錯誤代價升高會擴大差距。
- RLCD 的架構細節、reward function 設計、訓練資料來源、校準曲線全數未公開,外界無法完全驗證。
- 一句話判斷規則:錯誤代價低、量大的任務(分類、路由、guardrail 前置篩選)效率權衡非常划算;錯誤代價高的任務(金流、法遵、需要可稽核理由的判斷)應該保留前沿大模型。
2 兩條舊路線之間,那塊沒人補上的空隙
在 Jev 出現之前,一個「高頻、大量跑」的判斷任務——例如對每一張進來的發票判斷「是否異常」——大概只有兩條路可以走。
路線一是傳統監督式分類器,例如訓練一個 BERT-based classifier。優點是快、便宜、型別安全,輸出永遠落在預先定義好的類別裡;缺點是每換一個任務就要重新標註資料、重新訓練,而且完全不懂自然語言指令。
路線二是直接呼叫 LLM(GPT、Claude 這類)來做判斷。優點是不用訓練資料,用自然語言描述任務就能做零樣本或少樣本判斷,彈性極高。但這條路線的缺點也很具體,一共三個:輸出是自由文字,得自己寫 parsing 邏輯去抓答案,格式隨時可能跑掉;逐 token 自回歸生成很慢很貴,即使答案只是「是/否」兩個字,內部還是要一個 token 一個 token 算;信心不可靠——LLM 講得很篤定,但那個「篤定感」跟它實際答對的機率之間沒有可信賴的對應關係,這就是後面會展開的「校準」(calibration)問題。
Jev 想補的,正是這兩條路線中間那塊空隙:要路線二的彈性,但要路線一的速度、成本、型別安全,外加一個兩條路線都沒做好的東西——真正可信賴的機率。
| 傳統監督式分類器 | LLM(GPT/Claude) | Jev 想達成的 | |
|---|---|---|---|
| 需要訓練資料 | 需要 | 不需要 | 不需要 |
| 輸出型別安全 | 是 | 否(需自己 parse) | 是(schema 保證) |
| 速度/成本 | 快/便宜 | 慢/貴 | 接近分類器 |
| 信心可不可信 | 需自行校準 | 過度自信、不可靠 | 官方宣稱有校準(未經外部驗證) |
這個定位也解釋了為什麼官方把 Jev 叫做「decision layer」或「smart if-statement」,而不是「取代 LLM」——它瞄準的是答案空間已知、但用傳統分類器又太死板的判斷任務,不是開放式生成任務。
3 Jev 是誰在做:創辦團隊與資金背景
TypeSafe AI 於 2024 年在舊金山成立,2026 年 9 月 15 日結束隱身期、正式公開亮相,拿到 DCVC 領投的 4,000 萬美元種子輪。創辦團隊裡最值得留意的是 CEO Diogo Almeida——前 OpenAI 研究員,InstructGPT 論文的 primary author 之一(20 位作者中被標為 primary 的 9 人之一),也是 GPT-4 的貢獻者,之前待過 Google Brain。另外兩位共同創辦人是 CTO Erik Gafni 跟 COO Sasha Sheng。
創辦人背景解釋了技術路線的來由:RLCD(後面會展開的核心訓練方法)本質上是「用強化學習訓練校準機率」,這正是 Almeida 在 OpenAI 做 RLHF 研究的延伸。
跟這家公司有關的資訊,可信度並不一致,值得分開看待:
- 可獨立查證、可信度高:創辦人背景(InstructGPT 作者、GPT-4 貢獻者)、DCVC 領投 4,000 萬美元種子輪,這些是新聞稿等級的事實,多方來源一致。
- 單一匿名來源、應打折扣:「估值約 2 億美元」只來自 Forbes 引述一位「知情人士」,沒有官方數字佐證,也沒有第二方來源。
- 行銷措辭被指誇大:市場上流傳「創辦人是 ChatGPT 共同發明人」的說法,精確地說他只是 InstructGPT(ChatGPT 背後其中一篇關鍵論文)眾多作者中被標記為 primary author 的一員。「被標記為 primary author」跟「共同發明人」之間存在明顯的用詞放大,多篇獨立分析都明確指出這一點。之後再看到「共同發明人」這類引用,得留意來源的查證等級。
4 非自回歸架構:「一次 forward pass」到底是什麼意思
要理解 Jev 的速度優勢從哪來,得先搞清楚傳統 LLM 為什麼慢。
自回歸(autoregressive)是指模型一次只產生一個 token,然後把這個 token 加回輸入裡,再產生下一個 token,如此重複,直到生成結束:
輸入: "這筆交易是否異常?答案:"
第1步 -> 產生 token "是"                        (看完整個輸入後,算一次)
第2步 -> 輸入變成 "...答案:是",再產生 token ","      (再算一次)
第3步 -> 輸入變成 "...答案:是,",再產生 token "因為"   (再算一次)
第4步 -> ... 繼續逐字生成完整解釋,每個字都要重算一次
就算只想要「是/否」這一個字,模型往往還是習慣性生成一整句話,而且每多一個 token,就要多做一次完整的前向傳播計算。這是 LLM 判斷一次要花幾秒到幾十秒的根本原因,不是因為判斷本身難,而是生成文字這個形式本身慢。輸出是自由文字,事後還得自己寫程式解析,格式跑掉時還要處理重試。
Jev 不是一個 token 一個 token 生成答案,而是用「parallel sampler」機制,單次前向傳播就把所有問題的答案一次全部算出來:
傳統 LLM:  輸入 -> 算1次 -> "是" -> 再算1次 -> "," -> 再算1次 -> "因為"...(N次計算)
Jev:       輸入(state + 所有問題) -> 算1次 -> 同時吐出所有問題的答案(1次計算)
這帶來兩個官方明講的後果:多問幾題幾乎不增加時間,因為是平行評估,不是排隊算;也不會有 context rot(輸入越長、模型越容易抓錯重點的現象)。輸出端因為每題答案都被限制在預先定義好的型別,不存在「格式跑掉」這件事。
官方沒有揭露的部分是具體模型架構——官方只說「a new architecture, a new sampler, and a new training algorithm」,沒有發表論文。Hacker News 上的社群猜測可能是 text-diffusion(整段同時去噪生成),也可能是 encoder-only 加上 classification heads(每個問題當成一個獨立分類頭),但 TypeSafe 兩種都沒證實,只回應「暫時保密,論文可能之後發表」。我們知道 Jev 做到了什麼效果,但不知道具體怎麼做到的,這條界線要記住。
4.1 「一次算完」在技術上說不說得通?
有兩種已知的、非魔法的方式可以達到這種「體感上像一次算完」的效果。
機制一是 KV cache 重複利用,業界通常叫 prefix caching 或 prompt caching。Transformer 每一層在算 attention 時,每個 token 都會產生一組 Key、Value 向量,後面的 token 要「回頭看」前面的 token,靠的就是拿自己的 Query 去跟前面存好的 Key/Value 做比對。這些向量一旦算出來,只要輸入內容不變就不用重算——KV cache 就是把算好的向量存起來重複使用。
帶數字走一次:假設 state(背景資料)是 500 個 token,有 3 個問題各 10 個 token。
沒有 KV cache 的笨方法:
問題1: [state 500 + Q1 10] = 510 個 token 全部重算
問題2: [state 500 + Q2 10] = 510 個 token 全部重算  <- state 又重算一次
問題3: [state 500 + Q3 10] = 510 個 token 全部重算  <- state 又重算一次
總計算量約 510 x 3 = 1,530

用單一 KV cache:
第一步: state 500 個 token 只算一次,把每層的 Key/Value 存起來 = 500
第二步: Q1 只算自己的 10 個 token,借用已存好的 state Key/Value = 10(Q2、Q3 同理)
總計算量約 500 + 10 + 10 + 10 = 530
500 vs. 1,530,省了將近三倍,問題越多、state 越長,省下的比例就越誇張。這個技巧不是 Jev 的專屬發明,vLLM 這類推論框架、Anthropic API 都有類似機制。
機制二是平行評估,把多個問題一起送進 GPU 算,而不是排隊一題一題算。GPU 本質上擅長「同時對一堆數字做一樣的運算」,把三題疊成一個 batch,幾乎跟丟一題所花的時間差不多。
嚴格說,這不是真正單一次的 forward pass,而是「KV cache 省掉重複計算」加上「batch 化省掉排隊等待」兩個技巧疊加後,在體感延遲上表現得像一次算完。這跟 Hacker News 猜測的「Jev 可能是 encoder-only 加分類頭」原理相通:把 state 跟所有問題一起塞進輸入,每個問題用一個特殊標記位置代表,整個輸入只跑一次雙向的 Transformer forward pass,跑完後讀取每個問題標記位置對應的輸出向量,各自接一個小的分類或迴歸頭。這其實是 ML 裡行之有年的概念——共用一個 encoder、多個任務各自掛一個輕量 readout head,跟 BERT 用同一個模型接不同分類頭做多任務是同一個原理,不是前所未見的新架構。
有第三方實例可以佐證這個推論方向。開發者 Harsha Gundala 沒有重新訓練模型,只用現成的 Qwen2.5,搭配「平行評估 schema」加上「單一 KV cache」這兩個工程技巧,就做出比逐 token 解碼快 5.6 到 7.0 倍、100% schema 合法的效果。這顯示部分速度與型別優勢,可能來自工程手法,而不是 RLCD 訓練本身。
4.2 Constrained decoding 能不能做到跟 Jev 一樣的效果?
Constrained decoding(在生成時用文法或 schema 限制每一步只能選合法的 token)確實可以保證輸出一定符合 schema,這點跟 Jev 效果一樣。但有兩件事做不到。
第一是速度:constrained decoding 本身還是逐 token 生成,只是每一步候選詞被縮小——問 10 個問題,還是得跑 10 次以上的生成流程,不會自動變成「一次全部算完」。第二是校準機率:constrained decoding 只管格式合不合法,不管這個答案的信心值可不可信,這是後面 RLCD 要解決的問題,兩者是完全不同層次的東西。
延續上一段的第三方實例:那位開發者只用現成模型加工程技巧就做出接近的效果,代表 Jev 主打的「快 + 型別安全」有一部分可能是 constrained decoding 加 KV cache 重複利用就能達到的,不一定需要 RLCD 這套新訓練方法。RLCD 真正獨有、且尚未被驗證的賣點,是「校準機率」這塊。
4.3 輸入結構與多問題平行輸入
官方明講的輸入結構是 state(背景資料或上下文)加上多個 typed questions——每個問題都要指定型別,還要附上該型別需要的參數。可以同時輸入多題,這是設計核心,官方甚至鼓勵把一個模糊判斷拆成很多個具體小問題一次問完(後面「問題設計原則」那一節會展開)。Context 上限是 state 加所有問題合計約 64k,或 state 加單一最長問題約 32k,兩種算法哪個適用,官方沒有講得更細。
用一個發票異常判斷的例子示意結構——這是根據報告描述推論出的示意結構,不是官方公布的確切 JSON schema,實際欄位名稱可能不同:
state: "發票內容:供應商=ABC貿易,金額=850,000,日期=2026-09-20,..."

questions:
  [1] type=Noul,  問題="金額是否顯著偏離該供應商過去交易均值?"
  [2] type=Choice,問題="此交易應歸類為?",選項=[正常,需複核,高風險]
  [3] type=Score, 問題="整體異常程度評分",等級=1~5
一次 API 呼叫送出去,三題平行算完,一次回傳三個結構化答案。
4.4 三種輸出型別:Choice / Score / Noul
Jev 的輸出被限制在三種預先定義好的型別,型別安全就是靠這個保證的。
| Primitive | 輸出內容 | 選項數量限制 | 適用場景範例 |
|---|---|---|---|
| Choice | 選中的選項 + 每個選項的機率 + confidence | 最多 255 個選項 | 分類、路由(例如信件該分派給哪個部門) |
| Score | 一個可以落在等級之間的浮點分數 + 機率分布 + confidence | 2–10 個有序等級 | 評分、rubric(例如作文品質幾分) |
| Noul | 一個 0–1 之間的機率值,無獨立 confidence 欄位 | 是/否二元 | Guardrail、二元判斷(例如是否含惡意內容) |
三者的共同點是都可以在同一次 API 呼叫裡混用、平行評估。
以客服信件分類為例(選項:帳務問題/技術問題/退換貨/其他),Choice 回傳的內容會像這樣:
choice: "技術問題"
機率分布: { 帳務問題: 0.03, 技術問題: 0.81, 退換貨: 0.11, 其他: 0.05 }
confidence: 0.81
confidence 其實就是選中選項的機率值本身——選越集中在一個選項,confidence 越高。
以文章「論述清晰度」打分為例(1 到 5 分),Score 回傳的內容會像這樣:
score: 3.6   <- 注意:這是浮點數,不是整數 3 或 4
機率分布: { 1: 0.02, 2: 0.08, 3: 0.35, 4: 0.45, 5: 0.10 }
confidence: 0.45
重點是 3.6 這個數字不是隨便平均出來的整數混合,而是模型直接輸出的、可以落在兩個等級之間的連續值,比傳統分類器只能吐出離散類別更細緻,適合需要排序、比較的場景。
以判斷輸入是否含 prompt injection 為例,Noul 回傳的內容會像這樣:
value: 0.92 <- 代表「是」的機率是 0.92Noul 沒有獨立的 confidence 欄位,因為對二元判斷來說,機率值本身就已經直接反映信心程度。這跟 Choice 或 Score 需要額外一個 confidence 欄位是不同的設計邏輯:Choice、Score 的「選中值」和「信心程度」是兩件事——選中「技術問題」不代表信心一定高;但 Noul 的「機率值」和「信心」在數學上是同一個數字。這種「用機率值直接當信心分數」的做法,跟 LLM-as-a-Verifier 讀取完整 token 機率分布、而不只取單一 argmax 答案的精神是相通的。
5 訓練方法:從 RLHF 到 RLCD 的演化
Jev 的核心賣點是「校準過的機率」,而這個能力來自一套叫做 RLCD 的訓練方法。要理解 RLCD 好在哪裡,得先從強化學習的基本框架,以及標準 RLHF 為什麼會失去校準,講起。
5.1 強化學習的基本框架
用一個訓練狗做「坐下」這個動作的比喻,可以建立最基礎的框架:Agent(執行動作的主體)是狗,在 LLM 情境裡就是模型本身;Action(動作)是狗做出的動作,在 LLM 情境裡是「生成一個 token」或「生成一整句回答」;Reward(反饋)是主人給的零食,一個數字,越高代表這個動作越好。
整個訓練邏輯很簡單:狗做了某個動作,得到 reward;reward 高,以後更容易重複這個動作;reward 低,以後比較不會做。這裡先埋一個伏筆——「reward 分數是誰給的、怎麼給的」,正是 RLHF、RLVR、RLCD 三者的根本差異所在。訓練「機制」是一樣的,差別只在「零食怎麼決定要不要給」。
5.2 Reward model:另外訓練一個模型來打分
沒有人有空即時看過模型生成的每一個回答然後手動打分,因為訓練過程中模型會生成成千上萬個回答。標準 RLHF 的解法是先訓練另一個獨立的模型,專門模仿人類打分的行為,這個模型叫 reward model(獎勵模型)。
它的訓練流程是這樣的:先找一批人類評分員,給他們看同一個問題的兩個不同回答 A 跟 B,請他們選「A 比較好」還是「B 比較好」,收集大量這種比較資料;再用這些「人類偏好比較」的資料,訓練一個模型,目標是讓這個模型對人類選的那個更好的回答打出更高的分數;訓練完成後,這個模型就可以自動幫任何新的回答打分了,不用真人即時介入。
為什麼不能直接回歸到一個目標分數?因為人類評分員從來沒有給過絕對分數。人類只做了「A 跟 B 比,A 比較好」這種相對比較,沒有人說過「A 值 8.3 分、B 值 3.1 分」這種絕對數字——人類打絕對分數的一致性很差,但「A 比 B 好」這種相對判斷穩定得多。所以訓練資料的形式從頭就只有「哪個贏、哪個輸」,沒有目標分數可以拿來算均方誤差。
InstructGPT 論文實際使用的 loss function 是 Bradley-Terry pairwise ranking loss:
其中 是 reward model 的參數, 是輸入的問題或提示, 是人類選為「比較好」的回答(w 代表 winner), 是人類選為「比較差」的回答(l 代表 loser), 是 reward model 對這組輸入打的分數, 把任意實數壓縮到 0 到 1 之間。
帶入具體數字走一次:問題是「解釋複利」,回答 A 是「利滾利具體說明」,回答 B 是「複利是一種計息方式」,人類選 A 為贏家。
判斷正確的情況:
r_θ(x, A) = 2.3    <- A 是贏家
r_θ(x, B) = 0.8    <- B 是輸家
差值 = 2.3 - 0.8 = 1.5
sigmoid(1.5) ≈ 0.817
loss = -log(0.817) ≈ 0.202   <- loss 小,代表判斷方向正確

判斷錯誤的情況(給 B 更高分):
r_θ(x, A) = 0.8
r_θ(x, B) = 2.3
差值 = 0.8 - 2.3 = -1.5
sigmoid(-1.5) ≈ 0.183
loss = -log(0.183) ≈ 1.697   <- loss 明顯變大,懲罰判斷錯誤
關鍵重點是,這個 loss 只在乎「A 分數大於 B 分數」這個相對關係,完全不管 A、B 的絕對數值是多少——2.3 跟 0.8 也可以換成 230 跟 80,只要差距方向對,loss 一樣可以很小。這代表標準 reward model 訓練出來的分數,天生就不是「校準過的機率」,只是一個排序用的相對分數。這正是 RLCD 要解決、標準 RLHF reward model 完全沒處理的問題。
5.3 PPO:reward 分數怎麼實際調整模型參數
光知道這次動作的 reward 分數,模型還不知道下次該怎麼調整才能拿到更多 reward,需要一個轉換機制,這就是 policy gradient(策略梯度)演算法家族的工作,PPO(Proximal Policy Optimization)是 RLHF 標準流程裡實際使用的版本。
流程大致是:主模型(policy)根據目前的參數生成一個回答,reward model 對這個回答打分,PPO 演算法把生成這個回答的過程中每一個 token 被選中的機率往上或往下調一點點——reward 高就增加生成類似回答的機率,reward 低就降低。
帶數字走一次簡化版:模型生成「解釋複利」時,對「利滾利」這個詞給的機率是 0.40,這個回答整體拿到 2.3 分,相對高分。PPO 大致的調整邏輯是,調整前 P(選「利滾利」) = 0.40,訓練訊號是這個回答整體拿到高分,調整後 P(選「利滾利」) ≈ 0.43,機率被推高一點點,具體推多少由 learning rate 等超參數決定。訓練反覆跑成千上萬次後,模型逐漸學會偏好容易得到高 reward 的生成模式。
這裡直接呼應前面埋的伏筆:因為 reward model 本身只在乎相對排序、天生鼓勵「聽起來篤定、讓人類評分員滿意」的回答風格,PPO 訓練又是照著這個 reward 訊號去調整機率,整個 RLHF 流程從頭到尾都沒有任何一個環節在乎「這個 token 的機率值是不是真實反映了不確定性」。模型的 token 機率之所以變得過度自信,是這整條訓練流程的副作用,不是誰故意設計出來的錯誤,而是優化目標本身就沒有把校準放進去。
5.4 LLM 的 token 機率不是本來就可以當信心值嗎?為什麼還需要 RLCD?
這個疑問完全合理——LLM 生成每個 token 時,確實會附帶一個機率值,業界常叫 logprob(對數機率)。這部分的理解沒有錯。問題出在「有機率值」不等於「這個機率值可信」,這兩件事要分開看,而分開看的關鍵詞就是「校準」。
校準的定義是:如果把模型所有「我 80% 確定」的預測收集起來,這些預測裡應該真的有大約 80% 是對的。校準講的不是「有沒有機率值」,而是「這個機率值準不準」。
業界公認、有實證研究支持的現象是,LLM 在做完 RLHF 之後,token 機率會變得過度自信——不管模型內心真實的不確定性是高是低,輸出「是」這個 token 的機率常常被訓練得逼近 1.0 或 0.0,失去中間層次的區分度。OpenAI 自己在 GPT-4 技術報告裡展示過這個現象:預訓練階段的模型 logprob 校準得還不錯,但做完 RLHF 之後校準明顯變差,因為 RLHF 訓練的目標是「讓人類評分員覺得這個回答好」,不是「讓機率值誠實反映不確定性」,一個講得斬釘截鐵的回答往往比一個誠實說「我不太確定」的回答更討喜、拿到更高分。
具體化來看:假設某筆交易其實有點模糊,正確答案有 65% 機率是「異常」、35% 機率是「正常」——一個校準良好的模型輸出的機率值應該接近 0.65;但一個 RLHF 後過度自信的模型,可能不管實際上多模糊,都會把「異常」這個 token 的機率往 0.97 這種極端值推,因為訓練過程獎勵的是講得肯定,不是講得誠實。
官方文件(docs.typesafe.ai 的 ML primer)明講立場:「RLHF 會獎勵諂媚與聽起來自信的幻覺」;而 RLCD 訓練目標明確改成「優化校準決策」而非「優化人類偏好」。RLCD 想解決的不是「LLM 沒有機率值」這個問題,而是「RLHF 這個訓練過程,把原本還算誠實的機率值訓練壞了」這個問題。
要老實補一句:Jev 自己的校準曲線也沒有公開,所以「RLCD 訓練出來的機率真的比較準」目前只是 TypeSafe 官方的自我宣稱,還沒有被獨立驗證過。這跟 RLHF 校準變差那個現象不一樣——後者是有公開研究(GPT-4 技術報告)支持的既定事實,前者還停留在廠商自己的說法階段。
5.5 RLHF vs. RLVR:reward 從哪裡來的兩種路線
核心差異就一句話:reward 是誰打的、怎麼打的。
| RLHF | RLVR | |
|---|---|---|
| Reward 從哪來 | 另外訓練出來的 reward model(模仿人類偏好) | 直接用規則或程式判斷答案對不對,不需要額外訓練模型 |
| 適用場景 | 主觀、沒有標準答案的任務(寫作品質、對話語氣) | 客觀、有明確對錯的任務(數學題答案對不對、程式碼能不能通過測試) |
| Reward 的可靠性 | 繼承人類評分員的偏見,容易被講得篤定唬住 | 非常可靠,答案對就是對,沒有主觀模糊空間 |
用一題數學「,」示範差異:RLVR 路線裡,模型輸出「」,程式直接檢查 成不成立,成立就給 reward 為 1,不需要訓練任何 reward model,規則寫死就好。這點出 RLVR 興起的原因:當任務本身有客觀對錯時,直接用規則當 reward,遠比訓練一個容易帶偏見的 reward model 更可靠、更便宜,這也是為什麼近期很多「推理能力」(數學、程式)的訓練都轉向 RLVR,而不是 RLHF。
三者可以放進同一張座標圖:
用一句話總結三者:RLHF 的 reward 是另一個模型的主觀判斷,訓練出「討好」;RLVR 的 reward 是規則驗證對錯,只適用有標準答案的任務;RLCD 的 reward 是數學公式(proper scoring),訓練出「誠實的機率」。
RLCD 剛好卡在 RLHF 跟 RLVR 中間那個縫隙——它要處理的任務(例如「這筆交易有 65% 機率異常」)沒有非黑即白的標準答案,不像數學題,但又不想像 RLHF 一樣讓 reward model 只學會「討好」而犧牲機率的誠實度。
5.6 RLCD 本身:reward 怎麼設計成「校準」而不是「討好」
RLCD 的關鍵設計是,reward 不是由「另一個模型的主觀判斷」給的,而是直接用一條數學公式,根據「猜的機率」和「實際發生的結果」計算出來。這條公式屬於統計與機率論裡一個很老、很紮實的概念,叫 proper scoring rule(適當計分規則)——不是 RLCD 發明的,RLCD 是把這個概念拿來當 reward 用。核心精神是:一個適當的計分規則,必須讓模型在誠實報告自己真實機率的時候,拿到的期望分數是最高的;如果模型故意誇大或縮小機率,想討好、想聽起來自信,它的期望分數反而會變差。
用統計上常見的 Brier score(一種 proper scoring rule)來具體驗證:
其中結果 發生記為 1,沒發生記為 0,分數越低代表預測越好。
假設真實世界裡,這筆交易真正的異常機率是 65%——這是上帝視角才知道的真值,模型不知道。
情況 A:模型誠實猜 0.65
如果最後真的異常(結果=1):Brier = (0.65-1)² = 0.1225
如果最後正常(結果=0):    Brier = (0.65-0)² = 0.4225
期望 Brier(用真實機率加權) = 0.65×0.1225 + 0.35×0.4225 = 0.2275

情況 B:模型想「講得篤定一點討好人」,猜 0.97
如果最後真的異常(結果=1):Brier = (0.97-1)² = 0.0009
如果最後正常(結果=0):    Brier = (0.97-0)² = 0.9409
期望 Brier(一樣用真實機率加權) = 0.65×0.0009 + 0.35×0.9409 ≈ 0.3298
結果是 0.2275(誠實)小於 0.3298(過度自信),分數越低越好,誠實猜 0.65 反而拿到比較好的分數。只要真實世界的結果服從那個 65/35 的分布,模型「豁出去亂猜自信值」在期望值上永遠贏不了「誠實講出自己真正認為的機率」。這跟 RLHF 的 reward model 完全不同——RLHF 的 reward model 是主觀學來的,沒有這種數學保證;RLCD 用的是一條有數學證明的公式,結構性地逼模型不能靠自信語氣騙分數。
誠實標注一處報告沒講清楚的地方:官方只寫「RLCD 訓練 TypeSafe 回傳決策與校準機率」這樣的高層描述,沒有公開具體用的是哪一種 proper scoring rule(是 Brier score、還是 log score,還是其他變體)、reward 怎麼跟 PPO 這類 policy gradient 演算法接軌。上面用 Brier score 示範,是因為它是這類「校準訓練」最常見、最直覺的代表,不代表 Jev 內部確實用的就是 Brier score,這點務必跟官方原文分開看。
5.7 RLCD 的訓練資料長什麼樣?模型到底學到什麼?
先修正一個容易誤導的說法:RLCD 的任務,在「訓練當下、模型要輸出的那一刻」不能靠固定規則直接驗證對錯,不像 RLVR 的數學題,但這個任務最終還是有一個實際發生的結果可以拿來當訓練標籤——例如那筆交易最後真的被查出是不是詐欺。不是完全沒有真值,而是真值不能在生成當下用規則算出來,只能靠後續觀察或標註取得。
先釐清一個常見誤解:Brier score 就是 squared error,兩者是同一條公式。
當「真實值」被限制成只能是 0 或 1 時,squared error 套用在機率預測上,就叫做 Brier score——沒有比 squared error 多任何新東西,只是給這個特定應用場景一個專有名詞。統計學界很早就發現 squared error 拿來訓練機率預測時,剛好具備 proper scoring rule 這個好性質,於是給它取了個專有名詞方便討論,底層數學就是很熟悉的均方誤差(MSE)。
訓練資料的形狀是三元組:(state、問題、實際發生的結果)。例如(發票內容 A,「這筆交易是否異常?」,實際結果 = 1 異常)、(發票內容 B,「這筆交易是否異常?」,實際結果 = 0 正常),大量這樣的三元組。
一個尖銳的問題是:如果 reward 是拿單一一筆的 Brier score 來算,那模型豈不是應該永遠賭「機率 = 1」——如果那筆最後真的是異常——才能把 Brier score 壓到最低?答案的關鍵在於,模型面對的不是「同一筆資料重複出現」,而是「很多筆特徵相似、但實際結果不同的資料」。模型是一個函數,輸入特徵映射到輸出機率,沒辦法對每一筆資料量身訂做答案,只能學會一個「看到類似特徵就輸出類似機率」的通用規律。
帶數字走一次:假設訓練資料裡有 100 筆特徵幾乎一樣的交易,但實際結果不同,65 筆最後真的異常、35 筆最後正常,這是資料本身的隨機性。
如果模型學會「看到這種特徵就輸出機率=1」(賭最大聲):
  對 65 筆真異常: Brier = (1-1)² = 0        (65筆 × 0 = 0)
  對 35 筆真正常: Brier = (1-0)² = 1        (35筆 × 1 = 35)
  這100筆的平均 Brier = 35/100 = 0.35

如果模型學會「看到這種特徵就輸出機率=0.65」(誠實反映比例):
  對 65 筆真異常: Brier = (0.65-1)² = 0.1225  (65筆 × 0.1225 ≈ 7.96)
  對 35 筆真正常: Brier = (0.65-0)² = 0.4225  (35筆 × 0.4225 ≈ 14.79)
  這100筆的平均 Brier = (7.96+14.79)/100 = 0.2275
0.2275 小於 0.35,輸出 0.65 這個誠實的比例,平均表現贏過每次都賭 1。這正是統計上很熟悉的事實:用 squared error 當 loss 訓練模型,在資料量夠大時,模型的最優解會收斂到條件期望值(conditional mean);對於結果只有 0/1 兩種的情況,條件期望值就是條件機率 。這跟「最小平方法的解是條件期望」是同一個統計定理,只是套用在二元結果上。
所以模型最後學到的,不是「記住某一筆的正確答案」,而是學到一個函數:輸入一組特徵,輸出「歷史上跟這組特徵相似的案例中,異常發生的比例」。這也解釋了為什麼校準在統計上一定要靠大量資料才能成立——它是一個群體層次的性質,不是單筆預測能驗證或訓練出來的,呼應官方文件那句「這些描述的是一群預測,而非對單一答案的保證」。
誠實的缺口在於,RLVR 的訓練資料相對好取得,數學題答案、程式碼能不能跑,都可以自動大量生成、自動驗證;但 RLCD 需要「大量實際發生的結果」當標籤,例如真的要有人事後確認這筆交易是不是詐欺。報告完全沒有交代 TypeSafe 是怎麼取得這些實際結果標籤的,這是訓練資料來源上的一塊資訊落差。
6 效能數據:官方頭條 vs. 第三方查證
技術路線講完了,接下來是這份報告最需要「拆穿與拆穿不了」分開看的部分——數字。
6.1 官方頭條數字怎麼算出來的
官方最常被引用的兩個數字是快 193.6 倍、便宜 444.6 倍,這是官網上的最佳案例(best case),不是平均值。速度方面,端到端延遲(70 到 500 毫秒)對比前沿模型的 3 到 329 秒,193.6 倍對應的是拿 Jev 最快的一次去除前沿模型最慢的一次算出來的,分子分母都挑了對自己最有利的極端值。成本方面,Jev 輸入 $0.042/MTok、輸出免費,拿去對比某個更貴的模型算出 444.6 倍,但官方沒有把這個數字的確切分母模型講清楚,只知道是官網最佳案例。
更有意義的數字,是官方自己做的 4-workflow benchmark(security incident、agent-trace observability、invoice processing、customer service),比較接近平均表現,而不是最佳案例:
| 模型 | 一致率 | 單次成本 | 延遲 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10–38s 區間內 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 10–38s 區間內 |
| Claude Opus 5 | 73.1% | $0.1761 | 10–38s 區間內 |
6.2 「一致率」是什麼意思,為什麼不等於「對不對」?
這張表裡 67.8% 一致率的「參考答案」不是人工標註的真值(ground truth),而是用 GPT-6 Astra 跟 Fable 5.1 兩個模型的平均答案當標準答案。這代表 Jev 的「準確率」本質上量的是「Jev 的答案跟這兩個前沿模型有多像」,不是「Jev 的答案客觀上對不對」——如果 Jev 跟這兩個模型都因為同樣的原因答錯(shared errors,共享誤差),這個方法完全偵測不出來。任何用「另一個模型的輸出」當 ground truth 的 benchmark,測出來的都是「像不像裁判」,不是「客觀對不對」。
6.3 拆開混淆變因(confound)
放回 Jev 的情境,有四個 confound 汙染了官方數字:
| Confound | 影響的數字 | 拆掉之後的效果 |
|---|---|---|
| 對手用標價、不用 cache/batch 折扣 | 238x/444.6x 成本倍數 | 真實倍數會顯著縮小 |
| System One adapter 拖慢對手 | 延遲/成本倍數 | 可能高估 Jev 相對優勢 |
| 參考答案偏向 OpenAI/Anthropic 系 | 67.8% 一致率 | 對 DeepSeek 系模型的差距可能被低估 |
| Workflow 自家設計 | 整體 67.8% 一致率 | 可能偏向對 Jev 有利的任務類型 |
第一個 confound 的細節是,官方拿 Jev 的 $0.042/MTok 對比 Claude Fable 5.1 的標價 $10/MTok 算出約 238 倍,但前沿模型廠商實際上都有 cache 折扣(重複用到的 context 部分算便宜很多,呼應前面提到的 KV cache 概念,這裡是同一個技巧在計費層面的體現)跟 batch 折扣,真實應用成本通常遠低於標價。
第二個 confound 的細節是,官方為了讓前沿模型也能輸出跟 Jev 一樣的機率格式,用了自己開源的 System One adapter 去包裝這些對手模型——這是一個相容性工具的名字,跟前言提到的「System One Model」產品命名沒有實質關聯,只是剛好共用了「System One」這個字眼,讀到這裡別誤會成同一件事。這個 adapter 本身會讓對手模型的呼叫方式變得不自然,讓對手顯得比原生使用時更慢更貴——等於拿「Jev 原生跑」對比「對手被迫穿上不合身的衣服跑」。
6.4 第三方獨立驗證的實際數字
| 來源 | 測試內容 | 速度優勢 | 成本優勢 | 準確率/一致率 |
|---|---|---|---|---|
| 官方頭條 | 官網最佳案例 | 193.6x | 444.6x | (未單獨列出) |
| 官方 4-workflow | 自訂 benchmark,對比 Sol | ~25–95x | ~209x | 67.8%(對比 74.1%) |
| Every | 37 份文件、777 判斷 | 25x(對比 Fable 5.1) | 580x(對比 Fable 5.1) | 瑕疵抓取:6/7(Fable 5.1 全中 7/7) |
| Good Start Labs | 6,003 rubric checks | (未測速度) | 1.6x(對比 DeepSeek V4.1 Flash) | 91.5%(對比 Fable 5.1);DeepSeek 是 93.5% |
| Near Here | 50 筆真實 listing 審核 | 約 5x | 約 8.6x | 96%(對比 Mistral Small 4 的 84%、Gemini 3.5 Flash-Lite 的 86%) |
這張表有三個重點值得拆開來看。
第一,「加速倍數」高度依賴拿哪個模型當分母——Every 測出 25 倍(對比 Fable 5.1),Near Here 只有約 5 倍(對比較輕量的模型)。分母模型越重越慢,倍數自然越好看,這解釋了官方為什麼挑 193.6 倍這種極端值。
第二,獨立測試的準確率結果是「持平或略遜」,不是「贏過」——目前沒有任何一組獨立測試顯示 Jev 準確率贏過同級距的前沿大模型。
第三,Good Start Labs 那組數字揭穿一個常見行銷陷阱:Jev 比 DeepSeek 便宜 1.6 倍,聽起來划算,但一致率反而比 DeepSeek 低 2 分——1.6 倍的成本優勢某種程度上是用犧牲一點準確率換來的,不是純粹的技術優勢,這種「便宜但沒那麼準」的取捨,在強調「更快更便宜」的行銷敘事裡是被淡化掉的。
6.5 效率與準確率的權衡,到底該怎麼解讀?
看到第三方獨立測試結果時,一個容易被前面「拆穿行銷」的敘事帶偏的地方是:只看到「Jev 準確率贏不了前沿模型」這一面,卻忽略了另一面——用小幅度的準確率損失,換取巨幅的速度與成本優勢,這本身是一個成立的、甚至相當有吸引力的工程權衡,不該被講成「輸了」。
把獨立測試數字換算成「犧牲多少準確率、換到多少效率」:
| 來源 | 準確率損失 | 換到的效率提升 |
|---|---|---|
| 官方 4-workflow(vs Sol) | 少 6.3 分(67.8% vs 74.1%) | 快 ~25–95x、便宜 ~209x |
| Good Start Labs(vs DeepSeek) | 少 2 分(91.5% vs 93.5%) | 便宜 1.6x |
| Every(瑕疵抓取,vs Fable 5.1) | 7 個裡少抓 1 個 | 快 25x、便宜 580x |
如果任務可以接受「準確率打 85 到 95 折」,換到的是速度快一個數量級以上、成本砍到剩零頭——對一個高頻、大量跑的判斷任務來說,是一筆划算到不像話的交易。這正好呼應前面的定位:Jev 瞄準的本來就不是「取代前沿模型做最難的判斷」,而是「用得起規模、划算跑量」的場景。
但這個框架有一個關鍵前提:這個權衡划不划算,完全取決於任務對「錯一次的代價」有多敏感。用 invoice 工作流當反例,那裡的準確率差距拉大到 17 分(61.8% vs 79.1%),如果每一次錯判都有直接財務後果,這種等級的準確率損失就不是划算的權衡,而是不能接受的風險。
更精確的判斷規則是:Jev 在「錯誤代價低、量大」的任務上,效率權衡非常划算;在「錯誤代價高」的任務上,同樣的權衡就變得危險。這條規則脫離 Jev 也成立,適用於任何「輕量模型 vs 前沿模型」的取捨判斷。
7 適用場景、問題設計原則與失效模式
7.1 官方建議情境與明確排除的任務
| 情境 | 具體例子 |
|---|---|
| AI-powered workflows,「smart if-statements」 | 分類、路由、評分、抽取、分支判斷 |
| Map-reduce 大數據 | 對每一列資料做決策(例如替每則評論打分) |
| 即時應用 | 100ms 級延遲,適合 UX 關鍵場景 |
| Verify everything | 評分、判斷、驗證、guardrail、偵測 LLM 的 jailbreak |
官方明確排除的則是聊天、程式生成、需要書面說明或理由的任務(Jev 完全不生成文字,前面三種 primitives 的輸出永遠是結構化的值,沒有「解釋」欄位)、開放式生成、算術/計數/日期運算、需要可稽核理由(auditor)的決策,以及一次性複雜推理。
把這兩邊放在一起看,能看出共同點:排除清單的共同點是都需要「輸出自然語言」或「單次深度推理」;建議清單的共同點是都屬於「答案空間已知、可以拆成結構化判斷」的任務。這條界線跟 Jev 的技術本質完全對應——它不是「刻意」不做這些事,而是「架構上就做不到」:一個只能吐出「選哪個選項、幾分、是或否」的模型,天生沒辦法生成一段解釋文字,也沒辦法做「先想一步、再想下一步」這種需要串連多輪推理的複雜任務。
實務上要提醒的是,如果工作情境需要可稽核理由——例如信用評等判斷要能寫出理由供覆核——這正好落在官方明確排除的清單裡。這不代表 Jev 完全沒用,仍可做初步分類、路由、guardrail 這類前置篩選,但「取代最終判斷並附理由」不在它的能力範圍內。
7.2 為什麼要把問題拆成很多個具體小題
官方的 meta-rule 是:避免問模型可由程式精確計算的東西;避免把多個判斷藏在一個問題裡。這條規則可行的原因,接回前面架構那一節學過的機制——因為 Jev 是平行評估,KV cache 把 state 只算一次、多個問題 batch 化一起丟進 GPU,「多問一題」的邊際成本極低,幾乎不增加延遲。這代表完全不需要像對一般 LLM 那樣「省著問」,可以放心把一個模糊、複合的判斷拆成好幾個各自獨立、範圍很窄的小問題,一次性平行問完。
假設情境是一家貿易公司的授信風險評估:與其問一個籠統的問題「這家貿易公司的授信風險高不高?」——這個問題藏了太多子判斷,財務體質、產業景氣、供應商集中度、過去還款紀錄全部混在一起,模型很難給出乾淨、可拆解的答案——不如拆成:
Q1 (Score, 1-5): 近三年營收成長穩定度評分
Q2 (Noul):       是否有單一供應商佔比超過 60% 的集中度風險
Q3 (Score, 1-5): 產業景氣週期位階評分(景氣循環底部=1,高點=5)
Q4 (Noul):       過去 12 個月是否有延遲付款紀錄
Q5 (Choice):     整體風險分級 -> [低風險, 中風險, 高風險, 需人工覆核]
因為平行評估,問 5 題跟問 1 題的延遲幾乎沒有差,但換來的是每個判斷的來源都可追溯、可拆解,可以自己寫程式碼用權重去組合這些子分數,而不是把整個判斷邏輯的黑盒子丟給模型。
7.3 拆解問題不能只拆「窄」,還要拆「淺」
上面的框架有一個沒講清楚的地方:只強調了拆的數量不影響延遲,所以放心拆,卻沒講清楚拆出來的每一個子問題,本身的複雜度也是有上限的。這是兩件獨立的事:任務能不能被拆成多個獨立子判斷,不是每個任務都能乾淨拆開;拆出來的每一個子問題,本身要不要做多步驟推理,即使只是單一小問題。
維度二為什麼會是問題?接回前面的架構機制——Jev 是非自回歸、單次前向傳播,它不像自回歸 LLM 那樣,可以先生成一段思考過程(業界說的 chain-of-thought,思維鏈:先把中間推理步驟講出來,當作一個暫存的草稿紙,再根據這個草稿紙生成最終答案)。Jev 沒有這個草稿紙機制,它是直接從輸入一步跳到輸出,結構上更接近一個分類器(input 特徵映射到 output 標籤),而不是一個會「想過一輪」才回答的推理引擎。
自回歸 LLM(有思維鏈能力):
輸入 -> 生成"先看A條件,再看B條件,兩者互斥..." -> 生成最終答案
        (這段中間文字,是模型"想事情"的過程,會影響最終答案)

Jev(單次前向傳播):
輸入 -> 直接輸出最終答案
(沒有中間"想事情"的步驟,是直接映射)有一個第三方觀察可以佐證這個推論方向:Every 這個獨立測試方明確觀察到,Jev 在「需要注意到主張不成立」這種深思型判斷上會漏掉——需要反覆推敲、質疑表面說法這種多步驟推理的子任務,Jev 表現不好。
更精確的判斷規則是:一個任務適不適合拆給 Jev 這種單次前向傳播的模型做,取決於拆出來的每一個原子問題,是不是可以在「不需要中間推理草稿」的情況下直接判斷。如果連拆到最小的那個子問題,答案本身都需要「先這樣想、再那樣想」才能得出,那不管拆得多細,Jev 都不適合。
重新檢查前面舉的 Q1「近三年營收成長穩定度評分」——要判斷「穩定」通常需要比較多年數字的變動幅度、排除單次異常值的干擾,這可能已經藏了推理。如果是這樣,該由程式碼先算好統計量(例如變異係數),Jev 只負責「看到這個已經算好的統計量,判斷算不算穩定」這種更淺層的判斷。
更務實的設計原則是:拆解子問題時,不能只拆到「主題夠窄」,還要拆到判斷本身夠淺——凡是需要「先計算、先比較、先排除干擾」這類前置推理的部分,應該用自己的程式碼先做完,只把「最後一步、不需要中間推理的判斷」留給 Jev。這其實是官方 meta-rule「避免問可由程式計算的東西」這條原則的延伸,只是從「數量」的角度推進到「深度」的角度。
7.4 官方自己揭露的失效模式
官方文件有專門一頁叫 jaggedness(意思是「參差不齊」,模型在某些地方表現很好、某些地方莫名其妙地差)。這些是實際試用時會踩到的坑,不是理論性的擔憂:
| 失效模式 | 具體內容 |
|---|---|
| 字面解讀 | 只答寫出來的問題,否定詞、範圍詞、隱含條件都照字面處理,不會自己腦補「真正想問的」 |
| 不是計算機 | 計數不可靠,誤差隨數量增大;算術必須留在程式碼裡做 |
| 日期是文字,非有序量 | 先後順序、間隔長短、是否落在某個區間,這些判斷都不可靠 |
| Context rot | state 塞進不相關的內容會拖累準確率,必須先做檢索或過濾,官方原文直接寫「Jev suffers from context rot」 |
| 不把 state 當敵意輸入 | 如果 state 裡被植入了刻意誤導、幫自己辯護的文字,答案會被影響,prompt injection 的風險要自己防 |
| 矛盾指令/criteria 會混淆 | 問題裡如果給的判斷標準彼此矛盾,模型會困惑 |
| 不生成 | 需要抽取自由文字時,要先用 regex 或另一個生成模型產生候選,再讓 Jev 從候選裡選 |
這裡有一處值得停下來說清楚:前面架構那一節強調過,Jev 的平行評估架構「不會有 context rot」是官方講的優點之一,但官方自己在 jaggedness 頁又坦承「Jev suffers from context rot」。這兩句話字面上有點矛盾,官方沒有進一步解釋這個落差怎麼來的。
比較合理的推論——這是推論,不是官方原文——是「不會有 context rot」講的可能是架構層面:平行評估不會像自回歸那樣因為生成過程變長而累積誤差;但「會有 context rot」講的是輸入層面:state 塞太多不相關資訊,還是會讓模型分心、抓錯重點,這是任何模型都有的問題,不是自回歸特有的。官方沒有明確區分這兩種 context rot 的差異,算是官方文件內部一個沒說清楚的地方。
第三方驗證也補上了一塊實務資訊:Every 觀察到 32k context 上限跟 Choice 255 選項上限在實務上會被卡到——Hacker News 上有人反應分類數量上千類的場景直接超出上限。代表除了「品質會下降」之外,還有硬性的容量上限,規模夠大的應用需要注意。
8 生態系採用狀況與批判性評價
生態系這塊可以略讀,但有幾個確有其事、可查證的部分值得記下來。LangChain 官方整合是真的——langchain-typesafe 套件,提供 TypeSafeClassifier,PR 記錄可查(langchain-ai/langchain PR #40542),代表如果想在自己的 LangChain pipeline 裡試用 Jev,現成整合已經存在,不用自己從零接 API。多家 gateway 上架(Vercel AI Gateway、Cloudflare、OpenRouter beta),接入門檻低。社群專案數量不少,但多為 launch-week demo,官方自己也點名「真正生產環境案例仍在早期」。
社群反應裡唯一值得記住的一句話,是 Hacker News 最高票留言(約 1,863 分),精準地把整份報告的核心爭議濃縮成上面這句話。
8.1 「不會幻覺」這句話,問題出在哪
官方自己在 blog 承認,0% 錯誤率這個數字不是實測出來的,而是「schema 匹配是被保證的,所以我們可以有信心地把 0% 放進圖表」。換句話說,這是一個邏輯上必然成立的數字——型別系統設計成不可能輸出非法格式,不是一個經驗上驗證過的數字——答案對不對。這兩種「0%」的性質完全不同,官方把它們並排放在同一張圖表上,是這場爭議的根源。
創辦人 Almeida 本人在 Hacker News 上也直接承認 Jev 會「schema 合法但事實答錯」,代表連官方自己都不否認這個區分,爭議點純粹在於行銷用詞(「no hallucination」)有沒有誠實傳達這個區分,而不是技術本身有問題。
8.2 命名爭議:Jevons paradox
Jev 這個名字來自經濟學裡的 Jevons paradox(傑文斯悖論):當一項資源的使用效率提高、單位成本下降時,反而可能導致總消耗量增加,因為便宜了,大家用得更多、更不節制,不一定會讓總支出下降。
官方用這個典故,是想暗示「AI 推論成本大幅下降,會解鎖數量級更多的應用場景,總體 AI 使用量爆炸性成長」這個敘事,用來替「輸出免費、輸入極低價」的定價策略做鋪墊——本質上是為商業敘事服務的命名,不是中立的技術描述。經濟學界對 Jevons paradox 本身是否普遍成立是有保留意見的,取決於需求價格彈性,所以這個命名同時賭了兩件事:這個經濟學規律真的適用,以及 Jev 真的夠便宜到觸發它。
8.3 定位爭議:「ChatGPT 共同發明人」
前面已經細講過,InstructGPT 20 位作者中的 9 位 primary author 之一,不等於「共同發明人」。這件事跟命名爭議是同一類問題——行銷措辭把一個站得住腳的事實,包裝得比實際情況更響亮。
8.4 可持續性存疑
官方自己承認無法證明目前的定價沒有被補貼——$0.042/MTok 這個價格,可能是拿種子輪資金在燒錢換市佔,不是真實反映服務成本的可持續價格。這點呼應前面「定價比較忽略 cache/batch 折扣」的問題:如果 TypeSafe 之後漲價,238x/444.6x 這類倍數會直接縮水,第三方獨立測試的數字反而比較不受這個風險影響,因為那些是實測延遲與實際判斷品質,不是純粹的計費策略。
整體來說,Jev 的技術路線是紮實的,問題主要出在敘事層面的誇大——把「型別安全」講成「不會幻覺」、把「InstructGPT 作者之一」講成「共同發明人」、用 Jevons paradox 包裝定價策略。技術本身該打的折扣——準確率中段班、架構未公開——前面已經談過了。
9 脫離這篇報告也成立的東西
除了 Jev 這個產品本身,梳理這份報告的過程裡,有幾個判斷框架其實跟 Jev 無關,拿去看任何一個新的 AI 產品或訓練方法都用得上。這一節按耐久度排序,排越前面的,價值越不會隨 Jev 這個產品本身的興衰而消失。
9.1 Proper scoring rule:誠實預測在數學上有必然優勢
這不是 Jev 或 RLCD 的專利,而是統計與機率論裡一個很老的概念:只要設計得當的計分規則,像 Brier score,模型或預測者誠實報告自己的真實信心,期望分數必然不會輸給「講得比較篤定」。前面已經用具體數字驗證過:真實異常機率 65% 的情境下,誠實猜 0.65 的期望 Brier score(0.2275)低於過度自信猜 0.97 的期望 Brier score(0.3298)。這條原理適用於任何需要校準的預測系統,不只機器學習——天氣預報的降雨機率、醫療診斷的信心水準,背後都是同一套數學。
9.2 RLHF / RLVR / RLCD 的 reward 來源判斷框架
這三個訓練方法的根本差異,可以濃縮成一句話各自的 reward 從哪來:
RLHF: reward = 另一個模型的主觀判斷      -> 訓練出「討好」
RLVR: reward = 規則驗證對錯              -> 只適用有標準答案的任務
RLCD: reward = 數學公式(proper scoring)  -> 訓練出「誠實的機率」
之後遇到任何新的訓練方法,都可以先問「這個方法的 reward 從哪來」,套進這張座標圖裡定位——這比記住每個方法的名字更有用,因為新方法會一直冒出來,但「reward 來源」這個分類軸不會過時。
9.3 「一致率」不等於「對不對」
任何用另一個模型的輸出當 ground truth 的 benchmark,測出來的都是「像不像裁判」,不是「客觀對不對」,尤其要留意 shared errors——裁判跟被測模型因同樣原因一起答錯——完全偵測不出來這件事。以後看到任何「跟前沿模型的一致率 X%」這種宣稱,第一個要問的問題就是:參考答案是誰定的?是人工標註的真值,還是另一個模型的輸出?
9.4 Confound(混淆變因)的識別習慣
任何效能對比數字出現之前,先問三個問題:分母怎麼選的?評測方法本身有沒有讓某一方吃虧,例如被迫用不自然的方式跑?參考答案的選擇會不會系統性偏袒某一方?這三個問題幾乎可以拆穿市面上大多數誇大的 benchmark 宣稱。
9.5 KV cache 加 batch 化:「感覺像一次算完」的工程原理
不是魔法,是「共用部分只算一次」(KV cache)加上「多個請求疊在一起丟進 GPU」(batch 化)兩個業界通用技巧疊加的體感效果。這個原理不只 Jev 用得到,vLLM、Anthropic API 等任何需要處理大量帶共同前綴請求的系統都用得到——理解這個原理,之後評估任何宣稱「超快」的 AI 服務時,都可以先猜測背後是不是靠這個組合技。
9.6 拆解問題不能只拆「窄」,還要拆「淺」
一個常見的誤區是只拆「窄」、不拆「淺」:子問題主題夠窄還不夠,如果連拆到最小的那題都需要中間推理草稿(先算、先比較、先排除干擾),就不適合丟給沒有思維鏈能力的單次前向傳播模型,該由程式碼先做掉前置計算。這條規則的更底層原理是,思維鏈能力來自「能不能生成中間過程」這個架構特性,不是模型大小或訓練方法決定的——任何非自回歸、單次映射的模型,不只 Jev,天生都缺乏這個能力,遇到這類模型時,第一件事就是檢查任務是否偷偷藏了需要多步驟推理的部分。
9.7 效率換準確率的 trade-off,划不划算取決於錯誤代價
小幅準確率損失換取數量級的速度或成本優勢,在「錯誤代價低、量大」的任務上是划算的工程決策;在「錯誤代價高」的任務上,同樣的權衡就變得危險。這個框架不只用來看 Jev——任何「輕量方案 vs. 重量級方案」的選擇,不管是 AI 模型、系統架構,還是演算法選型,都可以先問一句:這裡錯一次的代價有多高?再決定要不要接受效率換來的準確率折損。
10 結論
Jev 想補的空隙是真的存在的:傳統分類器太死板,直接叫 LLM 又慢又貴還不可靠,Jev 想同時拿到 LLM 的彈性跟分類器的速度、成本、型別安全。速度與成本優勢的方向也是真的,第三方獨立測試普遍落在 5 到 25 倍之間,雖然遠不如官方頭條的 193.6 倍與 444.6 倍那麼誇張。型別安全這個工程價值同樣是真的,省掉了 parsing 和 retry 的麻煩。
但該打折扣的地方也很具體:「不會幻覺」只保證格式合法,不保證答案正確;準確率是中段班,而且隨錯誤代價升高會擴大差距;RLCD 的架構細節、reward function 設計、訓練資料來源、校準曲線全數未公開,外界無法完全驗證;創辦人背景與定價策略也都有被行銷措辭放大的痕跡。
最後能留下的一句話判斷規則是:錯誤代價低、量大的任務——分類、路由、guardrail 前置篩選——Jev 這類產品的效率權衡非常划算;錯誤代價高的任務——金流、法遵、需要可稽核理由的判斷——應該保留前沿大模型,或只把 Jev 當第一道篩選。