模型、訓練與推論是什麼?用手拉坯比喻搞懂三者關係
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 前言
在 Machine Learning 的世界裡,模型 (Model)、訓練演算法 (Model Training Algorithm) 與推論演算法 (Model Inference Algorithm) 是三個一定會反覆遇到的名詞。這篇文章會把這三個概念從頭講清楚:模型到底是什麼東西、訓練的時候電腦實際上在做什麼、以及訓練完之後我們怎麼使用它。
如果對 Machine Learning 本身還沒有概念,建議先看過系列前一篇〈什麼是機器學習?〉再回來,接下來的內容會假設你已經知道機器學習大致在做什麼。
- 模型 (Model):一個帶有參數的函式,輸入一種東西、輸出另外一種東西。
- 訓練 (Training):反覆調整模型參數,直到輸出達到我們滿意的水準。
- 推論 (Inference):拿訓練好的模型去預測沒看過的資料,是模型真正產生價值的階段。
- 三者的關係:不是三個獨立的東西,而是同一個模型在不同階段的樣子,就像手拉坯:黏土、雕塑、成品測試。
2 模型、訓練與推論的概念
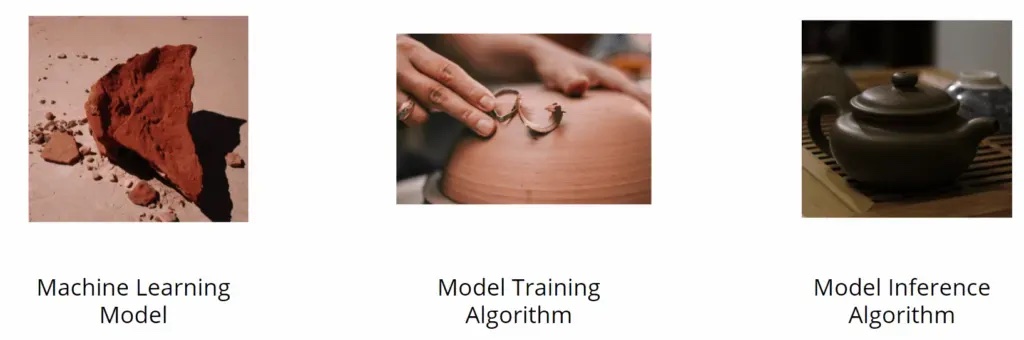
第一次碰 Machine Learning 的人,通常會先被一堆專業術語嚇到。所以在進入數學之前,先用一個生活化的比喻把三者的關係串起來:手拉坯。
「模型」就像是一塊還沒經過雕塑的黏土。「訓練」是我們用雙手去雕塑這塊黏土的過程,目標不同,雕塑的手法就不同,所以機器學習中也才會有這麼多種訓練演算法。至於「推論」,則像是容器捏好、燒好之後拿去測試:裝點液體進去,確認它真的能用。
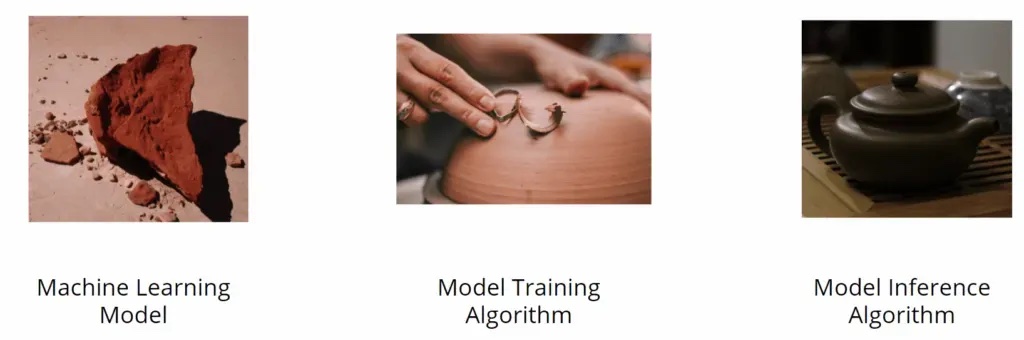
換句話說,這三者不是三個獨立的東西,而是同一個模型在不同階段的樣子。
3 機器學習模型是什麼
換個角度,用數學的形式來看,模型其實就是一個「函式」(Function)。沒錯,就是國中學過的那個 y = f(x)。函式的概念很單純:輸入一個東西,輸出另外一個東西。
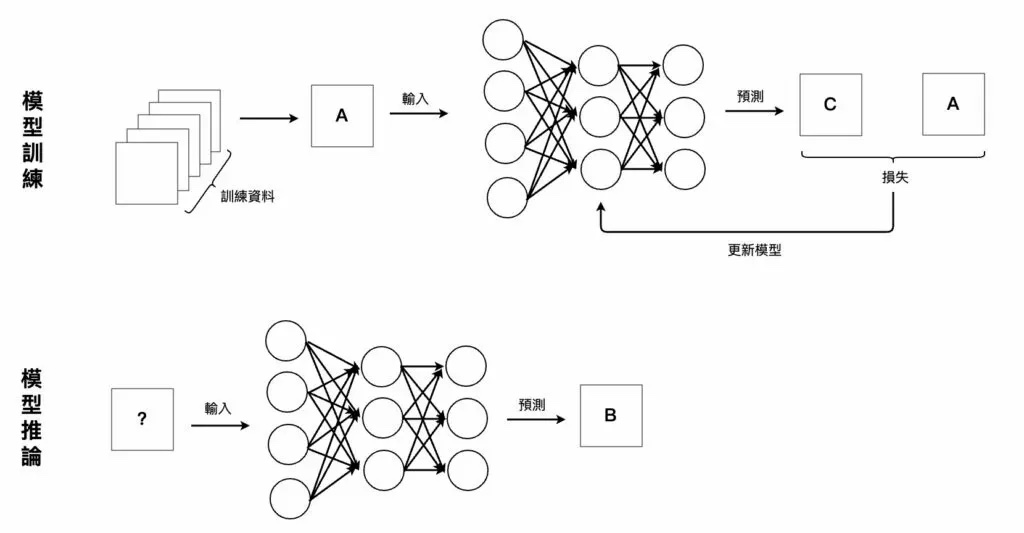
為了解決不同的問題,我們需要不同的函式。例如下圖就是一個函式:輸入一張圖片,輸出這張圖片的類別。
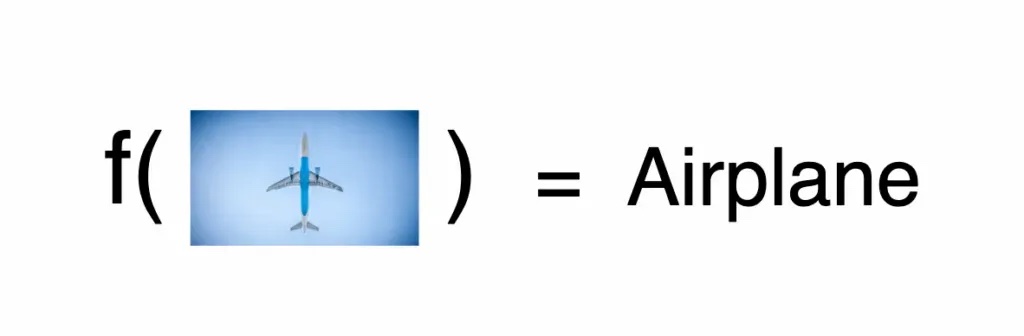
又或者是下面這個函式:輸入房子的坪數,輸出這間房子的價格。這個例子後面會一路用到底,可以先記著。
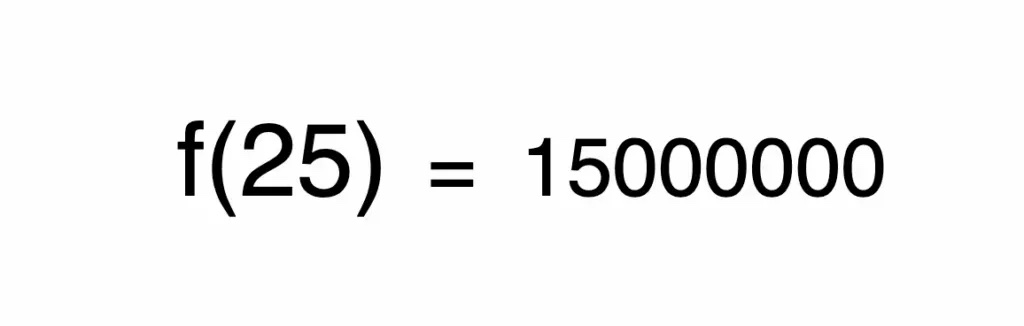
既然模型就是函式,函式裡自然會有參數。例如下方的函式中就包含了 、 與 三個參數。這些參數才是模型真正「學到的東西」,同一個函式形狀,換一組參數就是完全不同的模型。
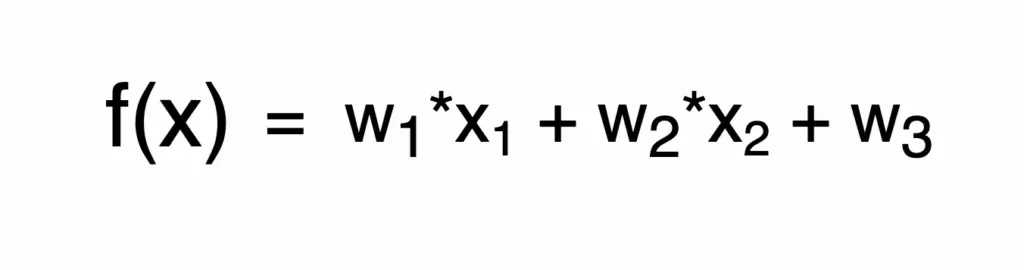
回到房價的例子。為了訓練出一個「輸入坪數、輸出價格」的模型,我們會準備很多樣本 (Sample) 給模型學習,每一個樣本裡都包含兩個數值:(坪數 => 價格)。
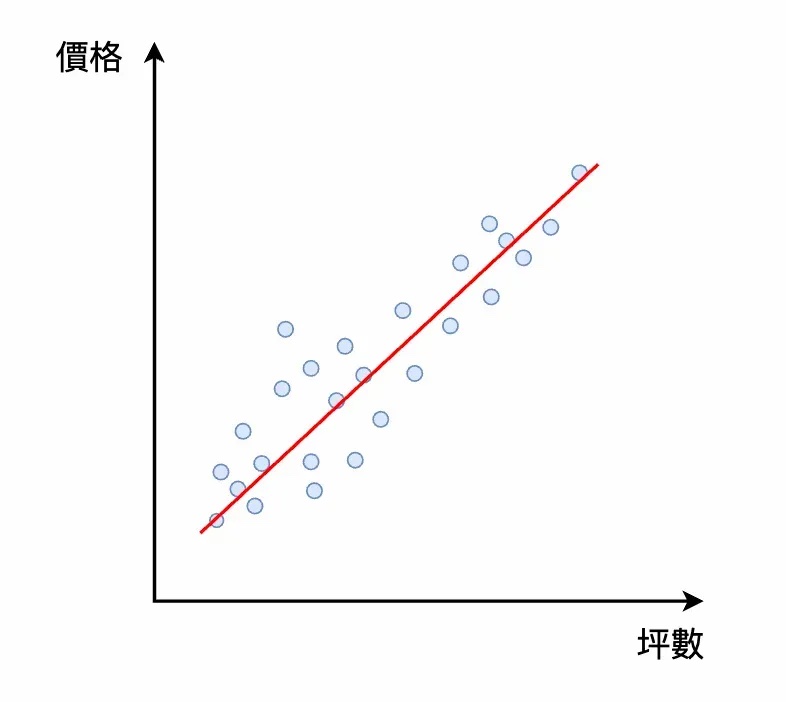
把這些 (坪數 => 價格) 的樣本通通畫在一個二維平面上,就是圖中那些藍色點點。我們希望模型能透過這些藍色點點自動調整自己的參數,讓它在輸入一個坪數之後,可以輸出一個夠準確的價格。也就是說,圖中那條紅色的線,就是我們希望得到的模型。
4 模型的訓練是什麼
「模型學習調整自己的參數」的這個過程,就是訓練模型。
訓練是一個不斷重複的流程,每一輪裡面包含兩個行為:
- 找到模型中參數調整的方向與大小
- 對參數進行調整
重複這兩個行為,直到模型的輸出達到我們滿意的水準為止。
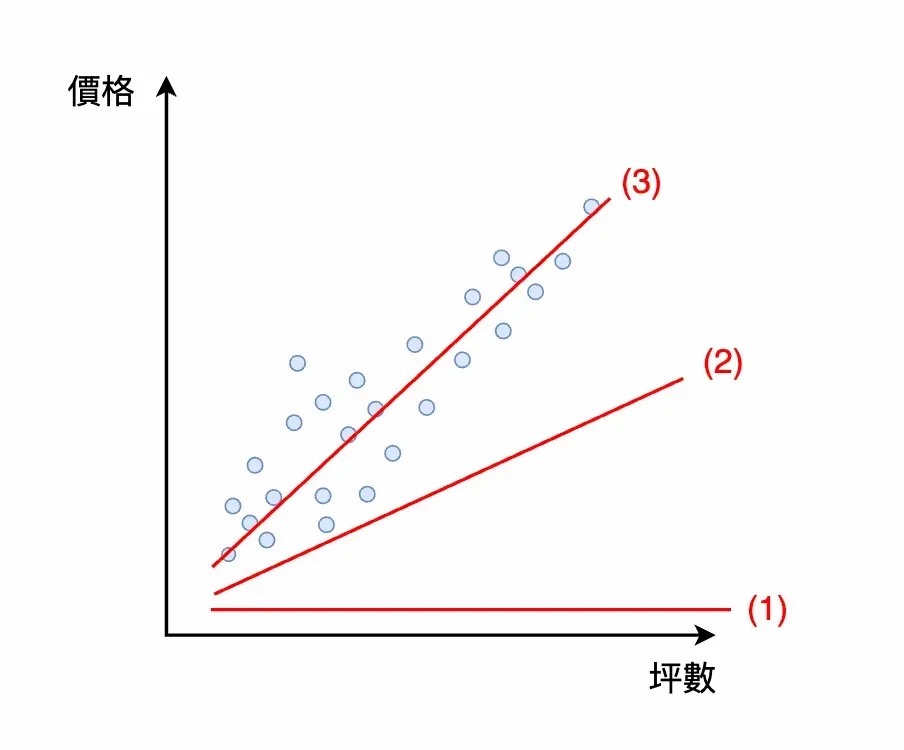
以「輸入坪數、輸出價格」的模型為例。一開始的模型可能只是一條水平線 (1),不管輸入什麼坪數,它都吐出同一個價格,顯然不能用。模型調整一次參數後,變成稍微斜一點的直線 (2),坪數愈大、輸出的價格也跟著愈大,輸出開始像樣了。隨著參數調整的次數愈來愈多,價格預測得愈來愈準,最終就變成我們想要的模型 (3)。
5 模型的推論是什麼
模型訓練完之後,內部的參數已經經過多次調整,面對不同的輸入,輸出也達到我們滿意的水準。接下來就進入推論階段。所謂的推論,說白了就是正式開始「使用模型」。
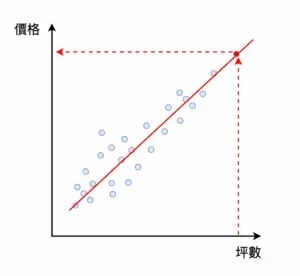
在「輸入坪數、輸出價格」的例子中,模型在訓練階段看過了圖中的藍色樣本,經過多次調整參數之後成為現在的模型 (紅色線)。未來當我們拿到一個只有坪數、沒有價格的樣本時,就能把它丟進這個訓練好的模型,得到預測出來的價格 (紅色點點)。這也是模型真正產生價值的階段:訓練只做一次,推論則會被用上無數次。
6 結論
這篇文章把 Machine Learning 中的模型 (Model)、模型訓練 (Model Training) 與模型推論 (Model Inference) 走了一遍:模型是一個帶參數的函式,訓練是反覆調整這些參數的過程,推論則是拿訓練好的模型去預測沒看過的資料。
下一篇文章會接著談,當我們遇到一個需要用 Machine Learning 解決的問題時,應該依循哪些步驟把問題定義清楚、再一步步解掉。