該不該拆 Subagent?Anthropic 談把多 Agent 折回單一 Agent Loop
 Hong-Wei Wu
收錄於 基本 AI 觀念
1 一個沒說錯、卻漏掉發票的 subagent
客人問客服 agent:「這筆訂單能不能退?發票怎麼處理?」系統把問題轉給專管退貨的小 agent。它讀完訂單原文,回報一句「可退貨」,這句話完全正確。可是這張訂單的發票已經開立、要先作廢;發票不在它的任務範圍,所以沒寫進回報,負責回答客人的那個 agent 永遠不會知道。沒有人做錯事,資訊卻在交接時掉了。(這是為了說明而設計的情境,後面會一直用到它。)
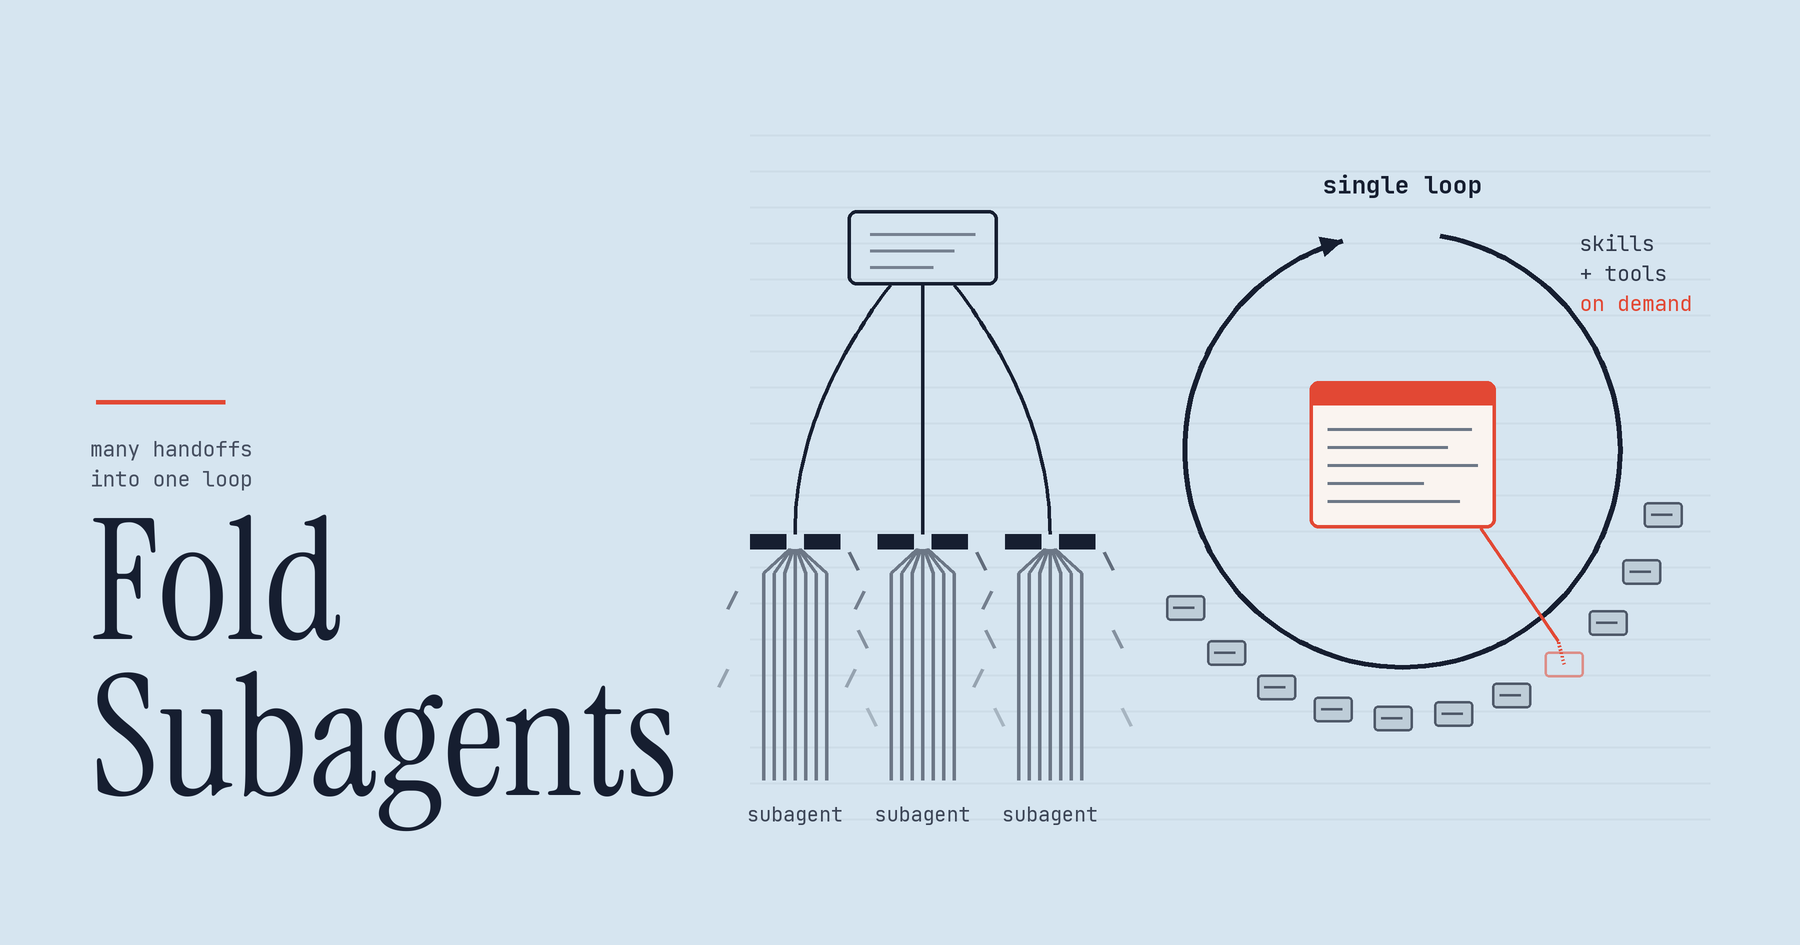
這種「交接」在企業的 agent 系統裡到處都是。所謂 agent,是一個會反覆呼叫工具、看結果、再決定下一步的 LLM 程式。企業裡的 agent 很常長成這樣:每個團隊各做一個 subagent(被上層叫去處理某一件子任務的 agent),平台團隊再疊一個 orchestrator(負責把問題分派給各個 subagent 的上層 agent)。Anthropic 最近一篇文章主張,這種架構很多時候可以折回單一 agent loop。
核心理由是:每一條 subagent 邊界都是一次有損的 context(模型當下看得到的全部資訊)交接,而這些邊界常常只是組織圖的投影,不是技術上非切不可。這就是 Conway’s law:系統結構會複製設計它的組織的溝通結構,後面有一整節專門談它。
當然也不是全部都要折。文章列了三種仍該保留 subagent 的情況,後面〈多切一個 agent 之前先問一句〉會逐一舉例。
接下來先看多 subagent 架構為什麼會出問題,再看文章想要的單一 loop 長什麼樣、怎麼一步步折過去、團隊之後負責什麼,最後談 agent 為什麼會長成組織圖,以及文章證據上的缺口。
原文:Building agents: When to fold subagents into your main agent loop(Anthropic,Diane Sarkis,2026 年 10 月 22 日)。文中標(推論)的是筆者在文章之外的推斷,標(自編)的是為了說明而設計的情境,標(一般知識)的是業界通用的背景知識;沒有標的都是文章內容。
2 多 subagent 架構為什麼會出問題
先從問題講起:「每個團隊各做一個 subagent,再疊一個 orchestrator」看起來最省事,為什麼文章認為它常常不值得?
2.1 五種失敗模式
這種架構實際跑起來,複雜度會一路往上堆。文章列了五種失敗模式(表中的 eval 是一組固定的測試題,用來替 agent 打分):
| 失敗模式 | 發生了什麼 |
|---|---|
| Context 管理 | 要決定 agent 之間交換哪些資訊,來回傳遞時細節會掉 |
| Subagent 氾濫 | 每個團隊各出一個,最後有大量功能重疊、沒有標準、沒有負責人的 subagent |
| Frankenprompt | 每個團隊往 system prompt 加一句,規則互相衝突,語氣也不一致 |
| Eval 過度局部 | 各團隊只為自己的子任務調分數,沒人維護整體,決策依據是被稀釋過的分數 |
| 延遲 | 多層架構本身就拉長時間。有個客戶把多 agent harness(包在模型外面、負責執行工具與設上限的程式)換成單一 loop,執行時間約快 2 倍(單一案例,見〈這些主張有多扎實〉) |
2.2 最根本的問題:每次交接都是一次有損摘要
五項裡最根本的是第一項。Subagent 做完事,回傳給主 agent 的是它自己寫的摘要,不是原始資料;摘要省略了什麼,主 agent 完全看不到。
回到開頭的例子(自編)。使用者問:「這筆訂單能不能退?發票怎麼處理?」同一個問題,在兩種架構下的資訊流是這樣:
| 拆成 subagent | 單一 loop | |
|---|---|---|
| 誰讀訂單原文 | 退貨 agent 讀完訂單原文 | 主 agent 自己讀訂單原文 |
| 主 agent 拿到什麼 | 只有摘要:可退貨 | 原文,看得見發票狀態 |
| 結果 | 主 agent 不知道發票已開立、需先作廢 | 回答時一併處理作廢 |
圖 1 — 同一個問題在兩種架構下的資訊流:差別在於摘要由別人寫,主 agent 拿不到被省略的細節。(自編例子)
退貨 agent 沒有做錯事,「可退貨」本身是對的。問題是發票狀態不在它的任務範圍內,所以沒進摘要。這些交接邊界是從哪裡來的,〈值得帶走的觀念:Conway’s law〉會回頭講。
小結:多 subagent 架構的毛病很多,但最根本的是每次交接都經過一份別人寫的摘要,被省略的細節就此消失。
3 目標架構:單一 loop 加上漸進式揭露
問題清楚了,再看文章想要的樣子:在 loop 裡反覆「呼叫工具、看結果、決定下一步」,知識和工具平常只放目錄,需要時才載入。
具體來說是一個模型、一個 context window(模型一次能看到的全部內容,包含指令、對話紀錄與工具回傳的結果)。領域知識寫成 skills(寫給 agent 看的做事說明),能力做成 tools(agent 可以呼叫的功能,例如查訂單),兩者平常都只放一份目錄。這一節分四步看:怎麼按需載入、為什麼比拆 subagent 好、loop 怎麼跑,以及原本的元件搬去哪。
3.1 漸進式揭露:平常只放目錄,需要才載入
漸進式揭露(progressive disclosure)的意思是:agent 一開始只看到每個 skill 和 tool 的名稱加一行描述,真正需要時才把全文或完整定義載入 context。
用同一個客服例子(自編),這次使用者問「我的訂單到哪了?」:
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    q["使用者:我的訂單到哪了?"]
    ctx["一開始就在 context(很短):skill 目錄、tool 目錄、精簡的 system prompt"]
    l1["物流 skill 全文"]
    l2["查訂單 tool"]
    n1["退貨 skill、發票 skill:這次沒用到,不占 context"]
    q --> ctx
    ctx -->|模型判斷後載入| l1
    l1 -->|需要時呼叫| l2
    l2 -->|其餘留在目錄| n1
圖 2 — 漸進式揭露:skill 目錄只有名稱加一行描述,tool 目錄只有名稱加簡述;只有這次被用到的 skill 和 tool 會進入 context。(自編例子)
這個概念套在兩種東西上:
- Skill:寫給 agent 看的做事說明,包含步驟、規則與判斷方式。原本寫在各個 subagent prompt 裡的專業知識,就搬到這裡。
- Tool search:同一個想法套用在工具上,工具定義延遲到需要時才搜尋並載入。
當初拆 subagent 的主要理由,是「所有專業知識塞進一個 prompt 會太長」。知識改成按需載入之後,這個理由就不成立了。
3.2 為什麼比拆 subagent 好
文章給了三個理由:
| 理由 | 內容 |
|---|---|
| 共享 context | 前面每一步的原始結果都在同一個視窗裡,agent 能自己把它們串起來(圖 1 的發票狀態就是例子) |
| 防止 context 膨脹 | 知識放在按需載入的 skill,不必一次塞進 prompt |
| 模型變強了 | 一個 loop 能管的事變多,不需要 harness 替模型拆步驟 |
前兩個理由各配了一份證據:
- 共享 context:多個企業部署的比較中,單一 agent 加 skills 在品質上「經常」勝過單一大 prompt 與 subagent 設計,成本與延遲也「常常」比較低。
- 防止 context 膨脹:Claude Code 針對較強的模型,把 system prompt 縮減了超過 80%。這個縮減「包含」漸進式揭露的效果,但不全是它的功勞(文章沒說其餘來自哪裡)。
這兩份證據有多扎實,〈這些主張有多扎實〉會回頭檢查:前者沒有數字,後者是 Claude Code 自己的經驗。
第三個理由,文章的說法是:從 Opus 4.5 起,模型能在單一 loop 裡處理的事比多數團隊預期得多。近期的模型會邊做邊交代進度、檢查自己的結果,讓部分 harness 設計變得多餘。每出一代新模型,就能把更多決策從 harness 移到模型身上;過於死板的多 agent 結構,反而常常是新模型發揮不出來的原因。
那模型要多強才能折?文章沒有給門檻,而是用症狀和 eval 取代門檻:折疊後分數比較差才保留 subagent,再搭配開頭提到的三個保留條件判斷(context 膨脹、需要平行乾淨的 context、選錯工具或指令衝突,詳見〈多切一個 agent 之前先問一句〉)。較弱的模型會更早出現這些症狀,流程依然適用,只是能折進去的 subagent 比較少(推論)。
3.3 Loop 怎麼運作:寫計畫的就是執行的
知道了 context 裡放什麼,再看 loop 本身怎麼轉。這裡的 harness 指包在模型外面的程式;決策都由模型做,harness 只負責執行工具與設上限:
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    p["模型寫計畫(寫在 context,可隨時改)"]
    t["模型輸出一批 tool calls"]
    h["harness 平行執行,原始結果直接回傳"]
    b["harness 上限:回合預算、成本預算、寫入閘門;超出預算也會停"]
    d["模型決定下一步"]
    u["問使用者"]
    a["回答並結束(可選:再跑目標或驗證檢查)"]
    p --> t
    t --> h
    h -->|受限於| b
    b --> d
    d -->|再跑一批| t
    d -->|缺資訊| u
    d -->|足夠| a
圖 3 — 單一 loop 的運作:決策都由模型做,harness 只負責執行與設上限。
和 orchestrator 架構最大的差別是:寫計畫的模型,就是執行計畫的模型。在 orchestrator 架構裡,planner 寫好計畫交給 specialist(負責單一領域的 subagent)執行,中途發現不對很難改;在單一 loop 裡,模型每看到一批新結果,就能當場修改計畫。
圖中的寫入閘門(write gate)文章沒有定義,可以理解成修改資料前的檢查或核准(推論)。
3.4 原本的元件搬去哪
折成單一 loop 之後,多 agent 架構裡的各種元件不會憑空消失,而是各自找到新的家。表中第一列的 router 與意圖分類器,指的是先判斷「這個問題該交給哪個 subagent」的元件,也就是分派工作的那一環(一般知識):
| 原本的元件 | 搬去哪 | 理由 |
|---|---|---|
| router、意圖分類器 | 模型讀目錄,自己挑 skill 和 tool | 選擇本身就是模型擅長的判斷(推論;文章只說 router 被折進主 loop) |
| 依規則改寫計畫的程式碼 | 不需要了 | 模型每一步自己決定 |
| 步驟順序、領域流程 | skills | 這是「團隊怎麼做事」的知識 |
| 硬限制(驗證、核准閘門) | tools 內部 | 必須百分之百遵守,不能靠模型記得 |
| 對話中途才需要的事(例如查記憶) | tools | 需要時才呼叫 |
| 便宜、幾乎每次都用到的東西(例如 entity resolution,把口語說法對應到具體訂單) | 程式碼預先載入 | 不值得讓模型每次都決定一遍 |
| 機械式處理(組 API 請求、解析串流、問完使用者後接回流程) | 程式碼,包在 tool 裡 | 固定步驟 |
表中兩個詞補充一下。Entity resolution 是把使用者口中的「上週那張單」對應到系統裡具體的訂單 ID(一般知識)。「問完使用者後接回流程」原文是 resuming a clarification,文章沒有解釋,這裡的理解是推論。
「硬限制放進 tool」值得多說一句:規則寫在 prompt 裡,只是「請」模型遵守;寫在 tool 的程式碼裡,則是條件不符時直接擋下,並回傳模型看得懂的訊息。具體做法見〈Tool 的設計:依意圖分組,規則寫在程式碼裡〉的圖 5。
小結:單一 loop 靠漸進式揭露解決「prompt 太長」,讓模型自己寫計畫、自己改計畫;原本散在各 subagent 的東西,依「要判斷、不能違反、固定步驟」分別搬進 skill、tool 和程式碼。
4 怎麼折:用 eval 把關的分階段遷移
目標架構清楚了,接著是最實際的問題:已經有一堆 subagent 在跑,要怎麼搬過去?遷移的原則是一次只改一件事,每一步都用 eval 確認沒有退步。要不要折,由分數決定,不由直覺決定。
4.1 先建 eval
Eval 分兩層:中央團隊維護一套端到端 eval,各團隊上線 skill 時,附上只測該 skill 的小 eval。起步用 10 個 golden examples(人工確認過正確答案的範例)就夠了。要量哪些指標、題目要涵蓋什麼、怎麼比較、怎麼判斷去留,整理在文末的〈深入:折疊 subagent 時要 eval 的五個面向〉。
4.2 三種做法,依序進行
文章給了三種做法。這裡把它們讀成依序進行的階段(推論;文章沒有明說,依據見本節最後的摺疊區):
A. 把 subagent 當 tool 呼叫。 主 agent 把 subagent 當成一個工具呼叫,自己持續握著和使用者的對話。好處是不必改寫 subagent,就能先拿到 baseline(之後每一步拿來比較的基準分數);同時可以統一各 subagent 的回應格式,讓主 agent 拿真實資料去核對 subagent 的結論。只有在 subagent 必須親自和使用者對話時,才讓它直接接手整段對話(full handoff)。
B. 合併 domain agents。 從使用量最大的開始,把會串接彼此輸出、碰同一份資料、常被一起呼叫的 specialist 合併。怎麼找出這種組合?看生產流量:如果很大一部分流量是「specialist 1 做完,接著叫 specialist 2」,這兩個就是緊密耦合的一對。
C. 折成 skills 加 tools。 一次一個:subagent 的 prompt 改寫成 skill,它呼叫的 API 改成 MCP tool(MCP 是 Model Context Protocol,讓 agent 透過統一介面呼叫外部工具的協定;一般知識)。有和沒有這個 subagent 分別跑一輪 eval,再決定去留。
串起來就是這樣一條流水線,最後只留下折疊後會退步的 subagent:
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    e["建立 eval"]
    a["A. subagent 當 tool:不改寫,取得 baseline"]
    b["B. 合併高耦合的 subagent:數量變少"]
    c["C. 一次折一個:prompt 改成 skill,API 改成 MCP tool"]
    g["折疊版分數比較差?"]
    k["保留該 subagent"]
    f["留在主 loop,換下一個"]
    e --> a
    a --> b
    b --> c
    c --> g
    g -->|是| k
    g -->|否| f
圖 4 — 分階段遷移:每一步都有 eval 把關,最後只留下折疊後會退步的 subagent。
4.3 總分一樣,也可能藏著退步
每一步都要比分數,但比的方式有講究:折疊後不能只看總分,要逐題比對,哪些任務從通過變失敗,哪些從失敗變通過。假設 eval 共 20 題(自編):
| 折疊前 | 折疊後 | |
|---|---|---|
| 通過題數(共 20 題) | 15 | 15 |
| 題號 3、7 | 通過 | 失敗 |
| 題號 11、18 | 失敗 | 通過 |
總分一樣是 15 題,但如果題號 3、7 這兩題是絕對不能錯的流程,總分就把退步藏起來了。
文章給了一個實例。一個示範用的客服 agent,把一個 subagent 折進另一個之後,延遲下降了,但一個原本通過的流程壞掉:主 agent 手上已經有查訂單的 tool,就自己回答了,沒有去問物流 specialist 實際的送達日期。而且這個失誤在兩次執行中只出現一次,只跑一次很可能根本抓不到。
小結:先建 eval,再依序「當 tool、合併、一次折一個」;每一步逐題看翻轉、每題多跑幾次,折疊版分數比較差才保留 subagent。
5 沒有各自的 agent 之後,團隊要負責什麼
架構折成一個之後,原本各做一個 subagent 的團隊不會消失。他們要做什麼?
沒有各自的 agent 之後,團隊的角色變了:各團隊不再擁有一個 agent,而是貢獻 skills、tools 或知識庫。一個小型中央團隊擁有 system prompt 與端到端品質,每個新的 skill、tool、eval 上線前都要經過它審核。中央團隊要刻意保持小,迭代才快,協調成本才低。
5.1 Tool、skill、知識庫怎麼選
團隊貢獻的東西有三種載體,用客服例子(自編)對照:
| 載體 | 適合放什麼 | 例子(自編) |
|---|---|---|
| MCP tool | 要執行動作、讀即時資料,或要回傳固定格式的結果 | 查訂單狀態、送出退款 |
| Skill | 團隊「怎麼做事」:步驟、規則、判斷方式 | 退貨流程與例外判斷 |
| 知識庫 | 偶爾才需要的參考資料:政策、指標定義、產品規格 | 退貨政策全文 |
知識庫有兩種放法:放在搜尋或查詢 tool 後面,讓模型自己呼叫;或者當成參考檔案放進 skill。文章要求避免的是「由程式碼先檢索,再直接貼進 prompt」。理由文章在這裡沒說,合理的解讀是:讀不讀、讀哪一段,應該交給模型按需決定(推論)。
5.2 Tool 的設計:依意圖分組,規則寫在程式碼裡
依使用者意圖分組,不要一支 API 一個 tool。 System prompt 裡的 tool 定義超過 30 到 50 個,工具選擇的準確度通常會下降(文章沒說是哪個模型、哪類任務的觀察)。不常用的 tool,再用 tool search 延遲載入。
| 做法 | tool 長什麼樣(自編) | 模型要做的選擇 |
|---|---|---|
| 一支 API 一個 tool | get_order、get_shipment、get_carrier_status | 自己判斷要串哪幾個、按什麼順序 |
| 依意圖分組 | track_order,內部依序呼叫三支 API | 只要判斷使用者想追包裹 |
前置條件寫進 tool。 如果 Y 需要 X 的輸出,就由 Y 的 tool 自己檢查,缺少時回傳一段模型能照著做的指示。硬性前置條件要盡量少,只保留真正必要的。以退款為例(自編):
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    r1["模型呼叫 refund(訂單 A)"]
    x["refund tool 回覆:尚未驗證身分,請先呼叫 verify_identity"]
    v["模型呼叫 verify_identity"]
    r2["模型再呼叫 refund(訂單 A)"]
    ok["refund tool 回覆:退款已送出"]
    r1 --> x
    x --> v
    v --> r2
    r2 --> ok
圖 5 — 前置條件寫在 tool 裡:規則不靠模型記得,而是由 tool 的程式碼擋下並指路。(自編例子)
權限檢查寫進 tool。 每個 tool 自己檢查呼叫者能看什麼、能做什麼,不行就回傳一句白話的拒絕。這樣同一個 loop 就能服務不同權限的使用者,不必每個權限等級各做一個 agent。
遷移期間,tool 也可以用來包住還沒折進去的 subagent,也就是〈三種做法,依序進行〉裡的做法 A。
5.3 Skills 怎麼維護、不氾濫
Subagent 拆掉之後,「氾濫」這個問題很可能換成 skill 的形式重演。文章的做法:
- 每個團隊指定一位 DRI(Directly Responsible Individual,直接負責人,來自管理領域的用語)負責自己的 skill,確保寫得好、不和其他 skill 重疊,並附上 eval。
- 維護責任交還給寫 skill 的人,粗重的工作則交給 Claude:用專門的 skill 去建立、測試、刪減其他 skill。
- 依使用量與成本資料決定去留,沒人用的 skill 就刪掉。
Anthropic 提供了對應的指令,涵蓋建立與整理 skill(/skill-creator)、查看成本與使用頻率(/skill-doctor)、建 eval、找出為舊模型寫的指令、對著 eval 反覆改進描述,以及成本優化。實際名稱與用法以官方文件為準。
至於 skill 的描述要怎麼寫,才會在對的時機被觸發?文章沒有給寫作規則,而是用 eval 反覆調整描述,直到折疊版的分數追上或超過原本的 subagent。
小結:團隊從「擁有一個 agent」改成貢獻 tool、skill 或知識庫;tool 依意圖分組,前置條件和權限寫在 tool 的程式碼裡;每個 skill 有人負責、有 eval,沒人用就刪。
6 值得帶走的觀念:Conway’s law
回到開頭留下的問題:那些交接邊界是從哪裡來的?這是整篇文章裡最能脫離 agent 單獨帶走的觀念。Conway’s law 說:設計系統的組織,做出來的系統結構會複製組織自己的溝通結構。Agent 架構變成組織圖的複製品,就是這個定律在 agent 上的表現。
6.1 這個定律從哪來、為什麼成立
Conway’s law 由 Melvin Conway 在 1968 年提出,屬於軟體工程與組織設計領域,在討論微服務該怎麼切分時很常見,在 AI agent 領域則還少見(一般知識)。文章是把它當成真正的診斷工具在用,不是借個名詞來裝飾。
它為什麼成立,可以拆成三步(一般知識加推論):
- 每個團隊只能輕鬆修改自己擁有的部分。
- 跨團隊的介面要協調,成本很高,所以系統邊界自然落在團隊邊界上。
- 每個團隊只為自己那一塊負責,也就只為那一塊優化,例如寫只測自己子任務的 eval(也就是前面五種失敗模式裡的「Eval 過度局部」)。
結果是:系統邊界依「誰負責什麼」劃分,而不是依技術需求劃分。
6.2 放到 agent 上為什麼特別傷
一般軟體的團隊邊界會變成 API 邊界,資料還能完整傳過去。Agent 的邊界卻是 context 的邊界,每一條團隊邊界都變成一次有損的摘要交接,就像圖 1 裡那張沒被提到的發票。
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    o["組織:退貨團隊、物流團隊、發票團隊"]
    a["各自做一個 agent,再疊一個 orchestrator"]
    x["每一條團隊邊界 = 一次 context 交接 = 一次資訊流失"]
    o --> a
    a --> x
圖 6 — 組織圖投影成 agent 架構,團隊邊界變成資訊流失點。
文章的例子:一家公司的客服 agent 底下有十幾個 specialist subagent,品牌語氣難以保持一致,延遲也傷害了使用者體驗。
6.3 多切一個 agent 之前先問一句
「如果整個系統只由一個團隊負責,這條邊界還會存在嗎?」
- 會存在:代表有技術理由,例如可量測的 context 膨脹、需要平行且乾淨的 context、工具太多選不準。這種邊界可以留。
- 不會存在:這條邊界只是組織圖的投影,應該改掉。
開頭提過,文章列了三種仍該保留 subagent 的情況。用例子說明(例子皆為自編):
- context 膨脹,造成可量測的退化。例如(自編)一個 agent 折進太多 skill 與工具結果後,eval 分數明顯下滑。
- 需要平行執行、而且各自乾淨的 context。例如(自編)同時調查幾個互不相關的方向,每個方向都要讀大量文件;混在同一個 context 裡會互相干擾,分給幾個 subagent 各自讀、各自回報比較合適。
- agent 選不對工具,或指令互相衝突。例如(自編)退款與換貨兩組規則寫法互相矛盾,折在一起後 agent 反覆用錯規則。
6.4 要改的往往是組織,不只是架構
文章不是叫團隊消失,而是改變團隊擁有的單位,也就是〈沒有各自的 agent 之後,團隊要負責什麼〉講的分工。它在這裡多補了一層理由:組織邊界換了,系統邊界才不會被慢慢拉回原狀。
小結:一個合理的解釋是,團隊只改得動、也只優化自己那一塊,agent 就跟著長成組織圖;放到 agent 上,每條團隊邊界都是一次掉資訊的交接。所以光改架構不夠,團隊擁有的單位也要跟著換。
7 這些主張有多扎實
這篇文章的方向很有說服力,但幾個關鍵數字和做法的細節交代得不完整,拿去說服團隊或照做之前要心裡有數:
| 主張 | 文章給的證據 | 缺了什麼 |
|---|---|---|
| 單一 loop 執行時間約快 2 倍 | 一個客戶的案例 | 單一案例,比較條件沒說明 |
| 單一 agent 加 skills 品質「經常」較好、成本延遲「常常」較低 | 多個企業部署的比較 | 沒有數字、任務或模型資訊 |
| Claude Code 的 system prompt 縮減超過 80% | Claude Code 自己的經驗 | 縮減「包含」漸進式揭露,不全是它的功勞 |
| 模型夠強就能折 | 從 Opus 4.5 起的觀察 | 沒有跨模型比較,也沒有「多強才夠」的門檻 |
| tool 超過 30 到 50 個準確度下降 | 觀察 | 沒說是哪個模型、哪類任務 |
還有幾處做法沒交代清楚,上文已經標出筆者的推論:
- 寫入閘門沒有定義(〈Loop 怎麼運作:寫計畫的就是執行的〉)。
- resuming a clarification 沒有解釋(〈原本的元件搬去哪〉)。
- 三種遷移做法是選項還是階段,沒有明說(〈三種做法,依序進行〉)。
- 知識庫為什麼不能由程式碼先檢索再貼進 prompt,理由在那一段沒說(〈Tool、skill、知識庫怎麼選〉)。
- 兩種替 eval 打分的方式:rubric(依評分標準替最終回覆打分)與 task-completion(任務完成率)沒有明確區分;筆者對兩者界線的推論見文末〈量什麼〉。
- 每題要跑幾次才夠,文章沒說。
- 怎麼用時間戳重播成 eval:文章建議內部系統難以重播時,在重要事件上記錄時間戳,之後重播成 eval(文末〈誰維護 eval〉),但沒說明怎麼做;推論是用時間戳還原當下的系統狀態再重跑。
8 結論
多 subagent 架構的根本問題,是每條邊界都是一次有損的 context 交接,而這些邊界常常只是組織圖的投影。解法是單一 loop 加上漸進式揭露:知識寫成按需載入的 skill,能力做成 tool,硬限制和權限檢查寫進 tool 的程式碼裡,而不是寫在 prompt 裡拜託模型遵守。
遷移要分階段:先建 eval,再把 subagent 當 tool 呼叫取得 baseline,接著合併高耦合的 subagent,最後一次折一個,只有折疊版分數比較差時才保留。比較時要逐題看翻轉、每題多跑幾次,因為模型在資訊「看起來夠用」時會跳過步驟。
組織面上,團隊從擁有 agent 改成擁有 skills 和 tools,由小型中央團隊守住 system prompt 與端到端品質。下次想多切一個 agent 時,先問一句:如果只有一個團隊負責,這條邊界還會存在嗎?
- 檢查:把現有 agent 架構圖和組織圖並排,標出每一條「只因為不同團隊負責」才存在的邊界。
- 先量:還沒有 eval 就先別折;從少量人工確認過答案的題目開始,涵蓋每一條會串接的流程。
- 存疑:拿「快 2 倍」「縮減超過 80%」去說服別人之前,記得它們是單一案例和自家經驗。
9 深入:折疊 subagent 時要 eval 的五個面向
這一節給準備動手的讀者。每折一個 subagent,就跑一次同樣的四步流程。下面五個小節裡,前四個對應流程中的步驟(〈怎麼比〉橫跨兩步):
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    a["準備題目(題目要涵蓋什麼)"]
    b["有、無該 subagent 各跑一輪(怎麼比)"]
    c["逐面向比較(量什麼、怎麼比)"]
    d["決定留或折(怎麼判斷要留 subagent)"]
    a --> b
    b --> c
    c --> d
圖 7 — 折疊一個 subagent 的 eval 流程。〈誰維護 eval〉不在流程內,而是讓流程能持續跑下去的前提。
9.1 量什麼
| 類別 | 要回答的問題 | 指標 | 何時用 |
|---|---|---|---|
| 結果 | 最後的回覆好不好 | Rubric 評分:依評分標準給最終回覆打分 | 全程 |
| 結果 | 事情有沒有真的辦成 | Task-completion(任務完成率) | 比較架構時最重要 |
| 過程 | 有沒有分派給對的 subagent | Routing accuracy(路由準確率) | 折疊前 |
| 過程 | 有沒有載入對的 skill、呼叫對的 tool | 選擇正確率 | 折疊後 |
| 過程 | 該走的步驟有沒有走完 | 串接題目(見下一小節) | 折疊後 |
| 效率 | 有沒有變快、變便宜 | 每任務延遲、每任務成本 | 全程 |
Rubric 和 task-completion 的差別文章沒有明確定義。可以這樣分(推論):rubric 看回答寫得好不好,task-completion 看事情有沒有辦成。回答寫得漂亮、退款卻沒送出,rubric 可能給高分,task-completion 則判失敗。
9.2 題目要涵蓋什麼
- 生產環境中每一條會一起執行的 agent 串接都要有題目。這是抓「跳過步驟」的關鍵,〈總分一樣,也可能藏著退步〉裡那個沒去問物流 specialist 的客服 agent 就是這種失誤。
- Agent 絕對不能違反的每一條規則,都要有對應的題目。
9.3 怎麼比
- 有和沒有該 subagent 分別跑一輪,其他條件固定。
- 逐題看翻轉,不只看總分(20 題的例子見〈總分一樣,也可能藏著退步〉)。
- 每題跑不只一次,偶發的失誤才抓得到。
- 一次只改一件事。
9.4 怎麼判斷要留 subagent
- 主規則:折疊版分數比較差,才保留 subagent。
- 輔助訊號:context 膨脹造成可量測的退化、選不對工具、prompt 指令互相衝突,這三者都能從〈量什麼〉的指標看出來。
- 另外判斷的一項:需要平行且乾淨的 context 是架構需求,不是 eval 分數能反映的,要另外判斷(推論;文章只是把它和另外兩個條件並列)。
9.5 誰維護 eval
- 兩層分工(中央團隊的端到端 eval 加各團隊的小 eval)與起步規模(10 個 golden examples),見〈先建 eval〉。
- 內部系統難以重播、使用者互動難以模擬時,可以在重要事件上記錄時間戳,之後拿來重播成針對性的 eval。