CIFAR-10 新手 Kaggle:Transfer Learning 只要 5 個 Epoch 就贏了
 Hong-Wei Wu
收錄於 其他主題
1 前言
很多剛入門機器學習的人都會想用 Kaggle 競賽練功,卻卡在第一步:到底該從哪一場比賽開始?這篇文章的建議是 CIFAR-10 – Object Recognition in Images,題目單純、資料乾淨,很適合拿來當人生第一場 Kaggle 競賽。
整篇文章會從競賽規則開始,一路走到資料前處理、模型建立、訓練迴圈,最後比較四種模型的訓練結果:最陽春的 CNN、加了 Dropout 的版本、改用 BatchNorm 的版本,以及用 Transfer Learning 微調的 DenseNet。
實作的部分是用 PyTorch 寫的,如果你完全沒碰過,建議先看過官方教學再回來。若你原本是 TensorFlow 或 Keras 的使用者,這裡的程式碼應該也不難看懂。完整程式碼收錄在筆者的 GitHub。
2 競賽簡介
CIFAR-10 是電腦視覺領域中廣為人知的資料集,很多機器學習的初學者都會使用這個資料集練功。CIFAR-10 中包含了 60000 張 32 × 32 的彩色圖片,每張圖片裡面都包含有一個物件,這個物件屬於 10 個類別中的其中一個類別。整體來說,每個類別各有 6000 張圖片。
在此競賽的資料集中,主辦方已經事先將 CIFAR-10 資料集拆分為訓練資料集以及測試資料集,訓練資料集包含 50000 張圖片、測試資料集包含 10000 張圖片。每張圖片都是下列 10 個類別中的其中一個類別:
- airplane
- automobile
- bird
- cat
- deer
- dog
- frog
- horse
- ship
- truck
我們的目標就是建立一個模型,利用 50000 張訓練圖片訓練後,能夠在剩下的 10000 張測試圖片有精準的預測結果。這裡有個很有趣的設計:主辦方為了避免參賽者作弊(手動標記測試資料集中的 10000 張圖片),在測試資料集中塞入額外 290000 張圖片,讓參賽者不知道其中哪些圖片才是真正的測試資料集。所以你送出的預測檔案裡,實際上有一大部分是不會被計分的雜訊。
從競賽簡介可以看出,這是一個典型的「圖像分類」任務,而且每張圖片只會有一個類別。類別數目不多(10 個),每個類別的訓練資料量也非常一致,不會出現資料不平衡(imbalanced data)那種還要另外處理的麻煩。對初學者來說,這代表你可以把注意力放在模型本身,而不是花大半時間在清資料上。
3 實作細節 01:載入函式庫
了解競賽的目標之後,就可以開始動手了。首先載入必要的函式庫:
# model
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import models

# dataset
import math
import glob
import pandas as pd
from PIL import Image
from sklearn.model_selection import train_test_split
from torchvision import transforms
from torch.utils.data import Dataset, Subset, DataLoader
import matplotlib.pyplot as plt

# save result
import pickle
接著,讓 PyTorch 抓取機器上的 GPU 資源:
torch.manual_seed(2022)
try:
    device = torch.device("mps")
except:
    device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
這段先試著抓 MPS device,也就是 Apple Silicon 的 GPU(筆者另外有一篇專文講怎麼讓 PyTorch 吃到 Mac M1 的 GPU);抓不到就退回 CUDA,再抓不到就用 CPU。如果你是在一般的 NVIDIA 機器或 Colab 上跑,直接走的會是 cuda 那條路。
4 實作細節 02:載入資料集
因為筆者是在 Colab 中完成此專案,因此會先將整個專案都上傳到 Google Drive 後,再將 Drive Mount 到 Colab 上,並解壓縮訓練資料與測試資料:
from google.colab import drive
drive.mount('/gdrive')
!unzip "/gdrive/MyDrive/Colab Notebooks/Kaggle/CIFAR-10 - Object Recognition in Images/cifar-10.zip"
!7z x train.7z
!7z x test.7z
競賽的原始檔是 .7z 格式,所以解完 zip 之後還要再用 7z 解一層,才會拿到真正的 png 圖片。解壓縮完成之後,把所有訓練圖片的路徑存下來:
img_names = glob.glob(f"cifar-10/train/*.png")5 實作細節 03:圖像資料前處理
在把圖像丟進模型之前,通常會做一些前處理,讓模型比較好訓練、學得比較好。這個專案只做最基本的一項:正規化。做正規化要先選一組平均(Mean)與標準差(Standard Deviation),而這組數字不是隨便挑的,要從訓練資料本身算出來,而且是「每個 Channel」各算一組(RGB 圖片有 3 個 Channel)。
先讀取每一張圖片,並將圖片轉為 PyTorch 中的 Tensor:
imgs = []

transform = transforms.Compose([
    transforms.ToTensor(),
])

for img in img_names:
    img = Image.open(img)
    imgs.append(transform(img))
接著,計算每一個 Channel 的 Mean 與 Standard Deviation:
imgs = torch.stack(imgs, dim=3)
channel_mean = imgs.view(3, -1).mean(dim=1)
channel_std = imgs.view(3, -1).std(dim=1)
print(f"channel mean: {channel_mean}")
print(f"channel std: {channel_std}")
算出來的兩個數值就可以放進 transforms.Compose(),把多個前處理步驟包成一條 pipeline:
transform_fn = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize(
        mean=channel_mean,
        std=channel_std
    )
])
最後定義一個 PyTorch Dataset。這個 Dataset 同時要應付訓練與測試兩種情境,差別在於有沒有 csv_path:有標籤檔就從 csv 建立「檔名 → 類別索引」的對照表,沒有就把 label 一律填 -1:
class CIFARDataset(Dataset):

    def __init__(self, img_path, transform, csv_path):
        self.csv_path = csv_path
        self.transform = transform

        if csv_path:
            self.img_names = glob.glob(f"{img_path}/*.png")
        else:
            self.img_names = [f"{img_path}/{idx}.png" for idx in range(1, 300001)]

        if csv_path:
            label_df = pd.read_csv(csv_path)
            self.label_idx2name = label_df['label'].unique()
            self.label_name2idx = {}

            for i in range(len(self.label_idx2name)):
                self.label_name2idx[self.label_idx2name[i]] = i
            self.img2label = {}
            for_, row in label_df.iterrows():
                self.img2label[f"{img_path}/{row['id']}.png"] = self.label_name2idx[row['label']]

    def __len__(self):
        return len(self.img_names)

    def __getitem__(self, index):
        img = self.img_names[index]

        if self.csv_path:
            label = self.img2label[img]
            label = torch.tensor(label)
        else:
            label = -1

        img = Image.open(img)
        img = self.transform(img)
return (img, label)dataset = CIFARDataset(
img_path="cifar-10/train",
transform=transform_fn,
csv_path="cifar-10/trainLabels.csv",
)為了評估模型的效能,我們會將訓練資料集再拆分為 Training 與 Validation 兩部分。之所以要多切一份 Validation,是因為 Kaggle 的測試資料集沒有標籤,你在本地根本沒辦法知道模型準不準,只能靠這份切出來的資料當作模擬考:
indexes = list(range(len(dataset)))
train_indexes, valid_indexes = train_test_split(indexes, test_size=0.2)
train_dataset = Subset(dataset, train_indexes)
valid_dataset = Subset(dataset, valid_indexes)

print(f"number of samples in train_dataset: {len(train_dataset)}")
print(f"number of samples in valid_dataset: {len(valid_dataset)}")
並分別建立 PyTorch DataLoader:
train_dataloader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True
)

valid_dataloader = DataLoader(
    valid_dataset,
    batch_size=32,
    shuffle=True
)
在 PyTorch 中定義自己的 Dataset 與 DataLoader 是常見的事情,如果你對此不熟悉可以參考官方教學。
有了 DataLoader,就可以撈一個 Batch 的資料出來,把其中幾張圖片畫出來檢查。這裡有兩個很容易踩雷的地方:第一,圖片已經被正規化過了,直接畫出來顏色會整個跑掉,所以要先把正規化還原回去;第二,Matplotlib 預設「色彩維度」放在最後一維,而 PyTorch Tensor 是放在第一維,所以要用 permute() 更改維度的順序:
def show_samples(batch_img, batch_label=None, num_samples=16):

    sample_idx = 0
    total_col = 4
    total_row = math.ceil(num_samples / 4)
    col_idx = 0
    row_idx = 0

    fig, axs = plt.subplots(total_row, total_col, figsize=(15, 15))

    while sample_idx < num_samples:
        img = batch_img[sample_idx]
        img = img.view(3, -1) * channel_std.view(3, -1) + channel_mean.view(3, -1)
        img = img.view(3, 224, 224)
        img = img.permute(1, 2, 0)
        axs[row_idx, col_idx].imshow(img)

        if batch_label != None:
            axs[row_idx, col_idx].set_title(dataset.label_idx2name[(batch_label[sample_idx])])

        sample_idx += 1
        col_idx += 1
        if col_idx == 4:
            col_idx = 0
row_idx += 1batch_img, batch_label = next(iter(train_dataloader))show_samples(batch_img, batch_label, 16)6 實作細節 04:模型建立(VallinaCNN)
一開始先用最基本、最原始的模型來處理這個圖像分類任務。這個模型只由三層 Convolution Layer 加一層 Linear Layer 組成,命名為 VallinaCNN(程式碼中的 class 名稱如此,本文沿用):
class VallinaCNN(nn.Module):

    def  __init__(self):
        super(VallinaCNN, self).__init__()

        self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
        self.conv2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1)
        self.conv3 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3, padding=1)
        self.linear1 = nn.Linear(64*8*8, 10)


    def forward(self, inp):
        x = F.relu(self.conv1(inp))
        x = F.max_pool2d(x, (2, 2))
        x = F.relu(self.conv2(x))
        x = F.max_pool2d(x, (2, 2))
        x = F.relu(self.conv3(x))
        x = torch.flatten(x, 1)
        out = self.linear1(x)

        return out
結構很單純:Convolution 抽特徵、MaxPooling 縮小尺寸,重複幾次之後把特徵攤平,交給最後的 Linear Layer 輸出 10 個類別的分數。建立模型後順便把參數量印出來,之後跟其他模型比較時會有感覺:
net = VallinaCNN()
net.to(device)
print(f"number of paramaters: {sum([param.numel() for param in net.parameters() if param.requires_grad])}")
7 實作細節 05:Loss Function 與 Optimizer
因為是多個類別的分類問題,因此我們選擇 CrossEntropyLoss() 作為 Loss Function,並使用 SGD 來調整模型中的參數:
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.005)
8 實作細節 06:Training & Validation Loop
Training 與 Validation Loop 的骨架幾乎一樣:每一輪都透過 DataLoader 從 Dataset 讀取一個 Batch 的資料,丟進模型拿到輸出。差別在於 train() 會呼叫 loss.backward() 與 optimizer.step() 去更新模型參數,而 validate() 只單純計算 Accuracy 與 Loss,不動模型。
先寫一個計算 Accuracy 的小工具,把模型輸出過一次 Softmax,取機率最大的類別,再跟正確標籤比對:
def get_accuracy(output, label):
    output = output.to("cpu")
    label = label.to("cpu")

    sm = F.softmax(output, dim=1)
    _, index = torch.max(sm, dim=1)
    return torch.sum((label == index)) / label.size()[0]
接著是 train()。裡面每 500 個 batch 會印一次平均 loss,方便在訓練過程中觀察數字有沒有往下走:
def train(model, dataloader):
    model.train()
    running_loss = 0.0
    total_loss = 0.0
    running_acc = 0.0
    total_acc = 0.0

    for batch_idx, (batch_img, batch_label) in enumerate(dataloader):
        batch_img = batch_img.to(device)
        batch_label = batch_label.to(device)

        optimizer.zero_grad()
        output = net(batch_img)
        loss = criterion(output, batch_label)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        total_loss += loss.item()

        acc = get_accuracy(output, batch_label)
        running_acc += acc
        total_acc += acc

        if batch_idx % 500 == 0 and batch_idx != 0:
            print(f"[step: {batch_idx:4d}] loss: {running_loss / 500:.3f}")
            running_loss = 0.0
            running_acc = 0.0
    return total_loss / len(dataloader), total_acc / len(dataloader)
validate() 則是把更新參數的三行註解掉,其餘照舊:
def validate(model, dataloader):
    model.eval()
    total_loss = 0.0
    total_acc = 0.0

    for batch_idx, (batch_img, batch_label) in enumerate(dataloader):

        batch_img = batch_img.to(device)
        batch_label = batch_label.to(device)

        # optimizer.zero_grad()
        output = net(batch_img)
        loss = criterion(output, batch_label)
        # loss.backward()
        # optimizer.step()

        total_loss += loss.item()
        acc = get_accuracy(output, batch_label)
        total_acc += acc

    return total_loss / len(dataloader), total_acc / len(dataloader)
9 實作細節 07:開始訓練模型
主迴圈跑 20 個 Epoch,每個 Epoch 各跑一次 train 與 validate,把 loss 記錄下來。最後那個 if 是重點:只有當這次的 Validation Loss 創新低時才存檔,這樣訓練結束後留在硬碟上的會是表現最好的那組參數,而不是最後一輪的參數:
EPOCHS = 20
train_history = []
valid_history = []

for epoch in range(EPOCHS):
    train_loss, train_acc = train(net, train_dataloader)
    valid_loss, valid_acc = validate(net, valid_dataloader)
    print(f"Epoch: {epoch:2d}, training loss: {train_loss:.3f}, training acc: {train_acc:.3f} validation loss: {valid_loss:.3f}, validation acc: {valid_acc:.3f}")

    train_history.append(train_loss)
    valid_history.append(valid_loss)

    if valid_loss <= min(valid_history):
        torch.save(net.state_dict(), "net.pt")
10 實作細節 08:模型訓練結果(VallinaCNN)
模型訓練完之後,把 Training Loss 與 Validation Loss 的變化畫成曲線,就能看出訓練得好不好。
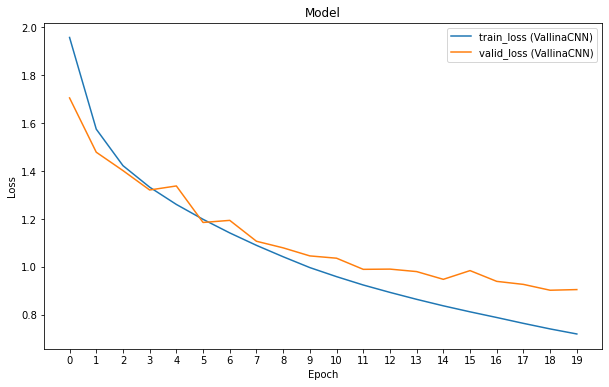
上圖呈現的是 VallinaCNN 的訓練結果。從圖中可以發現一開始 Training Loss 與 Validation Loss 不斷的下降,然而從第 8 個 Epoch 開始,Validation Loss 下降的速率開始減慢。到了第 19 個 Epoch 時,Validation Loss 與 Training Loss 已經有一段落差。
這是在訓練 Neural Network 時常遇見的問題:Overfitting。白話一點來說,模型把訓練資料背起來了,在沒看過的資料上就使不上力。兩條曲線愈拉愈開,就是最典型的徵兆。
11 實作細節 09:在模型中加入 Dropout(CNNDropout)
減緩模型 Overfitting 的方法有很多,最簡單的一項可能是在模型中加入 Dropout Layer(如果想更完整了解 Dropout 為什麼有效,可以參考本站另一篇專文):
class CNNDropout(nn.Module):

    def __init__(self):
        super(CNNDropout, self).__init__()

        self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
        self.conv1_dropout = nn.Dropout(p=0.4)
        self.conv2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1)
        self.conv2_dropout = nn.Dropout(p=0.4)
        self.conv3 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3, padding=1)
        self.linear1 = nn.Linear(64*8*8, 10)


    def forward(self, inp):
        x = F.relu(self.conv1(inp))
        x = F.max_pool2d(x, (2, 2))
        x = self.conv1_dropout(x)

        x = F.relu(self.conv2(x))
        x = F.max_pool2d(x, (2, 2))
        x = self.conv2_dropout(x)

        x = F.relu(self.conv3(x))
        x = torch.flatten(x, 1)
        out = self.linear1(x)

        return out
CNNDropout 與 VallinaCNN 類似,只不過在 MaxPooling 的輸出再經過一層 Dropout。同樣將模型訓練 20 個 Epoch 後,將其訓練結果與原來的 VallinaCNN 比較:
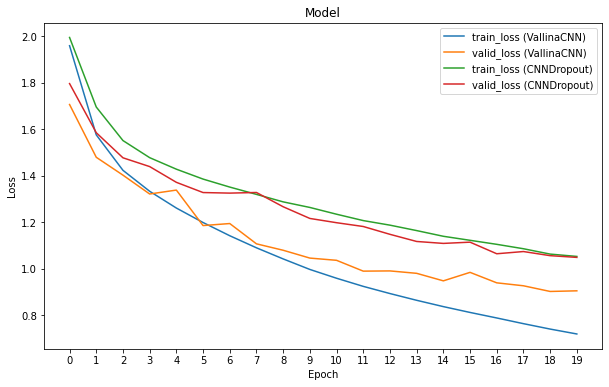
我們可以發現原來的 Overfitting 問題確實減緩了,也就是說即使來到了第 19 個 Epoch,Validation Loss 仍然與 Training Loss 繼續下降。然而,和未加入 Dropout 的 VallinaCNN 比較,DropoutCNN 的 Training Loss 與 Validation Loss 仍然高出許多。換句話說,Overfitting 是壓下去了,但整體的預測能力並沒有變好。
12 實作細節 10:以 BatchNorm 取代 Dropout(CNNBatchNorm)
實務上,我們經常會利用 BatchNorm 取代 Dropout,BatchNorm 除了有減緩 Overfitting 的效果,也能夠加速模型的訓練:
class CNNBatchNorm(nn.Module):

    def __init__(self):
        super(CNNBatchNorm, self).__init__()

        self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
        self.conv1_bn = nn.BatchNorm2d(num_features=16)
        self.conv2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1)
        self.conv2_bn = nn.BatchNorm2d(num_features=32)
        self.conv3 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3, padding=1)
        self.conv3_bn = nn.BatchNorm2d(num_features=64)
        self.linear1 = nn.Linear(64*8*8, 10)

    def forward(self, inp):
        x = self.conv1(inp)
        x = self.conv1_bn(x)
        x = F.relu(x)
        x = F.max_pool2d(x, (2, 2))

        x = self.conv2(x)
        x = self.conv2_bn(x)
        x = F.relu(x)
        x = F.max_pool2d(x, (2, 2))

        x = self.conv3(x)
        x = self.conv3_bn(x)
        x = F.relu(x)

        x = torch.flatten(x, 1)
        out = self.linear1(x)

        return out
注意 BatchNorm 的擺放位置:接在每一層 Convolution 之後、ReLU 之前。同樣將模型訓練 20 個 Epoch 後,將其訓練結果與 VallinaCNN、CNNDropout 一起比較:
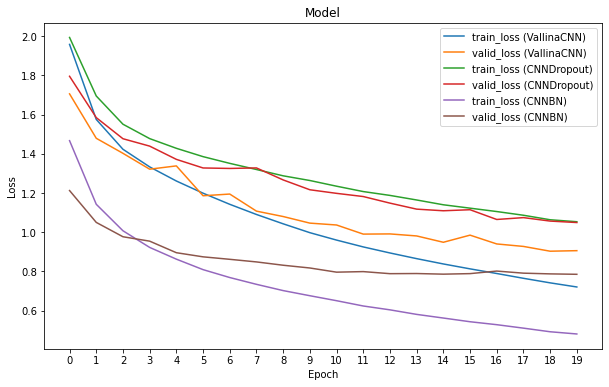
從上圖可以發現,同樣訓練 20 個 Epoch,CNNBatchNorm 的 Training Loss 與 Validation Loss 明顯低於 VallinaCNN 與 CNNDropout。CNNBatchNorm 也大幅縮短了訓練所需的時間,只訓練 4 個 Epoch,其 Training Loss 與 Validation Loss 也已經低於另外兩個模型。這就是「加速訓練」最直接的體現:同樣的成果,時間只要五分之一。
13 實作細節 11:利用 Transfer Learning 提高模型準確度(PretrainDenseNet)
到目前為止我們試過三種模型:VallinaCNN、CNNDropout 與 CNNBatchNorm,也看到了不同技巧對模型效能的影響。回到最初的問題:在這場 Kaggle 競賽中,到底該怎麼訓練出一個夠好的模型?答案是 Transfer Learning。
Transfer Learning 的想法是不從零開始訓練,而是拿一個已經在大量資料上訓練過的模型來 Fine-Tune。這裡從 PyTorch TorchVision Models 選擇 DenseNet,載入它在 ImageNet 上訓練好的參數。ImageNet 有 1000 個類別,而我們只需要 10 個,所以要把模型的 Classifier Head 換掉:
class PretrainDenseNet(nn.Module):

    def __init__(self):
        super(PretrainDenseNet, self).__init__()
        model = models.densenet121(pretrained=True)
        num_classifier_feature = model.classifier.in_features
        model.classifier = nn.Sequential(
            nn.Linear(num_classifier_feature, 256),
            nn.ReLU(),
            nn.Dropout(0.3),
            nn.Linear(256, 10)
        )
        self.model = model

        # for param in self.model.named_parameters():
            # if 'features' in param[0]:
            # param[1].requires_grad = False

    def forward(self, x):
        return self.model(x)
(這段的 pretrained=True 是當年的寫法,較新版本的 TorchVision 已改用 weights= 參數。)
在 Transfer Learning 中,我們通常會將模型主體的參數固定住,只需要重新訓練新的 Classifier Head 的部分,也就是被註解掉的那幾行在做的事。不過在此專案中,我們嘗試讓整個模型都訓練,結果也有不錯的表現:
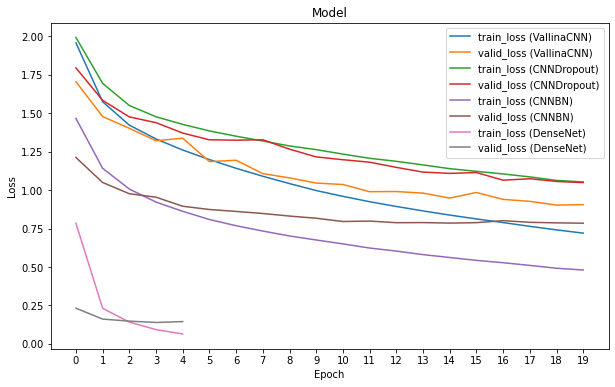
由上圖可以發現,我們只對模型訓練 5 個 Epoch,其 Training Loss 與 Validation Loss 就已經趨近於 0。跟前面三個模型辛苦跑 20 個 Epoch 的曲線放在一起看,落差相當明顯。
14 結論
這篇文章介紹了 Kaggle 上的 CIFAR-10 – Object Recognition in Images 競賽,題目乾淨、類別平衡,是一場非常適合初學者入門的比賽。
過程中我們也用同一份資料、同一套訓練迴圈,比較了原始 CNN、Dropout 與 BatchNorm 對模型效能的影響:Dropout 能壓下 Overfitting 但整體 Loss 偏高,BatchNorm 則是兩者兼顧、還順便加快了收斂速度。最後的 Transfer Learning 更是直接把成績拉開,證明在硬體資源與訓練資料量都不足的情況下,站在別人訓練好的模型肩膀上,仍然能訓練出高效能的模型。
本文沒有提到如何生成 Kaggle 指定的 submission.csv,那部分的程式碼可以參考筆者的 GitHub。