平行程式設計實例:資料怎麼拆、結果怎麼收斂
 Hong-Wei Wu
收錄於 其他主題
1 前言
上一篇「什麼是平行程式設計」介紹了 Parallel Programming 的基本概念,這篇則要往下走一層:用一段很單純的範例程式,看看一個原本單執行緒的程式到底是怎麼被拆開、丟給多個 Core 一起跑的。
文章分成三個部分:先說明為什麼平行化不只是「可以做」而是「必須做」,接著用一個 Array 加總的例子走完整個平行化流程 (包含最後的 Reduction),最後整理平行化的兩個方向與三個必須考慮的元素。
2 為什麼「必須」平行程式設計
前一篇文章談的是「為什麼需要平行程式設計」,這裡想講的是更硬的那一面:為什麼現在寫程式,平行化幾乎是躲不掉的。
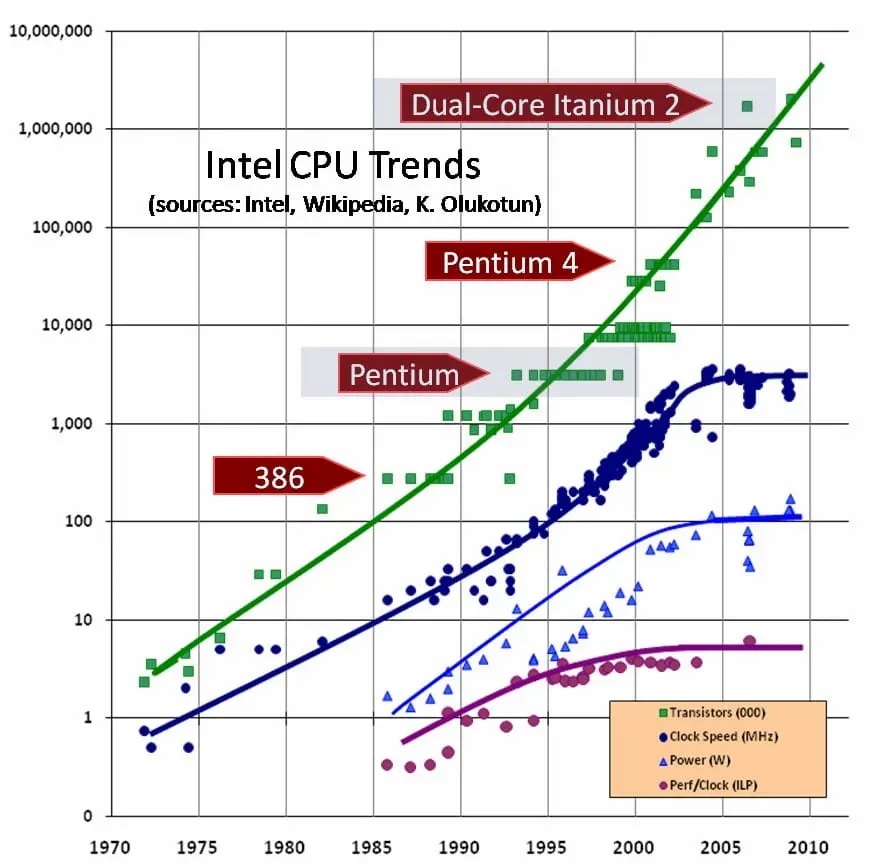
如上圖所示,四條線由上而下分別表示 Transistor 數量、Clock Speed、Power 與 ILP。根據 Moore’s Law 我們可以發現電晶體的數量呈現逐年成長 (綠線);然而,單個 CPU 的 Clock Speed (深藍線) 卻已經趨緩下來,ILP (紫色線) 也是一樣的走勢。
ILP 的全名為 Instruction-Level Parallelism,指的是即使只有 Single Core 的情況下,仍然可以透過 Compiler 與 CPU Architecture 達到指令層級的平行化運作,來加速程式的執行。換句話說,這是硬體和編譯器「偷偷幫你平行化」的部分,不需要工程師自己動手。
問題就在這裡:單個 Core 的 Clock Speed 與 ILP 都已經接近極限,能白拿的效能已經拿得差不多了。電晶體變多的紅利,現在是以「更多 Core」的形式交到我們手上,而不是「一個更快的 Core」。想繼續讓程式跑得更快,就必須回到軟體本身,透過平行化的程式設計,讓程式善加利用多個 Core 的資源。
3 平行程式的簡單範例
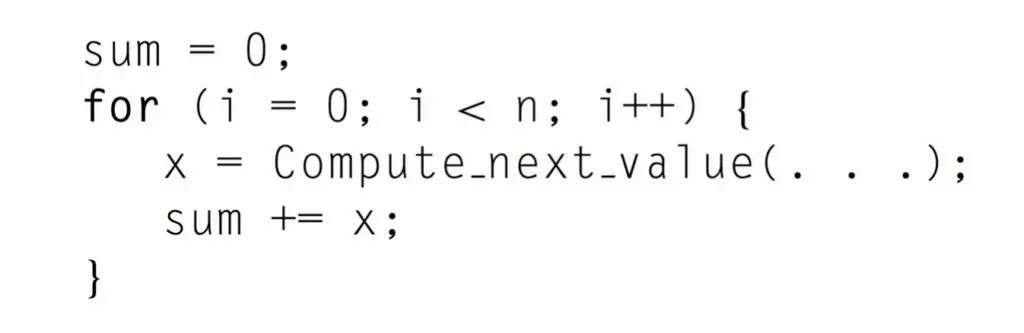
假設我們有一個 Array,Array 中有 n 個元素,每一個元素彼此之間沒有相依性,我們希望對每一個元素進行一些運算後,將結果加總起來。上圖的程式就完成了這件事:從頭到尾跑一次迴圈,一個元素一個元素地算,全部由同一個 Core 負責。
這裡的關鍵是「彼此之間沒有相依性」。第 5 個元素的運算結果不會影響第 6 個元素怎麼算,所以誰先算、誰後算並不重要,這正是可以平行化的訊號。
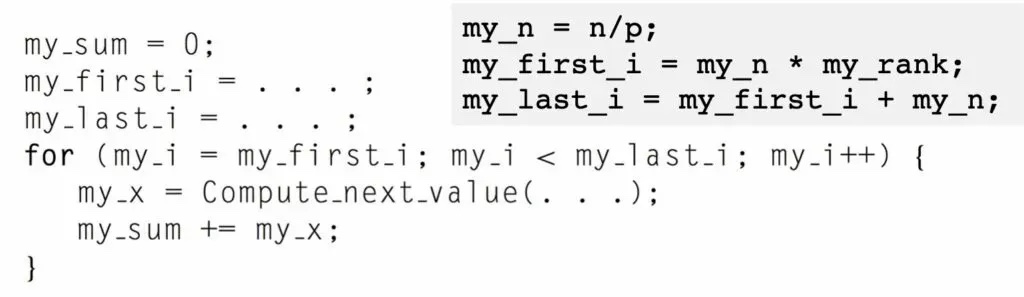
因為元素之間沒有相依性,我們可以透過 Parallel Programming 的技巧,把 Array 中的所有元素平均分配給所有的 Core。每個 Core 只需要知道兩件事:我負責哪一段範圍,以及我要把自己的小計放在哪裡 (也就是圖中的 my_sum)。
舉例來說,假設電腦上目前有 p 個 Core,且 Array 中有 n 個元素,那麼可以平均分給每一個 Core n/p 個元素。原本一個 Core 要扛 n 個元素,現在由多個 Core 平均分擔,執行時間自然縮短。
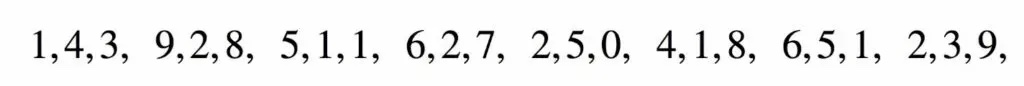
換成真實數字會更好懂。如上圖所示,假設 Array 中有 24 個數字,且電腦上有 8 個 Core,我們就平均分配 3 個數字給每一個 Core。
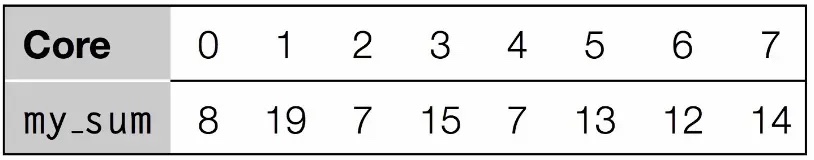
每一個 Core 都會算出自己的結果,存於 my_sum 變數當中。最後,再由一個 Master Core 負責把所有 Core 的結果加總起來。透過 Parallel Programming,原來只由 Master Core 負責 24 個數字的運算,現在由 8 個 Core 同時處理自己的部分,再由 Master Core 把大家的結果集合在一起。
4 平行化 Reduction 的過程
在上述的例子中,最後是由 Master Core 統一將所有 Core 的結果加總在一起,也就是要把 8 個數字併成 1 個數字。由原來的「很多元素」經過運算後變成「很少元素」的過程稱為 Reduction。
Reduction 本身通常也可以再進行平行化處理,這一步很容易被忽略:如果最後這段收尾還是由 Master Core 一個人做,前面分工省下來的時間就會被吃掉一部分。
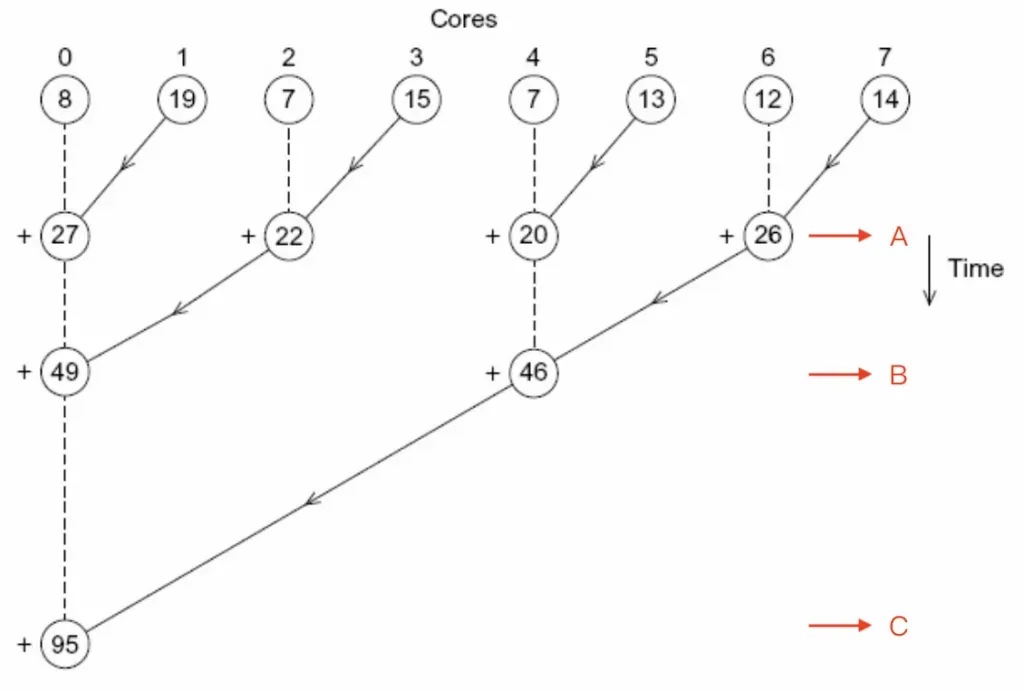
做法是兩兩配對相加:Core 0 加總 Core 1、Core 2 加總 Core 3、Core 4 加總 Core 5、Core 6 加總 Core 7。如此一來,在時間點 A 時,同時就有 4 個 Addition 發生。接著剩下的 4 個數字再兩兩相加、然後 2 個相加,就收斂成 1 個數字了。
把 Reduction 過程以 Parallel Programming 改寫後,原來由 Master Core (Core 0) 進行 7 個 Addition,現在只需要進行 3 個 Addition。
5 平行化程式設計的兩個方向
針對原有單執行緒的程式進行平行化處理時,有兩個方向可以進行:Task-Parallelism 與 Data-Parallelism。
- Task-Parallelism
將原來的問題拆分成多個不同的 Task,每一個 Core 都會處理自己的 Task。舉例來說,假設餐廳有 3 個師傅要做 300 個蛋糕,由每一個師傅負責每一個蛋糕的某些步驟,因此每一個師傅所做的事情都會不同。
- Data-Parallelism
將原來的問題中涉及資料處理的部分,分配給每一個 Core 處理部分資料。以上述蛋糕師傅的例子,每一個師傅即是負責 100 個蛋糕,因此每一個師傅所做的事情會相同。
前面 Array 加總的範例,就是標準的 Data-Parallelism:每個 Core 做的運算一模一樣,差別只在拿到的資料不同。
6 平行化程式設計的三個元素
針對原有的單執行緒程式進行平行化處理時,有三個元素需要考慮:Communication、Load Balancing 與 Synchronization。
- Communication
平行化程式中經常會用到多個 Core,這些 Core 彼此之間應該如何傳遞訊息。以前面的例子來說,各個 Core 的 my_sum 最後要送到 Master Core 手上,就是一種 Communication。
- Load Balancing
如何讓每一個 Core 都能平均分擔任務。在上面的例子中,我們把資料量平均分給每一個 Core。然而,有些情況下不同類型的資料所需的處理時間也不同,若只依照「數量」進行分配,可能導致某些 Core 還在執行,某些 Core 卻已經閒置下來。
- Synchronization
有些情況下,我們希望某些 Core 要等待其他 Core 執行完後才繼續執行。以 Reduction 為例,Core 0 必須等 Core 1 真的把 my_sum 算完,加起來的結果才會是對的。
上述 3 點中,Communication 與 Synchronization 是為了確保 Parallel Program 與原來的 Serial Program 執行的結果相同;Load Balancing 則是為了最佳化 Parallel Program 的效能。
7 結論
本文從硬體趨勢出發,說明為什麼今天「必須」做平行程式設計:Clock Speed 與 ILP 都已經卡住,效能的成長只能靠更多 Core。接著透過 Array 加總的範例,走過一次資料分配、各自計算、再以 Reduction 收斂結果的完整流程。
最後整理了平行化的兩個方向 (Task-Parallelism 與 Data-Parallelism) 以及三個必須注意的元素 (Communication、Load Balancing 與 Synchronization)。這三個元素在後續介紹 Shared Memory Model、Distributed Memory Model 時還會反覆出現,值得先記在腦中。