平行程式設計模型:Shared Memory Model 與 Race Condition 陷阱
 Hong-Wei Wu
收錄於 其他主題
1 前言
知道什麼是平行程式設計、以及為什麼需要它之後,接下來要處理的問題是「實際上怎麼寫」。平行程式設計有三種常見的模型 (Parallel Programming Model),每一種的實作方式與適用場景都不太一樣。本篇文章介紹其中第一種:Shared Memory Model。
內容會從 Shared Memory Model 的記憶體結構講起,接著用一個「把陣列元素加總」的小例子,帶出這個模型最容易踩到的雷 —— Race Condition,最後說明怎麼用 Lock 與 Critical Section 把它擋掉。
2 什麼是 Shared Memory Model
如果你在程式中用過 Multi-Threading 的技巧,那你對 Shared Memory 的概念一定不陌生。用 Shared Memory Model 開發平行程式時,寫出來的通常就是所謂的「Multi-Thread Program」。
它的基本想法很單純:把 Program 中性質相同的 Task 拆給不同的 Thread 執行,這些 Thread 可以同時被不同的 Core 跑起來,Program 整體的執行時間因此縮短。原本要跑 8 秒的工作,理想上分給 2 個 Thread 之後大約 4 秒就能收工。
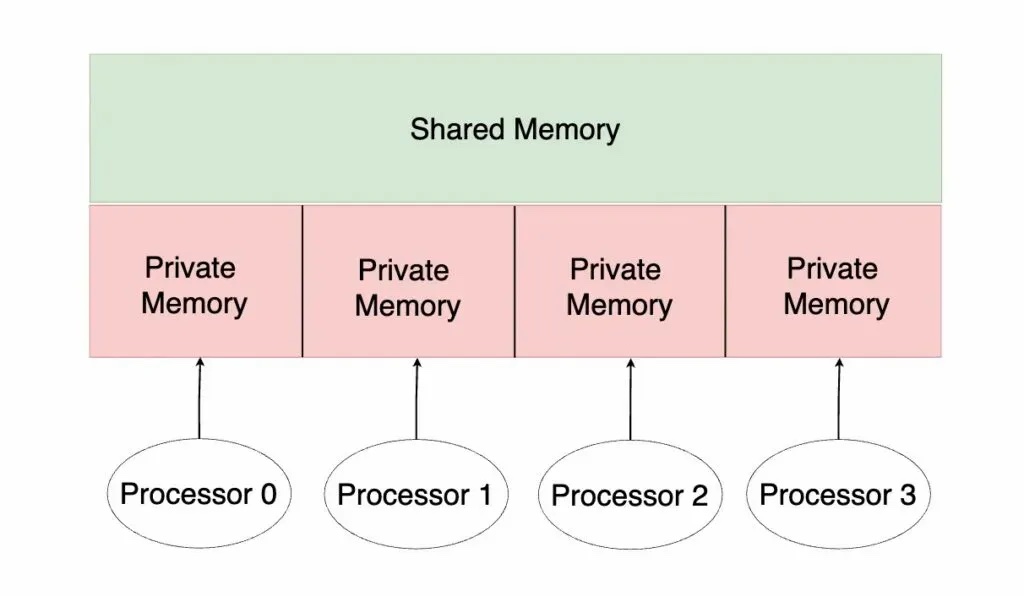
如果你對 Thread 與 Process 的區別還很陌生,可以參考 Program / Process / Thread 差異這篇說明。在這裡我們可以先把一個 Program 單純視為 Main Memory 中的一個 Process。在 Multi-Thread Program 中,這個 Process 底下包含了許多 Thread,每個 Thread 有自己的 Private Memory(例如 Local Stack Variable),所有 Thread 之間則共用一塊 Shared Memory(例如 Static Variable 與 Global Heap)。
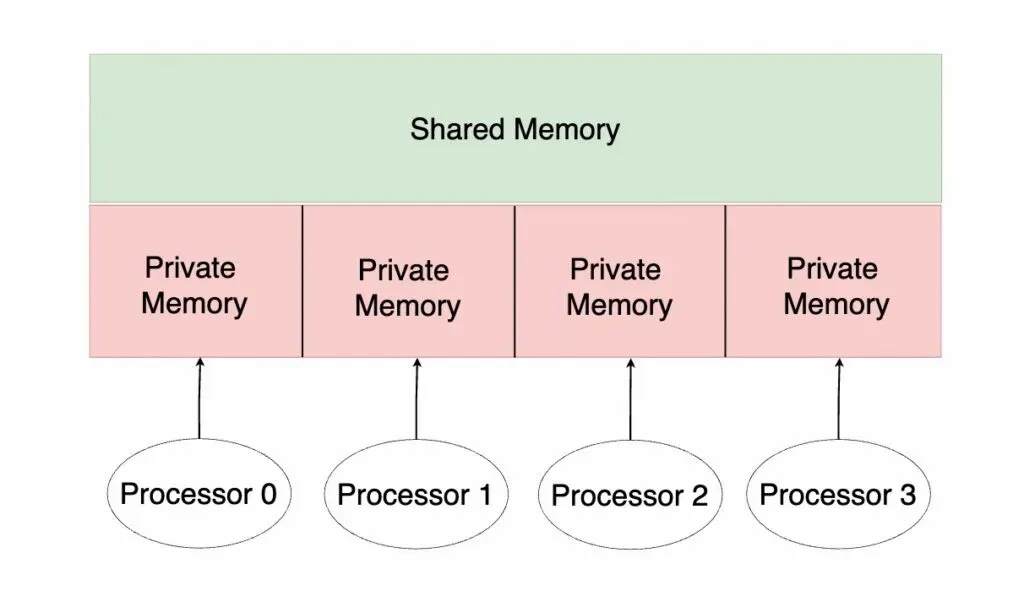
如上圖所示,假設每個 Processor 正在執行不同的 Thread,這些 Thread 有自己的 Private Memory 存放只有自己需要知道的資訊;同時也有一塊 Shared Memory 可以互相分享資訊。
這裡有個關鍵的觀念:在 Shared Memory Model 中,Thread 之間是用「Implicit(隱性)」的方式溝通的。程式碼裡我們不會直接叫某個 Thread 去 Send 或 Receive Data,而是各自對 Shared Memory 做讀取 (Read) 與寫入 (Write),資訊就這樣傳遞過去了。換個說法,共享記憶體本身就是通訊管道。
3 Shared Memory Model 範例
接著用一個簡單的問題與程式碼,把上面的概念以及它可能帶來的麻煩具體化。
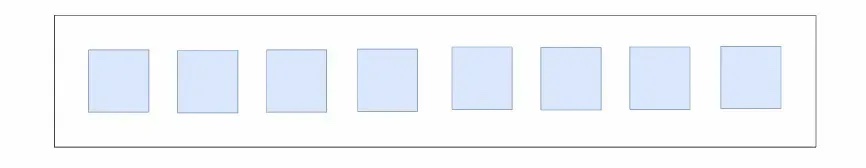
如上圖所示,假設我們現在有一個 Array,裡面有 8 個元素。每個元素都要先丟進 Function f 運算,再把全部的結果加總起來。
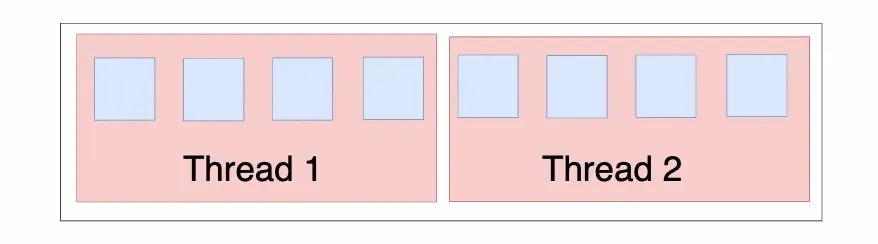
為了減少 Program 的運行時間,我們在 Program 中建立 2 個 Thread,各自負責 4 個元素。Thread 1 與 Thread 2 會有自己的 (Private) Local Variable 紀錄這 4 個元素運算後的小計;另外還有一個 (Shared) Static Variable 紀錄整體的總和。
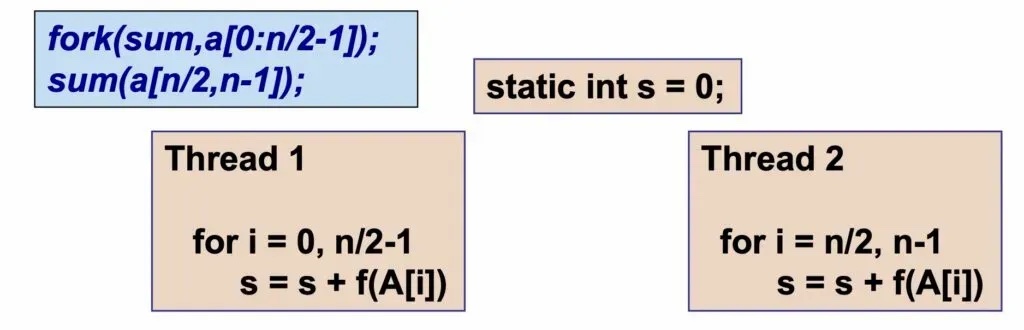
若把上面的描述寫成程式碼,結構大致就像上圖。先看藍色框框的部分:透過 fork Function 建立一個新的 Thread (Thread 1),指定它要執行的 Function (sum),並把這個 Thread 負責的 Array 元素 (a[0 : n/2 - 1]) 傳進去。下一行則是原來的 Main Thread 自己執行 sum Function,負責 Array 後半部的元素 (a[n/2 : n-1])。
這樣就形成了 Thread 1 與 Thread 2,兩者執行的都是同一個 sum Function。sum 的內容主要是一個 for loop,把每個元素丟進 f Function 之後,再累加到 static variable s 裡面(s 是 Thread 1 與 Thread 2 都可以讀取與寫入的共享變數)。
4 Race Condition
看起來沒問題,但實際執行上面的程式碼,會發現結果不一定正確 —— 而且每次跑出來的數字還可能不一樣。
原因在於 Thread 1 與 Thread 2 是被不同的 Core 同時執行的。如果 Thread 1 正在讀取 s 變數的當下,Thread 2 剛好對 s 寫入,最後的結果就會出錯。這種因為多個 Core 對同一塊記憶體空間讀寫的時序交錯而造成的錯誤,稱為 Race Condition。
舉個具體的例子。假設目前 s = 16:
- Thread 1 讀到 s = 16,準備把 f(A[i]) 的結果與 16 相加後寫回 s。
- 就在 Thread 1 寫回去之前,Thread 2 已經先把它算出的新結果寫進 s,此時 s = 20。
- Thread 1 完全不知道這件事,它手上握的仍然是 16,於是用 16 去算並覆蓋回 s。
Thread 2 那次寫入等於憑空蒸發,後面的運算自然也就不正確了。麻煩的地方在於,這種錯誤取決於兩個 Thread 的執行時序,所以它是間歇性的:測試時可能跑十次對九次,上線之後才偶爾爆掉。
5 Critical Section
為了解決 Multi-Thread Program 中的 Race Condition,我們可以透過 Lock 機制,在 Program 中建立 Critical Section。
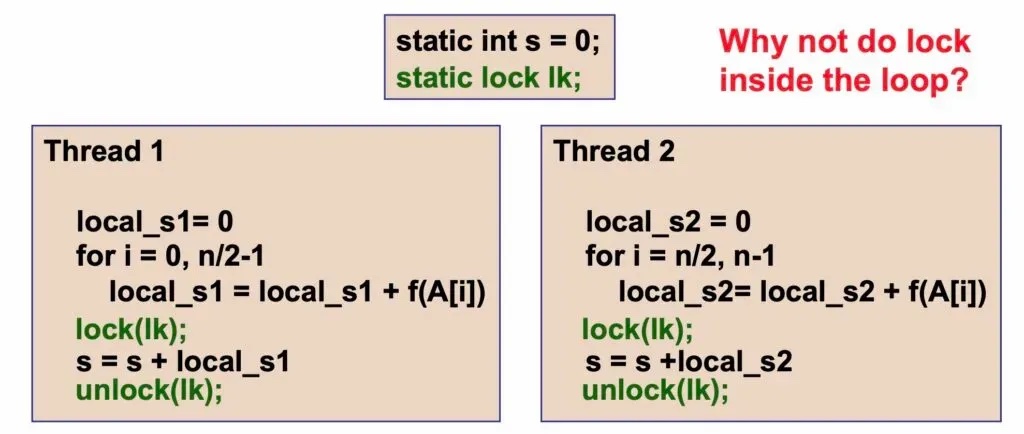
如上圖程式碼所示,第一步是「減少」Race Condition 發生的機率:在每個 Thread 中建立自己的 Local Variable(例如 local_s1 與 local_s2)存放自己算出來的小計,最後才把小計與 s 變數相加並寫回 s。這樣一來,原本 for loop 裡每一輪都要碰共享變數,現在整個 Thread 只碰一次。
不過機率變小不等於不會發生。「把自己算出來的總和與 s 相加並寫回 s」這個動作本身,依然可能撞上另一個 Thread 的同一個動作。
所以第二步,是用 lock 機制把這段過程變成一個 Critical Section,才能徹底根絕 Race Condition。一段程式碼一旦成為 Critical Section,同一時間就只會有一個 Thread 被允許執行它,其他 Thread 必須等前一個離開才能進去,交錯讀寫的情況也就不可能出現了。
最後,上圖中還有一行紅字:「Why not do lock inside the loop ?」意思是說,為什麼不乾脆回到最原始的版本(也就是沒有 local_s1 與 local_s2 的那一版),直接在 for loop 裡 s = s + f(A[i]) 這行的前後加上 Lock?這樣同樣可以避免 Race Condition。
答案是成本。Lock 的機制是透過 System Call 實作的,而 System Call 是一項高成本的指令。如果把它放進迴圈裡,等於每處理一個元素就要付一次這個成本;呼叫次數一多,額外的時間開銷反而可能把 Multi-Thread 帶來的好處整個抵銷掉。把 Lock 移到迴圈外面、只鎖真正需要保護的那一行,才是划算的做法。
6 結論
本篇文章介紹了 Parallel Programming Model 中的第一種 —— Shared Memory Model:Thread 之間透過共用的記憶體隱性溝通,寫起來直觀,但也因此容易踩到 Race Condition。
解法上,最基本的做法是用 Lock 機制圈出 Critical Section,確保同一時間只有一個 Thread 能碰到共享資料。同時也別忘了 Lock 本身是有成本的,鎖的粒度放在哪裡,往往直接決定了平行化到底有沒有賺到。