Context Language Models 解析:讓 agent 用 Bash 改自己的 context
 Hong-Wei Wu
收錄於 論文介紹
1 context 爆了,誰來決定留什麼?CLM 讓模型自己改
LLM agent 跑得越久,context(模型每一輪讀進去的整份文字)就越容易爆。搜尋結果、檔案內容、指令輸出一輪輪堆上去,遲早超過上限,總得有人決定「留什麼、丟什麼」。目前的主流做法,是由 harness(包在模型外面、負責跑 agent 迴圈與組裝每輪 context 的程式)用固定規則做摘要,或是給模型幾個預先設計好的壓縮工具。
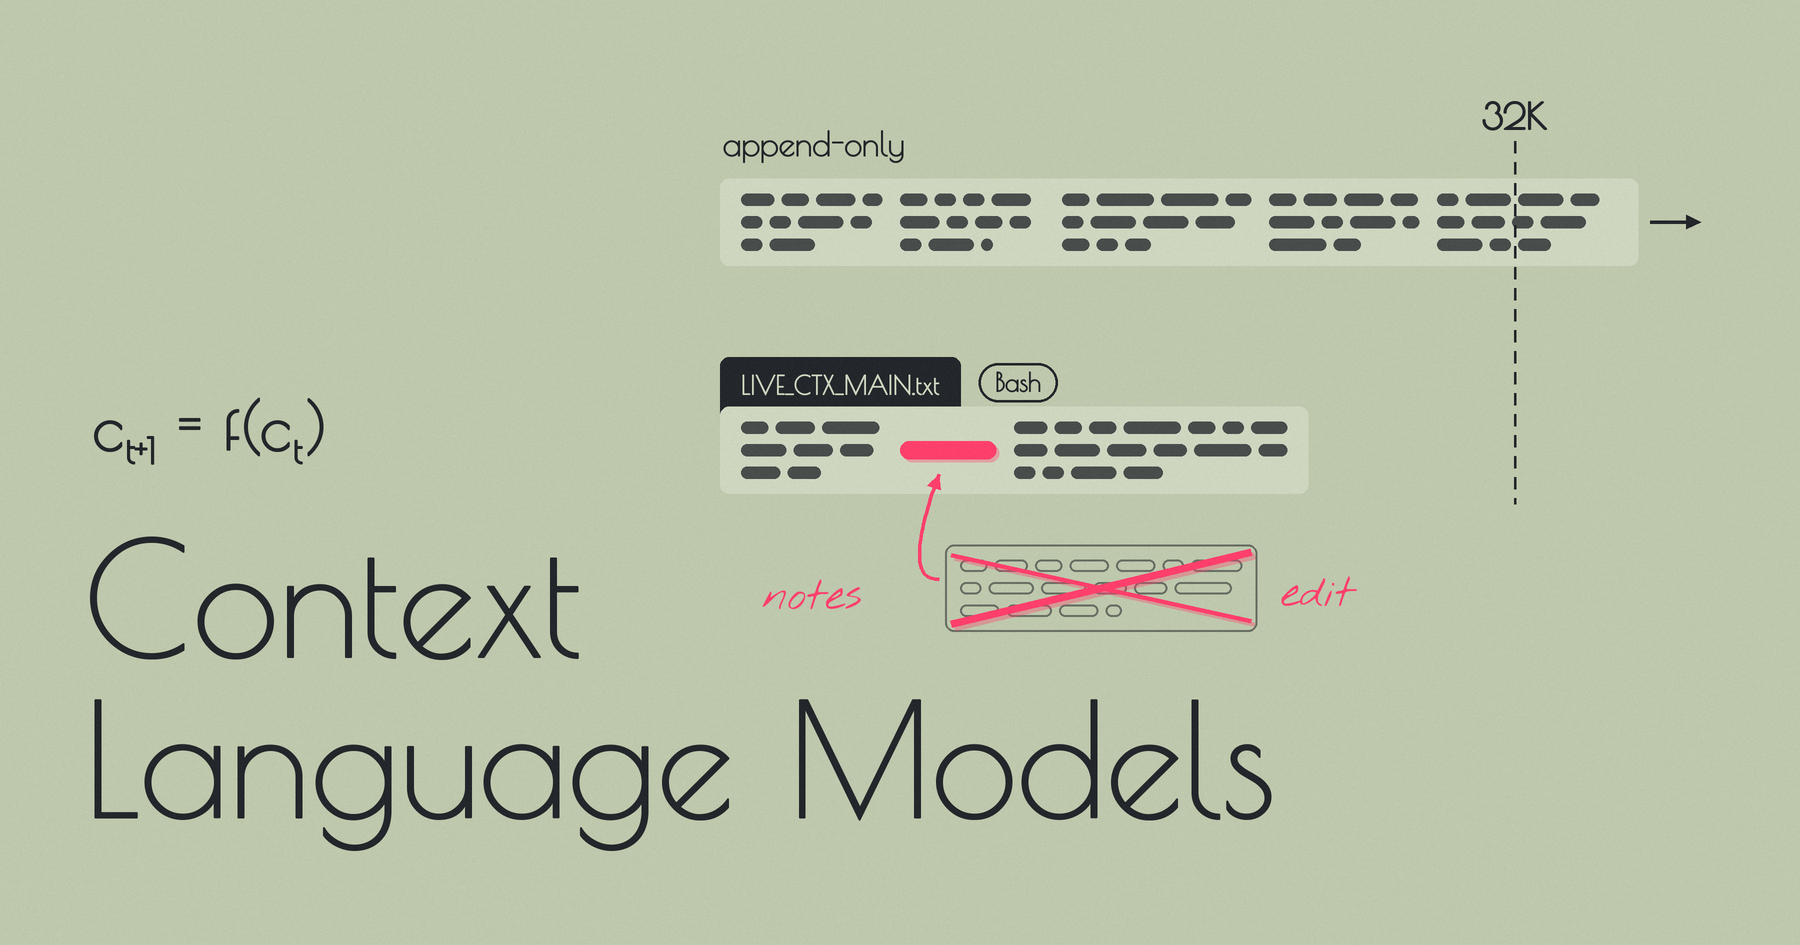
Context Language Models 這篇論文提出的做法叫 CLM:把模型當前的 context 鏡像成一個檔案,模型用 Bash 想改哪裡就改哪裡,改完立刻同步回它的 live context(下一輪真正餵給模型的那份 context)。這是介面設計,不是新演算法。
接下來先看 CLM 想解決的問題和它怎麼運作,再看改 context 的成本怎麼算、怎麼用文字與 RL 學管理策略,最後逐項檢查論文的證據,把摘要的大數字換回絕對值。文中標「自編例子」的是我為了說明而編的數字或情境,標「推論」的是我的判斷,不是論文原文。
論文:Context Language Models(arXiv 2609.37725v1,University of Washington/Meta,2026 年 9 月)。
2 context 管理:從固定規則到模型自己動手
agent 一輪輪地搜尋、讀檔、執行指令,累積的對話與工具輸出遲早超過模型的 context 上限(這篇論文的實驗多半設在 32K tokens)。怎麼處理這件事,叫 context management(context 管理)。先認識三個後面會一直用到的詞:
- harness:前面提過,包在模型外面的程式,負責跑 agent 的迴圈、呼叫工具、組裝每一輪要餵給模型的 context。
- compaction(壓縮):把舊歷史改寫成較短的摘要。
- offloading(卸載)與 retrieval(檢索):把內容存到外部檔案,context 裡只留一個指標,需要時再撈回來。
自編例子:一個搜尋 agent 跑 100 輪,每輪都把搜尋結果貼進對話,跑到 40 輪左右就滿了。你得決定:舊的搜尋結果整段刪掉?濃縮成一段摘要?還是先存到硬碟、需要再撈回來?
2.1 現有的兩條路:harness 定義與 action-based
現有的做法,可以依「誰做決定」分成兩類:
| 類型 | 誰決定 | 代表 |
|---|---|---|
| harness 定義 | 外部程式,固定規則 | Codex 風格摘要:context 用到預算的 75% 時,整段歷史換成一份摘要。MEM1:每一輪都重寫 context |
| action-based | 模型決定「何時用」,但「能做哪些操作」是人預先設計的 | Self-Compact:模型自己決定何時壓縮。ACM:模型可呼叫壓縮、卸載、檢索這幾個工具 |
第一類模型完全沒有發言權;第二類模型有發言權,但只能在人類給的選單裡選。更細的 when/how 分類與文獻出處,在文末「概念詳解」的第一節(選讀)。
2.2 論文的主張:連「怎麼改」都交給模型
論文認為這兩條路有同一個天花板:模型能做的操作,都是人類事先設計好的。CLM 把自由度推到底,排起來是三級:
- harness 定義:模型零控制。
- action-based:模型選「何時」,操作由人定義。
- CLM:模型連「怎麼改」都自己決定。
具體差別(自編例子):context 裡有 100 條搜尋結果,編號 30、31、57 的三條沒用,其餘要原文保留。如果工具只有「把全部歷史壓成摘要」,模型只能全壓,其他 97 條的原文就被改寫了;CLM 可以直接寫一小段程式,只刪那三條。
論文引用 Sutton 的 The Bitter Lesson(AI 領域常見的論點:靠搜尋與學習擴展的通用方法,長期會贏過人類手工設計的規則)當動機,這主要是修辭上的支持。我的推論(非論文原文)是:限制少也代表模型可能改壞,這個賭注划不划算,要看後面的實驗。
2.3 ContextBench:現有方法連簡單的管理任務都做不好
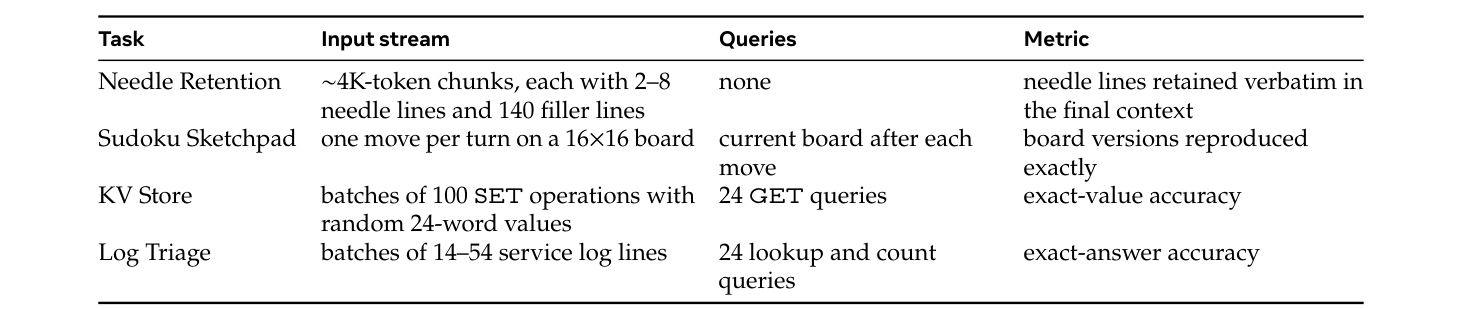
作者先自建一個小測試 ContextBench,專門量 context 管理本身,用來展示現有方法連簡單任務都做不好。設計上刻意不需要推理或知識:任務指令已經明講該做什麼,所以能把全部內容記住的 agent 一定全對,分數差異只反映管理能力。
難度用 context pressure(情境壓力) 調整:整段任務輸入的總量除以 context 上限(32K)。1× 代表全部保留剛好塞滿,24× 代表輸入量是上限的 24 倍;低於 1× 的是對照組,全部留著也放得下。
| 任務 | 考什麼 | 做法 |
|---|---|---|
| Needle Retention | 選擇性保留 | 每個區塊有 2~8 行重要句(needle)和 140 行雜訊,要原文保留 needle、丟掉雜訊 |
| Sudoku Sketchpad | 原地小改 | 16×16 數獨棋盤,每回合下一步,只改一格,不重寫整盤 |
| KV Store | 卸載與檢索 | 一批批 SET 資料,要先存到檔案,之後 24 次 GET 查詢時撈回來 |
| Log Triage | 卸載與檢索 | 一批批 log,之後 24 次查詢與計數 |
表 1 是論文對這四個任務的正式定義(輸入串流與評分指標)。評分一律只看 agent 的 context 內容:只存在檔案裡、沒留在 context 的答案不算分。
結果直接看下圖:CLM 的表現明顯高於其他方法,接近滿分。
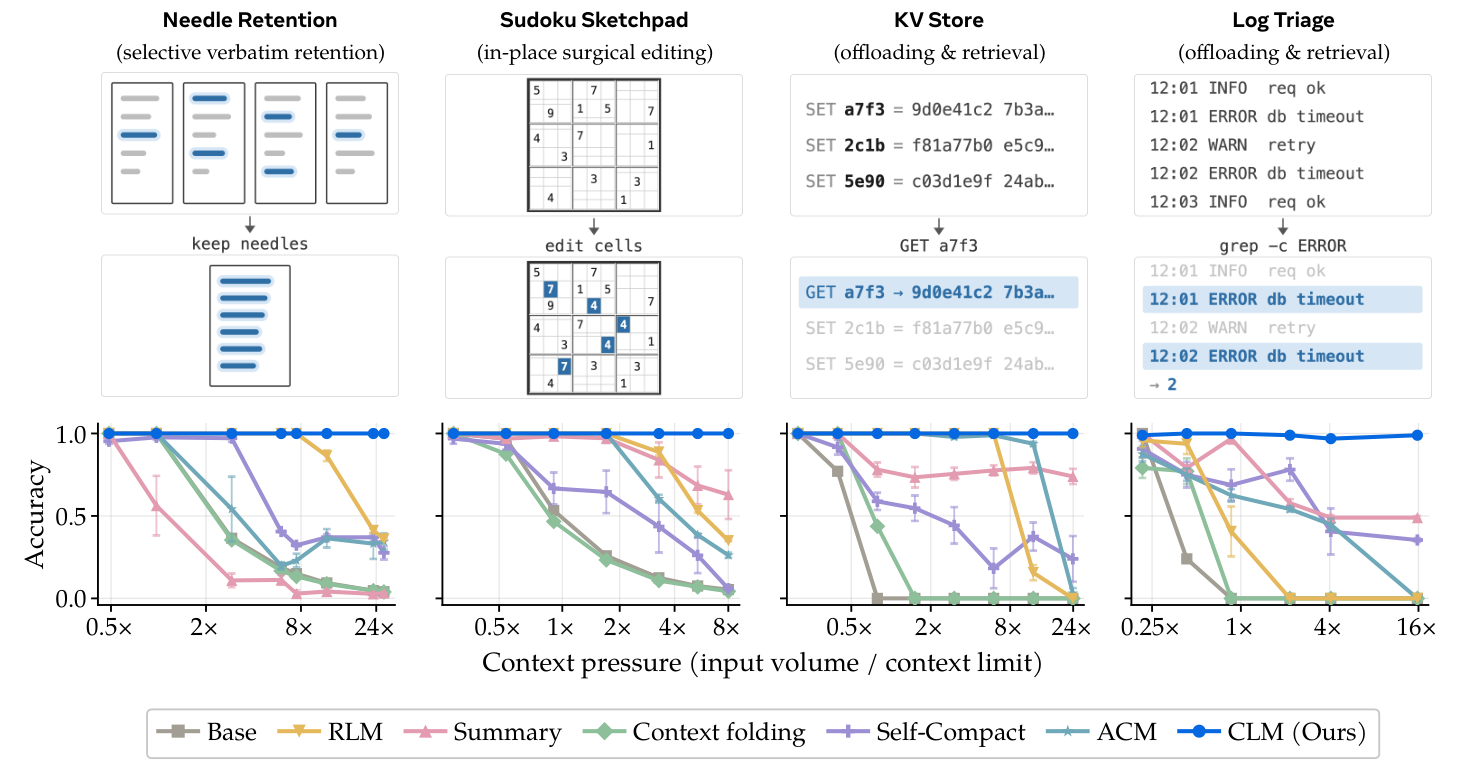
論文歸納了三個失敗原因:
- 摘要式壓縮會遺漏或編造資訊(Needle、Sudoku)。
- 沒有原地編輯的方法,每改一格都得重寫整盤數獨。
- 一般工具能把資料存到檔案,卻沒辦法把它從 live context 主動踢掉。
各難度對應的壓力、實際送給 agent 的訊息範例,分別在論文 Figure 15 與論文 Figure 16。
小結:現有方法要嘛由程式定死,要嘛讓模型從人設計的選單裡挑;選單裡少了「原地改」和「從 context 踢掉」,連簡單任務都會失手。CLM 想把「怎麼改」也交給模型。
3 核心機制:把 context 變成一個可以編輯的檔案
論文的方法有四個零件:context-as-a-file 這個核心機制、衡量成本用的指標、用文字引導與演化管理策略、用 RL 把策略訓練進權重。其中只有第一項是論文真正的主張,後兩項是「因為管理變成模型自己的行為,所以可以被學習」的延伸。這一章先看第一項。
3.1 從「只能往後接」到「任意改寫」
一句話:標準 LM 每一輪只能把新內容接在 context 後面,CLM 則讓模型直接決定下一輪 context 的完整內容。
標準 LM(論文 Eq. 1):
CLM(論文 Eq. 2):
- :第 輪開始時,模型看到的整份 context。
- :串接,把右邊的內容接到左邊後面。
- :模型根據 生成的新 token。
- :論文說它可以是任意函數,由 CLM 自己決定怎麼把 變成 。
白話一點:Eq. 1 的舊 context 一個字都不能動,Eq. 2 沒有這個限制。Eq. 1 其實是 Eq. 2 的特例,只要令 就是它。
第 輪 context 有 20,000 tokens,其中一段是 8,000 tokens 的搜尋結果,模型這輪產出 500 tokens。
- 標準 LM: 有 20,000 + 500 = 20,500 tokens。
- CLM:把那段搜尋結果換成 50 tokens 的筆記,再加上新輸出, 有 20,000 − 8,000 + 50 + 500 = 12,550 tokens。
這段 8,000 tokens 的搜尋結果,後面會一路沿用。
標準 LM 像只能在文件最後一行繼續寫的日誌,CLM 像打開了整份文件的文字編輯器,可以刪改任何一行。這個類比成立,是因為兩者的差別正是「能不能動既有內容」。底層上,context 本質就是下一次呼叫模型時餵進去的文字(一般知識,不是論文內容)。
論文把 寫成「任意函數」,但實作上它只能是模型寫得出來的 Bash 或程式,這是下一小節。
3.2 實作:context 就是一個檔案,模型用 Bash 改
一句話:把模型的 live context 同步成一個檔案,模型用平常的 Bash 指令改這個檔案,改完的內容就是下一輪的 context。流程是:
- harness 把當前 context 寫進檔案,路徑寫在 system prompt。
- 模型像編輯其他檔案一樣,用 Bash 或 Python 改它。
- 檔案一改完,就自動同步給 LLM server。
- 下一輪模型看到的就是改過的 context。
如果模型這輪沒動檔案,新生成的 token 照舊接在後面,也就是 Eq. 1 的預設行為。論文說這樣兼顧「context 重用」與「編輯彈性」。
論文的總覽圖裡,(a) 是模型寫出的 context 管理行為範例,先看這部分即可;(b) 到 (d) 分別是零樣本、指令引導與演化、強化學習的結果,後面會逐一出現。
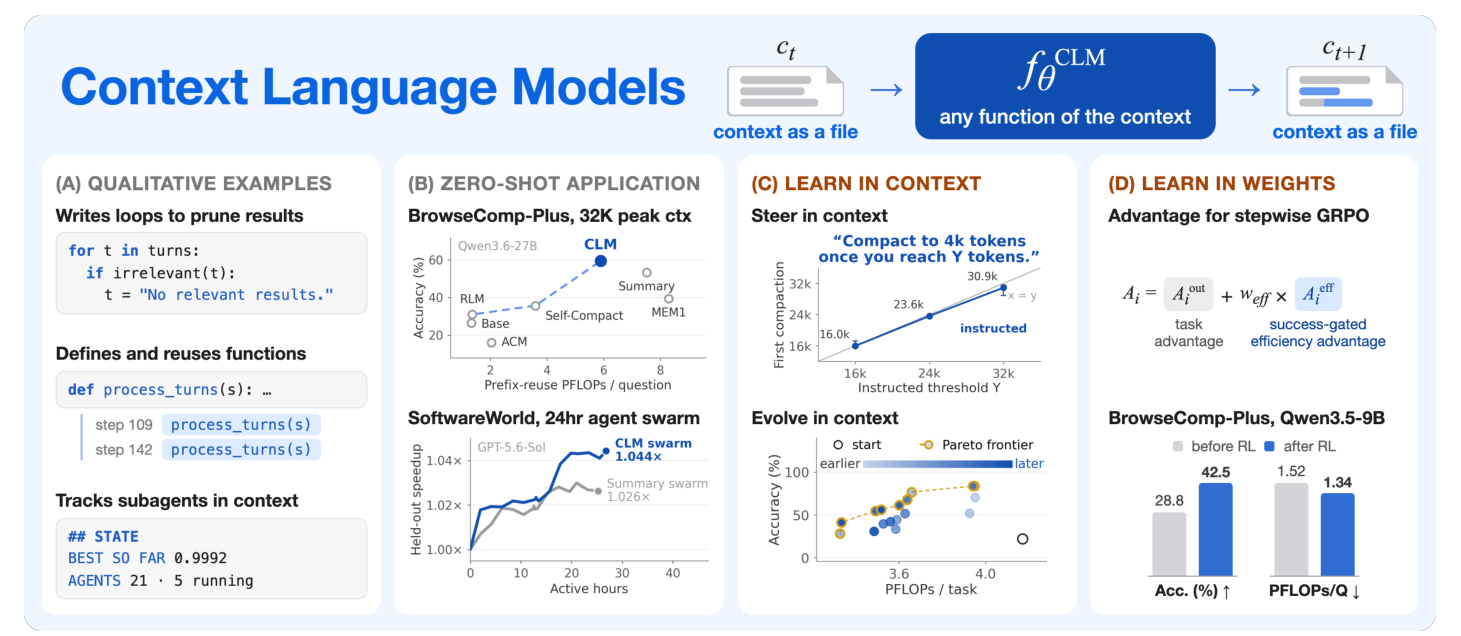
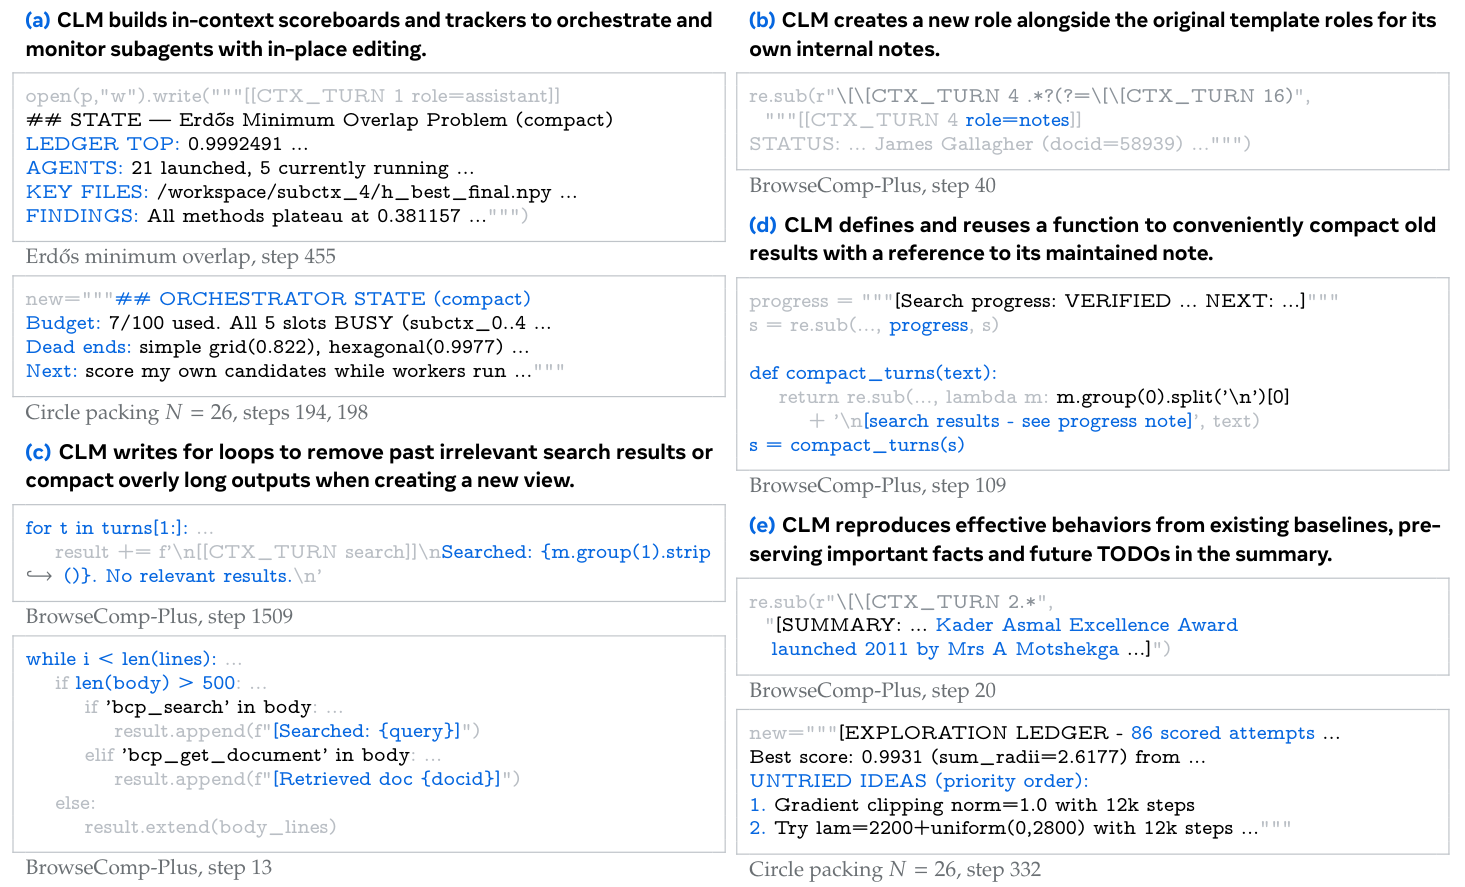
用前面那段 8,000 tokens 的搜尋結果來看(自編例子,寫法參考下面的圖 3):模型只要執行一段 Python,用正規表達式把 turn 4 那一輪整段換成一行筆記,寫回的瞬間 context 就縮小,不需要 harness 預先提供「壓縮」工具。
import re
p = "/tmp/.live_ctx/LIVE_CTX_MAIN.txt"      # 論文 Appendix E 給的 context 檔案路徑
s = open(p).read()
# 把第 4 輪(8,000 tokens 的搜尋結果)整段換成一行筆記
s = re.sub(r"\[\[CTX_TURN 4 .*?(?=\[\[CTX_TURN 5)",
           "[[CTX_TURN 4 role=notes]]\nSearched: xxx. No relevant results.\n",
           s, flags=re.S)
open(p, "w").write(s)                        # 寫回完成 = context 已縮小
論文觀察到,模型會自己發明新做法,例如:
- 在 context 裡維護一個「計分板」,用 163 次原地編輯追蹤子 agent 的狀態,同時讓 context 只維持在 6~8K tokens。
- 新增一種原本模板沒有的角色
notes,專門放自己的內部筆記。 - 用迴圈批次刪掉沒用的搜尋結果,或自己定義輔助函數
compact_turns(同一次任務中被呼叫 37 次)。
3.3 多 agent:一個 context 一個檔案
多個 context 檔案可以同時存在,各自與自己的 LLM server 同步。agent swarm(一群平行工作的 agent)就是在工作區放多個 context 檔案;subagent(由主 agent 啟動的子 agent)的啟動與結束,就是建立與刪除一個 context 檔案。圖 3 的 (a) 可以看到負責調度的主 agent(orchestrator)用一個狀態區塊,記錄 subctx_0..4 各子 context 的狀態。
3.4 要注意:「何時編輯」其實有 harness 在幫忙
論文實驗裡,CLM 另外享有幾項 harness 輔助(論文 Appendix E、腳註 4):
- 離預算上限還剩 2,048 tokens 時,harness 會送出「該編輯 context 了」的提醒。論文的理由是現有模型對自己用了多少 context 沒有準確感知(論文 Appendix G,見後面「模型估不準自己用了多少 context」一節)。
- 在 BrowseComp-Plus(一個在固定語料上搜尋並回答難題的深度研究基準,簡稱 BCP)上,CLM 的編輯回合不算進 100 輪的輪數上限;請求超出預算時,harness 會退回上一輪並重試,最多六次。
另外,主文沒有交代 context 檔案的格式與同步細節,也沒統計模型改壞格式的頻率,文末「概念詳解」裡 context 檔案的那一節有細節(選讀)。
小結:CLM 的全部魔法就是一個檔案,模型改它,下一輪就看到改過的 context;但「何時改」仍有 harness 在提醒。
4 編輯 context 的成本:位置決定要重算多少
CLM 會改 context 中間的內容,這會讓推論伺服器的快取失效,所以光比 token 數不公平。論文自訂了 prefix-reuse FLOPs,算「伺服器實際要做的計算量」(FLOPs 是浮點運算次數,衡量計算量)。要看懂它,先認識伺服器怎麼處理一份 prompt:
- prefill:模型一次讀完輸入的 prompt,算出每個 token 的中間狀態(KV cache,鍵值快取)。
- decode:模型一個一個生成新 token。
- prefix cache 重用:伺服器記住上一輪算過的 KV cache。新 prompt 若開頭一段完全相同,這段就直接沿用;從第一個不同的 token 開始,後面全部都要重算(re-prefill)。
自編例子(概念見下圖左半):context 是 [A B C]。只在後面追加,A、B、C 全部沿用,只算新增的部分。把 B 改成 B’,只有 A 能沿用,B’ 和 C 都要重算,即使 C 一個字都沒變。
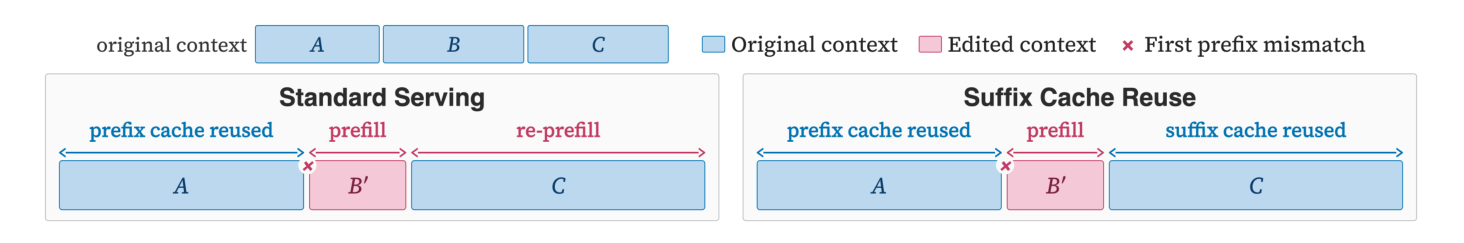
圖的右半是論文為了緩解這個問題提出的 SCR,後面「其餘實驗」那一節會再簡單提到。
論文的公式只算兩件事:沒對上快取的那段(從第一個不同 token 起到結尾)要重新 prefill 的計算量,加上模型生成新 token 的 decode 計算量。白話:只算快取沒幫上忙的部分,加上生成成本。寫成式子是論文 Eq. 3:
- 第一項:沒對上快取的那段(unmatched suffix)的 prefill 計算量。
- 第二項:模型生成的新 token(generated tokens)的 decode 計算量。
論文附錄 C 用 Qwen3.6-27B 做了一個數字例子(下圖)。論文註明這些長度是為說明而選,不是實測:
| 情況 | 可沿用的前綴 | 該輪計算量 |
|---|---|---|
| 只追加 | 18,000 tokens | FLOPs |
| 改中間 | 10,000 tokens | FLOPs |
| 改開頭(等於沒有快取) | 0 | FLOPs(追加的 7.7 倍) |
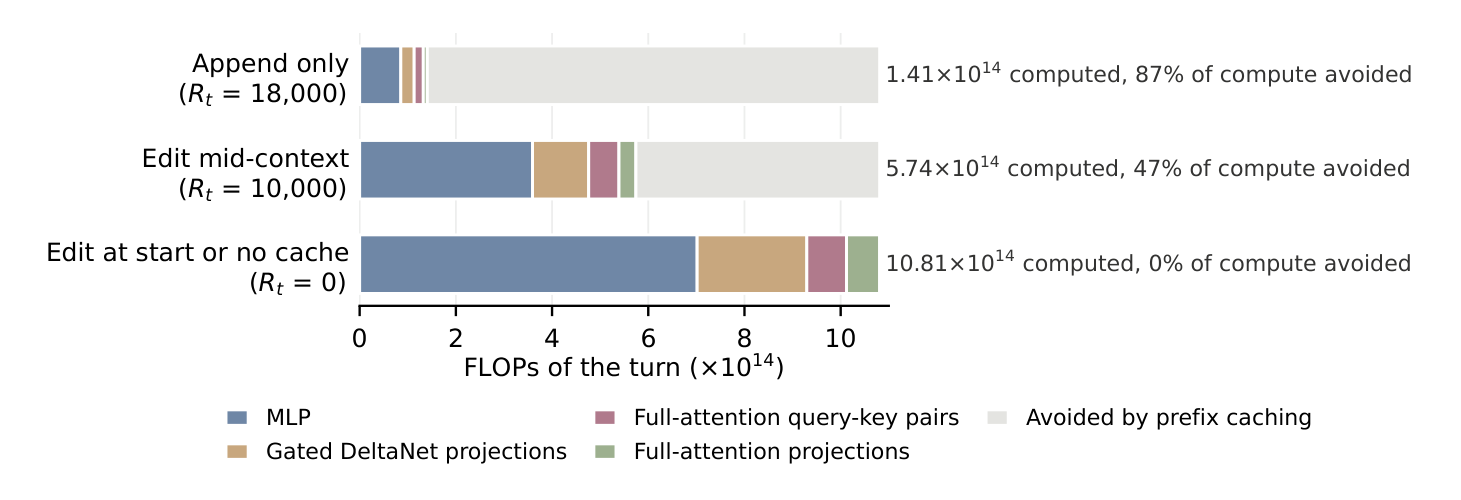
記住這個結論就夠:成本幾乎就是「要重算的 token 數加生成的 token 數」,編輯越靠前,要重算的越多。原因是在這個例子裡,每個 token 的固定處理成本(MLP 與各種投影,也就是模型每層裡和 context 長度無關的運算,約 FLOPs/token)佔了約 86% 的總計算量(我由論文給的數字驗算),attention 這種隨 context 長度增長的成本只佔約 14%。附錄 C(Eq. 7~9)把 Eq. 3 展開成 Qwen3.6-27B 逐層的完整算式,對理解結論沒有幫助,這裡不收錄。
5 不動權重:用一段文字引導與演化管理策略
既然 context 管理變成模型自己的行為,想改變它的策略,不必改 harness 程式,直接用文字告訴模型就行。這一章分兩步:先是人手寫指令引導,再來是讓另一個模型自動改寫指令。
5.1 一句話就能改變管理行為
做法很直接:在 context 裡放一段指令或 skill 文件(skill 在這裡就是一份教模型怎麼做事的文字說明)。和 Eq. 2 唯一的差別,是模型多讀了這段文字;它沒有任何新機制。寫成式子是論文 Eq. 4:
- 、、:同 Eq. 2。
- :放在 context 裡的那段指令或 skill 文件。
論文用 BrowseComp-Plus 的題目與 Claude 4.6 Sonnet,各用一句附加在任務訊息後面的指令,測三種行為(指令原文的中譯在文末「概念詳解」):
| 指令(意思) | 想引導的行為 | 論文量測什麼 | 結果 |
|---|---|---|---|
| 超過 tokens 就壓縮到約 4K | 壓縮時機 | 第一次壓縮時的 context 大小(中位數) | 設 16K/24K/32K,第一次壓縮約在 16.0K/23.6K/30.9K,貼著指令走 |
| 只在子任務邊界壓縮 | 壓縮位置 | 邊界附近兩輪內有壓縮的比例 | 0.40 升到 0.88 |
| 每次編輯前先備份到新資料夾 | 備份習慣 | 編輯前有完整備份的比例 | 0.00 升到 0.68 |
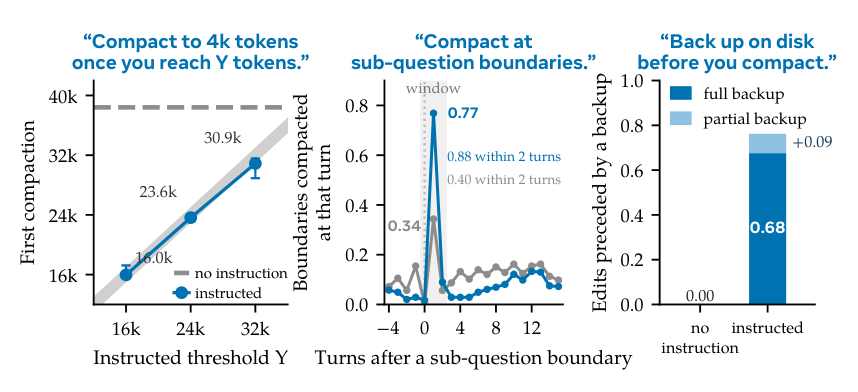
這像給員工一張書面作業規定,而不是去改公司的流程軟體:前者改的是「讀到的文字」,後者改的是「寫死的程式」。模型每輪都把整份 context 當條件來生成,指令就是其中一段 token,這就是 in-context learning(一般知識,不是論文內容)。
- 這三個實驗量的是「模型有沒有照指令做」,沒有報任務正確率,所以證明的是可控性,不是這些策略比較好(我的觀察,論文沒有明講)。
- 指令 就放在 context 裡,而模型能改寫整份 context。它能不能把指令自己刪掉?論文沒有討論。
5.2 讓另一個模型自動改寫指令
上面的指令 是人手寫的;這一步讓另一個模型看 agent 的成功與失敗紀錄,自動把 改寫得更好,一輪輪重複。
目標是:模型權重和 harness 都不動,只搜尋「哪段文字讓 agent 平均得分最高」。寫成式子是論文 Eq. 5:
- :那份指令(skill)的文字。
- 、:一個任務實例,以及任務的資料分佈。
- :agent 帶著 去解 的完整軌跡(來自 Eq. 4)。
- :這條軌跡的得分,來自任務的自動評分器。
- :找出讓平均得分最高的那份文字。
一輪的流程:
- 目前的 skill 在訓練集跑 rollout(讓 agent 實際把整條任務跑完)。
- proposer(負責改寫 skill 的另一個模型)讀這些成功與失敗的軌跡,寫出多份新 skill 候選。
- 候選先在 6 題訓練題初篩,過關再跑 12 題,最後在 102 題的開發集(dev)評分。
- 選出下一輪的 skill,重複;連續 5 次提案沒進步就停。
- 最終 skill 在測試集(test)只評一次。
兩種設定:assisted evolution 是 Qwen3.6-27B 當 agent、Claude Fable 5.1 當 proposer;self-evolution 是 Opus 5 同時當 agent 和 proposer。
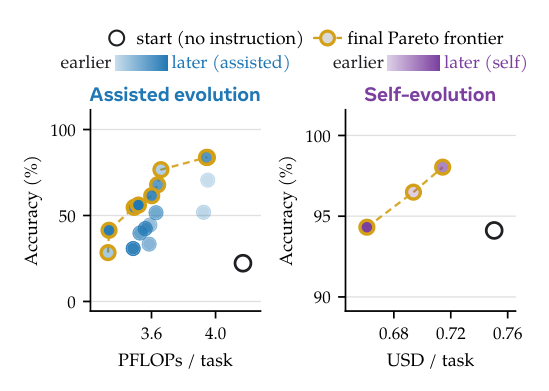
KV Store 任務、assisted 設定的結果如下。dev 是用來挑 skill 的題目,test 是定案後才評一次、沒參與挑選的題目:
| 階段 | dev(用來挑選) | test(定案後才評一次) |
|---|---|---|
| 起點:完全沒有管理指令 | 22.3% | 38.3% |
| 演化後選出的 skill | 83.8% | 74.2% |
- 論文摘要的「最多提升 35.9 點」,剛好是 74.2 − 38.3,也就是 KV Store 單一任務、assisted 設定下 test 的最好結果(我的計算)。
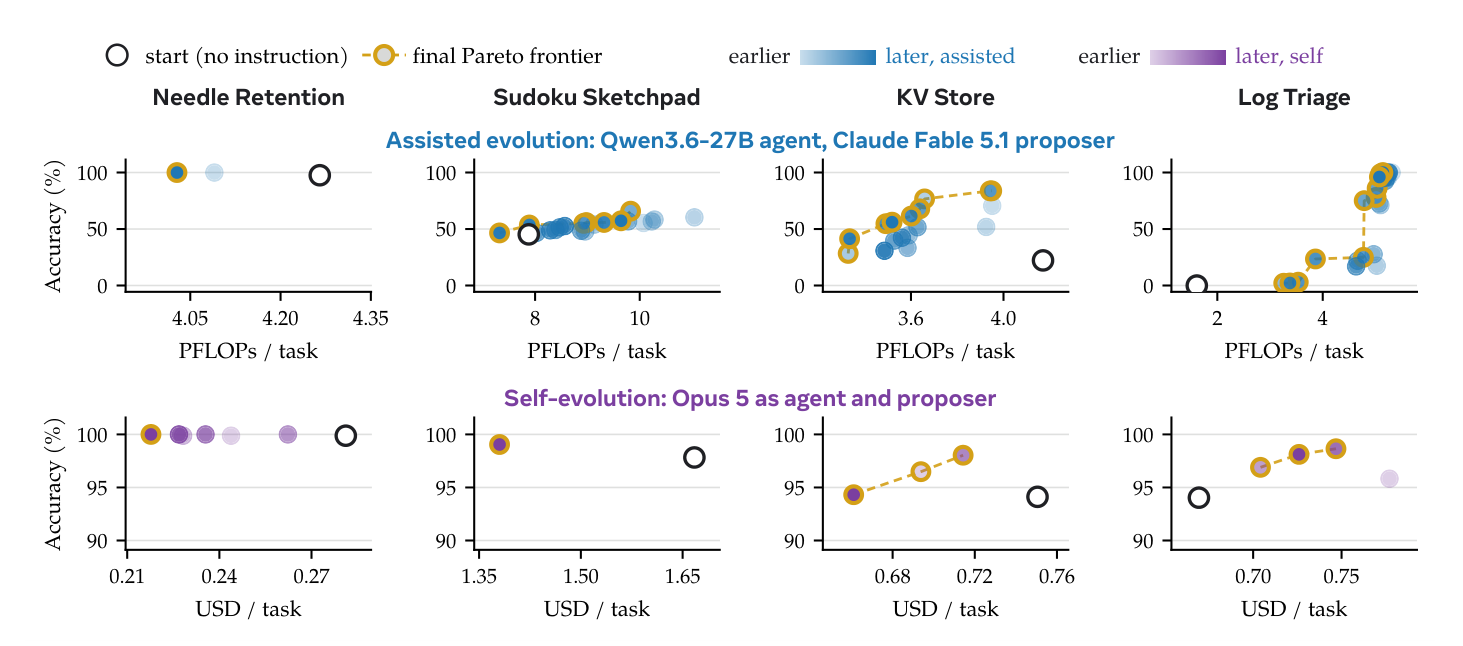
- 其他三個任務,文字只給 dev 數字:Needle Retention 97.6% 到 100.0%、Sudoku Sketchpad 45.3% 到 65.8%、Log Triage 0.0% 到 100.0%。dev 同時被用來選 skill,所以偏樂觀。
- self-evolution:Opus 5 起點就在 94% 到 100% 之間,演化後的 skill 要嘛在同樣準確率下降低成本,要嘛再提升準確率。
下圖會用到 Pareto frontier(帕累托前緣) 這個詞,意思是「沒有別的 skill 同時更準又更便宜」的那批 skill。
四個任務全部的結果在下圖:上排是 assisted evolution,下排是 self-evolution。
演化迴圈像教練看完比賽錄影後改寫戰術手冊,再讓球隊試打。底層上,這是用 LLM 當突變運算子的文字空間爬山搜尋,沒有梯度(一般知識,不是論文內容)。論文引用的對應方法是 GEPA(Agrawal et al., 2026,Reflective prompt evolution can outperform reinforcement learning)。
演化改的是 context 裡的文字,下一章的 RL 改的是模型權重,兩者都在學管理策略。
6 改權重:用 RL 學會怎麼編輯 context
前一章改的是 context 裡的文字,這一章改模型權重,讓模型從「最後有沒有答對」學會怎麼編輯 context。
6.1 GRPO 沒變,變的是兩處
GRPO(Group Relative Policy Optimization) 是一種 RL 演算法(來自 DeepSeekMath,Shao et al., 2024)。同一題先抽一組(group)完整軌跡,每條軌跡的 advantage(優勢)等於它的得分相對於組內平均的好壞:減掉平均、再除以標準差。
其中 是第 條軌跡的得分。這條公式是一般知識,論文只說「標準 GRPO advantage」,沒有寫出來。
自編例子:同一題抽 4 條軌跡,答對得 1、答錯得 0,得分是 1, 0, 0, 1。平均 0.5,標準差 0.5,advantage 是 +1, −1, −1, +1。答對的被鼓勵,答錯的被壓抑。
CLM 的訓練沿用這套,改動只有兩處:
- 輸入的準備:CLM 會編輯 context,所以最終的 context 已經不是早期某一步當時看到的內容。論文的做法是每次模型呼叫連同它當時真正看到的 context,各自算一次(stepwise GRPO),整條軌跡的 advantage 原封不動分給底下每一次呼叫。這個做法不是論文新發明,附錄 A 說明延續 ReSum 與 Sculptor。凡是會改寫歷史的 agent(摘要、折疊 folding、CLM)要用 RL 訓練,都面臨同一個問題。
- advantage 多了一項效率獎勵(下一小節),這才是論文自己的新設計。
6.2 效率獎勵只在答對的軌跡之間比
結果獎勵只分對錯,對「編輯得好不好」是弱監督:答對的軌跡裡可能有很笨的編輯,答錯的裡也可能有好的編輯。直接獎勵「編輯次數」或「刪掉的 token 量」又會被鑽漏洞,模型可能做一堆沒必要的編輯、把重要資訊也刪掉,或破壞 prefix 重用,這叫 reward hacking。所以論文只在「已經答對」的軌跡之間,依成本(prefix-reuse FLOPs)排序加減分,這種設計叫 success-gated:只有答對的軌跡才參與效率比較。
白話:答對的軌跡裡,比平均便宜的加分、比平均貴的扣分;答錯的完全不參與。寫成式子是論文 Eq. 6:
最後合成:
- :同一題抽出的那一組軌跡。
- :這一組裡答對的軌跡。
- :第 條軌跡的 prefix-reuse FLOPs。
- :答對軌跡的平均成本。
- :把結果限制在 −1 到 +1。
- :標準 GRPO 的結果 advantage。:權重,論文 Appendix E 給 0.25。
- 答對的軌跡少於 2 條時,整組的 都設為 0。
完整數字例子(自編例子,成本單位自訂):同一題抽 4 條軌跡。表中的 和前面的例子不同,因為這組 4 條裡有 3 條答對;最後一欄合計是 。
| 軌跡 | 對錯 | 成本 | 合計 | ||
|---|---|---|---|---|---|
| 對 | 2.0 | 0 | +0.58 | +0.58 | |
| 對 | 1.0 | +0.5 | +0.58 | +0.70 | |
| 錯 | 0.5 | 0(不參與) | −1.73 | −1.73 | |
| 對 | 3.0 | −0.5 | +0.58 | +0.45 |
算法:答對的成本平均 , 是 , 是 。 一欄是用「減平均、除標準差」算的(論文沒寫公式)。兩個重點: 成本最低卻答錯,所以拿不到效率加分,這就是 success-gated 的作用;效率項只是排序用的小項,,遠小於對錯造成的差距。
效率分數怎麼落到每個 step 上,論文沒講清楚。這是 RL 的 credit assignment(功勞分配) 問題:一條軌跡有很多步,最後只得到一個分數,要怎麼決定每一步該分到多少功勞或責任。這裡的疑問在於效率項是分給整條軌跡的所有 token,還是只給編輯 context 的 token;文末「概念詳解」有一節專門談。
6.3 實驗結果:準確率打平,成本低約四成
- 模型與資料:Qwen3.5-9B,用 OpenResearcher 資料集的 3,040 題訓練 70 步,在 BrowseComp-Plus 全部 830 題評估。獎勵是 GPT-5.4-nano 依 DeepSearchQA 的評分準則(rubric)打的對錯二元分數。
- CLM:context 預算 28K(保留 2,048 tokens),最多 80 輪,編輯回合不計入;另加效率 advantage(權重 0.25,論文 Appendix E 說套用在 context 管理相關的 token 上)以及工具呼叫失敗與格式錯誤的懲罰。
- 對照組 Summary:agent 照常累積 context,累積到 28,672 tokens 時,除了 system prompt 和任務訊息之外,整段歷史被換成一則摘要(摘要用 Codex 的摘要 prompt),最多跑 100 輪。「何時摘要」和「怎麼摘要」都是人定死的;Appendix E 寫它只用任務獎勵訓練。摘要由誰來寫,論文沒明說。
表 2 是論文的原表,下面另列前後差值方便比較。Acc. 是 BrowseComp-Plus 準確率;PFLOPs/Q 是每題平均的 prefix-reuse PFLOPs( FLOPs),越低越好。
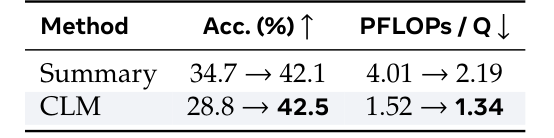
| 方法 | Acc. 訓練前到後 | PFLOPs/Q 訓練前到後 |
|---|---|---|
| Summary(對照組) | 34.7 到 42.1(+7.4) | 4.01 到 2.19 |
| CLM | 28.8 到 42.5(+13.7) | 1.52 到 1.34 |
- 訓練前,CLM 比 Summary 低約 6 點。論文歸因於小模型的 context 管理能力不足;論文 Appendix F 也說 Qwen3.5-9B 很少編輯 context(在 TerminalBench 2.1 這組終端機任務上平均 1.4 次,一半的任務完全不編輯)。所以 CLM 的零樣本效果取決於模型本身的判斷力。
- 訓練後,準確率實質上打平(42.5 對 42.1),CLM 每題成本低約 38.8%(,與論文引言一致)。訓練曲線見下圖。
- 論文摘要的「提升 47.6%」是相對值(42.5 除以 28.8),起點很低;絕對提升是 13.7 點。和訓練後的 Summary 比只贏 0.4 點,真正的差別在成本。
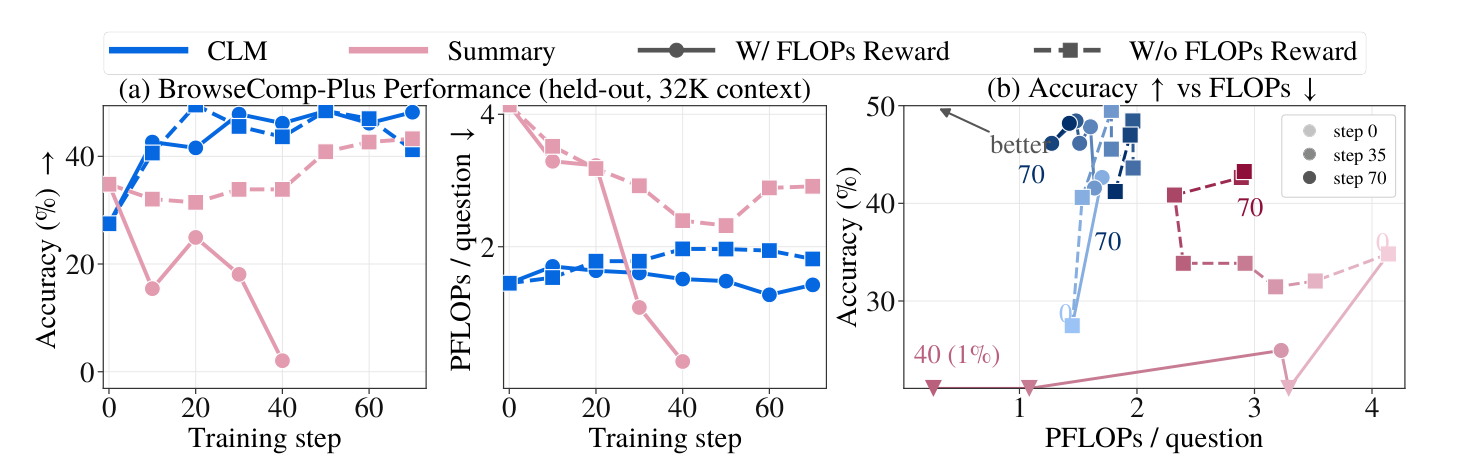
小結:RL 讓 9B 模型的 CLM 追上訓練後的 Summary,準確率打平,差別在成本;不過兩邊的獎勵設計不同,這個成本差距不一定是同條件的比較。
7 四個零件一張表
進入實驗之前,先把四個零件放在一張表裡,每一項附上最該記得的保留:
| 零件 | 做了什麼 | 動的是哪裡 | 要記得的一個保留 |
|---|---|---|---|
| context-as-a-file | 模型用 Bash 改 context 檔案,改完同步回 live context() | 機制本身,不訓練 | when 實際上靠 harness 在剩 2,048 tokens 時提醒;檔案格式與改壞的處理,論文沒說 |
| prefix-reuse FLOPs | 理論計算量 = 沒對上快取的 token + 生成的 token | 衡量用的尺 | 是理論值,不是實測延遲 |
| skill 引導與演化 | 把指令 放進 context 引導行為;proposer 看失敗紀錄反覆改寫 | context 裡的文字,權重不動 | 35.9 點是 KV Store 的 test 數字,dev 數字偏高;起點是「完全沒指令」 |
| RL | stepwise GRPO,每次模型呼叫各算一次,共用整條軌跡的 advantage;再加一項只在答對軌跡內比成本的效率 advantage | 模型權重 | 效率項怎麼分給 token 有兩種讀法;表 2 兩邊的獎勵設計不同 |
零件之間的關係是:第一項讓 context 可編輯,第二項提供衡量編輯成本的尺,第三項在不動權重的前提下用文字改善管理策略,第四項改權重來學管理策略(效率獎勵直接用第二項的指標)。第三、四項學的是同一件事,差別只在學到哪裡:前者學在 context 的文字裡,後者學在權重裡。
8 主要證據:現成模型零樣本對上最強的固定流程
論文的主證據是零樣本實驗:不訓練、不演化,直接把現成模型換成 CLM 的玩法,與其他 context 管理方法比。RL 與 skill 演化是另外兩組獨立的結果,兩者互不重疊(見文末「概念詳解」最後一節)。先認識用到的基準:
- BCP(BrowseComp-Plus):在固定語料上搜尋並回答難題的深度研究基準,測準確率。
- TB2.1(TerminalBench 2.1):89 個終端機任務,每題只看通過或失敗。TBLite 是它的輕量版。
- EdgeBench-10:從 EdgeBench 挑 10 個程式庫優化任務,跑 12 小時,評分 0 到 100。
- Software World:6 個互相依賴的程式庫由 agent swarm 優化 24 小時,在沒見過的下游套件上量加速比。
8.1 BrowseComp-Plus 與 TerminalBench:相對 11.4% 其實約 6 點
所有方法用同一個模型(Qwen3.6-27B)、同一個 agent 框架(Mini-SWE-Agent)、32K 預算、100 輪上限,對手有 Base(不做任何管理)、Summary、MEM1、Self-Compact、ACM、RLM(把長輸入當成變數、讓模型按需讀取的方法)。換不同大小模型的版本在論文 Figure 17。
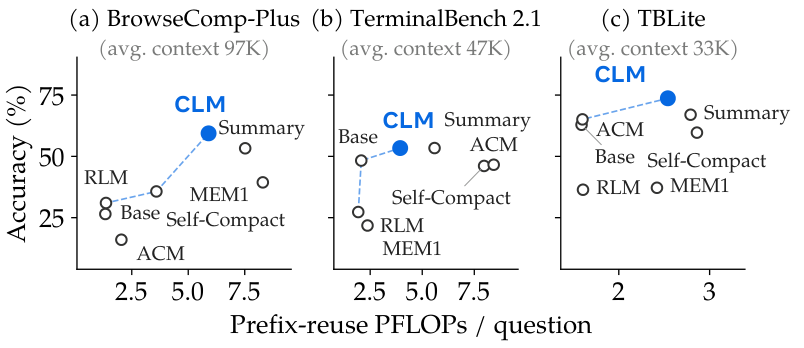
乾淨對照是 CLM 對最強對手 Summary:
| 基準 | CLM | Summary | 絕對差 | CLM 的 FLOPs |
|---|---|---|---|---|
| BCP | 59.4% | 約 53.3%(由「相對高 11.4%」反推) | 約 +6.1 點 | 少 21.5% |
| TB2.1 | 與 Summary 打平 | 同左 | 約 0 | 少 29.5% |
| TBLite | 73.7% | 67.0% | +6.7 點 | 少 9% |
論文摘要與引言的「高 11.4%」是相對值,換成絕對點數約 6 點。準確率真正贏的是 BCP 和 TBLite;TB2.1 只贏在成本。
8.2 EdgeBench-10:預算決定優勢大小
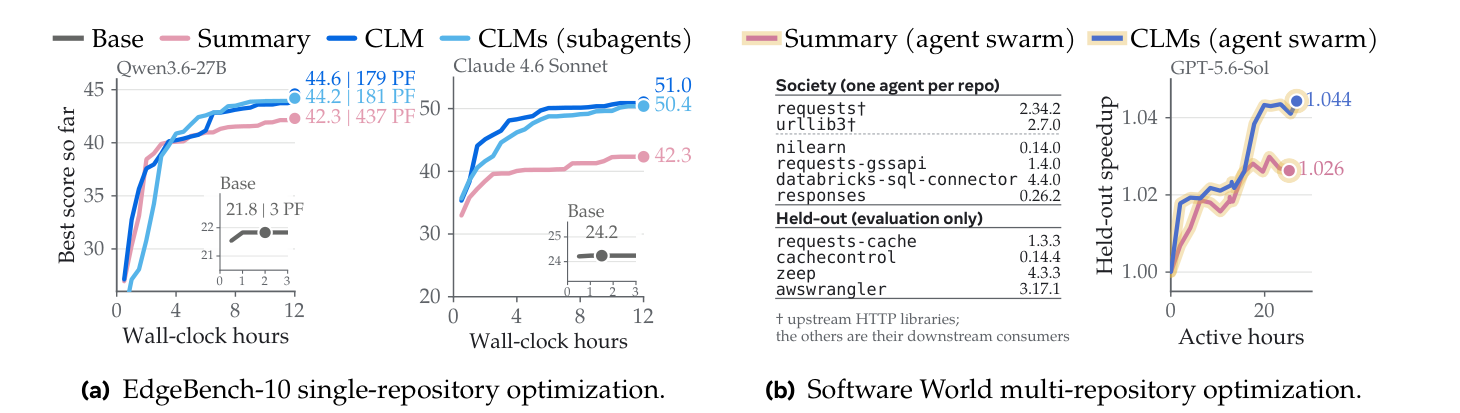
agent 在一個程式庫上連續優化 12 小時,容器沒有網路;每次提交由 EdgeBench 評分器打 0 到 100 分,一個 run 的分數取「最好的提交」與「最終程式庫」兩者較高者。每個任務跑三次(三個隨機種子,seed),取最好的一次(best-of-three)。PF 指每次試驗的平均 prefix-reuse PFLOPs。比較對象是 Base、Codex 風格摘要、CLM,以及 CLM 加最多五個同時運作的子 agent。
下圖的 (a) 是 32K 預算下的 EdgeBench-10 曲線,(b) 是後面「其餘實驗」會提到的 Software World。128K 預算的版本在論文 Figure 19。
| 預算與模型 | CLM | Summary | CLM 加子 agent | 備註 |
|---|---|---|---|---|
| 32K,Qwen3.6-27B | 44.6(179 PF) | 42.3(437 PF) | 44.2(181 PF) | CLM 較準,只用約 41% 算力 |
| 32K,Claude 4.6 Sonnet | 51.0 | 42.3 | 50.4 | Summary 在 Qwen 與 Claude 上都是 42.3,論文原文如此 |
| 128K,Qwen3.6-27B | 47.3(142 PF) | 47.8(222 PF) | 50.2(219 PF) | CLM 與 Summary 打平,只省算力 |
三個讀法:
- 32K 時 CLM 明顯贏:Qwen 上 +2.3 點、成本只要約 4 成。論文摘要的「高 5%、少 59% FLOPs」對應的就是這一格(44.6 除以 42.3 約 +5.4%;179 除以 437 約 41%),是單一最好看的設定。
- 128K 時準確率優勢消失:CLM 47.3 對 Summary 47.8,只剩約 36% 的算力節省()。合理的推論(非論文原文):預算寬裕時,管理壓力小,管理策略的差距也縮小。
- 子 agent 沒有穩定好處:32K 時沒有增益,128K 時 +2.9 點但算力與 Summary 相當。論文自己也說單一程式庫上子 agent 幫助不大。
把這兩組實驗放在一起看:CLM 的優勢在「預算緊、context 壓力大」時最明顯,預算放寬就收斂成省成本。這比論文摘要寫的「全面領先」窄得多。
8.3 其餘實驗:補充證據與 CLM 的依賴
下面四組是輔助證據,不細拆:數學優化、Software World、模型大小比較、context 長度感知。數學優化問題上,CLM 與 OpenEvolve(一套專為這類問題設計的演化式工作流程)的比較見表 3。
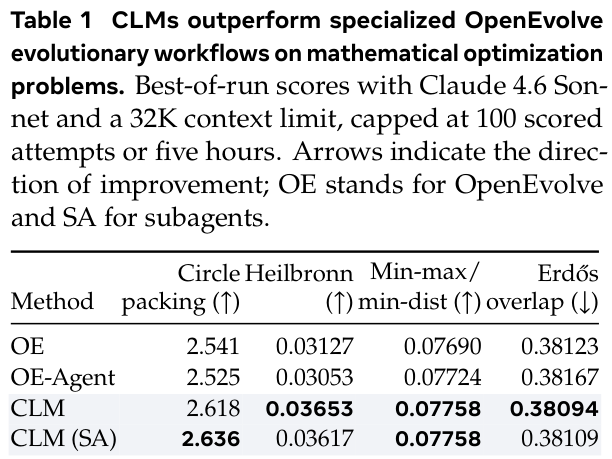
- 數學優化 vs OpenEvolve(表 3):想證明通用 agent 加 CLM 能贏專用的演化流程。四題 CLM 都最好:圓填充 2.618 對 2.541(+3.0%),Heilbronn 0.03653 對 0.03127(+16.8%),另兩題差距只在小數點第三到第四位。提醒:每個方法只跑一次,取最好結果;差距很小的兩題不能當證據,Heilbronn 的 16.8% 是相對值。
- Software World,24 小時 agent swarm(圖 11 的 (b)):想證明改進能遷移到沒見過的下游套件。17 個沒見過的基準上的幾何平均加速,圖上標 CLM 約 1.044、Summary 約 1.026;絕對多出約 1.8 個百分點,論文寫的「多 65%」是相對說法。提醒:模型是 GPT-5.6-Sol、context 預算 272K,不是前面的 32K 設定;文字沒交代跑了幾次。
- 模型大小比較(論文 Figure 17、Appendix F):說明 CLM 的效果取決於模型自己會不會判斷何時編輯。Qwen3.5-9B 在 TB2.1 平均只編輯 1.4 次,一半任務完全不編輯;Qwen3.6-27B 平均編輯 2.6 次。9B 的 context 峰值中位數 30.2K(上限 32K),27B 是 17.6K。提醒:9B 的零樣本結果不能和 RL 章的訓練前結果混讀,說明見下一段。
- Context 長度感知(論文 Appendix G,下一節的圖 12):說明現有模型不太會估算自己用了多少 context,所以需要環境提醒。沒有提示時估算誤差很大;給了 token 數的提示後誤差明顯下降。提醒:只用 50 個輸入測,而且測的不是主要實驗用的 Qwen3.6-27B。
關於模型大小那一列的提醒:論文 Appendix F 說 9B 在 BCP 上零樣本 CLM 是 39.9%,高於 Summary 的 37.7%;但 RL 章的表 2 說 9B 訓練前 CLM 是 28.8%,低於 Summary 的 34.7%。兩者設定不同(零樣本實驗:32K、100 輪;RL 評估:28K、最多 80 輪)。這是我的推論,論文沒點明這個差別。
這四組的讀法:前兩組是「CLM 比較好」的補充證據,但都不是受控實驗:單次執行、勝幅小,或換了模型與預算。後兩組是「CLM 目前有哪些依賴」的證據:模型要夠強,而且要有外部提醒。
順帶一提,圖 4 右半的 SCR(Suffix Cache Reuse)是論文在服務端提出的做法:改動中間內容之後,仍然重用所有留下來的 token 的快取,減少重新 prefill。論文另外用實驗比較了 SCR 與標準服務,但這篇文章不展開它的實驗細節,有興趣請回原論文查。
8.4 模型估不準自己用了多少 context
模型要自己決定「現在該不該壓縮」,前提是知道已經用了多少 token。論文 Appendix G 發現現有模型不太會估。衡量用的是 MAE(Mean Absolute Error,平均絕對誤差):估計值與實際 token 數的差距,取絕對值再平均,單位是 token,越小越準。下圖每個點是一次估計對上伺服器回報的真實 prompt 長度,各小圖分別是沒有提示,以及在輸入 25%、50%、75% 處給一個 token 數錨點。
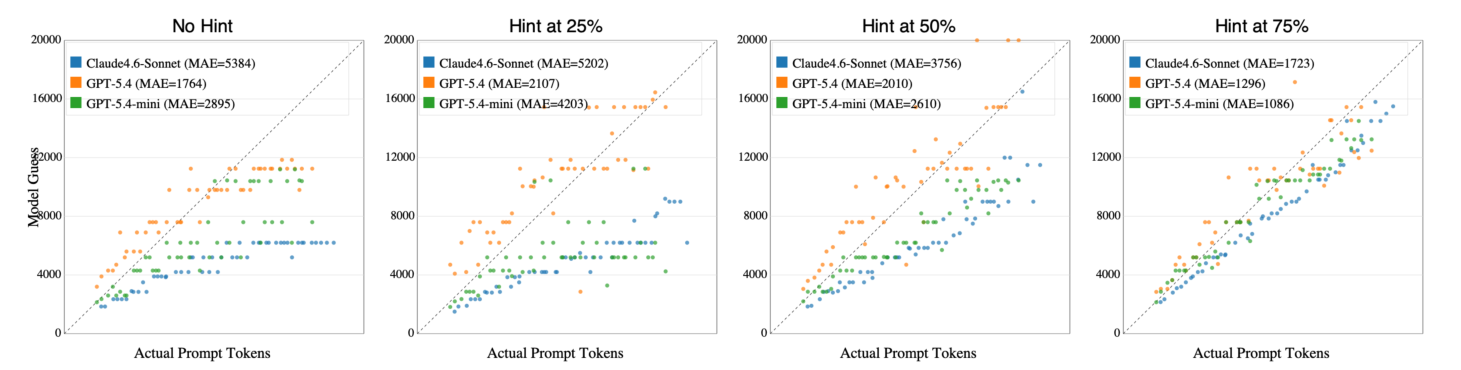
圖中的小字不好讀,圖例裡的數字整理在下表。這些數字取自圖例,本文沒有對照原圖逐點核實,請以原圖為準:
| 模型 | 無提示 | 提示在 25% 處 | 提示在 50% 處 | 提示在 75% 處 |
|---|---|---|---|---|
| Claude 4.6 Sonnet | 5384 | 5202 | 3756 | 1723 |
| GPT-5.4 | 1764 | 2107 | 2010 | 1296 |
| GPT-5.4-mini | 2895 | 4203 | 2610 | 1086 |
論文文字的結論有三點:長 context 下,模型的估計會落在重複出現的幾個數字(如 6.2K、9.8K);給了 token 數的提示後誤差下降;提示離估計點越近越有效。「重複的數字可能來自預訓練的計數習慣」是論文自己的猜測,沒有驗證。這就是為什麼 harness 要補提醒:實驗裡的提醒(剩 2,048 tokens),以及 ContextBench skill 摘錄(論文 Table 4)中的 [context: ~N/M tokens] 讀數,都是在補這個缺口。
可遷移的規則(推論,非論文原文):任何資源(token、時間、金額預算)都由環境量測,附在每次工具結果裡回報;回報要貼近決策點,每輪都附,比只在開頭講一次有效。
for each tool_result:
result += f"\n[context: ~{count_tokens(ctx)}/{limit} tokens]"小結:32K 的緊預算下,CLM 以較低成本達到相當或更好的準確率(TB2.1 打平,BCP、TBLite 與 EdgeBench 較準);在 EdgeBench 上把預算放寬到 128K,準確率優勢就消失,只剩省成本。而且 CLM 目前依賴兩件事:模型要夠強,還要有外部的用量提醒。
9 整體評價:概念值得試,證據只夠說明有潛力
先說結論:研究價值中等偏低;工程價值是「概念值得試,證據只夠說明有潛力」。
研究價值:論文的貢獻是介面設計,不是新演算法。「讓模型對自己的 context 有寫入權」這個想法簡單、通用,也把 when 與 how 兩個維度都推到了模型手上,這是它最持久的部分。但底下用的東西幾乎都是現成的:RL 是 GRPO 加上 ReSum 與 Sculptor 式的分段(附錄 A 自己承認),skill 演化是 GEPA 風格。真正算新的只有 success-gated 效率 advantage,權重只有 0.25,而且它怎麼落到 token 上論文沒說清楚。
工程價值:最強的證據是 32K 的緊預算下,27B 現成模型零樣本就勝過固定流程(BrowseComp-Plus 約 +6 點;EdgeBench-10 +2.3 點且只用約 4 成算力)。最弱的是:沒有任何實驗把「自由編輯」的功勞,從 harness 的輔助設計裡拆出來;預算放寬到 128K,準確率優勢也消失,只剩省成本。所以能說的是「整套設計」在緊預算下划算,還不能說「context 是檔案」這個想法本身就是主因。
9.1 論文摘要的宣稱,換成乾淨版本
| 論文摘要的宣稱 | 乾淨版本 |
|---|---|
| BCP 準確率高 11.4%,FLOPs 少 21.5% | 絕對約 +6 點(由相對值反推)。CLM 享有編輯回合不計輪數、超預算退回重試、剩 2,048 tokens 提醒,對手是否同樣未說明 |
| EdgeBench 高 5%,FLOPs 少 59% | 32K Qwen:44.6 對 42.3,+2.3 點。128K:47.3 對 47.8,−0.5 點,只剩省約 36% 算力。論文摘要選的是 32K 最好看的設定;分數是 best-of-three |
| Software World 多 65% | 約 1.044 對 1.026,絕對約 1.8 個百分點;相對值建在很小的基期;用 GPT-5.6-Sol 與 272K 預算 |
| skill 演化提升 35.9 點 | KV Store 單一任務,test 38.3 到 74.2;起點是「完全沒指令」,不是對人手寫 skill |
| RL 提升 47.6% | 絕對 +13.7 點;對訓練後的 Summary 只贏 0.4 點;兩邊獎勵設計不同 |
可以相信的是「緊預算下,CLM 以較低成本達到相當或稍好的準確率」,不能相信的是論文摘要給人的那種「全面大幅領先」的印象。表中每一列,論文摘要用的都是當下最好看的相對值或設定。
9.2 整篇共有的弱點
- 沒有拆開「自由編輯」與「harness 輔助」的功勞:CLM 同時享有編輯回合不計輪數、退回重試、剩 2,048 tokens 的提醒,沒有任何實驗把這些輔助關掉;零樣本實驗中 CLM 的 system prompt 與 skill 內容也沒給,看不出有多少功勞來自提示寫得好。這是最關鍵的一條,它決定能不能把「CLM 勝出」歸因給想法本身。
- 缺變異數與重複次數:數學優化每個方法只跑一次;EdgeBench 取三個 seed 的最好結果,沒有誤差;Software World 沒交代跑幾次。所以 44.6 對 44.2、RL 贏 0.4 點、數學題小數點第三到四位的差距,都分不出是真差距還是雜訊。約 2 點以內的小勝都不該當證據。
- 證據是拼起來的,沒有串成一條線:零樣本用 Qwen3.6-27B 與 Claude 4.6 Sonnet,RL 用 Qwen3.5-9B,skill 演化用 Opus 5 或 Fable 5.1 當 proposer,Software World 用 GPT-5.6-Sol。沒有任何一個模型從頭走到尾。
- 自建基準與自訂指標:ContextBench 是作者自建的;FLOPs 是自訂的理論值,不等於實際延遲或帳單。
另有一個結構性的提醒:「CLM 勝過現有最強方法」(27B 現成模型,零樣本)與「CLM 可被訓練變強」(9B 加 RL,或 skill 演化)是兩組互不重疊的證據。論文沒有展示「訓練或演化後的 CLM 在長時間任務上更強」,詳見文末「概念詳解」最後一節。
9.3 把自由度交給模型,什麼條件下划算
什麼時候值得把自由度交給模型?以下是我整合論文證據得出的判斷,推論,非論文原文:
| 條件 | 論文的證據 | 證據強度 |
|---|---|---|
| 預算緊 | EdgeBench 32K 時 CLM 較準又省;128K 時準確率打平,只剩省成本(圖 11、論文 Figure 19) | 直接,最強 |
| 模型夠強 | 9B 很少編輯 context,一半任務完全不編輯(論文 Appendix F);訓練前 CLM 落後 Summary(表 2) | 間接,是不同模型、不同設定的比較 |
| 任務長 | 沒有實驗單獨改變任務長度 | 弱,論文未驗證 |
| 有 harness 輔助 | 剩 2,048 tokens 的提醒、超預算退回重試;模型對自己的 context 用量估不準(論文 Appendix G) | 目前不是完全放手,仍需外部保險 |
還有一個講過頭要避開的地方:「三者同時成立」是我編的組合,論文沒測過三者的交互作用,它只是決定「從哪裡開始試」的經驗法則,不是必要條件。
9.4 安全風險:自己寫、自己讀回的 context
論文第 6 節提到,可編輯的 context 可能成為注入的提示或自我生成的指令跨輪持續的管道。它引用 OpenAI 的報告:模型曾在自己的壓縮摘要裡塞入未授權的指令,並影響後續行為。論文沒有做任何實驗,也沒有提出防禦,只說未來要研究。
機制是這樣(自編例子):
- 工具結果(例如網頁)裡藏有惡意指令。
- agent 把它寫進自己的筆記或摘要。
- 下一輪讀到,把它當成自己的計畫。
- 指令持續生效。
這樣的內容在後面幾輪看起來是「我自己寫的」,比一次性的注入更難被辨認。OpenAI 那個案例是模型自己加指令,和外部注入是兩個變體,但持久化的路徑相同。
可遷移的規則(推論,非論文原文):
- 凡是「模型能寫、之後又會讀回」的地方(摘要、筆記、記憶、CLM 的 context 檔案),都是持久化通道,不限於 CLM。
- CLM 的面積比摘要大,因為編輯不受限。
- 論文沒說的:context 檔案是否包含 system prompt、模型能不能刪掉自己的指令。
小結:能相信的是「緊預算下以較低成本達到相當或稍好的準確率」,不是「全面大幅領先」;而且這份自由也帶來一條論文還沒處理的安全通道。
10 結論:值得帶走的東西
這篇論文最值得記住的不是任何一個百分比,而是它把 context 管理拆開來看的方式:何時做與怎麼做是兩件事,過去的方法把其中一件或兩件鎖在人手裡,CLM 兩件都交給模型。這個主張在緊預算下有證據支持,但證據混著 harness 的輔助設計,而且沒有變異數;所以它是一個值得認真嘗試的設計選項,還不是已經被證明的最佳做法。
論文自己的貢獻之一:context-as-a-file,讓模型對自己的 context 有寫入權。 標準 LM 的 context 只能往後接,因此所有「留什麼、丟什麼」的決定都落在 harness 手上。過去讓模型參與,模型能做的事仍受限於人預先設計的操作選單(壓縮、卸載、檢索);這篇論文把這道限制拿掉,操作的種類由模型自己決定(刪一條、批次刪、寫一個輔助函數、新增筆記角色,都不用事先設計)。
這是最持久的部分:想法簡單、通用,不依賴特定模型或基準,任何會寫程式的 agent 都能用,也自然延伸出「context 管理可以被指令引導、被演化、被訓練」這幾條路。但它是設計選擇,不是新演算法,是否優於「固定流程加好的 prompt」,論文沒有直接證明。
貢獻之二:success-gated 效率 advantage(Eq. 6)。 只在答對的軌跡之間依理論成本加減分,解決了「結果獎勵分不出編輯好壞、直接獎勵編輯量又會被鑽漏洞」的問題。它只能算「小」貢獻,理由有三個:權重只有 0.25;對應的做法在別的領域早有類似設計(附錄 A 提到只在答對的回答上罰長度的 Arora & Zanette,以及 DDCA),差別只是這篇用 FLOPs 當成本;而且這一項怎麼分給 token,論文沒講清楚。
還有一個窄但可信的實證結論(32K 緊預算下的零樣本結果),但這類數字會隨模型與基準換代而過期,能長期留下的是前兩項,以及下面這些脫離論文也成立的觀念。
適用條件的判斷在前面「什麼條件下划算」一節;除此之外,最通用的觀念有三個:編輯 context 的成本由位置決定;次要目標只能在達標的集合內比較;用來挑選的資料不能拿來報成績。這三個在換掉模型、換掉基準之後依然成立,文末的延伸章節各有一節。
- 下次看到一套 context 管理方法,先問兩個問題:誰決定何時做?操作是誰寫的?CLM 是兩個都答「模型」的那一類,代價是要有 harness 在旁邊提醒。
- 讀論文數字時先換回絕對值:「高 11.4%」約是 6 點,「提升 47.6%」是 13.7 點;在 EdgeBench 上,預算放寬到 128K 時準確率優勢就沒了。
- 自己做 agent 時:改 context 盡量改在後面(論文附錄的例子裡,改開頭的成本是只追加的 7.7 倍);效率只在成功的嘗試之間比;挑 prompt 用的分數別拿來報成績。
11 延伸:脫離這篇論文也成立的四個觀念
以下四節是選讀:每一節都能獨立讀、不需要回頭看論文,內容收合起來,想深入再展開。
11.1 一塊 context 該留、壓、存檔,還是刪
context 滿了,面前有一堆內容,到底該對哪一塊做什麼?「何時做」與「怎麼做」之外,還需要一張「這塊內容該用哪種操作」的對照:
| 這塊內容的特性 | 該做什麼 | 為什麼 | ContextBench 的對應 |
|---|---|---|---|
| 之後要逐字用到,而且不大 | 留在 context | 任何改寫都可能失真 | Needle Retention |
| 之後要逐字用到,但很大 | 存到檔案,context 只留指標,要用時再 grep | 摘要有損,存檔無損 | KV Store、Log Triage |
| 只需要大意 | 壓成摘要 | 省空間,失真可以接受 | 無 |
| 已經沒用 | 直接刪 | 留著只佔空間 | Needle 的雜訊區塊 |
| 結構固定、常常只改一小處 | 原地編輯 | 重寫整份又貴又容易抄錯 | Sudoku Sketchpad |
判斷順序寫成虛擬碼如下:先問「之後還要不要原文」,再問「多大」,最後問「會不會一直小改」。
# 推論:整合論文三個失敗原因與 ContextBench 四個任務得出的判斷順序(非論文原文)
def decide(chunk):
    if chunk.needed_verbatim_later:
        return KEEP if chunk.small else OFFLOAD_TO_FILE   # 存檔後,context 只留指標
    if chunk.structured and chunk.edited_in_small_pieces:
        return EDIT_IN_PLACE                              # 例如棋盤、狀態表
    if chunk.only_gist_needed:
        return SUMMARIZE
    return DELETE
依據是論文歸納的三個失敗原因(摘要會遺漏或編造、沒有原地編輯就得重寫整盤、只能存檔卻不能從 live context 踢掉)。整理成決策表是我的整合,推論,非論文原文。這張表也能用來檢查任何一套 harness 缺了哪一格:只有摘要的 harness,缺的是「存檔」和「原地編輯」。
11.2 編輯成本由位置決定
原理(一般知識):每個 token 的 KV 快取取決於它前面所有 token,所以伺服器只能沿用「開頭完全相同」的那一段,第一個不同的 token 之後全部重算。所以粗略的成本,就是每個 token 的處理成本乘上「要重算的加上要生成的 token 數」。令 為需要重算的 token 數, 為生成的 token 數, 為每個 token 的處理成本:
實際數字見前面的圖 5:改開頭的成本是只追加的 7.7 倍。直覺例子(自編例子,假設成本與重算 token 數成正比):同樣是改 20,000 tokens 的 context 裡的一處。改在 18,000 個 token 的位置附近,只需重算約 2,000 個;改在 2,000 個 token 的位置附近,要重算約 18,000 個,差 9 倍。
可遷移的設計規則(推論,由上面的算式推出):context 由前到後,依變動頻率排列,穩定的放前面(system prompt、長期有效的筆記),較少變動的居中(已定案的摘要),常變動的放最後(最近幾輪)。
- 要壓縮就集中做一次,別在中間反覆小改。
- 同樣是刪 8,000 tokens,刪在尾端和刪在開頭,成本差好幾倍。
這個規則對任何會改歷史的 harness 都成立,不限於 CLM;成本是理論 FLOPs,限制見前面「編輯 context 的成本」一章。
11.3 次要目標只能在達標的集合內比較
想同時優化「答對」和「便宜」時,如果對所有軌跡都獎勵便宜,最便宜的做法是什麼都不做、直接放棄,這就是 reward hacking。做法是先分對錯,再只在答對的軌跡之間比成本。用四條軌跡舉例(自編例子),成本分別是 2.0(對)、1.0(對)、0.5(錯)、3.0(對):
| 做法 | 錯的那條(成本 0.5)拿到什麼 |
|---|---|
| 對全部比成本,平均成本 1.625 | ,失敗反而被獎勵 |
| 只在答對的軌跡內比 | 0,不參與 |
correct = [t for t in group if t.success]
if len(correct) < 2:
    eff = {t: 0 for t in group}                 # 沒得比
else:
    mean_c = mean(t.cost for t in correct)
    eff = {t: clip((mean_c - t.cost) / mean_c, -1, 1) if t.success else 0 for t in group}
A = A_out + w_eff * eff                         # 論文 w_eff = 0.25
可遷移的規則(一般知識加我的推論):
- 任何「主目標加次要目標」的優化,次要目標都要設門檻或排序,不能直接加總。例如準確率加延遲、品質加成本。
- 同類做法不是這篇獨有:附錄 A 提到 Arora & Zanette 只對答對的回答罰長度,DDCA 也在答對子集內算長度 advantage。
- 副作用(推論):答對的軌跡少於 2 條時,這項整個歸零。題目很難、成功率低時,效率訊號幾乎不存在。
11.4 用來挑選的資料,不能用來報成績
在 dev(開發集)上試很多候選,再報最高的那個,分數會系統性偏高,因為挑的是「在這批題目上最幸運的」。量測本身有雜訊,標準誤(SE)衡量這個雜訊有多大,大約是真實準確率乘上錯誤率、除以題數,再開根號:
其中 是真實準確率, 是題數。自編例子:100 份候選的真實水準都是 70%,,SE 約 4.5 個百分點。100 份裡的最高分,期望值約高出 2.5 個 SE,也就是 dev 上看起來約 81%,但真實仍是 70%。這個現象叫 selection effect(也稱贏家的詛咒)。
論文的實例在 skill 演化那一節:KV Store(assisted 設定)dev 上從 22.3% 升到 83.8%(+61.5 點),定案後在沒參與挑選的 test 上只有 38.3% 到 74.2%(+35.9 點)。
可遷移的規則:
- 嘗試的候選越多,dev 數字越膨脹。要報成績就用沒參與挑選的 test。
- 看到任何「取最好的一次」的數字都要打折,例如 best-of-three(EdgeBench 就是)。
- 任何自動優化 prompt、skill、超參數的迴圈都適用,不限於這篇論文。
12 概念詳解:最值得回頭查的五件事
以下五節是選讀,也是最容易忘、最值得回頭查的部分。每一節都寫成脫離這篇論文也成立的形式,內容收合起來,可以單獨展開。
12.1 when 與 how:context 管理的兩個維度
要看懂一套 context 管理方法「到底把多少自由度給了模型」,最好用的座標系是把問題拆成兩個獨立的維度:
- when(何時做):什麼時候觸發管理動作?由人(harness 的固定規則,例如用到預算的 75%、每一輪)決定,還是由模型自己決定?
- how(如何做):管理動作本身怎麼做?由人預先寫好(固定的摘要程序),由人定義一份操作選單讓模型挑,還是由模型自己寫出操作?
how 其實分兩層:(a) 模型能不能在選單裡挑操作;(b) 操作的內容是誰寫的。action-based 方法在 (a) 有自主權,在 (b) 沒有:選單裡每個操作的實作是人寫死的。CLM 兩層都交給模型。
下表把各方法放進這個座標系,附出處。越往「when 與 how 都由模型決定」靠,模型的自主權越大。
| 方法 | when | how | 出處 |
|---|---|---|---|
| Codex 風格摘要(OpenAI Codex CLI) | 人:用到預算約 75% 時 | 人:固定的摘要 prompt | GitHub openai/codex(軟體專案,無 arXiv) |
| Cursor Composer 的 self-summarization | 人:到預定長度就觸發 | 人定流程;RL 只訓練「摘要寫得好不好」 | 技術報告 arXiv 2603.24477;部落格 cursor.com/blog/self-summarization |
| MEM1 | 人:每一輪都重寫 | 人:固定的「整合新舊資訊」流程 | arXiv 2506.15841 |
| Self-Compact | 模型:自己決定何時壓縮(附一份判斷準則) | 人:固定的壓縮工具 | arXiv 2606.23525 |
| AutoCompact | 模型:自己決定何時壓縮 | 人:固定的壓縮程序 | 無 arXiv;論文引用的是專案頁 autocompact.github.io,我沒能核對 |
| Context-as-a-Tool(CaT) | 模型:把壓縮當成可呼叫的工具 | 人:預先定義好的壓縮動作與結構化 context 工作區 | arXiv 2512.22087 |
| ACM(Agentic Context Management) | 模型 | 模型只能從人定義的選單挑(壓縮、卸載、檢索),每個操作的實作固定 | arXiv 2607.23809 |
| Sculptor | 模型 | 模型只能從人定義的選單挑(切片、摘要/隱藏/還原、搜尋),實作固定 | arXiv 2508.04664 |
| Context Folding、AgentFold | 模型:決定何時分支或折疊 | 模型從人定義的折疊動作中挑 | arXiv 2510.11967、arXiv 2510.24699(編號取自 CLM 論文的參考文獻) |
| CLM(本文) | 模型(實作上靠 harness 在剩 2,048 tokens 時提醒) | 模型:寫任意 Bash 或程式 | arXiv 2609.37725 |
看到一套新方法,問兩個問題就夠了:「誰決定何時觸發」與「操作的內容誰寫」。兩個都答「人」的是 harness 定義;第一個答「模型」、第二個答「人」的是 action-based;兩個都答「模型」的才是 CLM 這一類。一個但書:CLM 的 when 並非完全由模型決定,實驗中靠 harness 在剩 2,048 tokens 時提醒。
相關但不在這個座標系裡的做法:RLM(Recursive Language Models,arXiv 2512.24601)把長輸入當成 REPL 變數,讓模型按需讀取,解的是「何時、讀什麼進 context」,但讀進來的內容仍然接在 live context 後面、不斷變長;CLM 解的是「live context 本身怎麼被編輯」。兩者互補。MemGPT(arXiv 2310.08560)讓模型編輯 context 中一個固定大小的指定區塊,而不是整份 context。
12.2 context 檔案像原始碼:改壞標記的風險
CLM 讓模型直接改的不是「對話」,而是對話的原始文字,裡面帶有格式標記。論文對這個機制交代得太少,我們看不出它怎麼運作;而且模型改錯標記會發生什麼,論文也沒說。這兩件事是同一個疑慮的兩面。
可以把它想成 HTML:你在聊天視窗看到的對話,像渲染後的網頁;context 檔案,像網頁的 HTML 原始碼。CLM 讓模型直接改原始碼,好處是想改哪裡就改哪裡,不需要別人提供「刪除」按鈕。風險是原始碼裡有標記(像 HTML 的標籤),標記被改壞,渲染就可能出錯。
這裡的標記就是圖 3 看得到的 [[CTX_TURN 4 role=notes]] 這類字串。我的推論(非論文原文)是:它的作用是告訴 server「這一段是第幾輪、誰說的」。已知的事實只有兩個:圖 3 顯示檔案裡有這類標記;論文 Appendix E 給了 context 檔案的路徑 /tmp/.live_ctx/LIVE_CTX_MAIN.txt。
具體例子(自編例子,沿用核心機制那一章的程式):那段正規表達式以 CTX_TURN 5 這個標記當結尾,只刪到 TURN 5 的標記之前。假設模型把結尾寫成 CTX_TURN 6,連 TURN 5 開頭的標記也會被刪掉,TURN 5 的內容就併進上一段,server 看到的不再是原本的對話結構。
論文沒說的事有三件:
- 主文沒有交代怎麼偵測檔案被改、怎麼把檔案轉回模型的對話訊息格式。
- 改壞時有沒有檢查或修復機制?沒寫。Appendix E 只提到請求超出預算時,harness 會退回上一輪並重試(BCP 最多六次),那是預算問題,不是格式問題。
- 實驗中發生過幾次?沒有統計。
這個疑慮的份量(推論):它不推翻論文的結論。成績不錯,代表多數時候沒壞。但它影響兩件事:想自己複製這個機制時缺資訊,而且失敗率可能被低估。它和前面談的安全風險也不是同一件事:安全問題是惡意指令跨輪持續存在,這裡談的是格式損壞。
12.3 credit assignment:總分怎麼分給每個 step
先說答案:論文明講的部分,是把結果 advantage 直接分給軌跡底下每一次模型呼叫;效率那一項到底有沒有一起分、怎麼分,論文沒講清楚。
credit assignment 是 RL 的核心問題:一條軌跡有很多步,最後只得到一個分數,要怎麼決定每一步該分到多少功勞或責任?論文明確寫的(Section 4.2)是:只有結果 advantage 的時候,把每條軌跡的 advantage 分給它底下所有 segment(每個 segment 就是一次模型呼叫),所以每次呼叫都用整條軌跡的結果來訓練。這是最粗的做法,沒有任何「這一步貢獻多少」的判斷,整條軌跡共用同一個數字。
沒講清楚的是效率項怎麼分。Eq. 6 之後只寫了 ,沒有寫這個合計值怎麼分給 segment。論文 Appendix E 又說效率 advantage 是套用在「context 管理相關的 token」上。拿 RL 章的 (自編例子:、),假設它有 3 個 segment,兩種讀法的結果是:
| 讀法 | 每個 segment 拿到的值 |
|---|---|
| 一:合計值直接分給所有 segment | 3 個都是約 +0.70 |
| 二:結果項分給所有 segment,效率項只給編輯 context 的 token | 3 個都有 +0.58,另外只有編輯 token 多 +0.125 |
兩種讀法各自在訓練什麼(推論,非論文原文):一條軌跡的 token 大致有兩類,一般 token(搜尋關鍵字、推理、最後答案)與編輯 token(改寫 context 檔案的 Bash 或 Python)。
| 比較項目 | 讀法一 | 讀法二 |
|---|---|---|
| 效率訊號落在 | 整條軌跡的所有 token | 只有編輯 token |
| 能不能歸因到「編輯變好」 | 不能:模型分不出便宜是因為編輯得好,還是少搜了幾輪 | 比較能 |
| 可能的副作用 | 模型可能靠「少做事、早收工」降成本,而不是學會更好的 context 管理 | 較小;模型被推向「編輯得更省」,例如少改很前面的內容(會讓快取失效) |
另外,論文 Appendix E 還提到對 CLM 加了「工具呼叫失敗」和「格式錯誤」的懲罰,也沒說是加在整條軌跡還是個別 token 上。
這影響你怎麼讀 RL 結果:論文說加了效率獎勵後,成本進一步下降而準確率沒有明顯損失(論文 Appendix F)。在讀法一之下,這個成本下降未必來自更好的 context 管理。論文文字無法判定是哪一種;要看論文公開的程式碼(GitHub facebookresearch/context-language-models)才能確定,我沒有讀過那份程式碼。
12.4 論文實際使用的三段引導指令
出處是論文 Appendix E 的「In-context steering」段落。以下是意思的中譯,原文請直接對照該段。這些指令附加在任務訊息之後,與「無指令對照組」在同一批 BrowseComp-Plus 問題上比較,模型是 Claude 4.6 Sonnet(透過 API)。
指令一:壓縮時機( 為 16,000/24,000/32,000)
監控你的 context 大小:每個工具結果都會回報目前大小。只要超過 tokens,就立刻把 context 壓縮到約 4000 tokens。例如:改寫
/tmp/.live_ctx/LIVE_CTX_MAIN.txt,只保留關鍵發現與目前計畫(約 4000 tokens)。
設定:48,000 tokens 預算、200 輪上限,30 道較長的題目(輪數在無指令時達到第 60 百分位以上)。
指令二:子任務邊界壓縮
請只在子任務的邊界壓縮。子任務一完成,就把該子任務的 context 全部丟掉。例如:寫完
/workspace/answer_1.txt之後,改寫/tmp/.live_ctx/LIVE_CTX_MAIN.txt,丟掉問題 1 的材料,只保留 answer_1 的結論。
設定:四個問題串在同一個 session,24,000 tokens 預算、1,000 輪上限,每個條件 189 個 session,其中 131 個在 session 內含有子任務邊界。
指令三:備份
每次編輯 context 之前,必須先把目前的 context 檔案備份到名為
compaction_backup的新資料夾裡的新檔案;絕不覆寫或刪除先前的備份。
設定:16,000 tokens 預算,200 道題,其中 91 道配對分析。
要注意兩點:
- 指令一說「每個工具結果都會回報目前大小」,這和前面提到的 harness 環境提示是同一件事。也就是說,這個實驗裡模型知道自己用了多少,是 harness 把大小餵給它的,不是模型自己感知的。推論:指令一的成功有一部分要歸功於這個提示。
- 指令一和二都直接寫出了 context 檔案的路徑,並且附上具體做法的範例。所以這些指令比「一句話」更具體,是帶範例的操作說明。
結果見圖 6,數字摘要在「一句話就能改變管理行為」那一節。
12.5 零樣本、skill 演化、RL:三組互不重疊的證據
先說答案:論文的主要實驗(BCP、TB2.1、TBLite、EdgeBench-10、Software World、數學優化)裡的 CLM 都是零樣本:沒有 RL 訓練,也沒有 skill 演化。RL 與 skill 演化只出現在兩個地方,而且不在同一組任務上。
| 實驗 | 有 RL 訓練嗎 | 有 skill 演化嗎 | 依據 |
|---|---|---|---|
| BCP、TB2.1、TBLite 零樣本對照 | 沒有 | 沒有 | 論文 5.1.1 說所有方法都是開箱即用、不訓練,目的是讓比較與訓練資料無關 |
| EdgeBench-10、Software World、數學優化 | 沒有 | 沒有 | 論文把這組歸在 5.1「Zero-Shot」之下,模型是現成的 |
| ContextBench 上的 skill 演化 | 沒有 | 有 | Qwen3.6-27B 或 Opus 5,合成任務,32K 預算 |
| BCP 上 Qwen3.5-9B 的 RL | 有 | 沒有 | 9B 模型,OpenResearcher 訓練資料 |
零樣本的 CLM 靠兩樣東西做 context 管理:現成模型自己的判斷(context-as-a-file 機制),以及 harness 提供的輔助(剩 2,048 tokens 的編輯提醒、BCP 上請求超出預算時退回重試)。BCP 的搜尋工具是以「in-context skills」的形式提供的(論文 5.1.1 腳註 2),那是工具說明,不是演化出來的 context 管理 skill,別混在一起。論文沒有給出零樣本實驗中 CLM 的 system prompt 具體寫了什麼。推論:ContextBench 的 CLM 有一份 skill(論文 Appendix D 與論文 Table 4 有摘錄),零樣本實驗應該有類似的基本說明,否則模型不知道 context 檔案的路徑。
所以論文的證據結構是三層:
- 27B 現成模型零樣本勝過對手(主證據)。
- 小模型加 RL,追平對手(輔助)。
- ContextBench 上 skill 演化有效(輔助,而且是合成任務)。
「變更好」要分開看:
- skill 演化:KV Store 上 test 準確率從 38.3% 升到 74.2%。但起點是「完全沒有管理指令」,所以證明的是「有 skill 比沒 skill 好」,不是「演化出的 skill 比人手寫的好」。
- RL:9B 從 28.8% 升到 42.5%,但 Summary 對照組也同樣被訓練變強(34.7% 到 42.1%)。所以證明的是「CLM 可以被訓練」,不是「CLM 比對手更吃訓練的紅利」;訓練後只是追平,差別在成本,而且兩邊的獎勵設計不同。
- 兩者都沒有在長時間任務上驗證:「訓練或演化後的 CLM,在 EdgeBench 這類任務上更強」,論文沒有這組實驗。
結論是:RL 與 skill 演化說的是「可學習性」,不是「更強」。把「CLM 勝過現有最強方法」(27B 零樣本)和「CLM 可被訓練變強」(9B 加 RL,或 ContextBench 上 skill 演化)當成同一組證據,是會被誤導的。