AI Agent 搜文件庫,需要先畫好地圖嗎?拆解 CorpusMap
 Hong-Wei Wu
收錄於 論文介紹
1 前言
讓 agent 在大型文件庫裡用 find、grep 找答案,是現在很常見的做法。問題是文件庫只是一堆平放的檔案,agent 就算找到一份相關文件,也得不到「它跟其他哪些文件有關」的任何線索,每一題都得從頭摸索一遍。
CorpusMap(論文 Follow the Entities: A Corpus Map for Agentic Search,KAIST 與 Microsoft,arXiv 2609.37226)的做法,是離線把文件之間「誰跟誰有關」先算好:把反覆出現的人、專案、事件解析成實體,每個實體寫成一頁 Entity Page,再連到所有提到它的文件。查詢時 agent 沿著這些連結跳,不必每題重新發現同樣的關係。這篇文章依序講問題、方法、實驗,最後收進幾個值得獨立帶走的概念。
- 問題:關鍵文件常常字面搜不到(例如會議記錄只寫專案內部代號),而且同樣的摸索每題重做一次。
- 做法:離線把文件中反覆出現的實體解析出來,每個實體做成一頁 Entity Page(事實逐條標出處),連到所有提到它的文件,形成「實體—文件」二部圖。查詢時 agent 用與原始文件相同的 shell 指令讀頁面、沿連結跳,系統另外附一份由關鍵字排名公式 BM25 挑出的候選文件路徑清單當起點。
- 結果(3 個基準、397 題、四個 GPT 模型):整體品質比 Raw Corpus(不加任何導航層,直接搜原始文件)高 6.4 到 11.7 分,輸入 token 少 34% 到 57%。其他四種導航層沒有穩定贏過 Raw Corpus。增益集中在「找得到證據」:EnterpriseRAG-Bench 與 WixQA 明顯,HERB 很小。
- 工程價值:全部離線建、可增量更新、可用便宜模型建一次再給貴模型用,其中抽取、解析、渲染三階段也可以換成現成工具而不用 LLM。
- 限制:實驗文件庫只有約 2.8k 到 6.4k 份(最大放大到約 2 萬份),多數延伸實驗只在 EnterpriseRAG-Bench 上做。
- 可帶走的概念:multi-document 與 multi-hop 是兩種不同的問題,二部圖用「共同鄰居」表達同類節點之間的關係。
2 問題與挑戰
論文鎖定的任務是 multi-document 問答:答案要合併至少兩份文件的證據。它列出兩個挑戰:
- 關鍵文件與問題之間,隔著只有這間公司才知道的關係。例如會議記錄只用專案內部代號,光靠問題的字面搜不到。
- 每題獨立處理,agent 要重複花 token 重新發現同樣的關係。但「哪幾份文件講的是同一個專案」這類關係與問什麼問題無關,是穩定的,可以事先算好重用。
所以論文把問題重新定義成 corpus navigation(語料庫導航):保留對完整語料的存取,再加一層持久的導航層,把跨文件的結構事先攤開。
2.1 導航層該放哪一種關係
導航層可以放的關係很多,論文給了兩個條件。
- 能帶你到「用問題字面搜不到」的文件。
- 不用知道使用者會問什麼,就能事先編好。
這其實就是書末索引該有的兩個性質。自編一個類比:想在一本厚書裡找「J. Chen」相關的所有內容。逐頁翻(對應平放的文件庫)每次都從第一頁開始,而且只翻得到字面寫著 “J. Chen” 的頁。書末索引則直接寫「J. Chen → 第 12、47、203 頁」。
索引條目指的是「這個人」,不是「這個字串」。就算第 203 頁寫的是「陳經理的基礎設施審查」,只要編索引時認定是同一個人,你也翻得到,這是條件一。索引在書出版前就編完了,與讀者之後問什麼無關,編一次所有讀者都能用,這是條件二。
反例可以看出兩個條件缺一不可(自編):
| 如果導航層是…… | 哪個條件不成立 |
|---|---|
| 全文關鍵字搜尋 | 條件一:還是只能找到字面有出現的 |
| 針對這一題寫的摘要 | 條件二:要看到題目才寫得出來,下一題就要重寫 |
| 實體索引 | 兩個都成立,所以論文選它 |
【推論】【背景知識】底層原理是把查詢時的工作搬到離線事先算好(precompute),與資料庫的 index、搜尋引擎的倒排索引是同一種思路。CorpusMap 特別的地方,是索引的單位換成「解析過的實體」,而不是詞。論文自己的理由是:文件本來就是圍繞人、專案、產品這類實體寫出來的,而且實體只看語料本身就能辨識,所以整層可以離線建好。
3 方法
方法的核心,是離線建一張「實體—文件」二部圖,並把每個實體寫成一頁 Entity Page,查詢時讓 agent 沿連結走。以下依序說明:地圖長什麼樣、離線怎麼建、查詢時怎麼用,最後交代為什麼地圖裡刻意沒有實體與實體之間的邊。
3.1 地圖的結構
地圖是一張二部圖:一邊是實體,一邊是文件,連線只出現在實體與文件之間。二部圖這個概念本身,留到文末「值得帶走的概念」再展開。形式上的定義如下:
- :文件集合。
- :保留下來的實體集合。只保留連到至少兩份文件的實體,因為只出現在一份文件的實體串不起任何路徑。
- :實體 的文件鄰域,也就是離線解析後被認定提到 的那些文件。
- :所有「實體—文件」連線的集合,每條線一端是實體、一端是文件。
- :這張二部圖本身。兩份文件若共用一個實體,就透過它相連,一份文件也可以同時屬於好幾個實體的鄰域。
沒有連到任何保留實體的文件仍留在 裡,靠一般的關鍵字搜尋找得到。
用圖 1 的內容走一遍。
| 實體 | 文件鄰域 |
|---|---|
| Project Atlas | Oct 28 Email、Q3 Status Report、Acme MSA |
| J. Chen | Q3 Status Report、Nov 6 Standup |
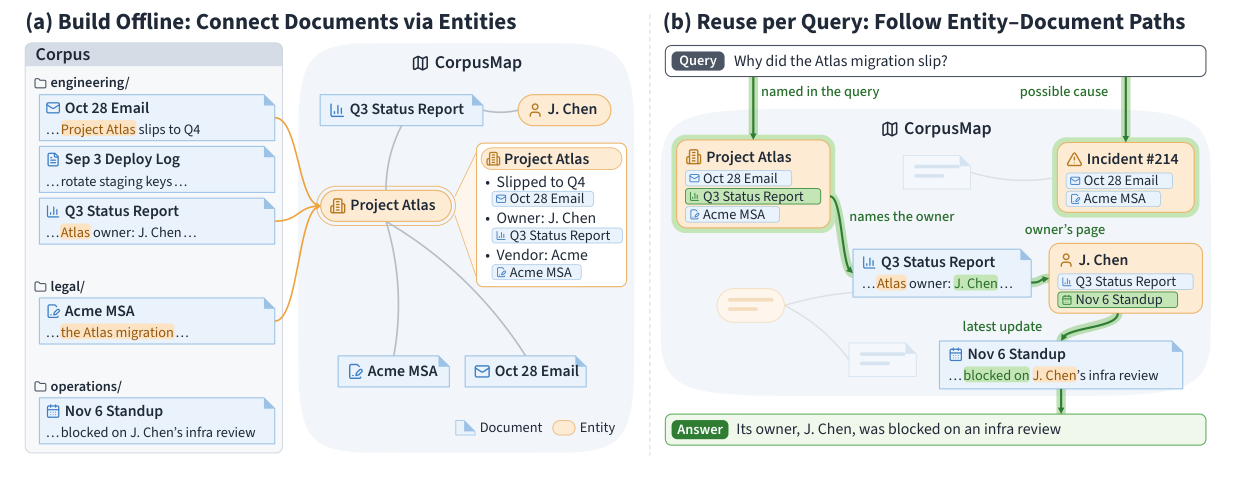
Q3 Status Report 同時屬於兩個鄰域,它就是橋:Atlas → Status Report → J. Chen → Nov 6 Standup。agent 的走法是這樣:
- 問題提到 Atlas,先打開 Project Atlas 頁。
- 從頁面進到 Status Report,讀到「Atlas owner: J. Chen」。
- Status Report 同時連到 J. Chen,跳到 J. Chen 頁。
- J. Chen 頁列出 Nov 6 Standup,裡面寫著「blocked on J. Chen’s infra review」,答案到手。
Nov 6 Standup 的內文沒有出現 “Atlas”,所以 grep Atlas 永遠找不到它,靠 Status Report 這座橋才接得上。
3.1.1 Entity Page:實體在 agent 眼中的樣子
Entity Page 是一頁 markdown,把所有提到這個實體的文件裡的事實濃縮在一起,每一條都標明出自哪份文件。一頁包含四樣東西:
| 內容 | 作用 |
|---|---|
| Overview | 2 到 3 句話,說明這個實體在文件裡出現在哪些情境 |
| Key facts | 一條一條的事實,每條標註來源文件 |
| 出現過的名稱 | 同一實體在不同文件的寫法(別名) |
| 連到的所有文件 | 的檔案路徑 |
用圖 1 的 Atlas 內容排成頁面如下(排版是示意。實際格式中,每條 Key facts 結尾以 [dsid x] 標示來源文件編號,文件連結由程式附加在頁面最後):
## Overview
Project Atlas 在 email、狀態報告與合約中被提及……

## Key facts
- Slipped to Q4 [Oct 28 Email]
- Owner: J. Chen [Q3 Status Report]
- Vendor: Acme [Acme MSA]

名稱:Project Atlas / Atlas
文件:Oct 28 Email、Q3 Status Report、Acme MSA
三個設計重點:
- 一頁把原本分散在不同資料夾的證據併在一起(論文稱 complementary evidence)。
- 每條事實帶出處,agent 不必信任摘要,可以回原文核對。
- 頁面是疊在語料上的一層,不取代原文件。摘要是有損的,所以原文件永遠還在。
論文對「寫頁面」也設了限制(對應渲染階段的 prompt):只能用原文件明講的資訊。不可以只因為某實體被連到某份文件,就推出別名、關係、負責人或動作。登記簿欄位與抽取證據只算導航資料,不算事實證據。原文件當資料處理,文件裡若夾帶指令一律忽略。
3.2 離線建構四階段
建構流程分四個階段,由前到後:
[1] 編目 -> [2] 抽取 -> [3] 解析 -> [4] 渲染 -> 二部圖 G 與 Entity Page3.2.1 階段 1:編目(Cataloging)
編目先決定「這個語料庫裡有哪幾種實體」,產出一份固定的類型目錄 ,供後面的階段使用。每種類型有名稱、定義、辨識標準(identity criteria)、文中觀察到的例子。
為什麼不事先寫死?因為實體類型因語料而異,產品、事件、設定旗標都可能是,無法事先窮舉,所以用 LLM 從語料自己歸納。做法是從幾組小規模抽樣文件各提一份候選目錄,合併成一份,再驗證並修正。之後目錄固定、不再更動,全語料只做一次。
論文給 LLM 的 prompt 有三條關鍵限制:
- 只收有穩定名稱或編號的東西,不收「某某狀態」這類陳述。
- 類型是「辨識方式」的分類,不是主題分類,同一類型的實體必須能用同一種證據辨認、區分、正規化。
- 每個例子必須是來源裡逐字出現過的字串。
論文沒有說明:抽樣幾組、每組幾份、怎麼抽樣、驗證修正跑幾輪。
具體例子:假設公司有 10 萬份文件。 以下流程骨架來自論文,所有數字與文件內容都是自編。這 10 萬份文件來自 Slack、Confluence、Jira、Gmail、Drive。
- 抽樣。 抽 5 組,每組約 40 份,每組都混入各個來源(論文的 prompt 說輸入文件取自多個來源類型,並依來源分組,抽樣方式是自編)。5 組共 200 份,只佔 0.2%。
- 每組各提一份候選目錄。 每組各丟給 LLM 一次,要求輸出類型名稱、定義、辨識標準、文中觀察到的實體字串。
- 合併。 把各組目錄合成一份。
- 驗證。 另一個 LLM 扮演對抗式驗證者,專門找反例。
- 修正。 只針對被點名的缺陷修改,得到最終目錄,假設有 8 種類型。目錄在此固定,後面的抽取階段拿這 8 種類型去處理全部 10 萬份文件。
第 2 步各組提出的類型長這樣(自編):
| 組別 | 提出的類型 |
|---|---|
| A 組 | Project(Atlas)、Person(J. Chen)、Jira ticket(RRB-17) |
| B 組 | Initiative(Atlas)、Customer(Acme)、Incident(INC-2147),另有一個被誤收的例子 “latency is high” |
| C 組 | Project(Redwood)、Config flag(installer-rollback-lock),以及一個把產品(Redwood Private)與工單(RRB-17)混在一起的類型 |
合併時,A 的 Project 與 B 的 Initiative 指同一種東西,併成 Project。C 的某個類型把產品與工單混在一起,辨認方式不同,要拆開。
【推論】編目只看 200 份抽樣,成本與語料大小幾乎無關。真正隨文件數線性增長的,是後面對每份文件跑的抽取與解析。論文沒有分階段的成本數字。
3.2.1.1 補充:抽樣文件很多,context 吃得下嗎
編目的第一步,是把一整組抽樣文件一次丟給 LLM。這有風險,尤其是長文件,而論文沒有處理這件事。自編的 token 估算如下(假設每組 40 份):
| 每份文件平均長度 | 40 份合計 |
|---|---|
| 1k tokens(Slack 訊息、短 email) | 約 40k |
| 3k tokens(一般 Confluence 頁面) | 約 120k |
| 10k tokens(會議逐字稿、長規格書) | 約 400k |
短文件沒問題。長文件的組別可能塞不進視窗,就算塞得進,長上下文裡的細節也容易被忽略。論文只說「幾組小規模抽樣文件」,沒有寫每組幾份、有沒有截斷長文件,也沒有實驗驗證這個敏感度。
【推論】設計上仍相對耐受,有兩個原因。第一,編目的目標是「找出常見的實體類型」,不是「讀懂每份文件」,某份文件被忽略,同類型通常還會在其他文件、其他組出現。第二,只有提案階段要吃文件,後面的合併、驗證、修正吃的都是目錄 JSON,很小。另外,如果一組太大,最直接的調法是把每組縮到 10 到 15 份、組數增加,或截斷每份文件的前段。代價是候選目錄變多,合併步驟的工作量變大,但合併處理的是小 JSON,成本低。調小每組份量是最自然的槓桿。
3.2.1.2 補充:合併、驗證、修正怎麼運作
這三步都是各自一次 LLM call,輸入與輸出都是 JSON 目錄,不再讀原文件,所以成本很小。
| 步驟 | 輸入 | LLM 做什麼 | 輸出 |
|---|---|---|---|
| 合併 | 所有候選目錄(每個類型有編號) | 每個來源類型必須表態:對應到一個最終類型、拆成多個、或否決 | 最終目錄,加上「每個來源類型去了哪」的對照表 |
| 驗證 | 原始候選、合併草稿 | 另一個 LLM 扮演對抗式驗證者,只找缺陷與反例,不改寫 | 缺陷清單,沒有缺陷才判定通過 |
| 修正 | 草稿、缺陷清單 | 只修被點名的缺陷,其餘不動 | 完整的修正版目錄 |
合併時,每個來源類型依固定順序處理,前一步行不通才走下一步:
[1] 剔除個別不合格的實例 -> [2] 縮小過寬的類型 -> [3] 拆開混雜的類型 -> [4] 併入已有的最終類型 -> [5] 否決否決是最後手段,要留一份紀錄(論文稱 tombstone),寫明縮、拆、併為什麼都行不通。每個來源類型必須剛好交代一次:mapped(對應到一個最終類型)、split(拆成兩個以上)、rejected(不對應任何最終類型)。另一條硬限制是,每個最終類型的例子必須逐字出自來源目錄,不許 LLM 編造。
驗證者看七類問題:否決理由站不站得住、兩個類型是否收了同一個東西(要附反例字串)、粒度不一致、標準自相矛盾、同類實例無法用同一種證據辨認、例子不屬於該類型、憑空多出的類型。任何一類有缺陷,判定就是不通過。修正只動被點名的部分,重疊問題的解法是合併,或補上執行時看得見的區別標準。
沿用上面的例子走一遍(自編):
- 合併:A 的 Project 與 B 的 Initiative 都是 Atlas 這類東西,併成 Project。C 的某個類型把產品(Redwood Private)與工單(RRB-17)混在一起,拆成 Product 與 Ticket。B 裡有一個例子是「latency is high」,這是狀態陳述不是名稱,被剔除。
- 驗證:驗證者指出「Redwood Private」同時符合 Project 與 Product,兩個類型沒有可靠區別,判定不通過。
- 修正:用兩種方式之一解決重疊:合併,或補上執行時看得見的區別標準(例如規定 Product 必須有版本號)。其餘類型原封不動。
論文沒有說明:驗證與修正是否循環多輪(只說「驗證並修正」)、修正 prompt 提到的 deterministic policy decision(用程式規則決定哪些缺陷算阻擋性)的規則,以及驗證輸出裡一種叫「軟警告」的註記。
【推論】軟警告大概是用來容許可被執行時規則消解的重疊,細節沒寫。整套流程本質上是「LLM 當產生器、另一個 LLM 當檢查器」,防的是 LLM 編造與過度合併。論文沒有拿掉驗證步驟做 ablation 來證明它必要。
3.2.2 階段 2:抽取(Extraction)
抽取是一份文件進去、一份清單出來:把文件裡的實體標出來,貼上目錄中的類型。可以想成目錄是「貼紙種類表」,抽取是拿著它替每份文件貼貼紙。它不負責判斷兩份文件裡的實體是不是同一個。
論文的 prompt 一次只吃一份文件加上固定的類型目錄,輸出兩個清單:
local entities:
  - surface forms: ["Project Atlas", "Atlas"]  type: Project
  - surface forms: ["J. Chen"]                  type: Person
unresolved entities:
- surface forms: ["Q4"] reason: 目錄中沒有適合的類型- local entities(文件內實體):每個包含原文寫法(surface forms,必須逐字出自這份文件)與類型名稱。同一份文件裡指同一個東西的不同寫法,併成一個。
- unresolved:套不進任何類型、或證據不足以選類型的,連同理由列在這裡,不強塞。
三條規則決定哪些東西能被標出來:
- 每個實體必須是一個可辨認的個體。獨立的事實、規則、建議動作、沒有名字的籠統描述(例如「那個遷移專案」),都不建立實體。
- 每個原文寫法必須逐字出自這份文件,不能是 LLM 改寫過的名稱。
- 目錄裡的「觀察到的例子」只是參考,不是已存在的實體名單。
走查(文件內容自編,句子取材自圖 1 的 Status Report):「Project Atlas 預計延到 Q4。Atlas owner: J. Chen。」
| 步驟 | 發生什麼 |
|---|---|
| 標出 | “Project Atlas”、“Atlas”、“J. Chen”、“Q4” |
| 同一份文件內歸併 | “Project Atlas” 與 “Atlas” 指同一個東西,併成一個實體,兩個原文寫法都保留 |
| 貼類型 | Atlas 貼 Project,J. Chen 貼 Person |
| 貼不上 | “Q4” 是時間,目錄裡沒有適合的類型,進 unresolved |
抽取只看單份文件:兩份文件裡的 J. Chen,此刻還是兩個互不相識的文件內實體。把它們認成同一個人,是下一階段的工作。
【推論】抽取與解析刻意拆成兩步,是因為抽取只看單份文件,可以逐份獨立處理,成本隨文件數線性增長。跨文件的認定交給下一步,對著登記簿做。論文沒有明講拆開的理由。
3.2.3 階段 3:解析(Resolution)
解析是整個方法最核心的一步:把「不同文件裡的同一個東西」認成同一個。做法是對每個文件內實體,拿去對照一份「登記簿」(registry,起始是空的),從三種決策中選一種:
| 決策 | 意思 | 結果 |
|---|---|---|
| LINK | 與登記簿裡某個實體是同一個東西 | 更新該實體,記一條實體—文件連線 |
| ADD | 登記簿裡沒有,是新的 | 新增實體,記一條連線 |
| UNRESOLVED | 證據不足,分不清 | 不記任何連線 |
走查(處理順序與文件內容自編,實體取自圖 1):
| 處理順序 | 文件內實體 | 決策 | 登記簿變成 |
|---|---|---|---|
| 1. Oct 28 Email | Project Atlas | ADD(登記簿是空的) | Atlas |
| 2. Status Report | Atlas | LINK(認出是 Atlas) | Atlas(新增一條連線) |
| 2. Status Report | J. Chen | ADD | Atlas、J. Chen |
| 3. Nov 6 Standup | J. Chen | LINK | Atlas、J. Chen(新增一條連線) |
結果是 Atlas 連到 Email 與 Status Report,J. Chen 連到 Status Report 與 Standup,正好就是前面二部圖的連線。
論文對這一步的 prompt 訂了幾條關鍵規則:
- 名稱相似或檢索排名高,都不算同一個東西的證據,要用完整的文件上下文判斷。
- 下決定前,要拿選中的候選跟「最強的競爭候選」比一次。文件上下文仍然分不出誰是誰,就回 UNRESOLVED。
- 登記簿本身不完整,不要硬配。新實體的規範名稱必須是文件內實體的某個原文寫法,既有實體的 id 必須來自候選清單。
自編例子:公司同時有 J. Chen 與 Jenny Chen,某份文件只寫 “Chen”,上下文看不出是誰。這裡寧可不連(UNRESOLVED),也不亂連。
3.2.3.1 LINK 與 ADD 的差別
兩者的差別只有一個,登記簿裡是不是已經有這個實體。LINK 是「已經有了,這份文件也提到它」,ADD 是「還沒有,這是第一次出現,建一筆新的」。
| LINK | ADD | |
|---|---|---|
| 判斷依據 | 與登記簿某個候選是同一個東西 | 登記簿裡沒有對得上的 |
| 對登記簿做什麼 | 更新既有那筆(UPDATEENTITY) | 新增一筆(ADDENTITY) |
| 實體 id 從哪來 | 必須是候選清單裡既有的 id | 新建,規範名稱必須是這個文件內實體的某個原文寫法 |
| 對連線 的影響 | 加一條 | 加一條 |
兩者都會記一條實體—文件連線,UNRESOLVED 才是不記連線的那個。這個區分決定地圖長什麼樣:只有連到至少兩份文件的實體會被保留。一個實體剛被 ADD 時只有一條連線,要等之後有別的文件 LINK 到它,才會升到兩條以上。從沒被 LINK 過的實體,最後會被丟掉。
兩種判斷錯誤的後果,加上拿不準時的預設做法如下:
- 該 LINK 卻 ADD:同一個東西變成登記簿裡的兩筆,連線被切成兩半,橋就斷了。例如 Standup 裡的 J. Chen 被當成新實體,Status Report 與 Standup 之間就沒有路徑。
- 不該 LINK 卻 LINK:兩個不同的東西被併成一筆,頁面混進不相干的事實。
- 拿不準時回 UNRESOLVED,論文的 prompt 偏向這個保守選擇。
【推論】論文沒有說明從登記簿取回候選用的是什麼檢索方式,也沒說 UPDATEENTITY 具體更新哪些欄位,應該是把新的寫法補進該實體的名稱清單。論文也沒有量化上面兩種錯誤各自有多常發生。另外,解析是依序對著一份持續成長的登記簿處理,不像抽取那樣能直接平行,處理順序可能影響結果,論文沒有分析這一點。
3.2.4 階段 4:渲染(Rendering)
渲染先篩掉只連到一份文件的實體,再請 LLM 把每個保留的實體寫成一頁。
- 篩選:只保留連到至少兩份文件的實體。自編走查:Project Atlas 連 3 份、J. Chen 連 2 份,保留。staging keys 只連 1 份,丟掉。
- 寫頁:每個保留的實體各一次 LLM call。輸入是實體名稱、類型、出現過的寫法,加上 的原文件,輸出固定兩段,Overview(2 到 3 句)與 Key facts(每條標來源)。限制規則見前面「Entity Page」一節。
- 連結:各文件的連結由程式附加在頁面最後,不是 LLM 寫的。
部署提醒(論文 Ethics Statement):一頁把分散的資訊集中,可能讓沒有權限看原文件的人,透過實體頁看到摘要。論文建議依權限等級分開建地圖,沒有做實驗驗證。
3.2.5 四個階段串起來
| 階段 | 輸入 | 做什麼 | 輸出 | 執行範圍 | 可換成現成工具 |
|---|---|---|---|---|---|
| 1 編目 | 抽樣文件 | 歸納實體類型 | 類型目錄 | 全語料只做一次 | 論文沒說可換 |
| 2 抽取 | 單份文件加 | 標出實體、貼類型、同文件內歸併 | 文件內實體,貼不上的進 unresolved | 每份文件各一次 | 可以 |
| 3 解析 | 文件內實體加登記簿 | 決定 LINK、ADD 或 UNRESOLVED | 登記簿,以及實體—文件連線 | 逐個文件內實體依序處理 | 可以 |
| 4 渲染 | 登記簿加原文件 | 篩掉只連到 1 份文件的實體,其餘由 LLM 寫頁 | Entity Page | 每個保留實體各一次 | 可以 |
階段 2 要用階段 1 編出的類型目錄 ,階段 4 要用階段 3 產出的登記簿,並回頭讀原文件。類型目錄只產生一次,登記簿則在階段 3 逐個處理時一路增長:前者是固定的輸入,後者是會變動的狀態。
這幾個詞很容易搞混,整理成對照:
| 詞 A | 詞 B | 差別 |
|---|---|---|
| 類型目錄 | 登記簿 | 目錄是「有哪幾種」,編完固定不變。登記簿是「實際有哪些」,隨解析增長 |
| 文件內實體 | 實體 | 前者是單份文件裡的暫時產物,後者是登記簿裡跨文件的正式一筆 |
| 連線 | Entity Page | 連線在解析時產生,是結構。頁面在渲染時產生,是內容 |
| UNRESOLVED | 被篩掉的實體 | 前者是分不清所以不連,後者是連到不到 2 份文件所以不保留 |
| 抽取階段的 unresolved 清單 | 解析階段的 UNRESOLVED 決策 | 前者裝的是貼不上類型的字串(例如 “Q4”),後者是「分不清是不是同一個實體」的決定,兩者名字像,但發生在不同階段 |
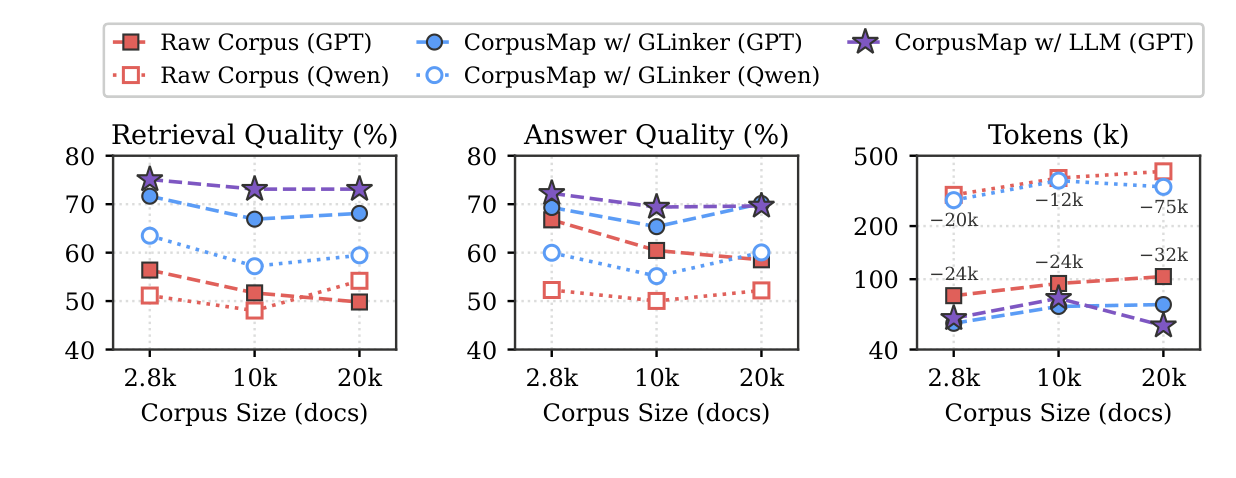
抽取、解析、渲染三階段也可以改用現成工具(GLinker 搭配開源 GLiNER 模型這類現成的實體連結與辨識工具,頁面直接由抽取證據產生,不用 LLM)。後面的語料放大實驗顯示效果與 LLM 版相近、成本更低,論文沒有說明作法細節。
3.3 查詢時怎麼用
查詢時 agent 沒有任何新工具,用與讀原始文件相同的 shell 指令讀 Entity Page。每一頁是存放在原始文件旁邊的檔案,頁面裡列著連到的文件路徑。
agent 可用的指令包括 ls、tree、find、grep、rg、cat、head、tail、sed、awk、cut、sort、uniq、wc、xargs、jq,另外可以把文件加進或移出自己的 supporting set(agent 自己挑出、認為能支持答案的文件集合)。每題有固定的執行預算,沿用 EnterpriseRAG-Bench 論文的設定。
兩種跳法交替使用,就能在二部圖上一路走下去:
| 從哪裡 | 到哪裡 | 怎麼做 |
|---|---|---|
| Entity Page | 文件 | 讀頁面裡列出的檔案路徑,打開那份文件 |
| 文件 | Entity Page | 搜尋「哪些頁面列了這份文件」,或用文件裡的詞去搜頁面,找到後打開 |
3.3.1 候選文件清單:agent 的起點
在 agent 開始之前,系統先附一份「建議先看這幾份」的清單。清單內容只有每份文件的標題(如果有)、檔案路徑、文件 ID,沒有內文。agent 可以照著讀,也可以不照,仍然能自己 grep 整個語料。預設設定的 CorpusMap 附有這份清單。
產生流程如下:
[1] 問題 -> [2] BM25 對所有 Entity Page 打分,取前幾頁 -> [3] 把這幾頁連到的文件集中起來
    -> [4] BM25 對這些文件的標題與內容重新打分,取前幾份 -> [5] 清單附在問題旁交給 agent
BM25 是經典的關鍵字排名公式,依問題裡的字在文字中出現的情況打分,只衡量字面相關,不懂語意。第 2 步比對的是頁面的名稱、類型、overview、key facts、出現過的寫法。實體頁在這裡的作用,是把關鍵字比對的範圍從「單份文件有沒有這個字」,放大成「這個實體連到的所有文件」。論文正文沒有寫預設給 agent 幾個候選頁面與文件,只在附錄的參數掃描實驗裡涵蓋 1 到 100 的範圍。
自編走查(假設只有 Atlas 頁排在最前面):
| 步驟 | 結果 |
|---|---|
| 問題 | 「Atlas 遷移為什麼延誤?」 |
| 頁面排名 | Project Atlas 頁排第一,因為名稱與 key facts 都含 Atlas |
| 集中文件 | Oct 28 Email、Acme MSA、Q3 Status Report |
| 文件重排 | 依標題與內容比對問題後排序 |
| 交給 agent | 前幾名的路徑清單,不含內文 |
這份清單裡沒有 Nov 6 Standup,因為它不在 Atlas 的鄰域。它要靠 agent 後續順著 J. Chen 跳過去才找得到。
3.3.2 agent 怎麼在地圖上走:論文的案例
論文附了一個真實的對照案例。問題是:Deterministic Playback Manifest v1 裡,簽章(signature)與完整性(integrity)欄位怎麼表示?答案散在兩份不同來源的文件:早期草稿 D1(Google Drive),以及改版後的 v1 規格 D2(Confluence)。標準答案是 v1 不嵌入簽章,完整性由可選的 integrity 欄位與 integrity ref URI 表達,早期草稿則列了嵌入式的 signature 欄位。
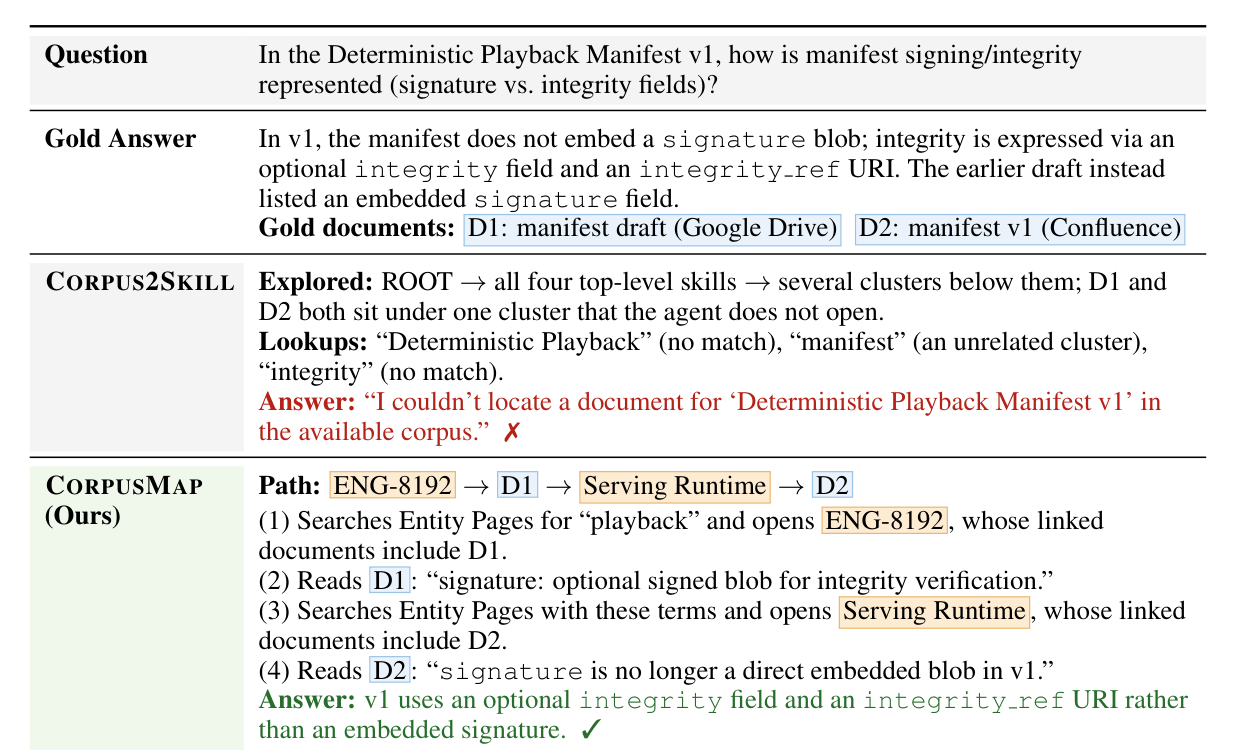
CorpusMap 的 agent 是這樣走的:
| 步驟 | CorpusMap 的 agent 做了什麼 |
|---|---|
| 1 | 搜 Entity Page 找 “playback”,打開工單頁 ENG-8192,頁面連到草稿 D1 |
| 2 | 讀 D1,看到草稿有嵌入式簽章欄位 |
| 3 | 拿 D1 的關鍵詞再搜 Entity Page,打開 Serving Runtime 頁,頁面連到 D2 |
| 4 | 讀 D2,答出 v1 改用 integrity 欄位加 integrity ref URI,不再嵌入簽章 |
對照組 Corpus2Skill(把文件分群成樹狀結構)把 D1 與 D2 放在同一個叢集底下,agent 探索了其他分支卻沒打開那個叢集,查 “Deterministic Playback”、“manifest”、“integrity” 都沒找到,最後回答找不到文件。重點是:CorpusMap 的 D1 與 D2 分別掛在不同的實體頁底下,所以有多條路可以到同一份證據,樹狀結構則讓每份文件主要只掛在一個分支。
論文沒有說明 agent 每一步怎麼決定該搜什麼、該跳去哪。路徑完全由 LLM 自己決定,只受每題固定的執行預算限制,沒有任何引導或限制規則。【推論】導航的品質會隨 agent 模型的能力而變。
3.4 為什麼地圖裡沒有實體—實體的邊
看到這裡可能會想:登記簿裡的實體之間有連線嗎?答案是沒有。登記簿是一份扁平的實體名冊,不是圖。它記的是實體 id、規範名稱、類型、出現過的寫法,加上每條連線的抽取證據(依渲染 prompt 列出的欄位,完整欄位論文沒有逐一說明)。沒有「Atlas 的負責人是 J. Chen」這類關係欄位。
兩個實體間接相關的方式,只靠共用文件: 與 的交集是 {Q3 Status Report},所以有路徑 Atlas → Status Report → J. Chen。
論文刻意沒加實體—實體邊,而且測過(Appendix B.4)。他們試了兩種加法,並把這些邊列在 Entity Page 上:一種是 LLM 抽取出的關係(例如「RRB-17 的 workaround 會刪除 installer-rollback-lock」),一種是共用同一份文件的實體配對。結果如下:
- 這種邊不會讓新頁面變得可到達。兩個實體本來就共用一份文件,邊只是把 縮短成 。
- 沒有邊時,agent 新開的 Entity Page 有 86% 到 90% 是靠搜尋找到的,因為頁面文字本身會提到其他實體。
- 有邊可用時,agent 只在 11% 到 19% 的題目裡跟著邊走,這些移動有 71% 沒帶來尚未找到的 gold 文件(gold 文件指基準標註、回答該題真正需要的文件)。透過邊第一次到達的 gold 文件,有 79% 在沒有邊時同一題也找到了。
- 文件召回率只變動 −2.6 到 +0.2 個百分點,Entity Page 卻變大 27% 到 52%,輸入 token 最多增加 28%。(以上來自 EnterpriseRAG-Bench,該段沒有明寫所用模型。)
整理起來:邊幾乎沒帶來新的路,卻讓頁面變大、token 變多,所以論文不加。
論文的結論是二部圖已涵蓋這些邊會帶來的連線。論文用下面這題做對照,問題是列出所有關於 RRB-17 的內部討論串。RRB-17 的 Entity Page 連到五份 gold 文件中的四份,剩下的一份是會議逐字稿,由另一條連結到達。表中同時列出實體—文件路徑與實體—實體路徑,可以直接對照兩種走法。
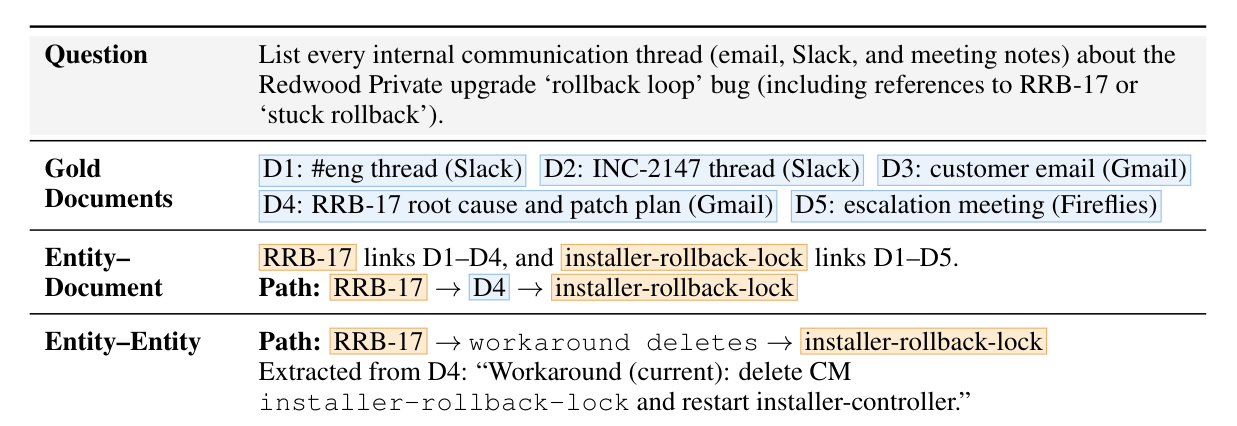
【推論】實體之間的關係被留在頁面文字裡(例如 Atlas 頁寫著 Owner: J. Chen),agent 想跳過去時用 grep 搜就好,不需要結構化的邊。
4 實驗
以下先講設定與指標(不懂指標就看不懂任何表),再講主結果,其餘實驗壓成列點。
4.1 設定
4.1.1 三個基準與文件庫
先定義兩個詞:gold 文件是基準標註的、回答該題真正需要的文件。干擾文件是與問題無關、混進文件庫讓搜尋變難的文件。
| 基準 | 取的題目 | 文件庫 | 內容 |
|---|---|---|---|
| EnterpriseRAG-Bench | 80 題(Project Related 40、Conflicting Info 20、Completeness 20) | 2,819 份 | 該基準所有題目的 gold 文件,加上與 gold 有連結的一跳干擾文件 |
| WixQA | 79 題(ExpertWritten 52、Simulated 27) | 6,221 篇 | 完整的客服知識庫文章 |
| HERB | 238 題(內容型問題) | 6,365 份 | 模擬軟體公司的 Slack、會議逐字稿、文件、PR 等:6,362 份被這些題目引用為證據的文件,加 3 個中繼資料檔 |
選題標準是只取「答案標註至少兩份 gold 文件」的題目。EnterpriseRAG-Bench 其他類別有單一或沒有 gold 文件,WixQA 則排除只依據單一文章的題目,共 397 題。所有方法使用同一個固定文件庫。
【推論】論文動機是數十萬份文件的企業語料,實驗文件庫卻只有 2.8k 到 6.4k 份(語料放大實驗到約 2 萬份)。EnterpriseRAG-Bench 的干擾文件取自與 gold 有連結的那一圈,應該比隨機干擾難,但仍比真實公司語料小而乾淨。論文沒有討論這一點。
4.1.2 指標
指標分三類,量「最終答案好不好」、「找到的證據齊不齊」、「花了多少 token」。
| 縮寫與全名 | 基準 | 量什麼 | 測哪一段 |
|---|---|---|---|
| Correct.(Correctness,正確性) | EnterpriseRAG-Bench | LLM 評審判斷答案大致吻合標準答案、沒有衝突,只有對或錯 | 最終答案 |
| Complete.(Completeness,完整性) | EnterpriseRAG-Bench | 標準答案拆成的原子事實中,答案涵蓋的百分比 | 最終答案 |
| Fact.(Factuality,事實性) | WixQA | 用官方評審 prompt,評答案包含標準答案關鍵資訊的程度 | 最終答案 |
| Content(內容分) | HERB | 用官方評審,依事實正確、完整、相關三面向對照參考答案評分 | 最終答案 |
| Doc. Rec.(Document Recall,文件召回率) | EnterpriseRAG-Bench | gold 文件中,有被放進 supporting set 的百分比,不用 LLM 算 | 找證據 |
| Ctx. Rec.(Context Recall,上下文召回率) | WixQA | 關鍵資訊有多少出現在 agent 蒐集到的上下文裡(工具輸出,加上隨問題給的候選清單) | 找證據 |
| Tokens | 全部 | 一題中,agent 所有 LLM 呼叫的輸入 token 加總 | 成本 |
Doc. Rec. 與 Ctx. Rec. 名字像,但不是同一種量:前者數「gold 文件有沒有被選進 supporting set」,後者問「關鍵資訊有沒有出現在讀過的內容裡」,數字不能跨基準直接比大小。所有 LLM 評審的指標,評審模型都是 GPT-5.6 Sol。
4.1.3 Overall Quality 與 Rel. Tok. 怎麼算
兩個總結指標的定義如下:
其中 是基準 上,該基準所有品質指標的平均(含兩個召回率指標,見下方提醒)。 是該方法在基準 的 token,除以同一模型下 Raw Corpus 在 的 token。取幾何平均,使三個基準權重相同,不被 token 最多的 HERB 主導。(【推論】這是筆記作者的解釋,論文沒有寫理由。)
實際算一次(取主結果表的 GPT-5.5,Raw Corpus):
| 基準 | 取的指標 | 算式 | 結果 |
|---|---|---|---|
| EnterpriseRAG-Bench | Doc. Rec.、Correct.、Complete. | (61.62 + 62.08 + 73.11) / 3 | 65.60 |
| WixQA | Ctx. Rec.、Fact. | (73.31 + 67.51) / 2 | 70.41 |
| HERB | Content | 62.31 | 62.31 |
Overall 是 (65.60 + 70.41 + 62.31) / 3 = 66.11,與表中一致。Rel. Tok. 以 CorpusMap(GPT-5.5)為例:88.1k / 206.5k = 0.43、74.5k / 337.2k = 0.22、494.7k / 598.4k = 0.83,三者的幾何平均約 0.43,與表中一致。
提醒: 論文只寫「品質指標」,Overall Quality 其實把兩個召回率指標也算進去了(用主結果表的數字反推才對得上)。只看答案類指標(Correct.、Complete.、Fact.、Content)時,增益縮小約四分之一。也就是說,頭條增益有一部分來自「找得到」,而不是「答得好」。下表是用主結果表的 GPT-5.5 數字自己算的:
| 含召回率(論文的 Overall) | 只算答案類指標 | |
|---|---|---|
| Raw Corpus | 66.11 | 65.81 |
| CorpusMap | 72.55 | 70.62 |
| 差距 | +6.44 | +4.82 |
4.1.4 比較對象(baseline)
六種方法的差別只有一個:導航層用什麼單位組織語料。原始文件在每種方法裡都保留,agent 也都用同一套 shell 指令操作。
| 方法 | 組織單位 | 做法 |
|---|---|---|
| Raw Corpus | 無 | 不加任何導航層,agent 直接搜原始文件 |
| Document Page | 每份文件 | LLM 替每份文件寫一頁重點事實 |
| Group Page | 語料自帶的分組(例如資料夾) | 把同一組的文件合併成一頁 |
| LLM Wiki(Karpathy, 2026) | 由 LLM 自己決定 | LLM 自由寫出互相連結的頁面 |
| Corpus2Skill(Sun et al., 2026a) | 主題階層 | 把文件分群、每群由 LLM 摘要,形成樹狀結構讓 agent 往下走 |
| CorpusMap(本文) | 實體 | Entity Page 加上實體—文件連結 |
| Gold Documents(Oracle) | 不適用 | 只把 gold 文件直接給模型,代表理想檢索下的能力上限 |
建構導航層與作答用同一個 LLM(GPT-5.5 建的地圖由 GPT-5.5 來答),跨模型重用另外測。Oracle 不是對手,論文自己說它是「不可比的」上限,用來衡量各方法離天花板多遠。
【推論】LLM Wiki 原本只是一份概念性的 gist,沒有標準實作,表中是作者自己的版本。它輸給 CorpusMap,只能證明「這個版本」輸。其他 baseline 的 prompt 細節,筆記作者在附錄中沒有看到。
4.2 主結果
先交代模型:實驗用的四個模型是 GPT-5.5,以及 GPT-5.6 的 Luna、Terra、Sol 三個版本。其中 Luna 最便宜,GPT-5.5 與 Sol 是最貴的兩個。
CorpusMap 在四個 GPT 模型的整體品質都最高,同時平均 token 較低。但領先幅度是「穩定」而不是「碾壓」,且集中在兩個基準。
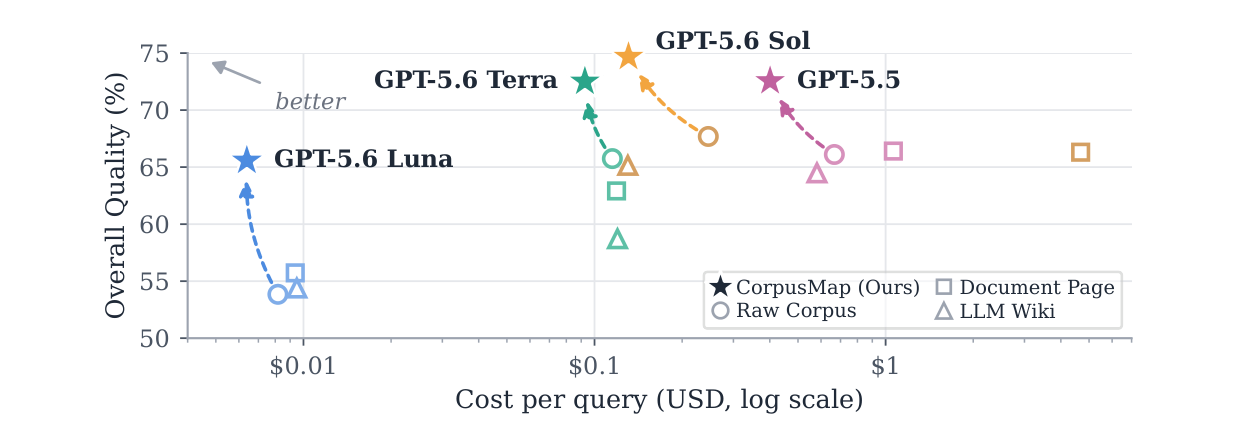
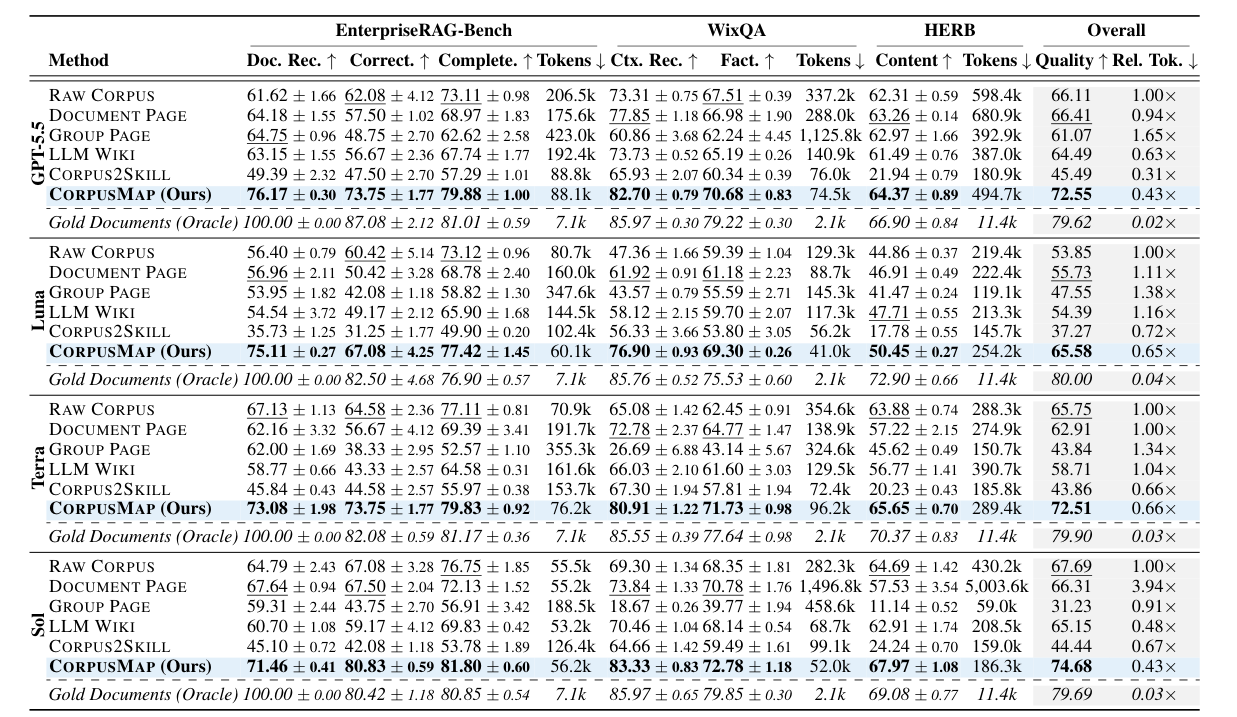
下表是主結果表的 Overall Quality(三個基準的平均再平均,題數 80、79、238,每個基準分數是三次執行的平均):
| 模型 | Raw Corpus | Document Page | LLM Wiki | Group Page | Corpus2Skill | CorpusMap | Oracle |
|---|---|---|---|---|---|---|---|
| GPT-5.5 | 66.11 | 66.41 | 64.49 | 61.07 | 45.49 | 72.55 | 79.62 |
| Luna | 53.85 | 55.73 | 54.39 | 47.55 | 37.27 | 65.58 | 80.00 |
| Terra | 65.75 | 62.91 | 58.71 | 43.84 | 43.86 | 72.51 | 79.90 |
| Sol | 67.69 | 66.31 | 65.15 | 31.23 | 44.44 | 74.68 | 79.69 |
- 增益:CorpusMap 四個模型的 Overall Quality 都最高。對 Raw Corpus 的增益是 +6.44、+11.73、+6.76、+6.99(表中數字相減)。論文的顯著性檢定表(paired bootstrap,以題目為單位重抽樣 100,000 次,Holm–Bonferroni 校正)給的數字是 +6.45、+11.74、+6.76、+7.00,95% 信賴區間全在 0 以上,例如 GPT-5.5 為 [4.30, 8.62]。
- 逐格核對:四個模型 × 六個指標共 24 格,CorpusMap 全部最高(Oracle 除外)。
- 其他導航層:沒有穩定贏過 Raw Corpus。Document Page 四個模型中只贏兩個(GPT-5.5、Luna),LLM Wiki 只贏一個(Luna,+0.54),Group Page 與 Corpus2Skill 四個都輸。論文自己的結論是:加一層導航層不保證有幫助。
- 成本:Rel. Tok. 是 0.43、0.65、0.66、0.43,也就是輸入 token 少 34% 到 57%,省最多的是最貴的兩個模型(GPT-5.5 與 Sol)。
- 不是碾壓:對每個模型最強的 baseline 領先約 6 到 10 分(+6.14、+9.85、+6.76、+6.99),離 Oracle 上限仍差 5 到 14 分(7.07、14.42、7.39、5.01)。成本逐格看也不是全面更低:Corpus2Skill 在 GPT-5.5 上更省(0.31× 對 0.43×,但品質只有 45.49),CorpusMap 在 Luna 的 HERB 用的 token 比 Raw Corpus 多(254.2k 對 219.4k)。
增益集中在兩個基準(GPT-5.5,每格是該基準所有品質指標的平均,題數 80、79、238):
| 基準 | Raw Corpus | CorpusMap | 增益 | Oracle | 離上限 |
|---|---|---|---|---|---|
| EnterpriseRAG-Bench | 65.60 | 76.60 | +11.00 | 89.36 | 12.76 |
| WixQA | 70.41 | 76.69 | +6.28 | 82.60 | 5.91 |
| HERB | 62.31 | 64.37 | +2.06 | 66.90 | 2.53 |
【推論】HERB 的上限本身就低(Oracle 直接拿到 gold 文件也只有 66.90),這個基準的瓶頸看起來不在「找得到」,所以導航層能幫的空間小。論文沒有分析這一點。論文自己的說法是「縮小與 Oracle 的差距」,這個描述準確,不是超越。
4.3 其餘實驗
- 地圖跨模型重用(表 4,以下數字都是 EnterpriseRAG-Bench 上的結果,增益是相對 Raw Corpus):
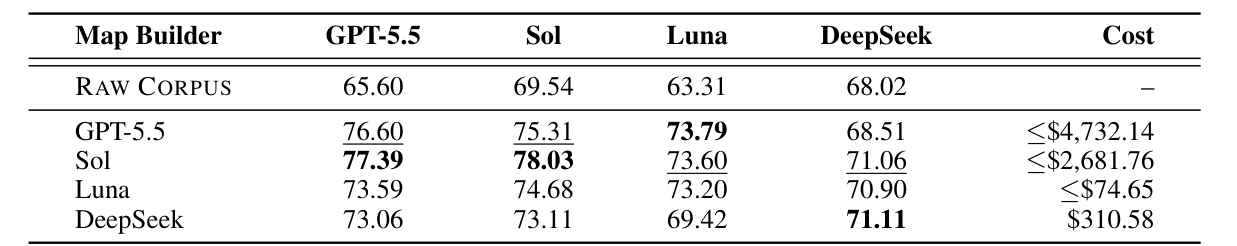
- 用最便宜的 Luna 建的地圖,四個答題模型都贏過 Raw Corpus(+7.99、+5.14、+9.89、+2.88)。
- 建構成本上限 74.65 美元,約為 GPT-5.5 建圖(上限 4,732.14 美元)的 1.6%。
- GPT-5.5 用 Luna 的地圖得 73.59,用自己建的得 76.60,差 3.01。
- 結論是地圖可以用便宜模型建一次,給貴的模型重用。這張表沒有標準差,格子間的差距常在 1 分左右,所以「誰建得最好」的排序不要看太重。
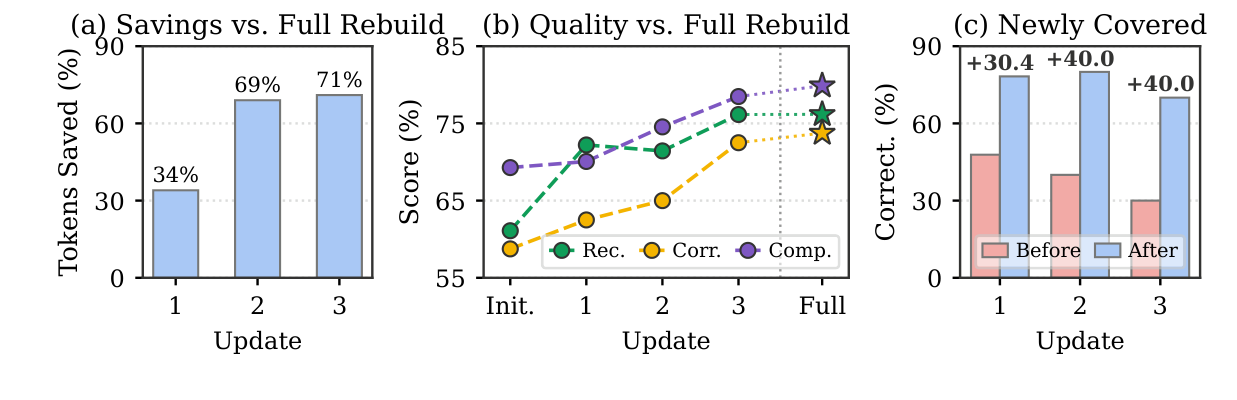
- 增量更新(圖 3):依時間順序加入新文件,只重新渲染連結文件有變動的 Entity Page。三次增量更新分別省下完整重建建構 token 的 34%、69%、71%,最終品質與完整重建相當。被更新納入的題目在更新後變好,即使這些文件原本就能在原始語料裡搜到。只用 GPT-5.5、EnterpriseRAG-Bench 測。
- 語料放大(圖 4):加入干擾文件並保留所有 gold 文件,文件庫放大到 2.8k、10k、20k 份,CorpusMap 每個規模都贏 Raw Corpus 且用更少 token。開源的 Qwen3.8-27B 用同一份(GLinker 建的)地圖,每個指標與規模也都改善。
- 其他模型家族(論文的跨模型家族表):DeepSeek-V4-Pro 從 68.02 到 71.11,MAI-Thinking-1 從 34.06 到 45.07,皆為最高。MAI-Thinking-1 的 token 反而增加(129.6k 到 158.8k),所以「更省 token」不是每個模型都成立。
- 對比傳統檢索式方法(論文的檢索式對照表):BM25、dense、HippoRAG、GraphRAG 都低於 CorpusMap。GPT-5.5 上最強的檢索式方法 65.05,CorpusMap 76.60,Luna 上最強 61.74,CorpusMap 73.20。論文的解釋是,檢索式只能用「那一次取回的內容」作答,agent 則可以繼續補證據。
- 顯著性(論文的顯著性檢定表):對每個 baseline、每個模型,95% 信賴區間都在 0 以上。重抽樣的單位是題目,不是獨立重跑整套實驗。
- 換評審重評(論文的換評審重評表):換成 DeepSeek-V4-Pro 當評審,CorpusMap 仍是五個 LLM 評分指標中最高。Kendall’s 是兩份排名的相關係數,1 代表排序完全一致:Correct.、Complete.、Content 為 1.00,Fact. 為 0.83,WixQA 的 Ctx. Rec. 只有 0.47。
- 其餘單文件問題(論文的剩餘題目表):在 EnterpriseRAG-Bench 剩下大多只靠單份文件的題目上,CorpusMap 仍然贏(GPT-5.5:Correct. 89.05 到 94.76,Tokens 250.7k 到 171.7k)。這個題集的題數論文沒有給。
- 共同限制:幾乎所有延伸實驗都只在 EnterpriseRAG-Bench 上做。
5 值得帶走的概念
下面兩個概念與這篇論文無關也成立。
5.1 multi-document 與 multi-hop 是兩種不同的問題
一句話版本:multi-document 問的是「答案要合併幾份文件」,multi-hop 問的是「是否必須先讀完上一份,才知道下一份要找什麼」。
| multi-hop(鏈式) | multi-document(這篇的範圍) | |
|---|---|---|
| 證據之間 | 有依賴:先讀 A 才知道要找 B | 不一定有依賴,只要求合併至少兩份 |
| 例子(本篇) | Atlas → J. Chen → Standup | 「列出所有關於 RRB-17 的討論串」(表 2 的問題) |
| 關係 | 屬於 multi-document 的一種 | 範圍較大,包含鏈式與並列兩種 |
論文自己用的詞是 multi-document。選題標準也看得出來:EnterpriseRAG-Bench 只取「每題標註至少兩份 gold 文件」的類別,其中 Conflicting Info(版本比對)、Completeness(蒐集齊全)未必是鏈式推理。
【推論】判斷法則是問自己「讀第一份之前,我能不能就知道第二份該找什麼?」不能,就是鏈式,必須逐步找。可以,就是並列蒐集,重點在一次撈齊。
這對方法選擇有影響:鏈式需要 agent 迴圈(讀了才決定下一步),並列蒐集的瓶頸是召回,用夠好的索引或實體連結就能一次抓到一組。本篇的 Atlas 例子靠實體當橋把鏈式縮短,RRB-17 的例子靠實體一次連到一組文件,兩種都被同一個結構處理。
對評估也有影響:評估一個方法時,要先確認基準裡的題目是哪一種,否則會把「撈得齊」與「推得下去」兩種能力混為一談。
5.2 二部圖(bipartite graph,也譯二分圖)
一句話版本:節點分成兩種(兩「部」),連線只出現在不同種的節點之間。同一種的兩個節點之間不能直接連線,它們靠共同連到的另一種節點間接相關。
形式上與前面「地圖的結構」的定義相同,更一般的寫法是 :
- :第一種節點(本篇是實體)。
- :第二種節點(本篇是文件)。
- :連線的集合,每條線一端在 、一端在 。
自編類比:學生與社團。
| 節點種類 | 例子 |
|---|---|
| 第一種 | 學生(小明、小華) |
| 第二種 | 社團(攝影社、桌遊社) |
| 連線 | 「加入」:小明 — 攝影社 |
沒有「小明 — 小華」的線,也沒有「攝影社 — 桌遊社」的線。但如果小明和小華都加入攝影社,他們就透過攝影社間接相連。對應到 CorpusMap:學生是實體(Atlas、J. Chen),社團是文件(Status Report、Standup),「加入」是「這份文件有提到這個實體」。快速檢查的口訣是,看任何一條線,兩端一定是「一個實體、一個文件」,出現「實體 — 實體」的線,就不是二部圖了。
為什麼值得獨立學:
- 兩個同類節點的關係,用「共同鄰居」表達就夠了。 兩個實體相關,就是它們的文件鄰域 與 有交集。前面實體—實體邊的實驗佐證了這點:另外加直接的邊,文件召回率幾乎沒變,頁面卻明顯變大。
- 它在檢索裡其實很常見。【推論】 倒排索引就是「詞 ↔ 文件」的二部圖,推薦系統是「使用者 ↔ 商品」,作者與論文是「作者 ↔ 論文」。CorpusMap 的新意,是把「詞」換成「解析過的實體」,同一個東西的不同寫法會併在一起。
- 選擇法則。【推論】如果關係只是「提到、屬於」這種成員關係,細節可以寫在頁面文字裡,二部圖就夠,成本最低。如果需要把「負責人是誰」這類有型別的關係當成查詢條件去篩選,才需要考慮帶型別的邊,那時要另外證明值得。本篇只驗證了前半。
6 結論
CorpusMap 把「文件之間誰跟誰有關」這件事,從每題重做的查詢時工作,搬成一次離線建好、可以重用的實體—文件二部圖。在三個基準、四個 GPT 模型上,它的整體品質都最高,輸入 token 少 34% 到 57%,其他導航層沒有穩定贏過直接搜原始文件。
實際要採用時,有幾件事要記得。增益有一部分來自「找得到」而不是「答得好」,HERB 這類瓶頸不在檢索的基準幾乎沒有好處。實驗文件庫遠小於真實的企業語料,延伸實驗也大多只在 EnterpriseRAG-Bench 上做。把分散的資訊集中成一頁,也要先想清楚權限問題。工程上比較實用的訊息是:地圖可以增量更新、可以用便宜模型建一次給貴模型重用,甚至把抽取、解析、渲染換成現成工具而不用 LLM。