EvoOntology 解析:在 data agent 與資料之間,加一層會自己演化的 ontology
 Hong-Wei Wu
收錄於 論文介紹
1 data agent 每次都從零摸資料,把說明整包塞進 prompt 還可能更糟
問 data agent(一種根據自然語言指令,去操作資料庫表格、CSV、文件、log 這類異質資料的 AI agent)一個問題:「上個月成本為什麼上漲?」答案可能散在好幾張表,甚至夾在文件裡。但 agent 事前完全不知道這些資料實際長什麼樣子:欄位叫什麼、表和表怎麼 join(依共同欄位把幾張表接起來),每個任務都得從頭摸一遍。
EvoOntology: A Self-Evolving Ontology Layer for Data Agents(arXiv:2609.15779v1,Renmin University of China 的團隊,2026 年 9 月)的做法,是在 agent 與資料之間插入一層可以被查詢、而且會根據使用經驗自我修補的知識層。
這一層的核心是 ontology(本體)。先把它理解成一份結構化的領域知識:有哪些業務概念、每個概念對應到資料庫的哪個欄位、使用這些概念要遵守什麼規則,再用「圖」把概念之間的關係連起來。它和傳統 ontology、knowledge graph 的差別,文末的延伸閱讀會細講。
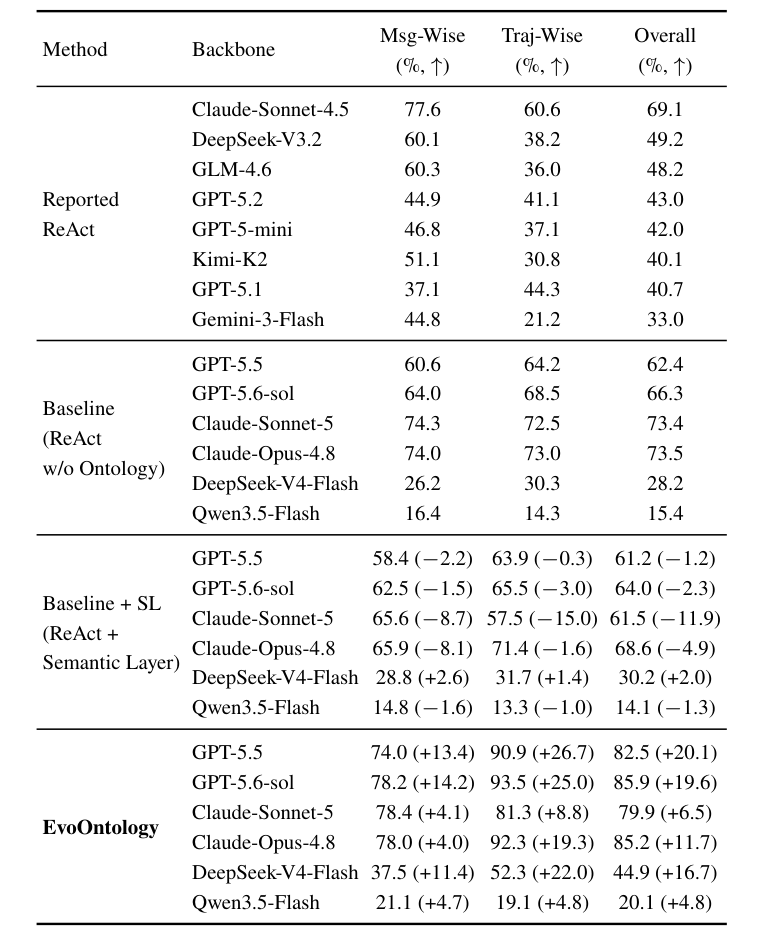
在 DDR-Bench(一個開放式資料研究的 benchmark,分數是準確率,越高越好)上,EvoOntology 在六個 backbone(驅動 agent 的底層 LLM)上全面贏過沒有 ontology 的 Baseline,平均增益是 +17.8 分。反過來,把 semantic layer(一本把業務用語對應到資料庫欄位的翻譯字典)整包塞進 prompt 的對照組常常沒用,甚至倒退:Claude-Sonnet-5 的 Trajectory-Wise 分數(DDR-Bench 的指標之一)反而掉了 15.0 分。
不過整體評價是貢獻中等偏低:結構化知識層、從失敗歸因、驗證閘門這個骨架,和同類論文在架構精神上同構。值得借用的是驗證閘門(候選修改要先通過、才會被採用的一道檢查)的設計,以及「主動查詢優於整包塞 prompt」這個結論。
文中有幾個以「論文沒交代清楚」開頭的引言區塊。它們標的是我們讀完論文後的推論或疑問,不是論文原文。
路線是這樣:先看問題和整體架構,再拆解它怎麼冷啟動、怎麼自我演化,接著看實驗數字與評價,最後是幾個脫離這篇論文也成立的概念。
2 問題:agent 不認識資料,既有的兩派做法各有短板
核心麻煩是:agent 只能透過 SQL 介面(用結構化查詢語言向資料庫發問的方式)、file reader 這類通用工具接觸資料,但資料的欄位怎麼命名、彼此怎麼 join、內容長什麼樣子,它事前一無所知。於是每次任務都要重新盲目探索:反覆發 probing query、猜資料可能藏在哪、再從一堆不相關的內容裡篩選。論文把「agent 知道的」與「資料實際的樣子」之間的落差,稱為 agent-data gap。
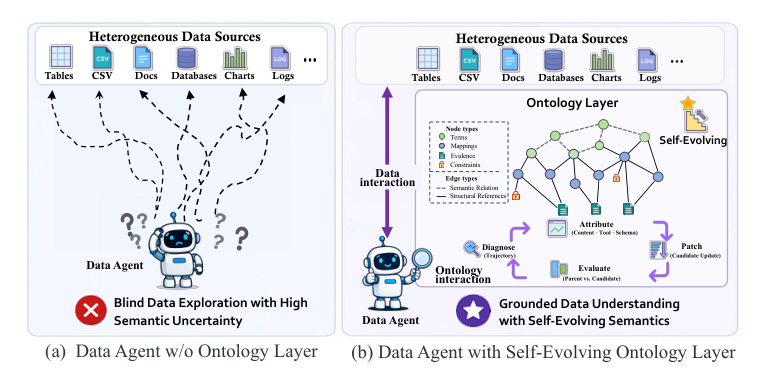
圖 1 用兩個畫面呈現這件事。左邊 (a) 是沒有 ontology 層的 data agent,箭頭雜亂地指向各種資料源,標註為高語意不確定性下的盲目探索。右邊 (b) 在中間多了一層畫成小型知識圖的 ontology 層,agent 先與這層互動,再由這層去對接實際資料,標註為有根據的資料理解,並且語意會自己演化。
那麼,既有的做法怎麼處理這個落差?大致分成兩派:
| 做法 | 代表 | 怎麼運作 | 侷限 |
|---|---|---|---|
| Raw querying | DIN-SQL、MAC-SQL、CHESS 這類 text-to-SQL agent | 讓 agent 直接摸 schema(資料表與欄位的結構)、發 exploratory query | 資料一大一異質,就陷入重複無效的探索;這次好不容易摸清楚的欄位對應,下次任務又要重摸,學到的東西不會被留下來 |
| Semantic layer | dbt 的 semantic layer、OWL ontology | 人工預先定義好業務概念對應到哪些欄位、哪些指標,整包塞進 prompt | 資料源一大就超過 context 長度限制;而且文件要人工維護,新資料、新任務一來就得跟著改 |
表裡提到的 semantic layer,直覺上是一本「業務語言與資料庫語言」的翻譯字典。使用者說「上個月營收多少」,但資料庫欄位可能叫 fact_rev.net_revenue_amt,還要 join 三張表,還要排除已取消的訂單。semantic layer 就是把這層翻譯規則寫下來,放在資料與使用者之間。
OWL(Web Ontology Language)的來歷:2000 年代初由 W3C 訂定的標準,屬於 Semantic Web 與知識表示(Knowledge Representation)的傳統,跟現在的 LLM 與深度學習是完全不同的兩條線。
在現代 AI 圈:不算常見,主要活在傳統知識圖譜、醫學生物領域的本體(例如 Gene Ontology)與企業資料治理場景。
真正的能耐是形式邏輯推理:定義 class、subclass、property 限制後,可以自動推論。例如定義「鳥都會飛」,系統看到「X 是鳥」,就能自動推出「X 會飛」。
dbt semantic layer 的來歷:dbt(data build tool)是資料工程圈近年很紅的工具,負責在資料倉儲裡做 SQL 轉換。它的 semantic layer 功能(底層叫 MetricFlow)讓「營收」這種指標的定義只寫一次,各種 BI(商業智慧)報表工具都查同一份定義,不會各自定義出不一致的結果。
這是現代資料工程實務,不算 AI 領域的東西。
這篇論文的切入點,是把「靜態塞進 prompt 的說明文件」升級成「agent 可以主動查詢、而且會根據使用經驗自己演化」的一層。這一層被包成 MCP(Model Context Protocol,一種讓 agent 用統一格式呼叫外部工具的協定)server,agent 用工具呼叫去問它,而不是把整包知識硬塞進 context。
小結:agent 知道的和資料實際的樣子之間有一道落差。盲目探索學不到東西;整包塞 prompt 則是資料一大就塞不下,人工維護的文件也跟不上。
3 做法:在 agent 與資料之間放一層三層 ontology
從這裡開始是整篇的核心:這一層 ontology 長什麼樣子。它由三層組成,存知識的 Content Layer、管規則的 Schema Layer、讓 agent 來查的 Tool Layer。EvoOntology 的 ontology 在演化第 輪的狀態,論文寫成一個三元組:
三個符號分別對應 Content Layer()、Schema Layer()與 Tool Layer()。這裡的 只是輪次編號(第 0 輪、第 1 輪……),不涉及計算,純粹標記「哪一個版本」。
3.1 Content Layer:用四種節點和兩種邊把領域知識連成圖
先從知識本身存放的地方開始。Content Layer 是一個 typed semantic graph(有型別的語意圖),裡面有四種節點家族、兩種邊家族。
| 節點類型 | 代表什麼 | 財務範例 |
|---|---|---|
| Term(概念) | 抽象的領域概念本身,不是實際資料 | Cost、Revenue、Profit、Time 這幾個概念 |
| Mapping(對應) | 把 Term 落地到具體欄位與串接路徑 | Term「Cost」對應到 fact_cost.total_cost 這個實際欄位 |
| Constraint(規則) | 規範這些概念合法使用方式的業務規則 | 「Profit = Revenue - Cost」、「Revenue 不含已取消訂單」 |
| Evidence(佐證) | 支撐前面語意聲明的實際觀測證據 | 實際抽樣看到的 cost catalog、revenue records |
| 邊類型 | 連什麼 | 具體型態 |
|---|---|---|
| Semantic Relations | Term 與 Term 之間 | association(關聯)、hierarchy(上下位)、composition(部分與整體)、equivalence(等價)、derivation(推導),共五種 |
| Structural References | Term 連到 Mapping,以及把 Constraint、Evidence 掛到它們所支持的對象上 | 不是概念與概念的關係,而是「掛載」關係 |
圖 2 是整篇會反覆用到的財務分析案例(圖說裡的「軌跡」,指 agent 執行任務時留下的完整過程)。它的內容可以拆成下面五條連線:
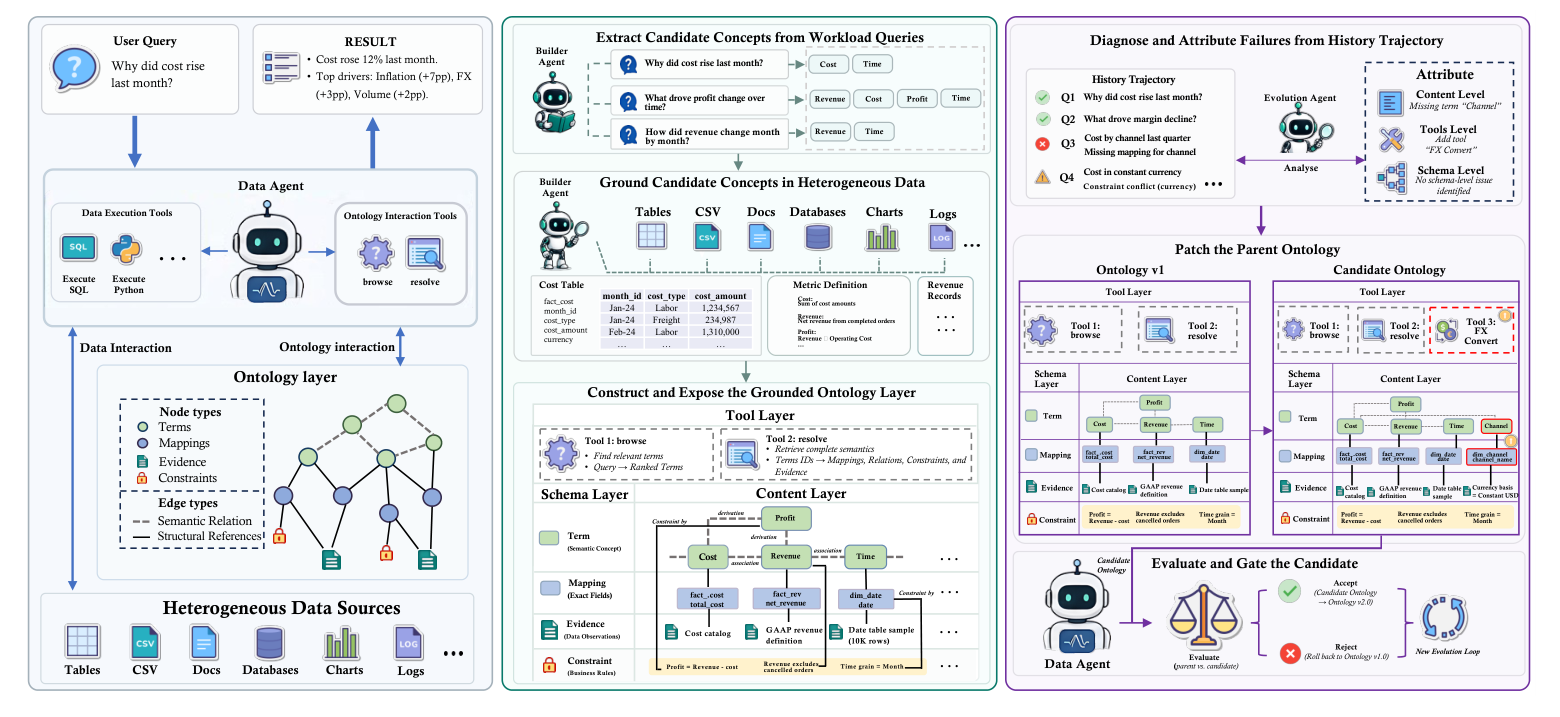
- Profit 以 derivation 連到 Revenue 與 Cost(Profit 是由 Revenue 減 Cost 算出來的)。
- Revenue 與 Cost 各自以 association 連到 Time。
- Cost 掛著一個 Mapping,指向
fact_cost.total_cost。 - Profit 受一條 Constraint 規範:Profit = Revenue - Cost。
- 那個 Mapping 再掛著 Evidence:cost catalog 的觀測樣本。
最關鍵的是 derivation 這條邊。它把「Profit 不是憑空存在,而是從 Revenue 減 Cost 算出來的」這件事,變成圖結構本身的一部分,而不是塞在某個字串定義裡。agent 查到 Profit 這個 Term,可以沿著 derivation 邊直接找到 Revenue 與 Cost,再沿著它們各自的 structural reference 找到實際欄位與佐證資料。這種「可以沿著關係走」的能力,是圖狀結構相對於扁平字典(例如傳統 semantic layer)的核心差異,後面的延伸閱讀會再展開。
3.2 Evidence 和 Constraint 差在哪:用卡牌合法性案例走一次
Term、Mapping、Constraint、Evidence 裡,Evidence 與 Constraint 最容易搞混,各自回答的問題不一樣。
| 比較項目 | Constraint(規則) | Evidence(佐證) |
|---|---|---|
| 回答的問題 | 這個概念應該怎麼用 | 這個概念的聲明是不是真的 |
| 內容形式 | 業務規則文字,例如 Profit = Revenue - Cost | 實際抓回來的資料片段,例如某欄位實際出現過哪些值 |
| 誰產生的 | builder agent(建立初始 ontology 的 agent)從查詢集合(workload)與資料推導出規則 | builder agent 對資料源實際發 query 拿到的原始結果 |
直接看一個真實案例會比較清楚。圖 3 是卡牌合法性任務裡一次被接受的修補,新增的物件用紅色虛線框標出。
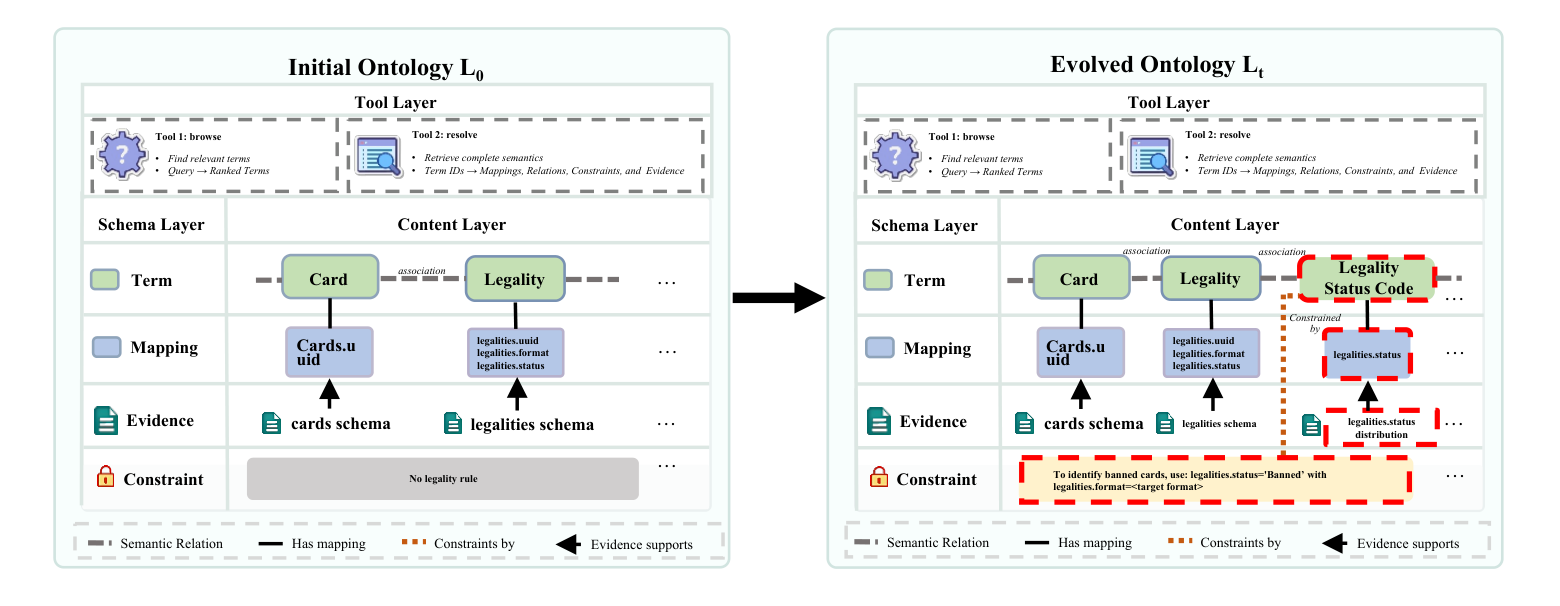
這個案例剛好能具體走一次。(圖中「被接受的修補」是怎麼產生、怎麼被驗收的,會在自我演化迴圈一節交代。)系統要新增「Legality Status Code」這個概念,代表 legalities.status 這個欄位,三個東西一起加進去:
- Mapping:指向
legalities.status。 - Evidence:實際觀測到的值分佈(Banned、Legal、Restricted 等)。
- Constraint:
legalities.status為Banned且legalities.format等於目標賽制,才算被禁用。
Evidence 在這裡的作用是:agent 不是憑空相信「這個欄位裡有個叫 Banned 的值」,而是真的探測過、有實際觀測紀錄可查。要注意 Evidence 存的不只是數值,也可以是 schema 結構、樣本資料、目錄清單(Content Layer 裡就有 “cards schema”、“date table sample” 這種 schema 觀測型的佐證)。
簡單說,Term 是概念,Mapping 是概念接到哪個欄位,Constraint 是怎麼正確使用這個概念的規則,Evidence 是證明前面這些聲明真的有資料撐腰的原始觀測紀錄。
3.3 Schema Layer:像 class 定義的規則書,改它不動既有知識
知識怎麼存講完了,接著看管規則的那層。用物件導向的類比最直覺:Schema Layer 像 class 的定義,Content Layer 才是實際 new 出來的物件。
class Term:          # Schema Layer 定義這個型別有哪些欄位
    name: str
    description: str

term1 = Term(name="Profit", ...)   # Content Layer 是實際的物件
Schema Layer 具體定義三件事:
- 四種節點家族各自的欄位:Term、Mapping、Constraint、Evidence 各自應該長什麼樣子(論文沒有把每個型別的完整欄位列出來,只在敘述裡零星提到)。
- 合法的 Semantic Relation 類型:就是前面那五種。
- 合法的 reference pattern:Structural Reference 誰可以指向誰,例如 Term 可以連到 Mapping、Constraint 可以掛在 Mapping 或 Term 上。
這層設計的關鍵好處是:改 Schema 不會動到既有的知識內容。比如想讓系統支援一種新的關係類型 temporal_dependency(時間先後依賴),只要改 。加了這條規則後,既有的 Profit、Revenue、Cost 完全不用動,只是未來可以開始用這種新關係描述知識。這也解釋了後面實驗裡 Schema 層級的修補次數最少:大多數時候問題出在知識內容不夠,而不是規則本身表達力不夠。
3.4 Tool Layer:agent 唯一碰得到的窗口,manifest 加 browse 與 resolve
前兩層講的是知識怎麼存,這一層講 agent 怎麼拿到,也是三層裡唯一真正與 agent 互動的介面。這個窗口由三樣東西組成:一份 manifest,加上 與 兩個工具。
① Manifest(清單)。 唯一會直接塞進 prompt 的東西,內容很精簡:資料源有哪些、這個工具怎麼用。這正好呼應前面講的問題:semantic layer 的痛點是整包塞進 context,這裡的解法是只把「使用說明書」放進 prompt,實際知識留在 ontology 裡,由 agent 自己決定要不要去查。
② 。 找相關概念的模糊比對與檢索。
| 符號 | 意思 |
|---|---|
| (query) | agent 想查的東西,可以是自然語言或關鍵字,例如「cost」 |
| (kind) | 限定只在哪個節點家族裡找:Term?Mapping?Constraint? |
| 要回傳前幾名 |
輸出是一份排序過的候選清單,也就是語意上與 最相近的 個結果。
③ 。 拿某個已知物件的完整內容。
| 符號 | 意思 |
|---|---|
| 要查詢的物件識別碼(例如從 browse 拿到的 Term ID) | |
| 論文沒有說明 |
原文只給了 這個函式簽名,沒有像 、、 那樣逐一說明每個參數。我們推測 可能類似 browse 的 ,用來限定只展開哪一類關聯物件,但這只是推論。
輸出是這個物件本身,加上它連到的所有東西(Mapping、Relations、Constraints、Evidence)。
3.5 走一遍:「上個月成本為什麼上漲」是怎麼被查出來的
| 層 | 角色 | agent 直接接觸得到嗎 |
|---|---|---|
| Schema Layer | 規則書,定義有哪些節點型別、哪些邊合法 | 不會,完全看不到,是背後的守門機制 |
| Content Layer | 知識本身,實際的 Term、Mapping、Constraint、Evidence 圖 | 間接接觸,要透過 Tool Layer 查詢 |
| Tool Layer | 窗口,manifest 加 browse、resolve 兩個 MCP 工具 | 是,agent 唯一直接互動的介面 |
繼續用圖 2 的案例。使用者問:「Why did cost rise last month?」,最終結果是「Cost rose 12% last month. Top drivers: Inflation (+7pp), FX (+3pp), Volume (+2pp).」中間的流程如下:
使用者  → Data Agent : Why did cost rise last month?
(manifest 已經在 prompt 裡,只有簡短說明,不含細節)
Agent   → Tool Layer : f_browse(q="cost", k="Term", n=3)
Tool    → Content    : 語意比對
Content → Agent      : 候選,Term "Cost" 排第一
Agent   → Tool Layer : f_resolve(I=[Term:Cost], c=...)
Tool    → Content    : 沿著邊撈出連著的物件
Content → Agent      : Mapping / Constraint / Evidence 一次交付
Agent                : 組 SQL 或 Python 去查 fact_cost 表
Agent   → 使用者     : Cost rose 12%,Inflation +7pp, FX +3pp, Volume +2pp
小結:manifest 讓 agent 知道有哪些窗口可以用,browse 找到 Term,resolve 一次拿到它連著的 Mapping、Constraint 與 Evidence,agent 才開始寫查詢。
這裡走的是「已經建好的 ontology 怎麼被查詢」。Content Layer 裡那些物件一開始是怎麼生出來的,是下一節的內容。
4 冷啟動:不靠人工、不看標準答案,生出第一版 ontology
人工定義領域概念、欄位對應、串接路徑與語意規則,非常花專家時間。這一步要看的是:builder agent 怎麼不靠人工,也完全不看標準答案(gold answer),直接從訓練用的查詢集合(workload)加上原始資料源,自動生出第一版 ontology。
4.1 propose、probe、verify、construct:概念要被真實資料驗證才收進來
整個流程分四步:
- propose:從 workload 提出候選概念集合 ,例如 Cost、Revenue、Profit、Time。
- probe:對每個候選 ,實際發探測查詢到資料源 。
- verify:檢查探測結果的型別、值分佈與語意一致性是否符合預期,符合才通過。
- construct:把通過驗證的候選,依 Schema Layer 的規則實例化成初始 Content Layer。
論文用兩條式子描述(原文的 Equation 1)。白話是:只有探測結果通過驗證的候選才會收進 ,再用 Schema 的規則把它們建成初始的 Content Layer。
| 符號 | 意思 |
|---|---|
| propose 從 提出的候選概念集合 | |
| 裡的一個候選 | |
| 對候選 實際探測資料源 的結果 | |
| 檢查探測結果是否符合型別、篩選、值分佈的預期,符合回傳 1 | |
| 通過驗證的候選子集合,也是唯一會被正式收進 ontology 的一批 | |
| 依 Schema Layer 的規則 ,把 實例化成初始 Content Layer | |
| 建出來的初始 Content Layer |
以圖 2 的案例為底重建一個示意(論文本身沒有給出實際跑起來的逐步數字):
c = "Cost"
  probe(Cost, D) → 找到 fact_cost.total_cost,型別=數字 OK,值分佈合理 OK
  verify(...) = 1 → Cost 進入 C+,探測抓到的樣本存成 Evidence

c = "Revenue"、"Time":同樣流程,各自驗證通過,進入 C+
整體來看,propose 決定「該查什麼」,probe 加 verify 決定「查到的東西在真實資料裡站不站得住」,兩者都做完才正式進入 ontology。這也是論文標題裡 “evidence-grounded” 的來源。
至於這四步哪些需要 LLM,論文沒有逐一標明。我們依每個函式實際要做的事倒推:propose 要從一批自然語言查詢裡「看懂」反覆出現的概念,是語意理解任務,大概率需要 LLM;probe 裡判斷「欄位名稱加樣本值,是不是真的對應某個概念」的部分也可能需要,但型別與值分佈的檢查可以是純 SQL 的機械檢查;verify 若規則已明確定義,可以是純程式的條件判斷;construct 只是依 Schema 把已驗證的候選組裝成圖節點,比較像純工程實作。這整套是推論,論文沒有講到這個顆粒度。
4.2 workload 怎麼分給不同用途,以及 split-and-swap 評估法
再看資料怎麼分。以 100 筆 query 的 workload 為例,論文原文只講了兩層切分,而且沒有把冷啟動、演化、驗證切成三塊分開:冷啟動用的資料與演化迴圈用的軌跡(agent 執行任務時留下的完整過程)來源,論文是混在一起講的。因此下面的比例,是我們依論文敘述的推測。
100 筆查詢
   |
   v  第一層切分(假設接近對半,論文未明講精確比例)
Fold A(約 50 筆) + Fold B(約 50 筆)
   |
   v  第二層切分,只切在 Fold A 裡(以 A→B 方向為例)
A 的 70%(約 35 筆)→ 冷啟動的 propose / probe / verify
                      + 演化迴圈的軌跡來源
                      (這兩件事共用同一批,論文未再分開)
A 的 30%(約 15 筆)→ gate 用的驗證集 V

Fold B(約 50 筆)→ 完全不碰,ontology 凍結後才拿來算最終分數

反過來再跑一次 B→A,最後 Score = (Score_{A→B} + Score_{B→A}) / 2
這叫 Reciprocal Two-Fold Evaluation(split-and-swap):兩份互斥資料互為訓練與測試,取平均分數,避免「用來建置系統的資料同時拿來評估系統」造成的樂觀偏誤。這是可以遷移的評估方法論,不限於這篇論文的場景。
4.3 workload-driven 冷啟動的盲點:沒被問過就永遠學不到
Cost、Revenue 這種直接對應一個欄位的概念,probe 起來很直覺。但像 Profit 這種沒有實體欄位、是算式推導出來的概念,怎麼被 verify,論文完全沒交代。更進一步,propose 完全是 bottom-up,只從查詢文字反推概念,沒有主動去掃資料庫 schema,找「可能存在但 workload 沒問到」的候選。這正好對應到 text-to-SQL 領域的 schema linking 問題(把問題裡的詞對應到資料庫的表與欄位),論文自己引用的 RSL-SQL、E-SQL 就是專門處理這個子問題的方法。
| 比較項目 | Workload-driven(論文做法) | Schema-driven(替代做法:直接給資料庫 schema、範例查詢與領域知識) |
|---|---|---|
| 候選概念從哪來 | 查詢裡反覆出現的字眼 | 資料庫結構本身,加上既有文件與 DBA(資料庫管理員)的知識 |
| 優點 | 天生對齊真實使用場景,不會生出用不到的概念 | 覆蓋率完整,不會漏掉 workload 沒問到、但系統確實存在的欄位或概念 |
| 缺點 | workload 沒覆蓋到的查詢模式,系統天生沒有對應概念 | 容易生出從沒被用過的概念;多層 join 關係依然不會自動解決 |
| 適用時機 | workload 有代表性、覆蓋主要查詢類型 | workload 稀疏,或已有現成 schema 文件;兩者也可混用 |
論文的實質缺口是:所有 baseline 與 ablation(消融實驗:逐一拿掉系統的某個部分,看分數掉多少)比的,都是「workload-driven 機制內部拿掉某個步驟」,沒有任何一組實驗拿 schema-driven 的冷啟動來對照。
有一個緩解、但仍有破綻的推論(不是論文明講的):論文的設計哲學可能是不指望初始化一次到位,靠後面的自我演化迴圈事後修補。破綻在於,如果一個複雜的多層關係在冷啟動時就漏掉,而且從來沒被使用者問過,它也不會出現在執行軌跡裡,演化迴圈根本沒有機會去補這個洞。這個「沒被問過就永遠學不到」的死角,論文同樣沒有討論。
冷啟動小結:候選概念要先被真實資料驗證才收進 ontology,所以第一版有證據撐腰;但它只從查詢文字反推概念,沒被問過的就學不到(這點是我們的推論)。
5 自我演化迴圈:診斷、歸因、局部修補、閘門
冷啟動建好的初始 ontology 是靠 workload 猜出來的,agent 真的拿去用之後,一定會暴露出「哪裡漏了」「哪裡誤導了」。自我演化迴圈要做的,就是持續把這些問題變成對 ontology 的具體修補。整個迴圈由四步構成:
- Diagnose:找反覆出現的失敗模式。
- Attribute:判斷問題屬於哪一層。
- Patch:局部修補,一次只動一層。
- Gate:配對驗證,決定接受或拒絕。
不論接受或拒絕,都進入下一輪,回到 Diagnose 重新開始。論文把前兩步合寫在同一個小節「Trajectory Attribution」,但後面的 ablation 是把兩步拆開、分別拿掉來測的。
5.1 Diagnose 與 Attribute:先判斷問題出在 Content、Tool 還是 Schema
要做的事是回頭看 agent 過去實際執行任務的一批紀錄,找出重複出現的失敗模式,並判斷這個失敗是 ontology 的哪個部分沒做好:內容(Content)不夠、缺了某個工具(Tool),還是規則本身(Schema)設計得不對。
論文原文:“Given historical trajectories and the current state , the evolution agent extracts recurrent signatures . The agent assigns the signature to Content, Tool, or Schema through .”
| 符號 | 中文白話 |
|---|---|
| 第幾輪演化;ontology 每被修補接受一次, 就加 1 | |
| 到第 輪為止,累積的一批 agent 執行紀錄 | |
| 第 輪當下 ontology 的完整狀態,即 | |
| 輸入「這批歷史紀錄」與「目前的 ontology」,輸出「有哪些問題重複發生」 | |
| analyze 找出來的一批特徵訊號集合 | |
| 裡的其中一個訊號,描述這是什麼互動模式、牽涉哪些 ontology 物件、結果成功還失敗 | |
| 分類函式(歸因判官):輸入一個訊號,輸出這個訊號該算誰的錯 | |
| 三個可能的判定:Content Layer、Tool Layer、Schema Layer |
帶入圖 2 的案例走一次。圖 2 右側面板列了四筆歷史查詢當作 :
Q1: "Why did cost rise last month?"       → 執行順利
Q2: "Why did margin decline?"             → 執行順利
Q3: "Cost by channel last quarter"        → 失敗
Q4: "Cost in constant currency"           → 失敗

analyze 抓出兩個反覆出現的訊號:
  σ1 = 問題牽涉「依通路(channel)拆分成本」,
       但 ontology 找不到對應的 Term 或 Mapping
  σ2 = 問題牽涉「固定匯率下的成本」,
       但 agent 沒有工具可以做幣別轉換

α 分類:
  α(σ1) = Content   (缺的是概念本身,內容層的缺口)
  α(σ2) = Tool      (缺的不是概念,是執行能力,工具層的缺口)
圖上同時特別標註「No schema-level issue identified」:這一輪分析下來沒有訊號被判給 Schema,代表既有的節點型別與合法關係規則沒有問題,純粹是內容與能力不夠。
先分類「屬於哪一層」的重要性在於,才不會拿錯的層級去修問題,例如把明明是工具不夠的問題,誤判成「加個新概念就好」。這個設計到底值多少,後面 ablation 的數字會給出具體幅度。
5.2 Patch:一次候選修補只能動一層
針對歸因完成的訊號,真的動手生出一個修補方案,規則是一次候選修補只能動一層。
論文原文:“For an attributed signature , the agent proposes . Each candidate modifies one level only.”
| 符號 | 中文白話 |
|---|---|
| 已歸因完成的訊號(例如「缺 Channel 概念」) | |
| 歸因結果(例如 Content) | |
| 生成修補方案的函式,輸出一個候選新狀態 | |
| 候選新狀態;加了一撇,代表還沒被正式接受,只是提案,要等驗證通過才會變成正式的 |
三種介入方式各自能動的範圍:
- Content 介入:新增、刪除或修改 Content Layer 裡已經實例化的語意物件(Term、Mapping、Constraint、Evidence 或它們之間的邊)。
- Tool 介入:修改既有工具,或新增、刪除工具(),依據觀察到的 agent 實際行為決定。
- Schema 介入:修改 Schema Layer 的物件模型本身,也就是節點型別的欄位定義與合法的關係種類。
補充一點:如果一個假設需要好幾個互相依賴的 Content 物件才能完整實現,這些物件可以一起更新,這不違反「一次只動一層」,因為它們都屬於 Content 這同一層。前面卡牌合法性的案例就是這樣:新增 Term 的同時,也一起新增了它的 Mapping 與 Evidence。
接續上面的例子,看候選長什麼樣子(圖 2 的「Patch the Parent Ontology」區塊,左邊是父版本 Ontology v1,右邊的 Candidate Ontology 比左邊多了兩個東西):
[σ1:缺 Channel 概念]   α 判定 Content → patch:新增 Term:Channel + Mapping(dim_channel.channel_name)
[σ2:缺幣別轉換能力] α 判定 Tool → patch:新增 Tool 3: FX Convert + Constraint("Currency basis=Constant USD")這是兩個各自獨立的候選修補,一個動 Content、一個動 Tool,不會合併成同時動兩層的修補。
5.3 Gate:候選要在同條件下贏過父版本至少 τ 分才轉正
候選方案不等於會被採用。系統把候選與「還沒改之前的版本」放在完全相同的條件下比一次,贏得夠多分才准轉正。
先定義一個詞:backbone(骨幹模型) 指驅動這個 agent 的底層 LLM 本身,例如 GPT-5.5、Claude-Sonnet-5。公式裡之所以要特別標記 backbone,是因為同一個 ontology 候選,換一個 LLM 來用,表現可能不一樣。
論文原文:“For backbone , let denote the score of ontology state on validation set . The candidate and its parent are evaluated on the same with identical decoding and interaction budgets. The candidate is retained only when its improvement reaches margin .”
白話版:候選和目前正式生效的版本,拿同一份驗證題目、同樣的設定各跑一次;候選的分數要比現在的版本高出至少 ,才會取代它,否則維持原狀。
| 符號 | 中文白話 |
|---|---|
| 打分函式:某個 ontology 狀態 ,配上驗證集 與 backbone ,表現多好 | |
| 驗證用的題目集合,從訓練 workload 切出來、專門保留給驗證用的那份 | |
| 候選版本 | |
| 父版本(目前正式生效的版本) | |
| 門檻值,候選要贏過父版本至少這麼多分才算通過 | |
| 下一輪正式生效的版本 |
「paired(配對)」的重點是:候選與父版本用完全相同的 、完全相同的取樣設定、完全相同的互動輪數上限去跑。把其他變因全部鎖死,讓分數差異只可能來自 ontology 改了什麼。
帶入數字走一次( 是假設值,論文未公開實際門檻):
候選1(新增 Channel):  φ(L_t)=70, φ(L'_t)=78, 差距 8 ≥ τ(5) → 通過
候選2(新增 FX Convert):φ(L_t)=70, φ(L'_t)=73, 差距 3 < τ(5) → 拒絕圖 2 的「Evaluate and Gate the Candidate」區塊是這樣畫的:中間是天平圖示,Evaluate 之後分兩條路。Accept 路徑讓候選正式轉正、版本號加一;Reject 路徑回到修補前的版本,但事情不會就此打住,而是進入新一輪 Evolution Loop,回到 Diagnose 重新開始。
5.4 候選逐一處理,被拒絕的也會留下紀錄
接下來有一個容易想歪的地方:照論文的公式,候選是逐一處理的,每一輪只對應一個訊號、一個候選。為什麼不會有多個候選同時過關?展開看論文的機制設計與佐證。
你可能會想:如果同一輪有好幾個候選都過了門檻,系統選哪一個?照論文的機制設計,這個情境不會發生。 回頭看公式,patch 吃進去的是一個 ,吐出一個候選,gate 比的也是這一個候選與它的父版本,從頭到尾都是一對一。公式裡沒有「多個候選同時通過,選哪個」的選擇機制。
佐證有兩個。一是論文演化輪次分析的圖說明(原文:“Each round corresponds to one candidate that passed the paired gate”),明講每一輪對應恰好一個通過的候選。二是實驗一節的圖 5:Tool 6 輪加 Content 11 輪加 Schema 3 輪,共 20 輪,正好等於被接受的總輪數,也支持這個讀法。所以候選是逐一輪次處理,不是批次競爭:
第 t 輪:  父版本=L_t(未修補) → 處理 σ1 → 候選 L'_t → 驗證通過 → L_{t+1}=L'_t(已加 Channel)
第 t+1 輪:父版本=L_{t+1}(已有 Channel) → 處理 σ2 → 候選 L'_{t+1} → 驗證沒過 → L_{t+2}=L_{t+1}(不變)
第二輪拿來比較的父版本,是已經吸收了第一輪修補結果的版本,不是最原始的版本。
候選被拒絕之後會怎樣?論文原文:“Rejected candidates are not deployed, and their signatures, interventions, and evaluation outcomes are logged to avoid repeated ineffective updates.”
被記錄的是三樣東西(延續候選 2 失敗的例子):
1. signature(訊號)            → σ2:缺幣別轉換能力
2. intervention(介入內容)     → 「新增 Tool 3: FX Convert」這個候選的完整內容
3. evaluation outcome(評估結果)→ 差距 3 分,沒過門檻 τ=5,被拒絕
為什麼要記?候選被拒絕時,問題其實還沒解決。沒有這份紀錄的話,下一輪 analyze 再次看到類似的失敗案例,系統很可能又生出一個跟上次幾乎一樣的候選,又花一次驗證資源,又被拒絕,在同一個死胡同裡繞圈圈。有了紀錄,理論上就能避開已知無效的路。
5.5 把兩輪演化串成一條時間線
兩輪演化放在一起看,示範了三件事:
- 演化迴圈是逐輪推進,不是批次競爭,父版本隨每輪接受的結果更新。
- 同一種修補機制可能成功,也可能失敗。
- 失敗不是終點,問題會留在後續軌跡裡,等下一次機會。
整個自我演化迴圈可以收斂成一句話:先分類問題出在哪,再對症下藥式地局部修補,最後用嚴格的配對實驗決定要不要留下。這跟人工除錯的邏輯很像,只是每一步都被形式化成可以自動跑的機制。
6 實驗結果:主動查詢勝過整包塞 prompt,閘門最不能省
接下來看實驗。下面只保留有支撐力、或改變我們對架構判斷的關鍵數字:這部分我們沒有逐表細讀,判斷是架構層面的思路已經理解清楚,數字本身的增量價值有限。
6.1 主結果:六個 backbone 全贏,整包塞 prompt 反而掉分
三個 benchmark 各自測不同的能力:
- DDR-Bench:開放式資料研究,測 message-wise 與 trajectory-wise 的準確率。
- InsightBench:商業分析,測有沒有找出正確的 insight。
- BIRD:text-to-SQL,測查詢正確率(EX)與效率(VES)。
DDR-Bench 的分數是準確率,越高越好;Message-Wise 與 Trajectory-Wise 在這篇只引用數字,不展開計算方式。另外先分清兩個統計範圍:主結果表(表 1)涵蓋六個 backbone;後面消融實驗的 +20.0,則是只取四個 backbone 的平均。
三組對照則是:Baseline(無 ontology)、Baseline+SL(把 semantic layer 整包塞進 prompt)、EvoOntology。
核心結論是 EvoOntology 在六個 backbone 上全面贏過 Baseline,DDR-Bench 六個 backbone 的平均增益是 +17.8 分(後面 ablation 的 +20.0 是另一個統計範圍:只取四個 backbone 的平均,兩個數字不矛盾)。而 Baseline+SL 常常沒用,甚至倒退:Claude-Sonnet-5 在 Baseline+SL 上的 Trajectory-Wise 反而掉了 15.0 分(表 1)。這組對照是全篇最有力的證據:整包塞 prompt 這條路是錯的,主動查詢才有效。
6.2 Ablation:Gate、Mappings、Tool 層各自貢獻多少
演化迴圈四步驟,拿掉各自掉多少分(DDR-Bench,Traj-Wise,論文 Table 5):
| 拿掉哪個步驟 | 掉分 |
|---|---|
| Gate(驗證閘門) | −11.2(掉最多;沒有閘門,壞的修補進得來、出不去) |
| Attribution(歸因判斷哪一層) | −6.3 |
| Diagnose(找反覆失敗模式) | −4.8 |
| Patch stage(換成自由發揮式重寫) | −1.7 |
三個可編輯層級,限制成只准動一層(論文 Table 6):
| 限制 | 增益 |
|---|---|
| 只准 Tool 層 | +13.2 |
| 只准 Content 層 | +8.7 |
| 只准 Schema 層 | +3.6 |
| 三層都開放(完整版) | +20.0 |
三層互補,不能互相取代。
Content Layer 的物件家族,拿掉各自掉多少分(論文 Table 7;Term 無法單獨遮蔽,所以不在表中):
| 拿掉哪種物件 | 掉分 |
|---|---|
| Mappings(概念接到實際欄位) | −13.4(掉最多) |
| Evidence(觀測佐證) | −8.7 |
| Constraints(業務規則) | −3.5 |
| Relations(語意關係邊) | −2.1 |
結論是 Mappings 與 Evidence 才是 Content Layer 真正的骨幹。沒有 Mapping,概念接不到實際資料;沒有 Evidence,agent 就沒辦法驗證候選的 SQL 片段對不對。
6.3 演化到底跑了幾輪:因 backbone 與 benchmark 而異
論文沒有在正式的實驗設定段落明講「演化了 N 輪之後拿最終版本去評分」,但這個資訊散落在 Analyses 章節裡。
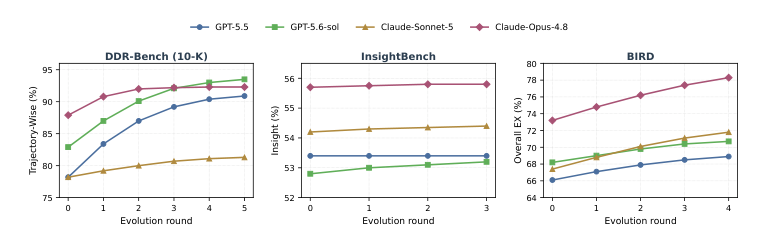
圖 4 顯示 DDR-Bench 跑 0 到 5 輪、InsightBench 跑 0 到 3 輪、BIRD 跑 0 到 4 輪,而且不同 backbone 停在不同輪次。原文明講:“GPT-5.6-sol reaching 93.5 Traj-Wise after five accepted rounds and Claude-Opus-4.8 reaching 92.3 after four.”
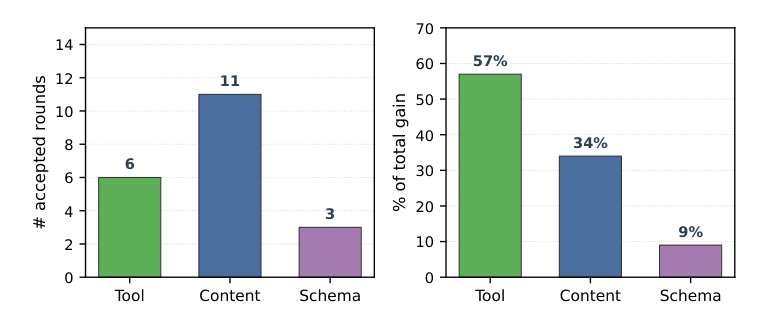
圖 5 是另一個線索:四個 backbone 加總,Tool 層被接受 6 次、Content 層 11 次、Schema 層 3 次,共 20 輪。所以論文有報告輪數,但因 backbone、因 benchmark 而不同,不是固定的超參數。至於什麼時候停,論文說曲線在最後兩輪「flatten(打平)」,原文是 “the trajectories flatten by the last two rounds, which is consistent with the failure signatures becoming rarer”,卻沒有明講這是不是明確的停止規則(例如連續 N 次沒有候選通過就停),還是研究者看趨勢打平就不繼續跑了。
6.4 跨 backbone 遷移:換底層模型,ontology 幾乎要重新演化
這是實驗部分裡,對「這篇論文距離落地還有多遠」最有參考價值的一個發現。同一套流程,換不同 backbone(GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8)各自演化出一套 ontology。把 A backbone 演化出來的 ontology 拿去給 B backbone 用,表現全面下滑,平均掉 6.6(Sonnet-5)到 10.9(GPT-5.5)分,沒有例外。
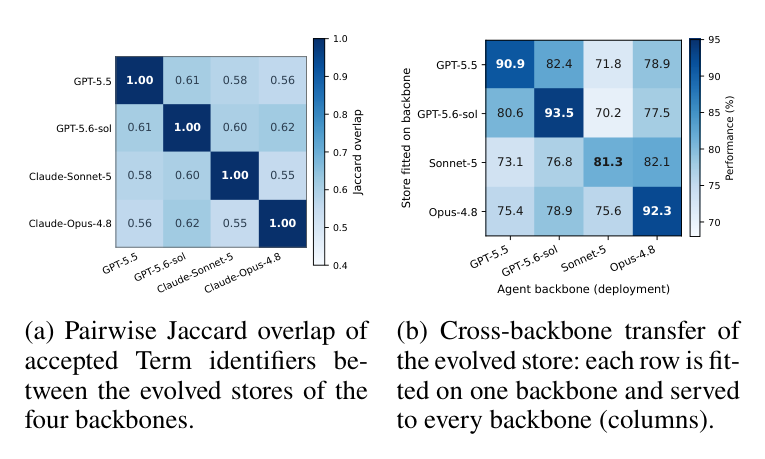
圖 6(a) 顯示不同 backbone 演化出的 Term 集合,彼此重疊並不高:論文指出沒有任何一對超過 0.62,兩個 Claude 之間的重疊(0.55)甚至比兩個 GPT 之間還低。這個意義很直接:這不是一套「建一次、到處通用」的系統。 換底層模型,等於要重新跑一次演化。這是部署時一個實質的成本與限制,論文的摘要沒有強調。
實驗小結:整包塞 prompt 常常沒用,甚至倒退,主動查詢才有效;演化迴圈裡 Gate 的貢獻最大(DDR-Bench 消融);Mappings 與 Evidence 是 Content Layer 的骨幹;換 backbone 就得重新演化。
7 評價:貢獻中等偏架構層面,細節缺口不小
整體來看,研究貢獻中等偏低。核心骨架(結構化知識層、從失敗軌跡歸因、驗證閘門)與同類的「agent 自我演化知識庫或技能庫」論文(例如 WikiSkill,另一篇讓 agent 把執行軌跡蒸餾成可重複使用知識的論文)在架構精神上同構,不是原創突破。比較站得住腳的貢獻有三個:
- 把「三層拆分(Schema、Content、Tool)加上 MCP 包裝」這個具體架構,應用在 agent-data gap 問題上,並證明了「主動查詢優於整包塞 prompt」。Baseline+SL 常常反而讓表現變差,就是最乾淨的證據。
- backbone-conditional paired validation 這個驗收閘門的具體設計:用「候選對父版本,同條件跑同一份驗證集」決定要不要接受修補,相對嚴謹。
- 六個 backbone、三個 benchmark 的實證支持,以及清楚的 ablation 拆解各機制的貢獻度。
但貢獻的天花板不高,因為一路讀下來,我們挖出了一長串方法論沒交代清楚的地方。這些不是枝微末節,而是「這套系統真的能不能落地跑」的核心工程細節:
- 冷啟動與演化迴圈用的是同一批查詢,還是再切分過。
- 同一輪抓出多個訊號時,處理順序怎麼決定。
- 被拒絕候選的日誌,怎麼影響之後的修補。
- 演化的停止規則是什麼。
- 沒有任何實驗拿 schema-driven 的冷啟動來對照,而「沒被問過就永遠學不到」的死角也沒被討論。
另一個很現實的限制是前面提過的:換一個 LLM backbone,演化出來的 ontology 幾乎要重跑一次,無法跨 backbone 遷移。
還有一點關於名字:EvoOntology 自稱 ontology,但沒有前面折疊裡 OWL 那種形式邏輯推理(OWL 這類傳統本體語言可以自動推論,例如從「X 是鳥」推出「X 會飛」)。它的 Content Layer 比較接近一個可以查詢的 typed knowledge graph,是檢索導向,不是推理導向。老實說,「ontology」這個詞在這裡用得有點鬆散。
8 帶得走的收穫:該不該整包塞,看量有多大;自我演化的骨架,閘門先行
不過,這次閱讀最耐用的收穫,不是記住這篇論文的任何一個數字,而是下面幾個彼此有關聯的觀念。
核心原則:知識該不該整包塞給 agent,取決於量有多大。 最乾淨的一組實證,是 Baseline+SL 在多個 backbone 上的表現反而不如完全沒有 ontology 的 Baseline,最極端的是 Claude-Sonnet-5 掉了 15 分。原因不難理解:靜態塞進 prompt 的知識,會與 agent 其他的指令競爭注意力,而且沒辦法按需裁剪。
可以抽象成一句可操作的判準:任何要給 agent 的領域知識,只要量大到可能超出單輪任務需要的範圍,就該做成「agent 可以主動查、按需展開」的工具,而不是無條件塞進系統提示。
知識存好之後,還有兩個組織上的問題,延伸閱讀有細講。第一,規則和事實怎麼分工:ontology 是規則層,knowledge graph 是事實層,規則規範事實。第二,要用扁平的 skill 包還是圖:領域之間有衍生或依賴關係時(例如 Profit 由 Revenue 與 Cost 推導),圖只要把關係定義一次,到處都能沿著走;領域之間幾乎不互相引用時,扁平的 skill 包就夠。這兩個問題是同一條「知識供給設計」思路往下展開的結果,不是互相獨立的知識點。
論文對這個問題給出的具體答案,落在一個更通用的骨架上:自我演化系統的四步循環。 也就是 diagnose(找反覆失敗模式)、attribute(先分類問題屬於哪個子系統)、patch(局部修補、一次只動一層)、gate(配對驗證,候選與父版本同條件比較)。這個骨架的價值不在於是這篇論文原創,而在於每一步都有明確的設計理由,且 ablation 量化了每一步的貢獻。
其中 gate 是整個骨架裡最不能省的一步:沒有它,任何局部修補機制都可能把壞的改動放進系統,而系統本身沒有機制把它撤銷。對任何想做「agent 自我優化知識庫或 skill 庫」的系統,這是可以直接借用的優先順序:先確保有一個嚴謹的驗收閘門,再談怎麼把 diagnose 與 attribute 做細。
最後,前面提過的 Reciprocal Two-Fold(split-and-swap)評估法,是任何「系統會自動修改自己」的場景都該採用的驗證框架:把資料切兩半互為訓練與測試,取平均分數,避免用同一批資料又建置又評估而造成樂觀偏誤。
回到這篇的主線:EvoOntology 想解決的是 data agent 事前不認識資料、每次都要重新摸索的問題,做法是在 agent 與資料之間放一層可查詢、會演化的 ontology,由 Schema、Content、Tool 三層組成。實驗上最乾淨的結論是:主動查詢勝過整包塞 prompt,而演化迴圈裡最不能省的是驗證閘門。
論文本身的原創性有限,方法論也留下不少沒講清楚的細節,換 backbone 就得重新演化,更是部署上的實質成本。不過「診斷、歸因、局部修補、配對驗證」這個骨架,以及 split-and-swap 的評估方式,脫離這篇論文也值得帶走。
- 試:下次替 agent 準備領域知識,先估一下量有多大。量大的,做成它能按需查詢的窗口(manifest 加 browse、resolve),不要整包塞進 prompt。
- 先做閘門:自己做自我優化的系統時,先寫好候選與父版本同條件配對比較的驗收,再回頭把診斷和歸因做細。
- 存疑:EvoOntology 是值得借用的設計,不是建一次到處通用的系統;換 backbone 要重新演化,冷啟動與停止規則等細節也要自己補上。
9 延伸閱讀:幾個脫離這篇論文也成立的概念
這一段收錄的是討論過程中被追問、釐清,甚至修正過的通用概念。它們脫離這篇論文本身也成立,是這次閱讀真正最有價值的部分。只想看論文本身的讀者,可以跳過這裡,上面的評價與收穫已經是完整的結論。
9.1 Ontology 與 Knowledge Graph 到底差在哪
修正後的框架是:兩者都可能是圖,差別在圖的表達力與涵蓋範圍。
- 邊的種類:dbt 的圖只有一種語意,「算式依賴」。EvoOntology 的邊有五種語意(derivation、association、hierarchy、composition、equivalence),能表達的關係結構豐富得多。
- 節點的範圍:dbt 的節點限定在指標(metric)與維度(dimension),天生綁死在結構化表格上。EvoOntology 的節點可以是任何領域概念,還把 Constraint 與 Evidence 都做成一等公民,不只是外掛的註解。
再看傳統知識表示領域怎麼分 Ontology 與 Knowledge Graph:
| 比較項目 | Ontology | Knowledge Graph |
|---|---|---|
| 講的是什麼層次 | 規則層:定義有哪些類別、類別之間怎麼關聯才合法 | 事實層:實際存在的具體資料點 |
| 程式類比 | class diagram 或 database schema | 資料庫裡實際的 row |
| 有沒有邏輯推理 | 通常有(像 OWL) | 通常沒有,就是存好的事實圖 |
兩者的關係是:Knowledge Graph 通常是「依照某個 Ontology 的規則,把實際資料填進去」的結果。而 EvoOntology 自己的架構,剛好同時包含這兩層:
- Schema Layer 是 Ontology 那一半:定義有哪些節點類型、哪些關係類型合法。
- Content Layer 是 Knowledge Graph 那一半:實際填進去的 Cost、Revenue、Profit 等 Term,以及它們的 grounding。
- 前者規範後者。
所以論文標題叫 ontology 並不是亂用:Schema Layer 真的在扮演傳統意義上 ontology 的角色,Content Layer 則是照著這套規則長出來的 knowledge graph。
9.2 Skill-per-domain 與 Ontology-graph:怎麼選
很多實務上的 agent 系統(例如替不同領域各寫一份 skill,每個 skill 綁定該領域的 schema 與知識)和這篇論文的 ontology 做法,屬於同一個大類別:都是把散落的領域知識結構化,讓 agent 查得到。差別在組織方式。
| 比較項目 | Skill-per-domain | Ontology-graph(EvoOntology) |
|---|---|---|
| 組織單位 | 一個 skill 就是一個領域的完整包(schema 與領域知識綁在一起) | 一個 Term(概念)就是一個節點,概念之間用 typed edge 連起來 |
| 取用方式 | 依問題標記對應哪個 skill | agent 主動呼叫 browse、resolve 兩個工具,查詢單位是概念,不是整包 skill |
| 跨領域關聯 | 弱:skill 之間預設互不相干,要跨領域通常得手動兜起來 | 強:Term 之間可以是 association、hierarchy、composition、derivation 等關係,例如 Profit 直接連到 Revenue 與 Cost,agent 可以沿著關係走過去 |
可以遷移的判斷規則是:
- 領域之間幾乎不互相引用(例如「文件解析」skill 與「排程」skill 沒什麼關係),用 skill-per-domain 這種扁平做法就夠,維護也簡單。
- 領域之間有衍生或依賴關係(例如某個指標要組合好幾個不同來源的欄位與規則),圖狀結構的優勢就會顯出來,因為關係定義一次,到處都能沿著走,不用在每個用到的地方重複兜同一套推導邏輯。
這也連到自我演化系統的設計。前面的 ablation 顯示,拿掉 gate 與 attribution 是掉分最多的兩項,它們對應任何「skill 自動優化」系統都要面對的核心問題:怎麼判斷一次修改是不是真的變好、要不要接受,以及修補前要不要先分類問題屬於哪一類。EvoOntology 的閘門設計(候選與舊版本用同一組留出的驗證集、同樣的取樣與互動預算各跑一次)是一個具體可以參考的做法,細節見前面「驗證閘門」一節。
9.3 跟 WikiSkill 比:知識要先蒸餾再交付,還是讓 agent 直接查活的結構
WikiSkill 是我們之前讀過的另一篇自我演化知識系統論文,架構是 Raw Layer(原始軌跡)、Wiki Layer(整理過的中間知識)、Skill Layer(最終交給 agent 的技能文件)三層。它處理的是同一個大問題:怎麼把 agent 執行過程中的原始軌跡,蒸餾成日後可重複使用的知識。但在一個關鍵軸線上,它與 EvoOntology 站在兩端:中間那層知識結構,到底有沒有直接曝露給執行任務當下的 agent。
| 比較項目 | WikiSkill:先蒸餾、再交付 | EvoOntology:不蒸餾,直接查活的結構 |
|---|---|---|
| 軌跡怎麼處理 | 軌跡先進維護用的 Wiki(優化過程的工作台),再蒸餾成 Skill(最終產物) | 軌跡直接修補進 ontology 本體(Content、Tool、Schema) |
| 執行期 agent 看到什麼 | 只看 Skill,完全不碰 Wiki | 每次都透過 Tool Layer 即時查詢 ontology 本身 |
WikiSkill 的設計是刻意的,不只是訓練期的臨時限制:執行期 agent 在 inference 階段確實只讀 Skill,完全不接觸 Wiki,這貫穿訓練與部署兩個階段。EvoOntology 則沒有一個獨立的「最終文件」,agent 看到的資料形態,與系統儲存的資料形態是同一個東西。
這其實是前面「Skill-per-domain 與 Ontology-graph:怎麼選」那個框架再往下一層的軸線:不只是知識怎麼組織(扁平包或圖),還有知識怎麼交付給執行期的 agent(蒸餾成一份文件、只露出最終產物,或讓 agent 直接查活的結構、完全不封裝)。兩者各有道理:
- 封裝可以避免 agent 在推論時被中間過程的雜訊干擾。WikiSkill 的消融實驗顯示,讓 agent 直接碰 Wiki 反而讓最終品質下降。
- 不封裝則保留了「知識還在持續演化、agent 每次都拿到最新版本」的即時性,不需要一個明確的「蒸餾完成」時間點。