Is Bash All You Need?只給 agent 一個 shell,比整套專用工具更準又更省
 Hong-Wei Wu
收錄於 論文介紹
1 只給 agent 一個 shell,分數反而更高
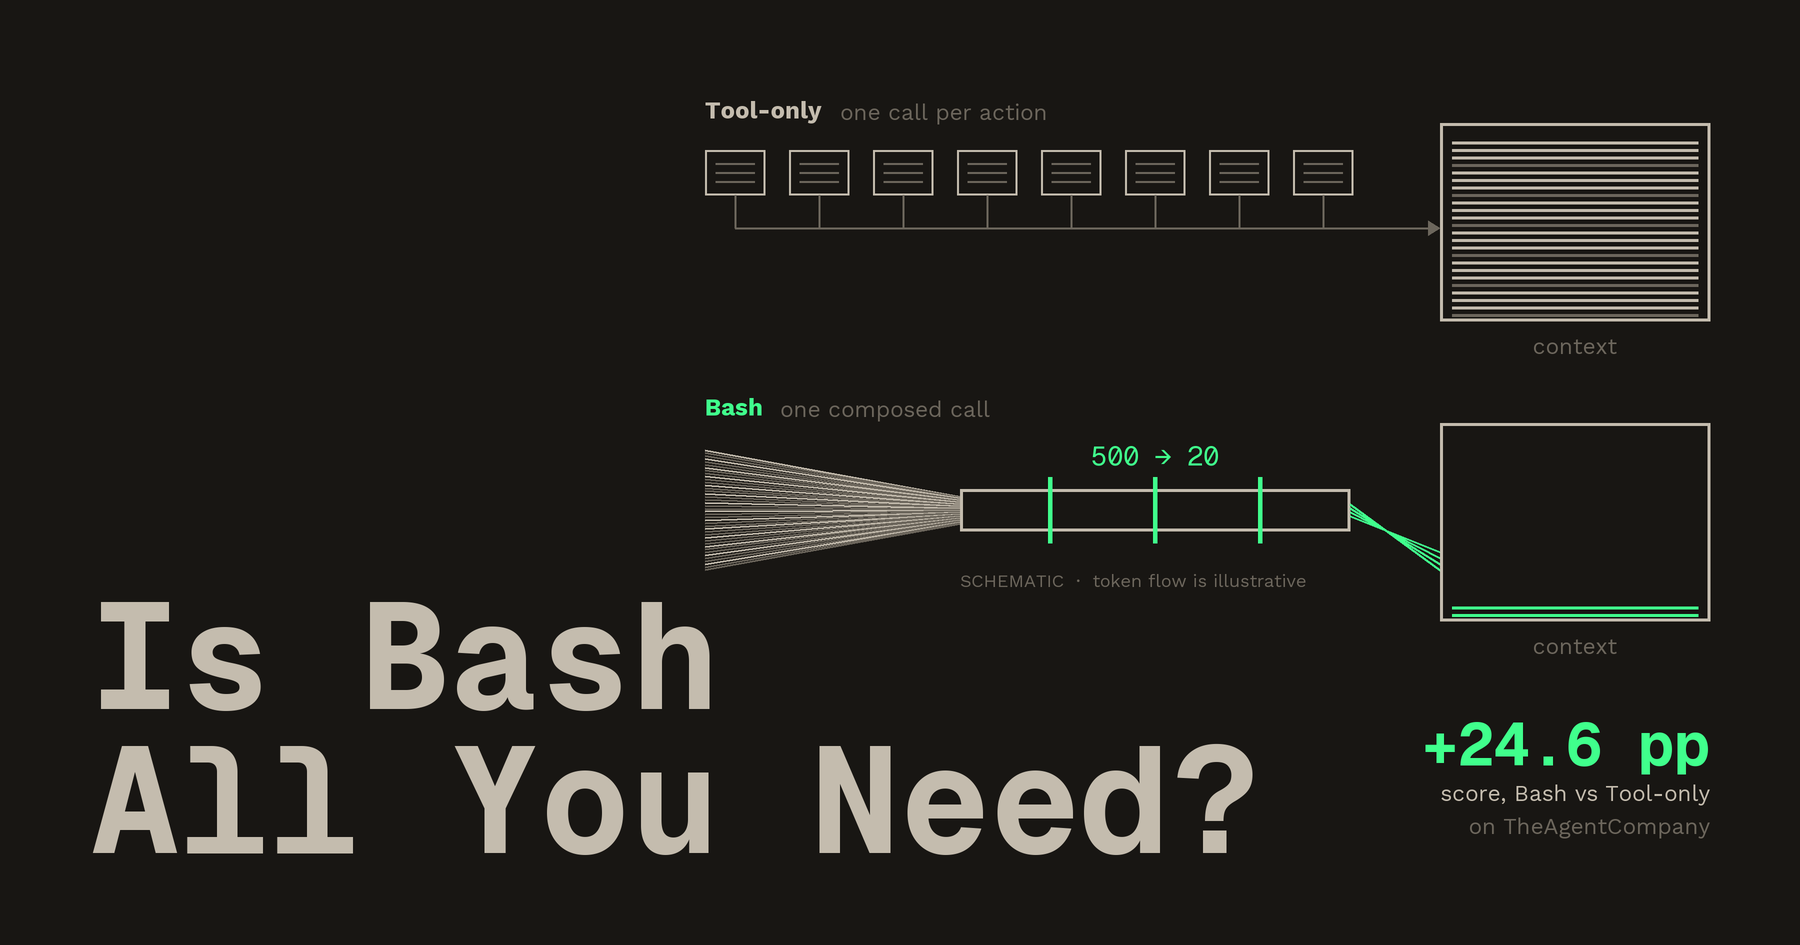
要讓企業 agent 去操作 GitLab、聊天室、試算表這類環境,工具該怎麼給?直覺上,一套預先設計好的專用工具,應該比丟一個命令列給它更穩、更安全。這篇論文把五種給法放進同一個受控設定裡比較,結果反過來:只給 agent 一個 bash shell,在兩個企業工作 benchmark 上分數反而更高,而且用更少 token(模型讀寫文字的計費單位)。在 shell 之上再加專用工具,或讓 agent 自己造工具,都沒有偵測到分數增益。
論文比的是工具介面(tool interface),也就是 agent 用什麼方式對環境下動作。一端是 typed tool:預先定義好名稱與參數格式的函式,例如 gitlab_create_issue,模型一次呼叫一個;另一端是直接給一個 bash shell(命令列),讓模型自己寫指令。中間還有幾種折衷,論文一共比了五種。實務上兩條路都有人走,但受控的對照證據很少。
差距有多大?Bash 對比只有 typed tools,分數在 TheAgentCompany(模擬軟體公司的 benchmark)高 21.8 到 24.5 個百分點(pp),在 APEX-Agents(模擬投資銀行、顧問、法務專業分析的 benchmark)高 4.8 到 7.4 pp,每題總 token 少 19% 到 72%。分數本身就是百分比,所以差距用百分點表示;這些範圍是從論文的完整結果表逐格相減得到的。
中間的折衷之一是 PTC(Programmatic Tool Calling,程式化工具呼叫:模型寫一小段程式,程式只能呼叫預先定義的工具)。它比只給 typed tools 省 token,分數大致持平,整體輸給 Bash。
論文的實務建議是條件式的:能把任意程式碼執行隔離起來,就用 Bash;合規要求只能用固定工具目錄,就用 PTC。
論文:Is Bash All You Need? An Empirical Study of Tool Interfaces for Enterprise Digital Worker Agents(Microsoft、CMU,arXiv 2609.11999v1,2026-09-10)。論文沒有提出新方法,價值在於把五種介面放進同一個受控設定裡比較。
2 企業 agent 的工具該怎麼給:兩條路各有代價
agent 是讓大型語言模型(LLM)反覆「想 → 呼叫工具 → 讀結果」直到完成任務的系統,每一輪都要把前面的對話重新讀一遍。給它哪種工具介面,決定了它能做什麼、多安全、多貴;「貴」在論文裡用 token 數與估算的美元成本來量。後面的 APEX-Agents 環境用 MCP 伺服器提供應用程式:MCP(Model Context Protocol)是把外部服務包成「模型可呼叫工具」的標準做法(一般知識,不是論文內容)。
- Coding 領域已經有先例:在寫程式的 agent 裡,mini-SWE-agent 只給 bash,Live-SWE-agent 則讓 agent 自己造工具,還登上過 SWE-bench Verified(寫程式 agent 的評測排行榜)榜首。
- 企業產品兩條路並存:Anthropic 與 OpenAI 的 API 提供 PTC(受限在固定工具目錄內);Claude Code、Codex CLI、Microsoft Copilot Studio(底層是 GitHub Copilot CLI)走 shell 路線。
- 缺口:企業工作要在多個應用之間切換、跟同事溝通、做專業分析,和寫程式不一樣,而 shell 對 typed tools 的受控比較在這類場景很少,實務者沒有證據可選。同期有一篇 Patel et al. 2026(The Bitter Lesson of Tool Calling)比較了 PTC 與一般 JSON 工具呼叫,但沒有納入 shell。
兩邊各有代價:
| Shell | Typed tools | |
|---|---|---|
| 好處 | 一步可以做很多動作 | 只暴露被授權的函式,安全可控 |
| 代價 | 任意執行需要控制執行環境與存取範圍 | 每個動作各自一次呼叫,累積起來有額外開銷 |
以下三題是我依論文的 Introduction 與 Method 整理的,後面的實驗結果就照這三題走:
- Q1:只給 shell,能不能贏過只給 typed tools?
- Q2:在 shell 之上再加 typed tools,或讓 agent 自造可重用的工具,有沒有額外好處?
- Q3:PTC 這個折衷方案的表現如何?
3 怎麼比才公平:同一個模型、同一份任務,只換 agent 的雙手
論文作者用同一個模型、同一份任務文字、同一份基礎 prompt、同一套停止條件,只改變「agent 能怎麼動手」,藉此隔離出介面本身的影響。測試的模型是 Opus-4.8 與 GPT-5.5,推論設定用預設的推理強度。agent 迴圈由 GitHub Copilot SDK 提供,它的預設工具集與 system prompt 都被覆蓋掉了(論文 Appendix A)。
3.1 五種工具介面
下圖畫出五種介面的結構:它們分別由 shell 執行、typed tools、持久的自造工具,以及只能呼叫 typed tools 的受限程式組合而成。
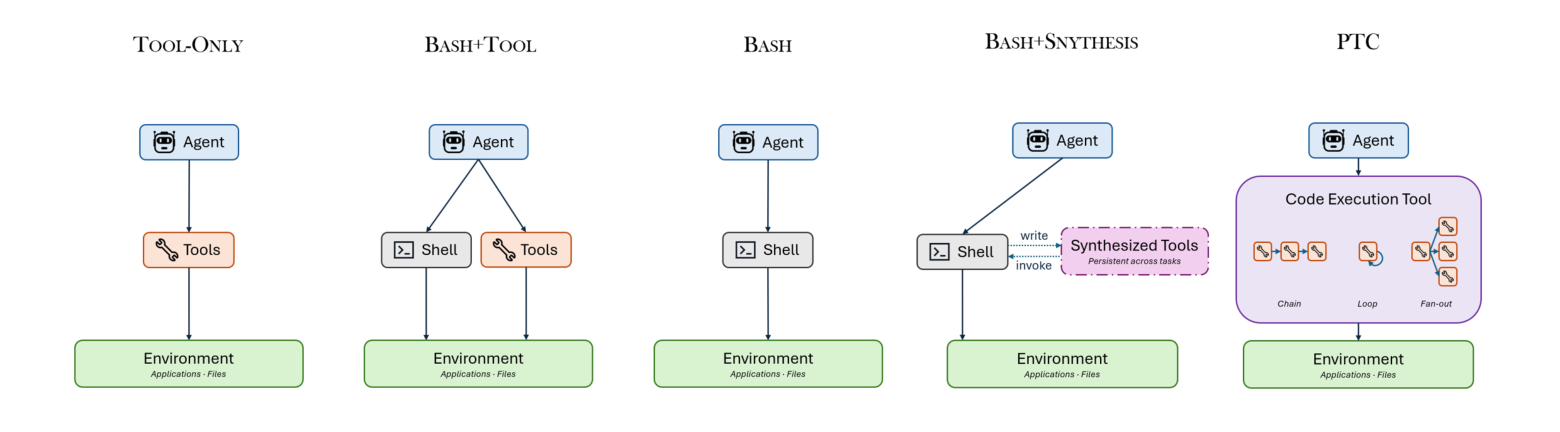
| 介面 | agent 手上有什麼 | 特別之處 |
|---|---|---|
| Tool-only | 只有 typed tools | 每個動作一次獨立呼叫,是基準線;只暴露被授權的函式,安全可控 |
| Bash | 只有 shell | 可以用 pipe(\|,把前一個指令的輸出接給下一個)、迴圈把多個動作串成一次呼叫;彈性最大,但任意執行需要另外做隔離與權限控管 |
| Bash+Tool | shell 加 typed tools | 兩者並存,agent 自己選 |
| Bash+Synthesis | shell 加一個持久資料夾 | prompt 鼓勵 agent 把常用步驟寫成可重用腳本,後續任務直接呼叫,藉此減少重新摸索的成本;任務依序執行,資料夾會保留 |
| PTC | 模型寫 Python,程式裡只能呼叫 typed tools | 介於兩者之間:保留固定工具目錄,又能 loop、串接、平行批次處理;但沒有 shell,也沒有其他能碰到環境的管道 |
只有 Bash+Synthesis 與 PTC 額外加了介面專屬的 prompt 指示,其餘介面共用同一份基礎 prompt。
3.2 同一件事,三種介面各怎麼做
用一個自編例子看三種介面的差別。任務:找出某個 GitLab 專案裡,標題含「bug」的 open issue 標題。假設專案有 500 個 open issue,其中 20 個符合。看的重點是:每種做法有多少資料回到模型的上下文(模型每一輪讀入的全部文字,包含之前每一輪的工具結果)。
【Tool-only】
 turn 1: 呼叫 gitlab_list_issues(project="p", state="opened")
         -> 500 筆 issue 的完整內容全部回到模型的上下文
 turn 2: 模型自己從這 500 筆裡挑出符合的標題,寫成答案

【Bash】
 turn 1: bash("curl -s $GITLAB/api/.../issues?state=opened | jq -r '.[].title' | grep -i bug")
         -> 只有 20 行標題回到上下文

【PTC】
 turn 1: 模型送出一段 Python:
         issues = gitlab_list_issues(project="p", state="opened")   # 500 筆,留在程式裡
         hits = [i["title"] for i in issues if "bug" in i["title"].lower()]
         print(hits)                                              # 只有 20 個標題回到模型
這個例子顯示 PTC 與 Bash 的共通點:中間結果留在模型之外,只把整理好的輸出交回來。論文把 PTC 省 token 歸因於這個機制,但措辭是「可能」(These savings may reflect…),屬於論文作者的推測,沒有直接驗證。為什麼這樣能省 token,文末延伸段落有完整的推導。
記住這個例子:500 筆對 20 行。後面看到 Bash 和 PTC 省 token 時,會反覆回到它。
3.3 兩個企業工作 benchmark,typed tools 來源不同
兩個 benchmark 的環境如下圖:TheAgentCompany 有 4 個自架服務、一個本地工作區,以及透過 RocketChat 聯絡的 17 位模擬同事;APEX-Agents 有 9 個 MCP 伺服器共用一個工作區,任務分布在 33 個情境世界。
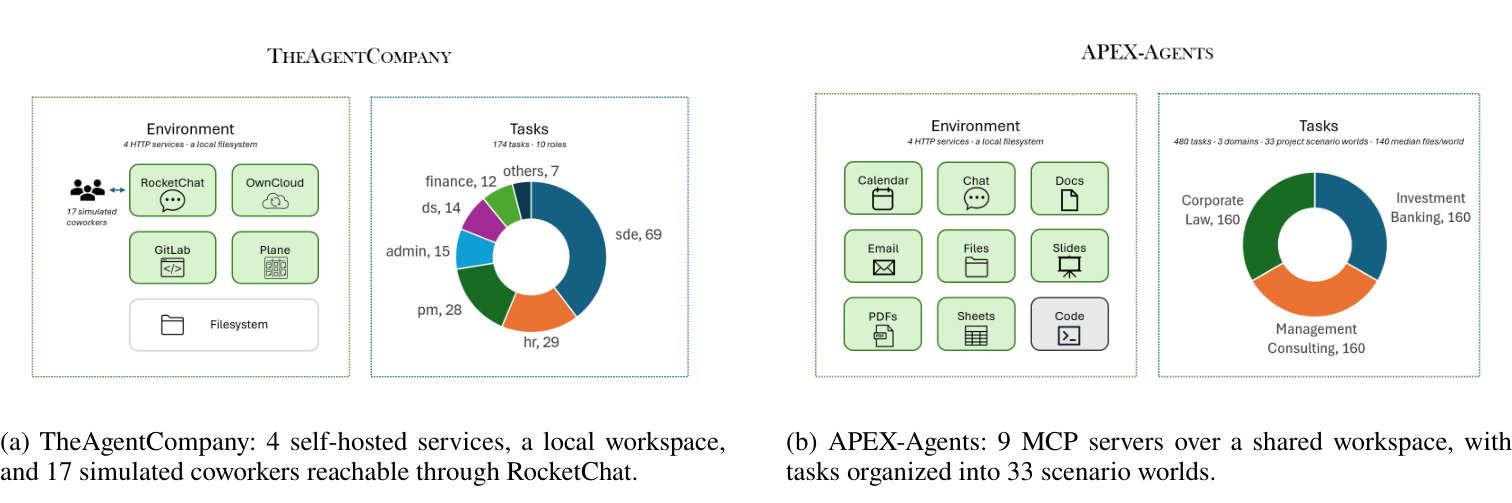
| TheAgentCompany | APEX-Agents | |
|---|---|---|
| 模擬什麼 | 軟體公司:跨 GitLab、RocketChat(聊天)、ownCloud(雲端硬碟)、Plane(專案管理)做事,加上本地檔案 | 投資銀行、管理顧問、公司法務的專業分析:合約審查、試算表估值、問卷整併 |
| 任務數 | 174 題(軟體工程 69、人資 29、專案管理 28、行政 15、資料科學 14、財務 12、其他 7) | 480 題,三個領域各 160 題,分布在 33 個情境世界 |
| 同事 | 17 位由 GPT-5 扮演的模擬同事,透過聊天室互動 | 無 |
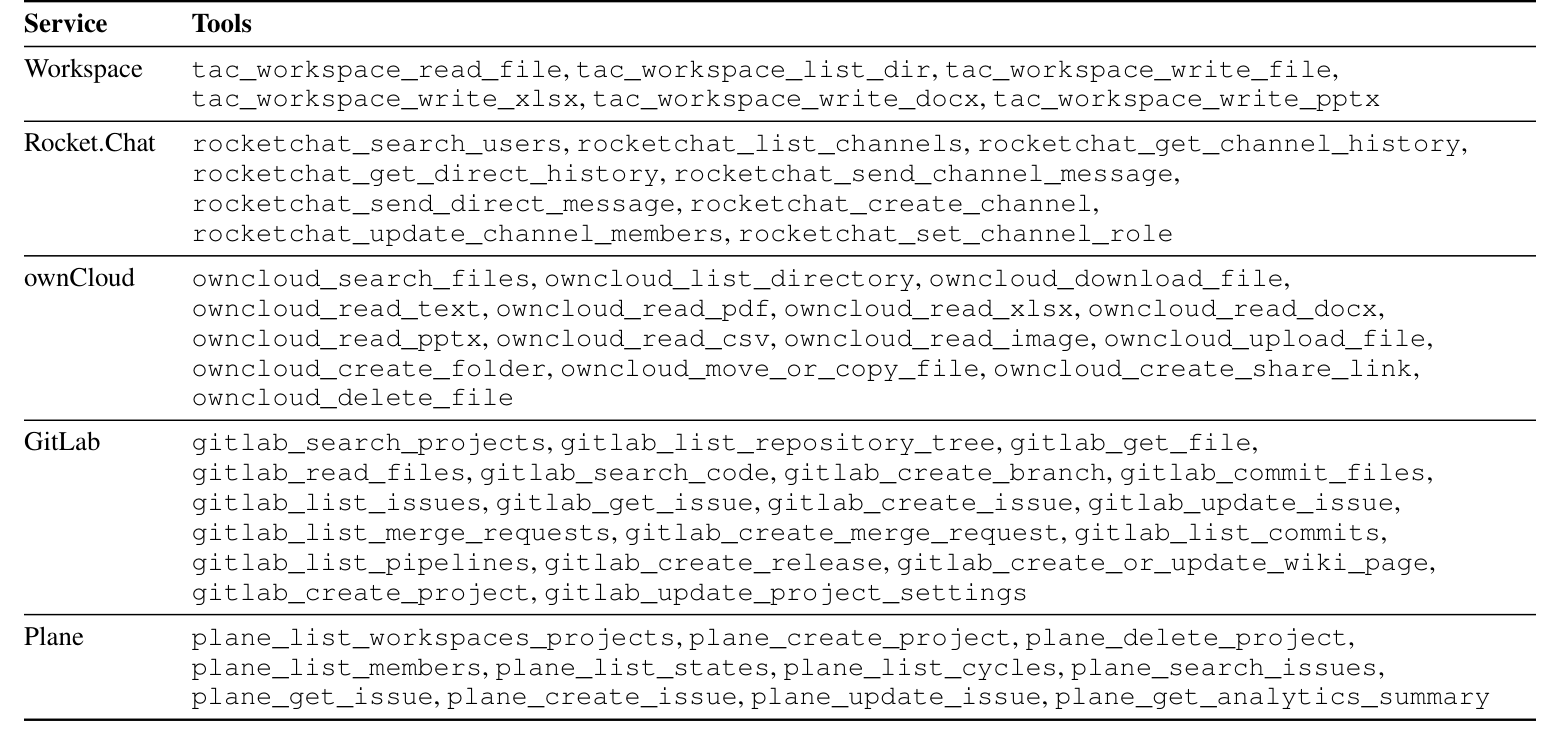
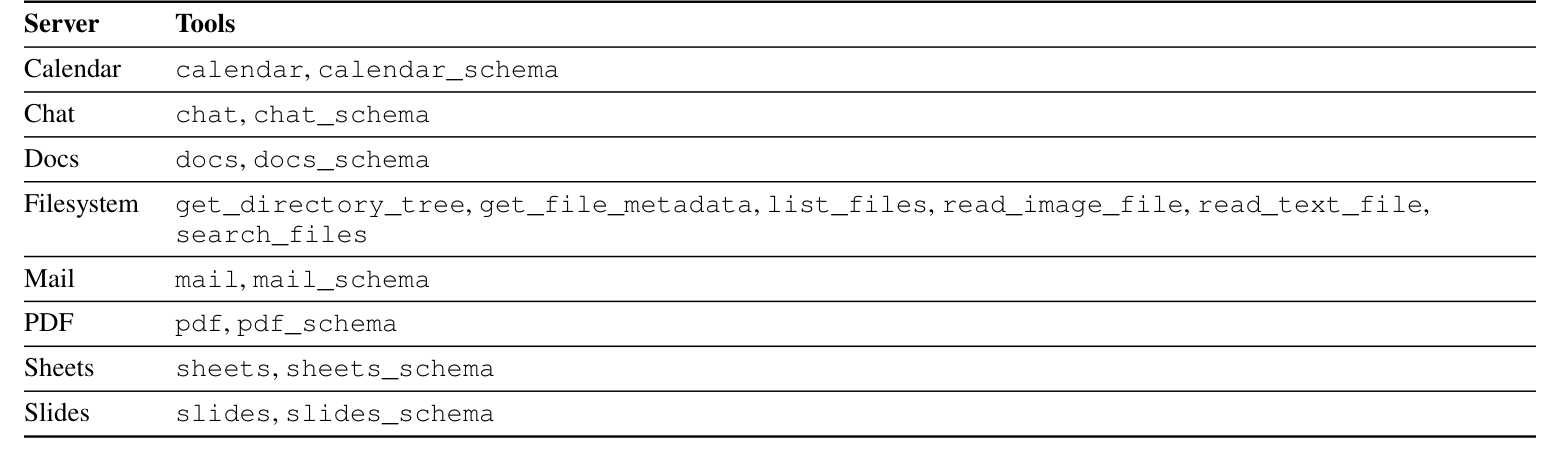
| typed tools 從哪來 | benchmark 沒有現成的,論文作者自己設計 60 個(54 個服務工具加 6 個工作區檔案工具) | benchmark 原有的 20 個,分屬 8 個非 shell 伺服器 |
| Bash 從哪來 | 直接給 shell | 用該 benchmark 的程式碼執行伺服器:有檔案系統限制、環境變數清除、執行上限的 Unix shell |
| 評分 | 各任務的 Python 檢查點程式 | LLM 評審依 rubric(評分標準)逐條檢查最終回覆與工作區檔案變更 |
| 環境版本 | 修補了同事模擬的可靠性缺陷(漏訊息、提早結束、狀態過期),對所有介面一體適用 | 固定使用 2026-06 的環境快照(Archipelago,9 個 MCP 伺服器),避開較新版本的付費金融資料 API |
兩邊的工具清單論文都列在附錄。TheAgentCompany 的 60 個按服務分組如下:
APEX-Agents 的 20 個工具是 benchmark 原有的。除了檔案系統伺服器之外,每個伺服器都由一個「動作分派工具」搭配一個「schema 工具」組成。
3.4 agent 會鑽評分漏洞:Bash 的高分是在額外防護下測的
另一個細節:這裡的絕對分數不能和公開排行榜比。APEX-Agents 官方排行榜用最大推理強度與較新的伺服器快照,這裡用預設推理強度與舊快照(Appendix B.2)。
3.5 怎麼算分:分數、通過率、token 與配對差
後面的表格會用到這幾個指標:
| 指標 | 全名與定義 | 量的是什麼 |
|---|---|---|
| Score(分數) | TheAgentCompany:依工作量加權的檢查點通過率;APEX-Agents:rubric 條目滿足的平均比例 | 任務完成程度。兩個 benchmark 算法不同,不能直接互比 |
| Pass rate(通過率) | 完全解決的任務比例(全部檢查點或全部 rubric 條目都達標) | 完成得多徹底 |
| Total tokens | 每題平均的輸入加輸出 token(輸入含快取讀取,也就是重複送出、以較低單價計費的那一段前綴) | 讀寫的文字量 |
| 每題成本 | 依 GitHub Copilot 公開價目估算的每題推論成本(美元) | 花多少錢 |
| 配對分數差(pp) | 同一題、同一模型、兩種介面的分數相減,再對所有題取平均 | 兩種介面的淨差距;pp 是百分點 |
| 95% bootstrap 信賴區間 | 從配對任務重複抽樣、重算平均差,看結果散布的範圍;先粗略理解成「這個差距大概落在多大的範圍」 | 這個差距有多不確定,細節見文末延伸段落 |
4 Bash 對 Tool-only:四組設定全部同向
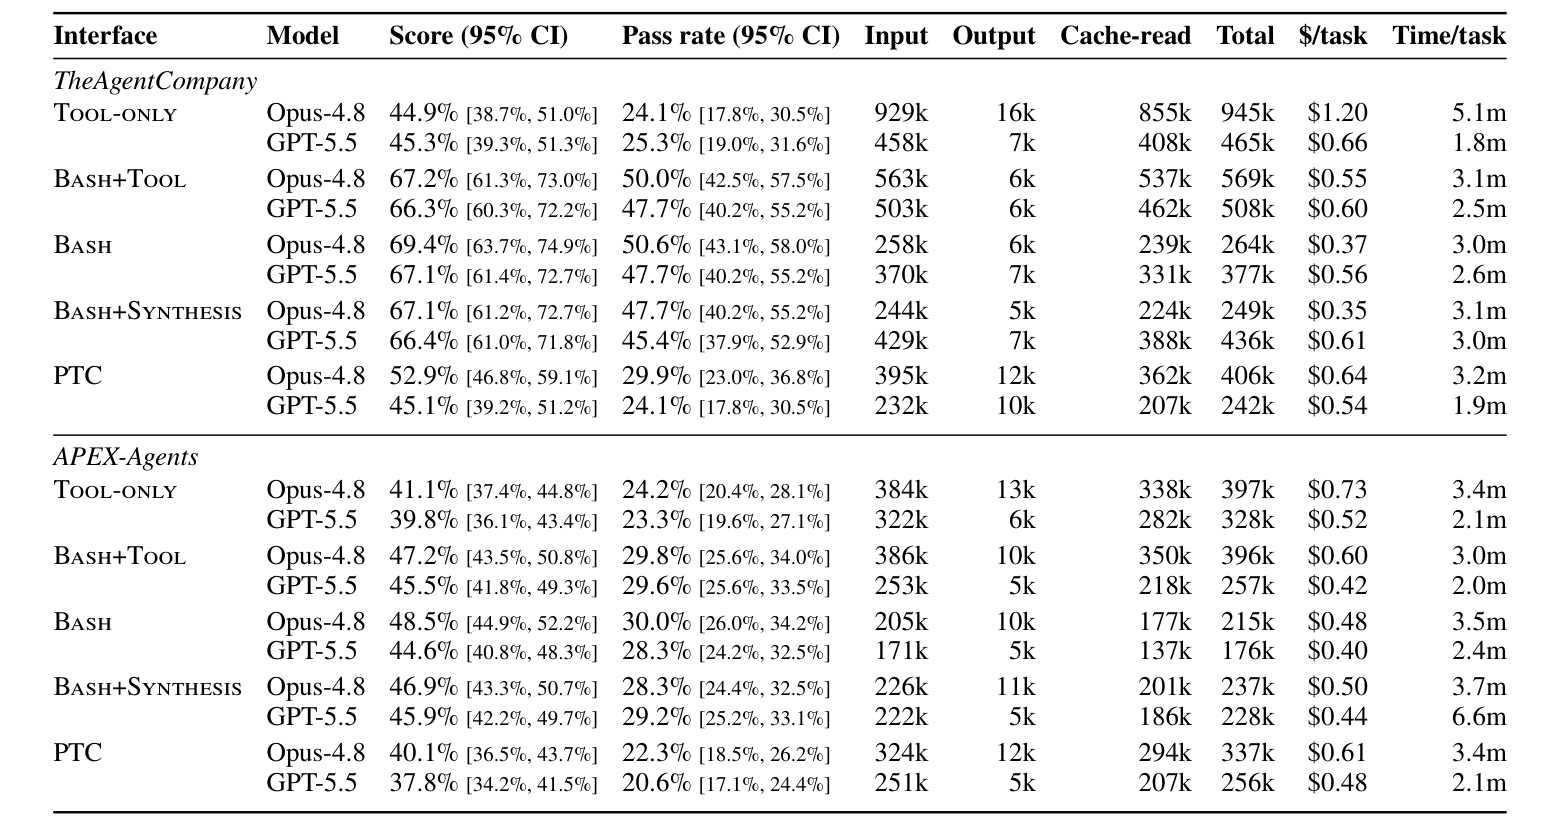
Q1 到 Q3 的答案,都是從論文兩張總表逐格取出來的:表 1 是 5 種介面乘 2 個模型乘 2 個 benchmark 的全部結果,表 9 是配對分數差。先把分數對總 token 數畫在一起(token 為對數刻度),越靠左上越好:
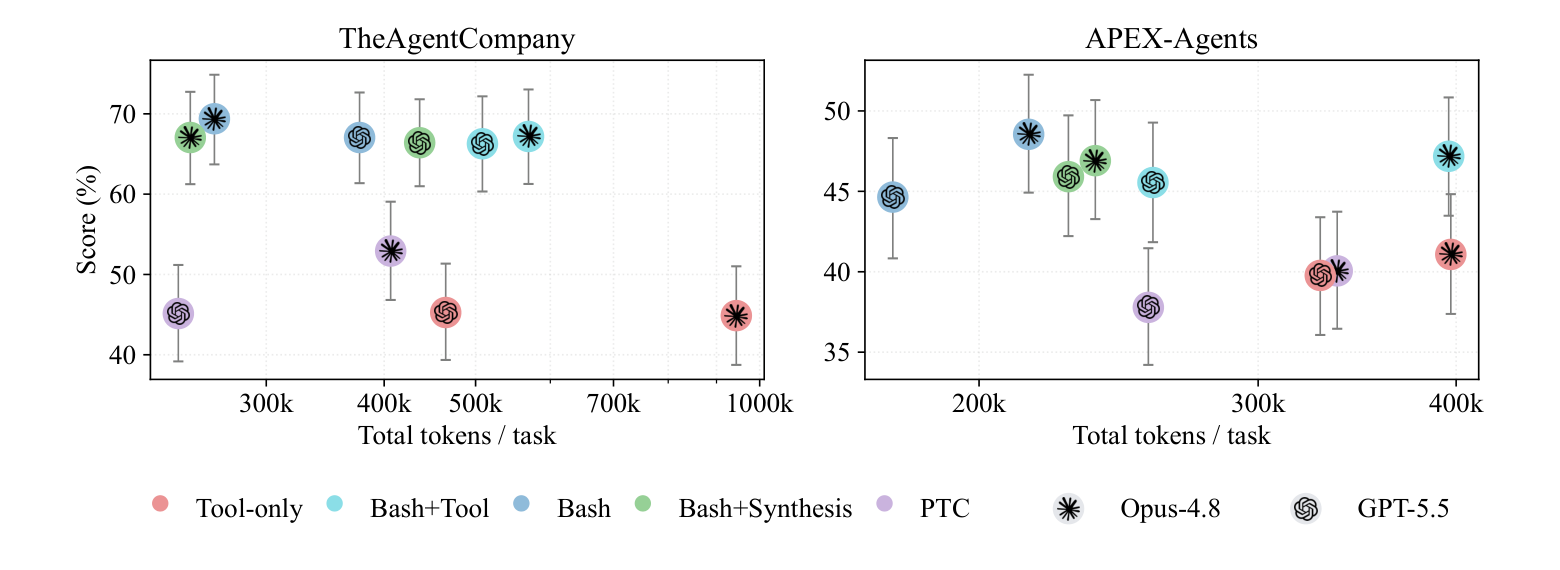
Q1 是最單純的對照:Tool-only 換成 Bash,其他都不變。下表箭頭左邊是 Tool-only,右邊是 Bash。
| Benchmark/模型 | Score | Pass rate | Total tokens | 每題成本(美元) |
|---|---|---|---|---|
| TheAgentCompany/Opus-4.8 | 44.9% → 69.4% | 24.1% → 50.6% | 945k → 264k | 1.20 → 0.37 |
| TheAgentCompany/GPT-5.5 | 45.3% → 67.1% | 25.3% → 47.7% | 465k → 377k | 0.66 → 0.56 |
| APEX-Agents/Opus-4.8 | 41.1% → 48.5% | 24.2% → 30.0% | 397k → 215k | 0.73 → 0.48 |
| APEX-Agents/GPT-5.5 | 39.8% → 44.6% | 23.3% → 28.3% | 328k → 176k | 0.52 → 0.40 |
表 1 — 摘錄:Tool-only 換成 Bash 的四組結果(摘自原始論文 Table 1。)
四組全部同向:分數變高,token 和成本變低。開頭的「+21.8 到 +24.5 pp」與「+4.8 到 +7.4 pp」,就是這張表的分數欄逐格相減。
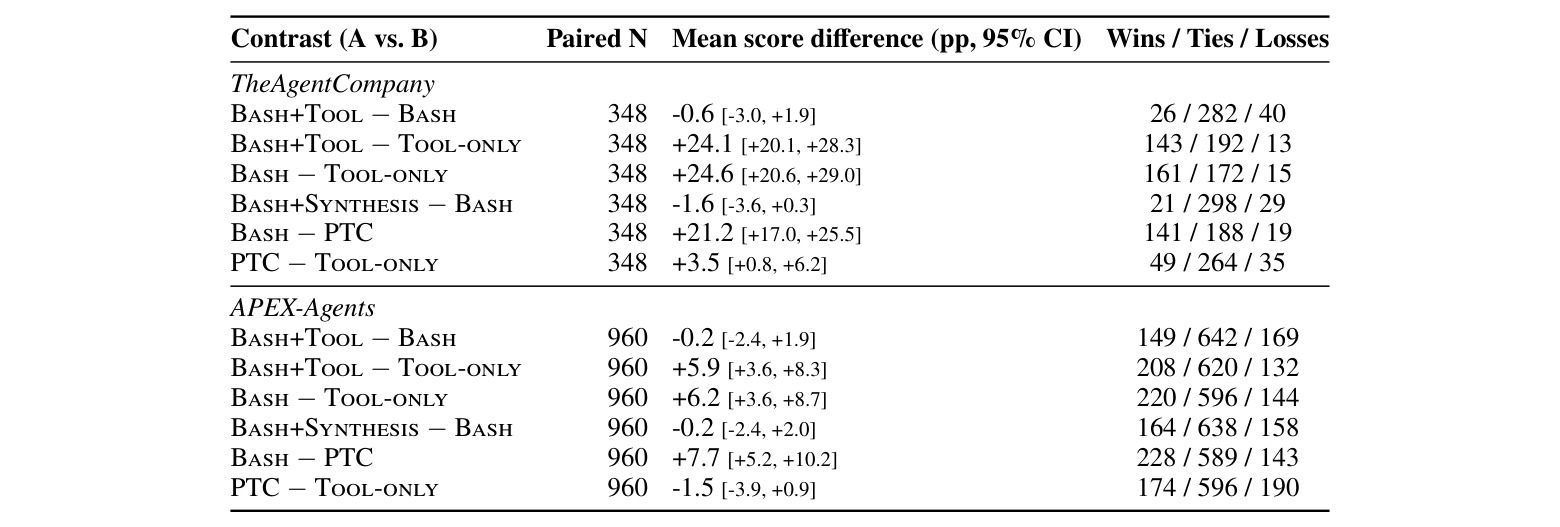
統計上站得住嗎? 下表是以配對任務算出的平均分數差(摘自表 9)。TheAgentCompany 的 +24.6 pp 比上面逐格相減的範圍(最高 24.5)略高一點,兩邊的算法不同,論文沒有說明這個小出入的來源。
| Benchmark | Bash − Tool-only | 95% 信賴區間 | 勝/平/負(題數) |
|---|---|---|---|
| TheAgentCompany(348 個任務-模型配對) | +24.6 pp | [+20.6, +29.0] | 161 / 172 / 15 |
| APEX-Agents(960 個配對) | +6.2 pp | [+3.6, +8.7] | 220 / 596 / 144 |
表 9 — 摘錄:Bash 相對 Tool-only 的配對分數差(摘自原始論文 Table 9。)
兩個區間都不含 0,代表在這批資料裡,Bash 較好的方向相當穩定。不過 APEX-Agents 有 144 個配對是 Bash 反而輸,整體只是 Bash 贏的題數多於輸的題數。論文作者認為,彈性執行對寫程式與跨應用工作的幫助,可能大於對領域推理的幫助。
5 在 Bash 上再加工具,沒有加分,只多花 token
Q2 問的是:已經有 shell 了,再加東西有沒有用?下表是分數差,正數代表加了比較好:
| 加了什麼 | TheAgentCompany | APEX-Agents |
|---|---|---|
| Bash+Tool − Bash(加 typed tools) | −0.6 pp [−3.0, +1.9] | −0.2 pp [−2.4, +1.9] |
| Bash+Synthesis − Bash(加自造腳本) | −1.6 pp [−3.6, +0.3] | −0.2 pp [−2.4, +2.0] |
表 9 — 摘錄:在 Bash 上加東西的配對分數差(摘自原始論文 Table 9。)
四個區間都跨過 0,看不出差異。但「看不出」不等於「證明沒有」:以這些區間的寬度,這個實驗只能排除大於約 2 到 3 pp 的好處,比這小的效果它量不出來。文末延伸段落會用一個體重計的類比說明。
加了東西之後的 token 與成本(每格為 Total tokens/每題成本,單位美元):
| 設定 | Bash | Bash+Tool | Bash+Synthesis |
|---|---|---|---|
| TheAgentCompany/Opus-4.8 | 264k/0.37 | 569k/0.55 | 249k/0.35 |
| TheAgentCompany/GPT-5.5 | 377k/0.56 | 508k/0.60 | 436k/0.61 |
| APEX-Agents/Opus-4.8 | 215k/0.48 | 396k/0.60 | 237k/0.50 |
| APEX-Agents/GPT-5.5 | 176k/0.40 | 257k/0.42 | 228k/0.44 |
表 1 — 摘錄:在 Bash 上加東西的 token 與成本(摘自原始論文 Table 1。)
八格裡只有 TheAgentCompany/Opus-4.8 的 Bash+Synthesis 比純 Bash 便宜,論文自己也把它列為唯一例外,其餘都是 token 變多。
6 PTC:省了 token,分數沒跟上
Q3 看折衷方案 PTC。Tool-only 換成 PTC(箭頭左為 Tool-only,右為 PTC):
| Benchmark/模型 | Score | Total tokens | 每題成本(美元) |
|---|---|---|---|
| TheAgentCompany/Opus-4.8 | 44.9% → 52.9% | 945k → 406k | 1.20 → 0.64 |
| TheAgentCompany/GPT-5.5 | 45.3% → 45.1% | 465k → 242k | 0.66 → 0.54 |
| APEX-Agents/Opus-4.8 | 41.1% → 40.1% | 397k → 337k | 0.73 → 0.61 |
| APEX-Agents/GPT-5.5 | 39.8% → 37.8% | 328k → 256k | 0.52 → 0.48 |
表 1 — 摘錄:Tool-only 換成 PTC 的四組結果(摘自原始論文 Table 1。)
四格 token 都下降,但分數只有第一格明顯進步,其餘持平或略降。配對分數差(表 9)給出一致的結論:
- PTC − Tool-only:TheAgentCompany 是 +3.5 pp [+0.8, +6.2],APEX-Agents 是 −1.5 pp [−3.9, +0.9]。
- Bash − PTC:+21.2 pp [+17.0, +25.5] 與 +7.7 pp [+5.2, +10.2],區間都不含 0,Bash 明顯較好。
- token:PTC 只在 TheAgentCompany/GPT-5.5 比 Bash 省(242k 對 377k)。
為什麼 PTC 省 token? 表 6 拆解了 PTC 的批次化程度與 token 變化(相對 Tool-only 的差;快取讀取是重複送出、以較低單價計費的那段前綴):
| Benchmark | 每次執行包的呼叫數 | 呼叫次數差 | 未快取輸入 token 差 | 快取讀取 token 差 | 輸出 token 差 |
|---|---|---|---|---|---|
| TheAgentCompany | 2.0 | −4.0 | −97.6k | −86.8k | +0.2k |
| APEX-Agents | 2.0 | −3.0 | −45.4k | −44.0k | −0.4k |
表 6 — PTC 的批次化程度與 token 效率(相對 Tool-only 的差,依任務與模型配對)(來源:原始論文 Table 6。)
批次化程度不高(平均每次執行只包 2 個呼叫),但輸入與快取讀取 token 少了很多,輸出幾乎不變。論文作者推測(沒有驗證),這是因為中間結果留在程式裡、只把選出的輸出交回模型,後續每輪要帶的上下文就變短,像前面自編的 GitLab 例子裡 500 筆只回 20 個標題。文末延伸段落有這個機制的推導。
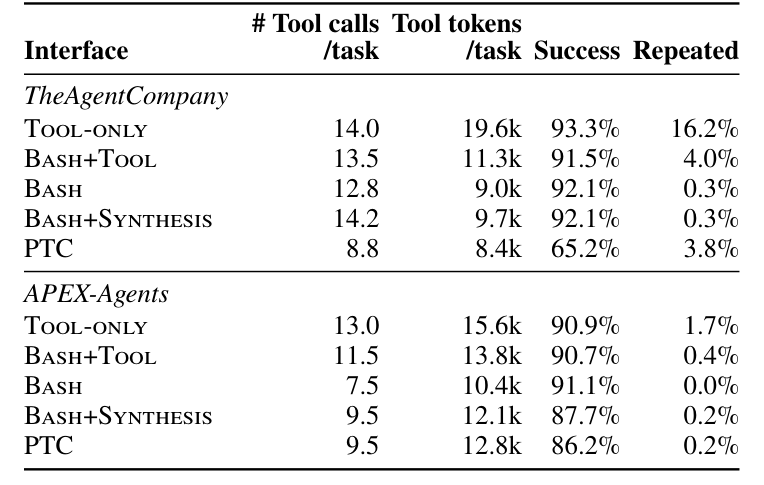
PTC 的工具呼叫成功率最低(表 2):TheAgentCompany 只有 65.2%,其他介面約 92%;APEX-Agents 是 86.2%,其他約 88% 到 91%。論文作者猜測是「在程式裡協調呼叫、處理中間失敗比較難」,沒有進一步驗證。
7 Bash 為什麼比較好:agent 拿 shell 寫小程式
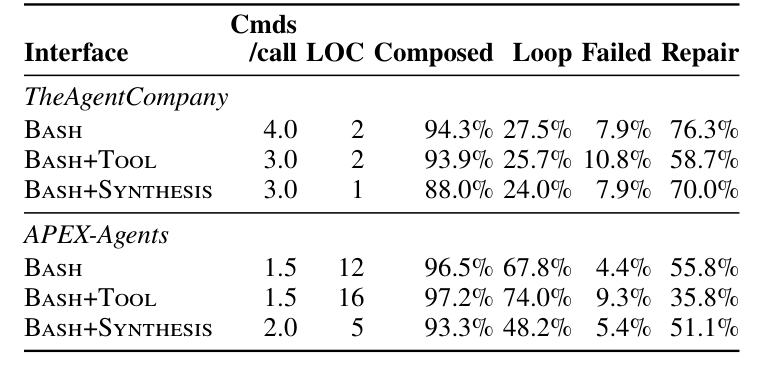
前面三題回答了「誰贏」,這一節看「為什麼」。其中工具使用與 shell 用法兩組實驗指向同一個方向:agent 拿到 shell 之後,不是一次跑一個指令,而是拿它寫小程式,把多個動作串成一次呼叫。最直接的兩個數字:94% 以上的 shell 呼叫是組合式(含 pipe、迴圈、多行等);TheAgentCompany 上,完全相同的重複呼叫在 Tool-only 占 16.2%,在 Bash 只有 0.3%。
- 工具使用(表 2):TheAgentCompany 上,呼叫內容的 token 是 Bash 9.0k 對 Tool-only 19.6k;APEX-Agents 上,呼叫次數中位數 Bash 7.5 對 Tool-only 13.0。論文作者的解釋是:shell 能把重複動作合併成一次呼叫。
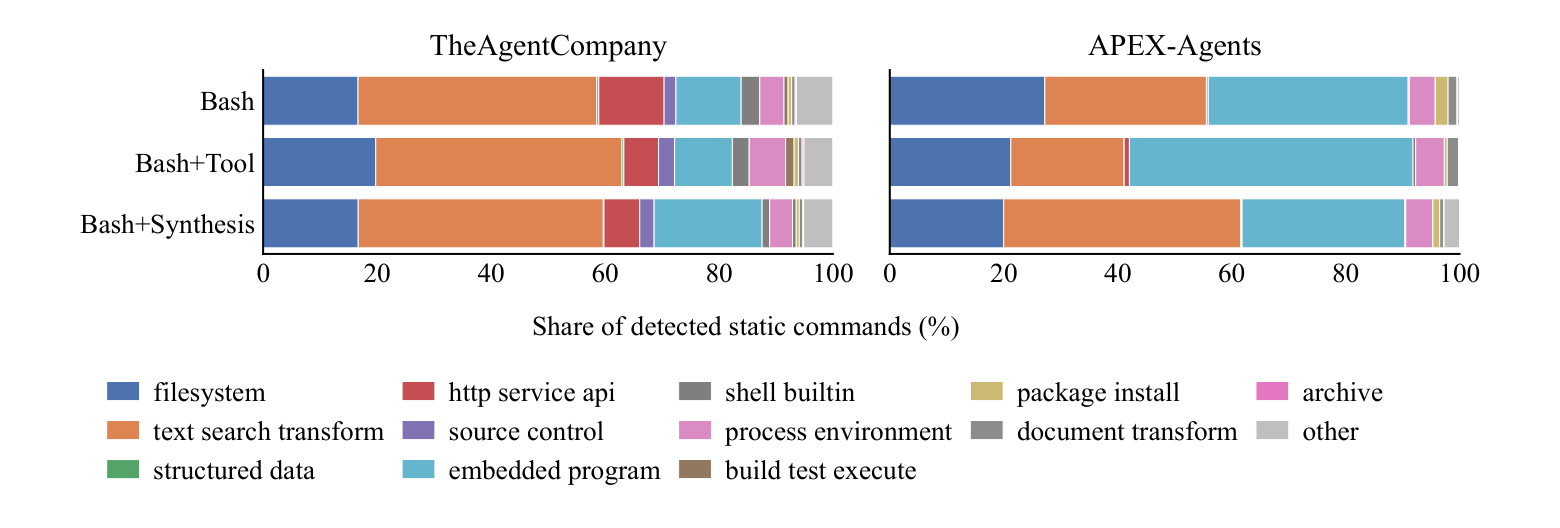
- shell 用法(表 3、圖 5):TheAgentCompany 偏短指令加 HTTP 請求,APEX-Agents 偏長的內嵌 Python。Bash 不只是跑單一指令,是拿來寫小程式。
- Bash+Tool 的 shell 表現(表 3):有了 typed tools,剩下的 shell 呼叫沒有更可靠。失敗率 Bash+Tool 對純 Bash 是 10.8% 對 7.9%(TheAgentCompany)、9.3% 對 4.4%(APEX-Agents)。加 typed tools 只是少用 shell,剩下的沒變好。
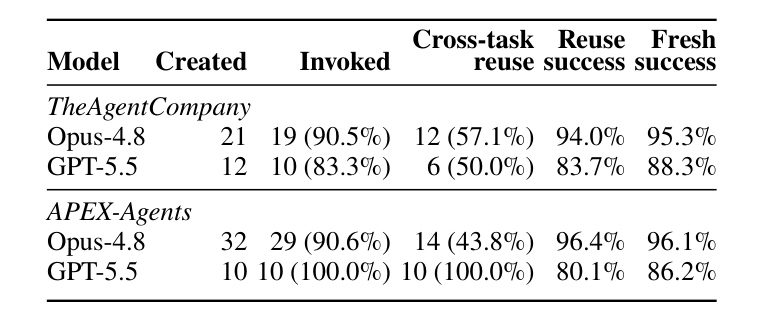
- 自造工具(表 4、表 5):Opus-4.8 在 TheAgentCompany 創造了 21 個工具,其中 12 個在後續任務再被用到;有呼叫自造工具的任務,相對純 Bash 的平均分數差是 −0.6 pp(TheAgentCompany)與 +0.1 pp(APEX-Agents),APEX-Agents 的 token 中位數還多 31.4k。這份資料裡看不到自造工具的價值。
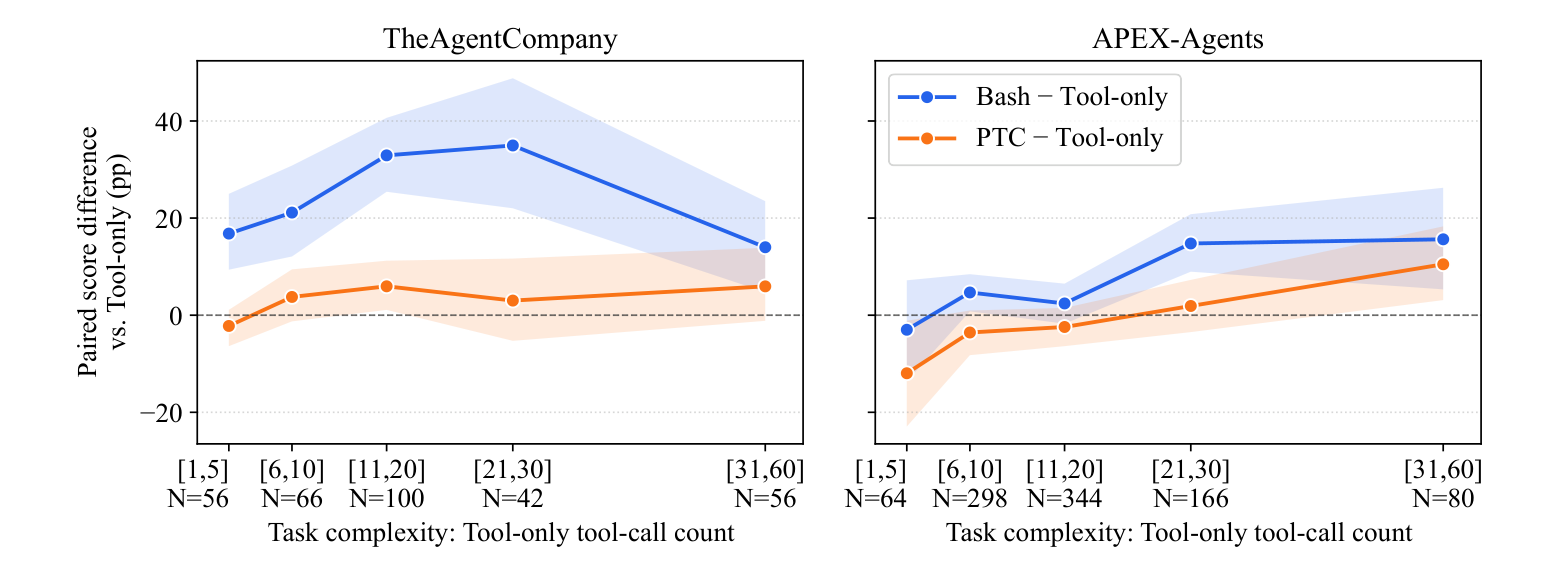
- 任務複雜度(圖 4):Bash 在 TheAgentCompany 的優勢在中等長度最大;APEX-Agents 上,呼叫次數高的區間兩者進步都比較多;PTC 的信賴區間多半跨過 0。證據弱,不要當結論。
- 各領域分數(圖 6):每個領域都是 Bash ≥ Bash+Tool ≥ Tool-only,軟體工程差距最大,公司法務幾乎不受介面影響。介面的影響在寫程式與跨系統的工作最大,在法律判斷最小。
先看工具使用統計,包含呼叫次數、呼叫內容的 token 量、成功率與完全相同的重複呼叫比例。
接著是 shell 的使用統計。「組合式」指呼叫中含 pipe、邏輯運算子、替換、流程控制、多行等標記;失敗與重試則是看 shell 呼叫出錯後,下一個呼叫是否沿用同一個指令。
下圖把 agent 實際下的 shell 指令,依執行檔分成 12 個類別加上「其他」,看 Bash 到底拿來做什麼。
自造工具的重用情形與有沒有幫助,分別在下面兩張表。
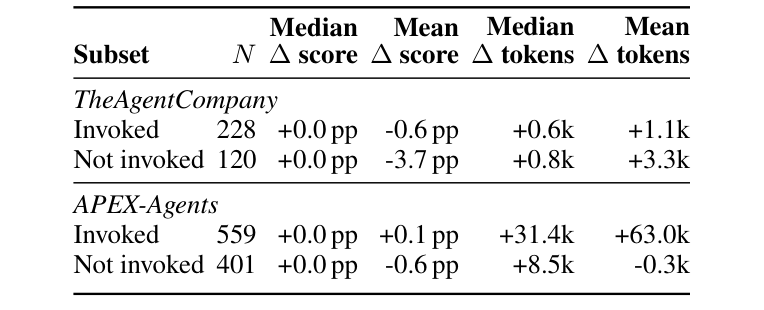
任務複雜度的分析如下。橫軸是 Tool-only 的工具呼叫次數,用來代表任務的長度。
最後是各領域的分數。
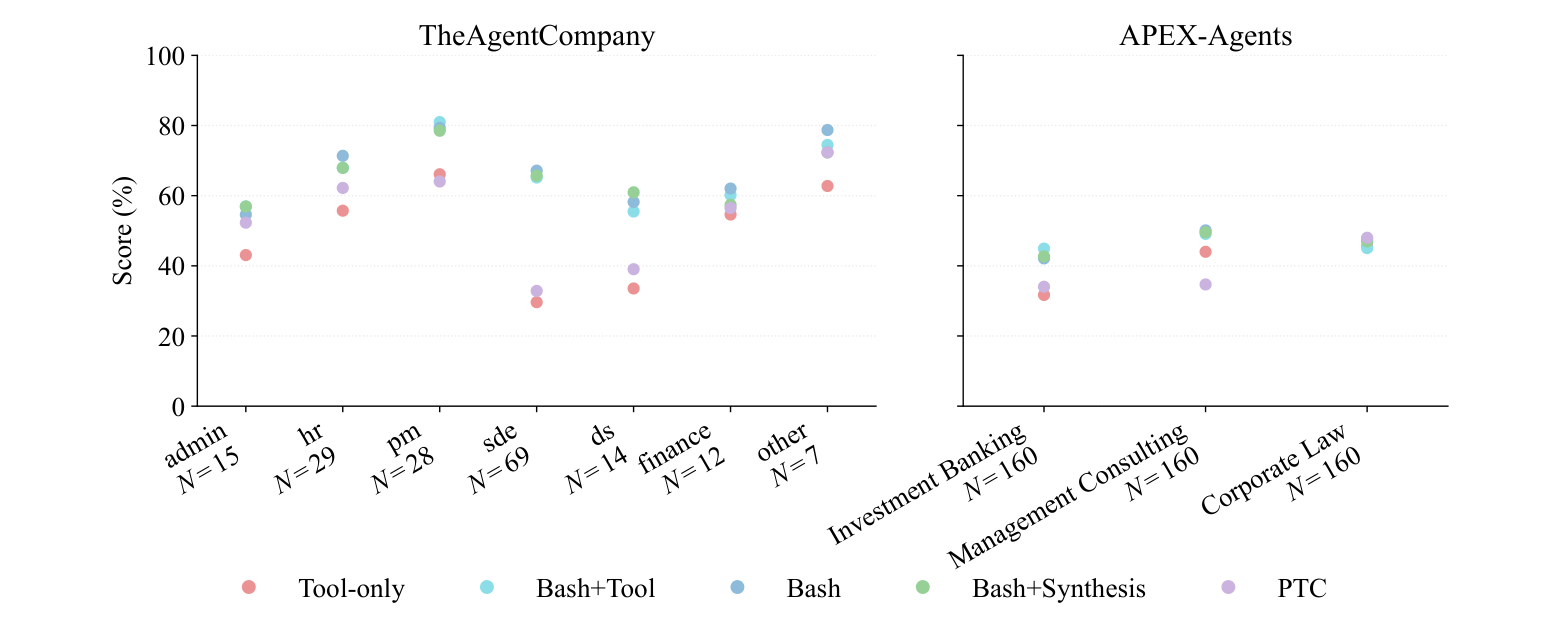
8 這份證據能信幾分
研究價值偏低。 論文沒有提出新方法,也沒有新的分析框架,貢獻是把五種介面放進同一個受控設定裡比較。這類論文的價值取決於基準線公不公平,而這一點正是它最弱的地方(見下面的缺點)。
工程價值中等。 「Bash 分數較高,而且更省」這個方向,在兩個模型乘兩個 benchmark 共四個設定裡一致,值得當作選型的參考;「在 Bash 上加 typed tools 或自造工具,沒看到分數增益」也一致,並且同時伴隨 token 增加。但幅度(尤其 TheAgentCompany 的 +24.6 pp)不能直接搬到別的系統。
它做得好的地方:
- 同模型、同任務文字、同基礎 prompt、同停止條件,只換介面,控制變因乾淨。
- 統計處理算認真:用配對比較加 bootstrap 信賴區間,不只報平均。
- token 與每題成本和分數放在同一張表,對實務決策比單看分數有用。
- 誠實揭露 reward hacking,並說明怎麼擋(Appendix B.1)。
做得不夠的地方,第一點最影響結果的讀法:
- Tool-only 的基準線不是中立的。 除了 TheAgentCompany 那 60 個自製的 typed tools(見 Q1 那一節),PTC 的 Python 執行環境也是論文作者自己實作。APEX-Agents 的 20 個工具是 benchmark 原有的,相對乾淨,但不是完全乾淨(我的推論)。
- Bash 的風險沒有被納入評分。 論文建議「能隔離任意執行時用 Bash」,但隔離的成本與安全事件都沒有量化;而實驗本身就抓到 agent 會從評分腳本撈答案。typed tool 在輸出整理、權限控管、稽核上的價值,也不在分數裡。
- 單次執行的隨機性沒有被單獨量化。 配對任務數 348 = 174 × 2、960 = 480 × 2,似乎每個「任務乘模型」只跑一次(我的推論,論文未說明)。信賴區間是對任務取樣,「看不出差異」的那幾組結論(加 typed tools、自造工具)能排除的效果大小因此有限。
摘要有被包裝嗎? 沒有明顯誇大:摘要的 21.8 到 24.5 pp 與 4.8 到 7.4 pp 就是四格結果的範圍。但它把幅度較大、且基準線問題最嚴重的 TheAgentCompany 放在前面。
9 該怎麼選:先問合規,再問能不能隔離
帶得走的結論:
- Bash 分數更高,而且更省。 四個設定同向;TheAgentCompany 的 +24.6 pp 混著自製基準線,幅度以 APEX-Agents 的 +6.2 pp 較可信。
- 在 Bash 上再加東西,沒看到分數好處。 typed tools 與自造工具都只是讓 token 變多,信賴區間跨過 0 只代表偵測不到大於約 2 到 3 pp 的效果。
- PTC 是折衷。 省 token、分數持平,輸給 Bash,其中有一部分可能只是目錄覆蓋不夠。
這篇論文本身能帶走的不多,比較耐用的是讀它的過程裡整理出來的幾個判斷方法。論文本身的貢獻:
- 一組受控數據:五種介面在同一個設定下的分數、token 與成本。方向可信,幅度不能直接搬(原因見上一節)。
- 一個 reward hacking 實例:有 shell 的 agent 會從評分腳本撈答案,而不是做事(Appendix B.1)。這對任何「讓 agent 有 shell 再拿 benchmark 評分」的實驗都是提醒:能碰到評分程式的環境,分數不能直接信。
- 方法上的貢獻接近零:五種介面都是既有做法的組合。
下面這些判斷方法脫離這篇論文也成立,文末延伸段落逐條展開:
- 看到「A 贏 B」,先檢查 B 是誰做的:基準線被做得多弱,會混進比較結果裡。
- 省 token 的關鍵是別讓大量中間資料進上下文:進了上下文的每個 token,之後每一輪都要再付一次。
- 「能批次處理」與「能碰到的範圍」是兩件事:Bash 與 PTC 都能批次,差別在能碰到什麼。
- typed tools 加 exec(執行 shell 指令的工具)的混合架構:論文沒有支持它比純 Bash 更好,也沒有量到輸出整理帶來的穩定度。
- 「看不出差異」不等於「沒有差異」:信賴區間的寬度,決定了這個實驗偵測得到多小的效果。
工具介面的選擇規則。 論文的建議是條件式的,整理成判斷順序,是先問合規,再問能不能隔離:
| 順序 | 要問的問題 | 答案是「是」 | 答案是「否」 |
|---|---|---|---|
| 1 | 合規要求只能呼叫核准的固定工具嗎? | 用 PTC | 往下問 |
| 2 | 能把任意程式碼執行隔離起來嗎? | 用 Bash | 論文沒有直接講這種情形,退回 Tool-only 是我的推論 |
在 Bash 之上疊 typed tools 或自造工具不在這條判斷路徑上,因為論文沒看到分數好處;真要加,理由得是分數以外的價值。
論文另外給了模型選用建議:以 shell 為主的 coding 與跨應用工作先用 Opus-4.8;追求 token 效率的直接 typed tool 呼叫用 GPT-5.5;文件密集的專業分析要在 Opus-4.8 較高品質與 GPT-5.5 較低 token 之間取捨。論文作者自己也說,模型更新後這些建議未必成立,所以這一段的保存期限最短。
下次看到「新做法大勝基準線」的數字,先問基準線是誰做的,再看信賴區間有多寬。自己設計 agent 時,先問合規、再問能不能隔離,並留意哪個工具正把一大疊結果整份倒進上下文。
關於文中的標示:沒有標示的實驗設定與結果來自論文;〈這份證據能信幾分〉的評估與延伸段落的判斷方法是筆記作者的看法。「我的推論」是筆記作者的推測,「自編例子」是為了說明而編的情境與數字,「一般知識」是論文以外的背景,論文沒交代的地方寫「論文未說明」。
10 延伸:看到 A 贏 B,先檢查 B 是誰做的
以下五段是讀論文時順手整理的判斷方法。每一段脫離這篇論文都成立,想快速回頭複習時,只讀這幾段就夠。
任何「新做法 A 贏過舊做法 B」的結果,都等於方法本身的功勞,加上 B 被做得多弱;當 B 是提案者自己設計的,第二項常被低估。
拆解一個比較結果。 寫成式子,再加上雜訊這一項:
- 觀察到的差距:論文表格上看到的 A 減 B。
- A 本身的功勞:我們真正想知道的東西。
- B 被做得多弱造成的落差:基準線的設計、調校、覆蓋範圍不如 A 所造成的差距。
- 雜訊:任務與模型的隨機性,用信賴區間估計。
論文只能量到等號左邊、表格上看到的總差距(雜訊用信賴區間估計);這個差距裡「A 本身的功勞」和「B 被做得多弱造成的落差」各占多少,要靠讀者判斷。
這篇論文裡的兩層混淆。
| 比較 | 混進去的其他變因 | 相對乾淨的參考 |
|---|---|---|
| Bash 對 Tool-only(TheAgentCompany,+24.6 pp) | Tool-only 的 60 個工具是論文作者自己設計,只涵蓋任務相關的 API,不是 shell 能碰到的所有端點(Appendix B.1) | APEX-Agents 的 20 個工具是 benchmark 原有的,差距只剩 +6.2 pp |
| Bash 對 PTC(+21.2 pp 與 +7.7 pp) | PTC 只能呼叫目錄內的函式,所以差距混著「程式化呼叫的做法」與「目錄夠不夠用」;PTC 的受限 Python 執行環境也是論文作者自己實作 | 論文沒有提供 |
範圍要記清楚:Appendix B.1 講的「目錄只涵蓋任務相關 API」只針對 TheAgentCompany 自建的那 60 個工具,所以這個混淆主要影響 TheAgentCompany 的結論。
兩個 benchmark 的差距差了四倍(+24.6 對 +6.2),論文沒有拆解原因。我的推論是:至少有一部分來自「TheAgentCompany 的基準線是自製的」,另一部分來自任務類型不同(寫程式與跨系統,對上專業分析)。兩者各占多少,這份資料回答不了。
三問檢查法。
- 基準線是誰設計的? 提案者自己做的基準線,要先假設它沒被調到最好。
- 有沒有被投入同等的力氣? 同樣的 prompt 調校、同樣的超參數搜尋、同樣的工具覆蓋範圍。
- 有沒有另一個來源的基準線可以交叉驗證? 兩個來源給出的差距差很多,就代表基準線品質在影響結果。這篇剛好有:自製目錄與 benchmark 原有目錄。
其他常見的基準線陷阱(一般知識,不是論文內容):
- 基準線用預設超參數,提案方法卻調過。
- 基準線的 prompt 沒有針對它調整。
- 基準線用的模型較弱,或給的運算預算較少。
- 兩邊用不同的 harness(執行環境與評分程式)。
怎麼在自己的評估裡用。 把基準線當成一個要認真對待的系統:給它與新方法相同的調校預算,並且盡量另找一個外部來源的基準線來對照。報告結果時,把「同一個條件下只差一個變因」的兩組數字挑出來,那組才是方法本身的功勞。
11 延伸:為什麼中間結果不進上下文就能省 token
模型每一輪都要把前面的全部內容重新讀一遍,所以進了上下文的每個 token,之後每一輪都要再付一次錢;讓大量的中間資料留在模型之外,是最直接的省法。本節的機制屬一般知識,不是論文內容,論文只提供表 6 的旁證。
先定義兩個詞。
- 上下文(context):模型每次被呼叫時讀入的全部文字,包含 system prompt、任務描述、過去每一輪的動作,以及每個工具回傳的結果。
- 無狀態:模型本身沒有跨呼叫的記憶。每一輪,系統都要把整份上下文重新送給模型,模型才「記得」之前發生了什麼。
每個進了上下文的 token 會被重複計算。 先用白話講:一筆工具結果在第 輪進來,之後第 到第 輪都要再讀一次,所以它的成本是「大小乘以剩餘輪數」。寫成式子,總輸入 token 就是每一輪讀入的上下文長度加總,而每一輪的長度是起始上下文,加上之前每一輪模型的輸出與工具結果:
- :任務總共進行了幾輪。
- :第 輪模型要讀入的上下文長度。
- :起始上下文(system prompt 加任務描述)。
- :第 輪模型自己輸出的 token。
- :第 輪工具結果進入上下文的 token 數。
所以省 的效果,會被輪數放大。
逐步試算(自編例子)。 沿用前面的 GitLab 任務:500 筆 issue、其中 20 筆符合條件。假設每筆完整 issue 約 200 token,每個標題約 20 token,起始上下文 5,000 token,取得結果之後還要 9 輪才完成任務;兩種做法模型自己的輸出相同,所以忽略 。
| 做法 | 首輪後進入上下文的結果 | 之後每輪要讀的上下文 | 之後 9 輪合計 |
|---|---|---|---|
| Tool-only(500 筆完整結果進上下文) | 500 × 200 = 100,000 token | 約 105,000 | 約 945,000 |
| Bash 或 PTC(只有 20 個標題進上下文) | 20 × 20 = 400 token | 約 5,400 | 約 48,600 |
差約 19 倍(這裡的數字都是假設,不是論文的實驗結果)。用程式表達同一件事(首輪的 5,000 兩種做法相同,比較的是之後 9 輪):
def total_input(L0, results, turns):
    ctx, total = L0, 0
    for t in range(turns):
        total += ctx                 # 這一輪要讀整份上下文
        ctx += results.get(t, 0)     # 這輪的工具結果進上下文,之後每輪都要再讀
    return total

total_input(5_000, {0: 100_000}, 10)   # 約 95 萬(Tool-only)
total_input(5_000, {0: 400}, 10)       # 約 5 萬(Bash/PTC)
實際系統通常有快取(prompt caching):前綴相同的部分以較低單價重讀。它降低單價,但沒有減少 token 數;論文結果表(表 1)的輸入 token 也包含快取讀取。所以「別讓大量資料進上下文」的價值在有快取時仍成立,只是金額差距變小。
論文的旁證與保留。 旁證是 PTC 那一節的表 6:相對 Tool-only,未快取輸入與快取讀取都大幅減少,輸出幾乎不變,而平均每次執行只包 2.0 個呼叫,所以省下的主要不是「呼叫次數」。論文作者的解釋是:中間結果在程式裡處理,只回傳選出的輸出,後續各輪攜帶的上下文因此縮短。原文措辭是「可能」(may reflect),沒有做直接驗證。
降低進入上下文的 token 的其他做法(一般知識):
| 做法 | 怎麼做 | 適合什麼情況 | 代價 |
|---|---|---|---|
| 工具端先整理輸出 | 在 typed tool 內做篩選、挑欄位、截斷、分頁再回傳 | 你能控制工具的實作 | 每個工具都要設計,整理不當會丟掉需要的資訊 |
| 讓 agent 寫程式處理 | Bash 的 pipe 或 PTC 的 Python,中間結果留在程式裡 | 資料量大、處理步驟固定 | 需要執行環境與安全控管 |
| 上下文壓縮 | 對話太長時,用摘要取代舊內容 | 長時間任務 | 摘要可能遺失細節 |
| 子 agent | 把大量閱讀交給另一個獨立上下文,只回傳結論 | 需要大量搜尋或閱讀 | 額外的協調成本 |
| 快取 | 重複讀取的前綴用較低單價 | 前綴穩定的長對話 | 只降單價,不減 token 數 |
判斷規則:先問「這筆結果大不大、之後會不會再用到原文」。大,而且之後只需要其中一小部分,就別讓它整份進上下文,用上表的前三種擇一;結果小或之後每輪都要參考原文,就直接放進上下文。
12 延伸:批次化不是 PTC 專屬,差別在能碰到的範圍
Bash 與 PTC 都能把多個動作合成一次模型呼叫,它們的真正差別是能碰到什麼環境。因此「這個 benchmark 是不是對 PTC 不利」與「PTC 輸給 Bash 的原因」要分開想。
先定義批次化。 一次模型呼叫(一個回合)完成多個對環境的動作,減少模型與工具之間的往返次數,也減少中間結果進入上下文(機制見上一段)。
三種介面各自怎麼批次。 自編例子:讀 30 份合約 PDF,找出每份的生效日期。
【Tool-only】每份一次呼叫,共 30 次,每次結果都回到模型
  read_pdf("c01.pdf") -> 全文回來 ...  read_pdf("c30.pdf") -> 全文回來

【Bash】一次呼叫,用迴圈與 pipe 串起來
  for f in *.pdf; do echo "$f"; pdftotext "$f" - | grep -i "effective date"; done

【PTC】一次執行,用 Python 迴圈呼叫目錄裡的函式
  for f in list_files("*.pdf"):
      text = read_pdf(f)                       # 目錄內的 typed 函式
print(f, find_line(text, "effective date"))| 介面 | 能不能批次 | 論文的證據 |
|---|---|---|
| Tool-only | 不能,每個動作是一次獨立呼叫 | 表 2:完全相同的重複呼叫占 16.2%(TheAgentCompany);論文作者的解釋是它把每次重複都暴露成一次呼叫 |
| Bash | 能:pipe、&&、迴圈、heredoc(在指令裡直接嵌入多行文字)、內嵌腳本 | 表 3:94.3% 與 96.5% 的 shell 呼叫是組合式;含迴圈標記的呼叫 27.5% 與 67.8%;表 2:APEX-Agents 呼叫次數中位數 7.5,Tool-only 是 13.0 |
| PTC | 能:Python 迴圈、串接、平行,但只能呼叫目錄內的函式 | 表 6:平均每次執行只包了 2.0 個 typed tool 呼叫 |
「這個 benchmark 是不是對 PTC 不利?」 前面看到 PTC 輸給 Bash,一個自然的疑問是:會不會只是這兩個 benchmark 的任務型態不適合 PTC?PTC 的優勢來自迴圈式的大量呼叫,任務若本來就只有十幾次呼叫,優勢就發揮不出來。有可能,但論文沒有直接驗證。 證據如下:
- 支持這個假設:Tool-only 每題呼叫次數的中位數只有 14.0(TheAgentCompany)與 13.0(APEX-Agents),PTC 平均每次執行只包 2.0 個呼叫,不是大量迴圈的工作型態。
- 部分呼應:在任務複雜度圖(圖 4)裡,APEX-Agents 上呼叫次數高的區間,PTC 的平均分數差變成正的。但論文作者自己也說,PTC 的信賴區間在大多數區間都跨過 0,證據很弱。
- 高呼叫次數的任務是少數:呼叫數 31 到 60 那一組,只占配對任務的約 16%(56/348)與 8%(80/960)(筆記作者用圖 4 標示的每箱任務數算的)。
- 論文未說明:它沒有按呼叫次數拆 token 節省量,只拆了分數。所以「呼叫越多,PTC 越省 token」這個假設合理,但沒被驗證。
真正的差別:能碰到的範圍。
| PTC | Bash | |
|---|---|---|
| 批次能力 | 有 | 有 |
| 能碰到什麼 | 只有固定工具目錄裡的函式 | 檔案系統、任意指令、網路,任何 shell 能碰到的東西 |
| 安全控管靠什麼 | 固定的工具目錄(沒有 shell) | 隔離環境、檔案系統限制、執行上限 |
所以就算任務改成大量重複呼叫,優勢會同時屬於 Bash 與 PTC,PTC 沒有 Bash 做不到的批次能力,兩者之間不會因此翻盤(我的推論)。反過來,PTC 輸給 Bash 的那 +21.2 pp 與 +7.7 pp,有一部分可能只是目錄覆蓋不夠(Appendix B.1),而這個混淆主要在目錄自製的 TheAgentCompany。論文沒有把「做法」與「目錄覆蓋」拆開。
判斷規則。
- 任務有大量重複呼叫,而且目錄已涵蓋所需動作:PTC 與 Bash 都比 Tool-only 省,兩者的差別在管控方式。
- 需要碰目錄以外的東西:只有 Bash 做得到。
- 合規要求只能呼叫核准的固定工具:PTC,它在不開放 shell 的前提下保有批次處理的能力。
13 延伸:typed tools 加 exec 的混合架構,論文沒測到什麼
給 agent 一組 typed tools,再加一個 exec(執行 shell 指令)的工具,是常見的實務架構,也就是論文的 Bash+Tool。論文的數據說它比只有 typed tools 好很多、和純 Bash 沒有可偵測的差別,但論文測的 typed tools 不一定是精心整理過輸出的那種。
論文的數據。
論文的數字前面都看過了。Bash+Tool 相對 Tool-only 的進步(TheAgentCompany +24.1 pp [+20.1, +28.3],APEX-Agents +5.9 pp [+3.6, +8.3])和純 Bash 差不多;相對純 Bash 則看不出分數差異(Q2 的表 9 摘錄),token 卻多出不少(Q2 的表 1 摘錄),shell 呼叫的失敗率也比較高(〈Bash 為什麼比較好〉那一節)。
論文(§5.4)的說法是:加了 typed tools,shell 的使用量變少,但剩下的 shell 呼叫並沒有更可靠。Bash+Tool 在使用 shell 的任務裡,shell 呼叫次數的中位數最低,卻同時有最高的失敗率與最低的立即重試率。
論文沒有測到的三件事。
- typed tool 的輸出有沒有被整理:論文說明了工具清單,但沒有說明工具回傳的內容做過多少處理(論文未說明)。
- 穩定度:論文報告平均分數與信賴區間,沒有報告重複執行同一任務的變異;配對數 348 = 174 × 2、960 = 480 × 2,顯示似乎只有一次執行(我的推論)。
- 權限管控與稽核:這些不在分數裡。
所以「有做輸出處理的 typed tool 帶來穩定度」這個實務論點,論文既沒有支持,也沒有反駁。
輸出整理的論點(實務論點,一般知識加我的推論)。exec 回傳的是原始輸出:長度不定、格式不固定、可能夾帶雜訊或不該給模型看的資訊。typed tool 可以在回傳之前先處理:
- 統一格式:固定欄位的結構化結果,模型不必猜怎麼解析。
- 控制長度:截斷、分頁,並附上「還有多少沒顯示」。
- 去識別或遮蔽敏感欄位。
- 標準化錯誤訊息,讓失敗原因清楚可讀。
自編例子:同樣是「找標題含 bug 的 issue」。typed tool 這邊,輸出在回傳前就被整理過:
def search_issues(project, keyword, limit=20):
    raw = gitlab_api.list_issues(project, state="opened")   # 可能有數百筆
    hits = [i for i in raw if keyword.lower() in i["title"].lower()]
    return {
        "total_matched": len(hits),
        "items": [{"id": i["iid"], "title": i["title"], "url": i["web_url"]} for i in hits[:limit]],
        "truncated": len(hits) > limit,          # 明確告訴模型還有沒有更多
    }
exec 這邊回傳原始文字,格式取決於 agent 自己寫的指令,幾行到幾百行不等,出錯時是 curl 或 jq 的原始錯誤訊息:
$ curl -s $GITLAB/api/.../issues | jq -r '.[].title' | grep -i bug這和前面講的是同一個機制:整理過的輸出讓進入上下文的 token 變少。我的推論是:一個輸出設計良好的 typed tool,可以拿到 PTC 與 Bash 靠別的方式拿到的 token 節省,並且多一個可預期的輸入格式。
安全面的一個提醒(我的推論)。只要 agent 手上有 exec,typed tool 就不能單獨當作權限邊界:agent 可以直接用 curl 打同一個 API,繞過 typed tool 的限制。如果選 typed tools 的目的是權限控管或稽核,就要確保 exec 拿不到同樣的憑證與網路路徑,否則兩者並存等於沒有限制。論文把固定工具目錄的價值放在安全與合規,這個價值只有在沒有 shell 時才成立。
怎麼驗證(筆記作者的建議,不是論文內容)。用同一批任務、同一個模型,比較兩個條件:只有 exec;typed tools(輸出經過整理)加 exec。每個條件重複執行至少 3 次,除了平均分數,也比較「同一任務多次執行的分數變異」與 token 量。如果整理輸出的價值主要在穩定度,那麼平均分數可能看不出差別,變異才會有差別。
14 延伸:看不出差異不等於沒有差異
實驗只能說「兩種做法的分數差異,在這批資料裡沒有明顯到能確認」,不能說「保證沒有影響」;信賴區間的寬度,就是這個實驗能偵測到的最小差距的粗略尺度。
用論文的數字看。 TheAgentCompany 上,Bash+Tool − Bash 的平均差是 −0.6 pp,95% 信賴區間 [−3.0, +1.9]。
- 信賴區間:根據這批資料,真實差距有 95% 的信心落在這個範圍內。
- 範圍的下限是 −3.0(加了 typed tools 反而差 3 pp),上限是 +1.9(加了好 1.9 pp),中間包含 0。
- 所以資料分不出「其實沒差」與「其實有 2 pp 左右的小好處或小壞處」。
類比:一個只能量到正負 2 公斤的體重計。你吃了一餐、多了 0.5 公斤,它顯示不出來,但這不代表你沒變重,只是儀器的雜訊比變化本身大。這個類比成立的原因是:任務與模型本身的隨機性,會讓平均差有一個抖動範圍,效果小於這個抖動就被淹沒。
bootstrap 怎麼算(一般知識,論文只寫「95% bootstrap CIs」,細節未說明):
import random

def bootstrap_ci(diffs, n=10000):
    # diffs:每個配對任務的分數差,例如 348 個數字
    means = []
    for _ in range(n):
        sample = [random.choice(diffs) for _ in diffs]   # 有放回地抽,抽得和原本一樣多
        means.append(sum(sample) / len(sample))          # 這一次抽樣的平均差
    means.sort()
    return means[int(0.025 * n)], means[int(0.975 * n)]   # 中間 95% 的範圍
任務數越多,抽出來的平均越穩定,區間就越窄,能偵測到的差距就越小。
讀到「沒有可偵測的增益」(no detectable gain)時的三個動作。
- 看區間寬度:寬度大約是正負幾個 pp?
- 想我在意的效果有多大:如果我在意的好處只有 1 到 2 pp(例如穩定度的小幅提升),這個實驗本來就量不出來。
- 看有沒有同時有其他指標支持:例如 token 是否變多、失敗率是否變高,這些可以補足平均分數看不到的面向。
這篇論文的含義。 加 typed tools 或自造工具,在分數上「看不出差異」,能排除的只是「大於約 2 到 3 pp 的好處」;比這小的效果,這個實驗不能證明也不能否定。