便宜判官先判、沒把握才找 GPT-6:JEV 串接真的省錢嗎?
 Hong-Wei Wu
收錄於 論文介紹
1 前言
用 LLM 當判官(LLM-as-a-judge)幫模型輸出打分數,已經是評測的預設做法。問題是強的推理判官(例如 GPT-6)又貴又慢,便宜的判官又不知道自己什麼時候會錯。這篇文章讀的是 JEV-as-a-Judge: Accept When Confident, Escalate When Unsure(Li、Miao、Krishnan、Padman,卡內基美隆大學,arXiv 2609.26550v3,2026 年 9 月)。它想問的是:讓便宜的判官先判,信心夠高就直接採用,信心不夠才轉給強判官,能不能用小得多的成本換到接近強判官的準確度?
這篇論文是第三方評測,不是提出新方法。串接分流和選門檻都是既有做法,它的價值在於把整套流程事先凍結,再拿沒看過的題目驗收,並誠實攤出哪裡成立、哪裡不成立。答案大致是:在答案能從文字直接讀出的任務上成立,在難任務上,只要門檻選對,準確度不掉,但省得很少。
文章依序是:論文的問題、方法、實驗、整體評價,接著是「值得帶走的東西」,最後是「概念詳解」。概念詳解整理了 AUROC、校準、資料切分這些脫離論文也成立的觀念,對工程師的耐用度比論文的具體數字高得多。正文第一次碰到這些術語時,會先用一句話解釋,想看完整推導再跳到概念詳解。
2 三十秒版本
- 問題:強的推理判官準但貴又慢,便宜判官又不知道自己什麼時候會錯。
- 做法:JEV 先判每一題,把它最大的標籤機率當成信心 。 夠高就直接採用,低於門檻 才轉給 GPT-6 重判。
- 結果:RewardBench 上,串接的準確度略勝 GPT-6(+1.27 個百分點),費用只要 27%。JudgeBench(較難)與兩個全新任務上,準確度追平 GPT-6,但轉出比例高(65% 到 89%),只省約 9% 到 33% 的費用。
- 兩個要記住的性質: 適合拿來排序「誰比較可能錯」,不適合直接當「答對機率」讀。沒有證據可對照的任務,信心完全失效。AUROC 是「信心能不能把錯題排在對題前面」的指標,0.5 等於亂猜,這個任務上是 0.498。
- 判斷:研究價值低,工程價值中高但有範圍。最值得帶走的是 AUROC 與校準這些通用觀念,以及「讀得出答案 vs 需要推導」的界線。
3 問題與背景
3.1 先弄清楚什麼是 LLM 判官
**LLM 判官**是拿一個 LLM 去評另一個模型的輸出,例如「這兩個回答哪個比較好」,或「這個答案有沒有被給定的證據支持」。它會成為預設做法,是因為人工評分無法大規模進行,而 BLEU 這類自動指標只比對字面重疊,處理不了開放式回答。
判官分兩類:
| 類型 | 做法 | 特性 |
|---|---|---|
| 推理型判官(reasoning judge) | 先在內部想一長串再給結論,如 GPT-6 | 難題上比較強,但每次判斷要多花運算,費用高、速度慢 |
| 決策型判官(decision-only judge) | 只輸出判決與每個標籤的機率,不產生任何文字 | 便宜、快。JEV(TypeSafe AI 的託管模型,論文測的是 1.13 版)就是這類 |
3.2 三個痛點
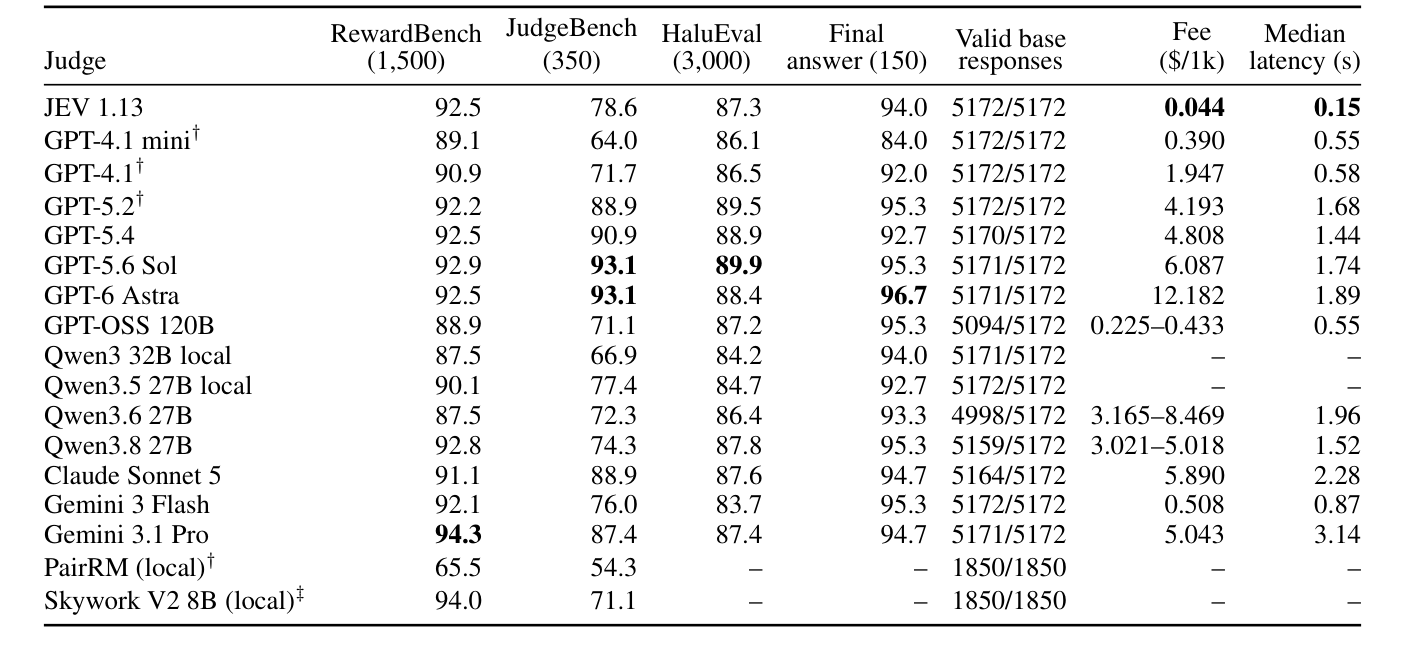
成本與延遲。 論文量到 GPT-6(低推理強度)每千次判斷約 12.182 美元、中位延遲 1.89 秒;JEV 每千次約 0.044 美元、0.15 秒。差距約 277 倍與 13 倍。每換一個模型檢查點、每評一批新回答,這筆帳都要重付。
信心不可靠。 直接問 LLM「你有多確定」,它常過度自信,對錯的答案也給很高的機率。大規模使用時,需要判官能分辨哪些判斷是例行的、哪些需要複查。
便宜與準確很難兼得。 單一判官只能二選一,所以論文想用「串接」把兩者的優點組起來。
3.3 論文怎麼問問題
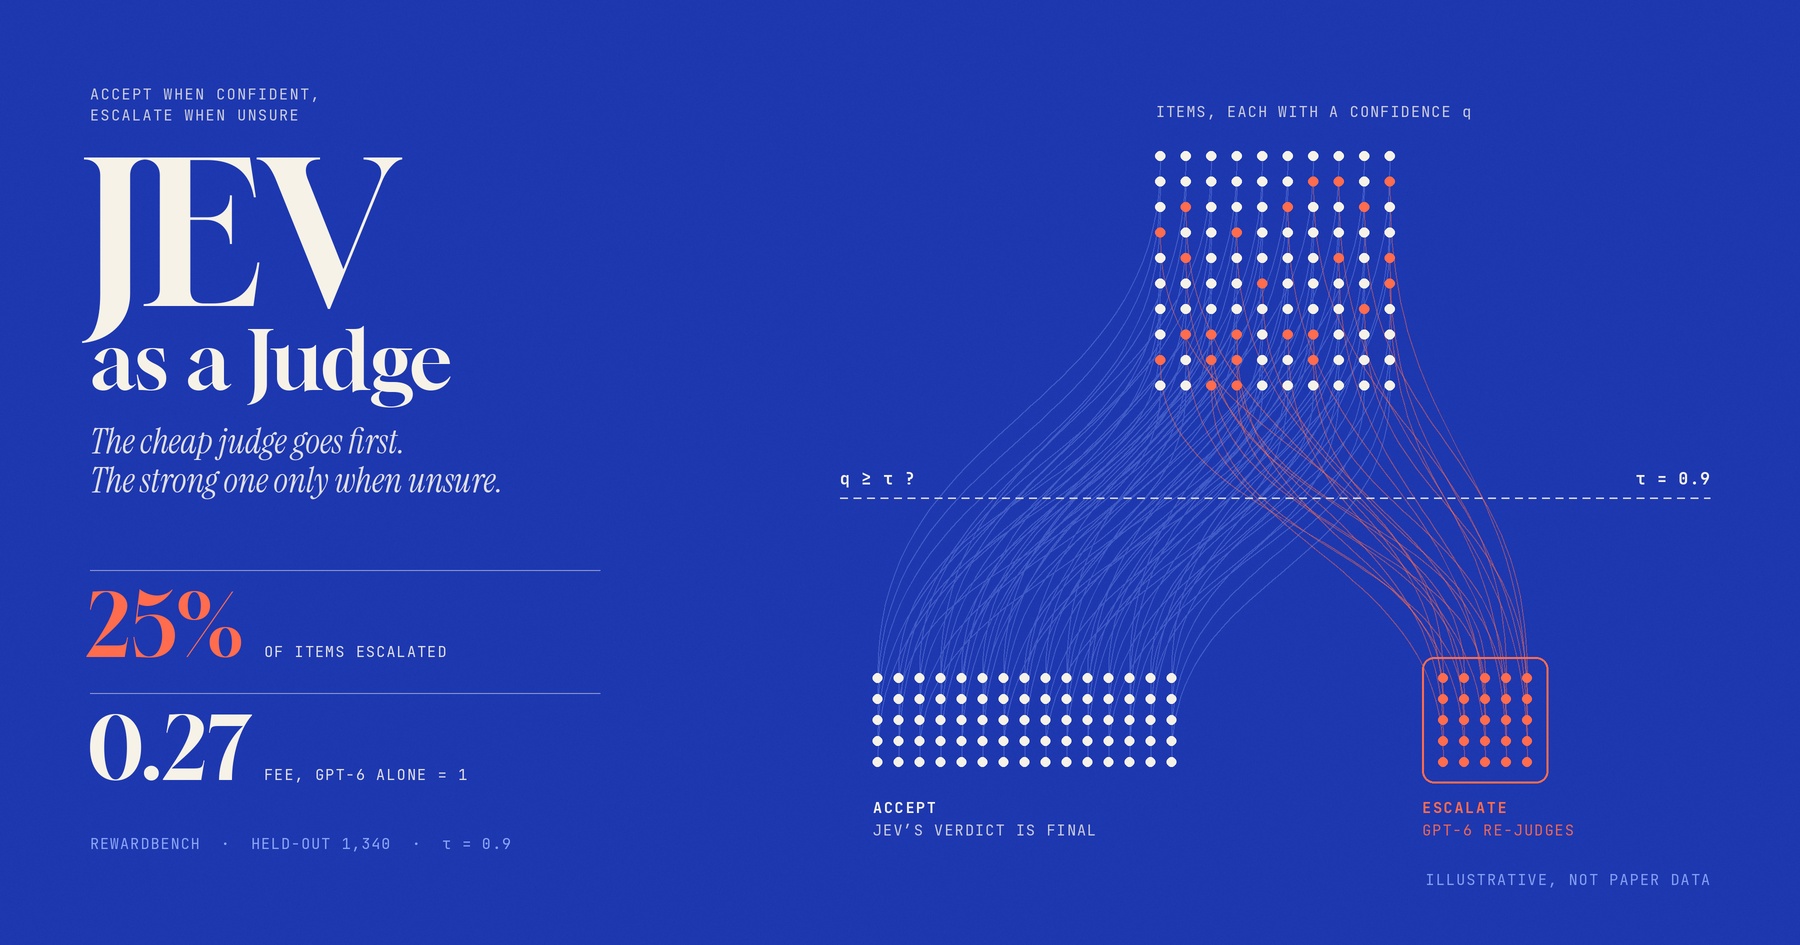
核心想法就是下面這張流程圖:JEV 先判每一題, 達到門檻 就直接把 JEV 的判決當最終答案,沒達到就交給 GPT-6 獨立重判,並以它的判決取代 JEV 的判決。
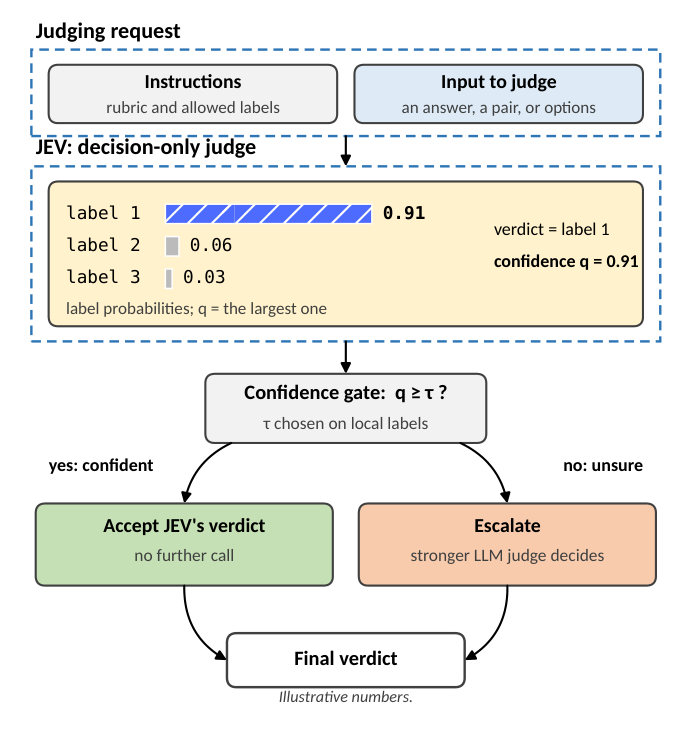
因此論文實際要回答的是四個問題:
- JEV 的機率能不能當信心?( 排序得出誰比較可能錯嗎?)
- 這個信心在換個呈現順序時穩不穩?
- 門檻 怎麼選,才能在準確度掉不超過容忍度的前提下省最多錢?
- 這些結論在沒看過的題目、新的任務上還成立嗎?
名詞先統一:本文的「轉出」和「升級」是同一件事,指把題目交給強判官;「串接」和「分流」指整套「先便宜、後貴」的流程。
論文同時量四種東西:準確度、機率品質(機率數字準不準)、費用、延遲。
4 方法
方法有三件事:怎麼公平地測、怎麼定義並驗證信心 、怎麼用 串接並選門檻 。
4.1 評測設計
三種任務,難度由「答案寫在文字裡就能讀出」排到「得自己推導才知道」:
| 任務 | 判什麼 | 主要資料集 |
|---|---|---|
| 成對偏好(pairwise preference) | 兩個回答哪個比較好 | RewardBench(日常偏好)、JudgeBench(較難,對錯可客觀驗證) |
| 證據型事實性 | 答案有沒有被給定證據支持 | HaluEval(幻覺偵測) |
| 最終答案裁決 | 一段回覆的最終答案對不對 | 作者自己存的 150 筆選擇題回覆 |
比較對象。 除了 JEV,還有 16 個判官,共 17 個配置:14 個生成式 LLM(含 GPT-6、Claude Sonnet 5、Gemini 3.1 Pro),加 2 個獎勵模型(reward model,不會講話,只替回答打分數)。GPT-6 是主要對照組,因為它最貴、最穩,人工複查也針對它與 JEV 的分歧。
輸出契約,是公平比較的關鍵。 所有 LLM 判官都被要求用 JEV 的格式回答:一個判決加每個標籤的機率,不准寫理由。這樣大家的輸出形狀才一樣,信心才能直接比。(推論:這也限制了推理型判官發揮,所以「GPT-6 的表現」是在這個限制下量到的。)
資料切分。 全部 5,172 筆分成 642 筆 pilot 與 4,530 筆 held-out。held-out 的意思是完全不碰、只拿來最後驗收的資料。pilot 再依來源題目切成 select(40%,專門用來決定門檻)與 test(60%)。規則與門檻候選值,在任何 held-out 結果出現之前就先固定。數字如下(單位是判斷次數):
| 任務 | pilot | 其中 select | 其中 test | held-out |
|---|---|---|---|---|
| RewardBench | 160 | 64 | 96 | 1,340 |
| JudgeBench | 80 | 32 | 48 | 270 |
| HaluEval | 80 | 32 | 48 | 2,920 |
| 最終答案與控制組 | 322 | 不切分 | 不切分 | 0 |
最後一列是作者另外準備的最終答案與控制組資料,不切 select/test,也沒有 held-out(論文沒有展開細節)。pilot 的 test 部分做什麼用,論文沒有說明,後面「概念詳解」會專門討論。
4.2 信心 q:定義與驗證
定義。 是 JEV 所有標籤機率中最大的那一個,也就是它對自己所選判決的把握:
- :JEV 對第 個標籤給的機率,所有標籤的機率加起來是 1
- :取最大的那個
- 白話:判官最看好的那個答案,它有多大把握
例子(流程圖的示意數字):三個標籤的機率是 0.91、0.06、0.03,判決就是 0.91 那個標籤,。
JEV 其實自帶一個「原生信心」欄位,但論文不用它,原因有兩個:
- 其他 16 個判官都只有標籤機率,用 才能公平比較
- 原生信心的公式 TypeSafe 沒公開
論文另外確認原生信心與 的排序很像(三個 Spearman 相關係數是 0.976、0.999、0.958,越接近 1 表示排序越一致),所以換成 損失不大。
成對題要兩個順序各問一次,再取平均。 兩個回答誰先誰後,判官可能受位置影響,所以每一對都問兩次,把機率對齊到同一個回答後平均,再取最大值當 (HaluEval 沒有候選順序,只問一次)。
自編例子:A 先時,JEV 說「A 好」的機率 0.90;B 先時,JEV 說「先出現的 B 好」的機率 0.70,換算成「A 好」是 0.30。平均 ,所以 。一個會偏袒第一個位置的判官,兩次答案互相矛盾,平均後 就掉下來,後面會被轉給強判官。
驗證: 到底能不能用? 論文做了三個檢查(論文第 7 節)。
檢查一: 越高,是不是真的越準? 把 4,850 題(三個公開基準的原順序判斷:RewardBench 1,500、JudgeBench 350、HaluEval 3,000)依 分組,看 JEV 的正確率。 的 214 題,JEV 只對 55.1%(GPT-6 對 69.6%); 的 2,332 題,兩者都對 97.8%,一起對、一起錯,只有 2 題例外。差距集中在 低的地方。
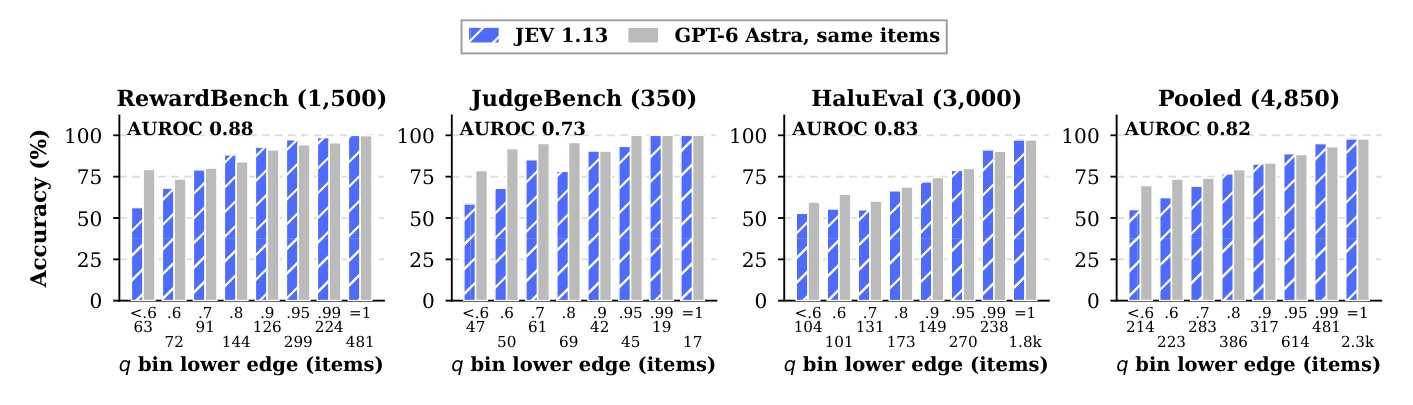
檢查二: 能不能把錯的題挑出來? 這要用 AUROC:把題目照 排序,看答錯的題是不是排在答對的題前面,0.5 等於亂猜,1 等於完美(細節見後面的概念詳解)。JEV 的 在 RewardBench、HaluEval、JudgeBench 上分別是 0.88、0.83、0.73(兩順序平均),最難的 JudgeBench 最弱。
檢查三:換順序時 穩不穩? JEV 共有 95 次「換順序後判決翻轉」,只有 3 次發生在 。翻轉大多出現在本來就不確定的題目上。
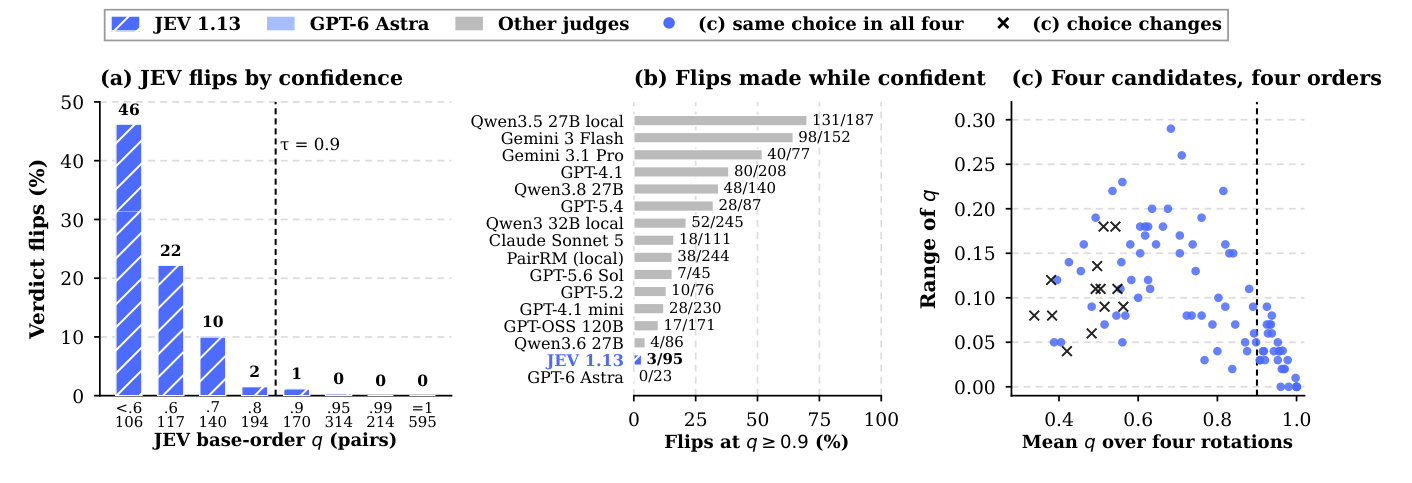
必須知道的結論: 的排序可以信, 的數字不能直接當機率讀。 論文 7.2 節把排序能力(AUROC)與機率品質(Brier 分數,越低越好,見後面的概念詳解)分開量:
| 任務 | AUROC:JEV | AUROC:GPT-6 | Brier:JEV | Brier:GPT-6 |
|---|---|---|---|---|
| RewardBench | 0.875 | 0.894 | 0.113 | 0.115 |
| JudgeBench | 0.745 | 0.907 | 0.297 | 0.095 |
| HaluEval | 0.827 | 0.831 | 0.196 | 0.213 |
表中的 AUROC 是單次呼叫的結果,跟前面兩順序平均的數字略有差異。Brier 分數是「機率與實際對錯的平方差」的平均,越低表示機率越準。
RewardBench 上兩者接近;JudgeBench 上 JEV 不只排序弱,Brier 還差了三倍。HaluEval 的 Brier 看似 JEV 較好,但論文指出這個優勢經不起標籤修正:人工裁決其中 240 題後,Brier 變成 JEV 0.062、GPT-6 0.032(題數不同,不能與 0.196 直接相減,但方向很清楚)。
更直接的證據是,同樣是 ,不同任務上對應的錯誤率不同:RewardBench 是 1.8%(20/1,130 題),JudgeBench 是 5.7%(7/123 題,題數少,數字不太穩)。
校準也救不了這件事。溫度縮放是把機率整體調平或調尖的旋鈕(溫度 壓平, 拉尖,細節見後面的概念詳解)。論文在三個任務擬合出的 分別是 0.651、2.148、4.452,方向不一致,而且 NLL(一種特別嚴懲「很有把握卻答錯」的機率品質指標,越低越好)在其中兩個任務校準後反而變差。
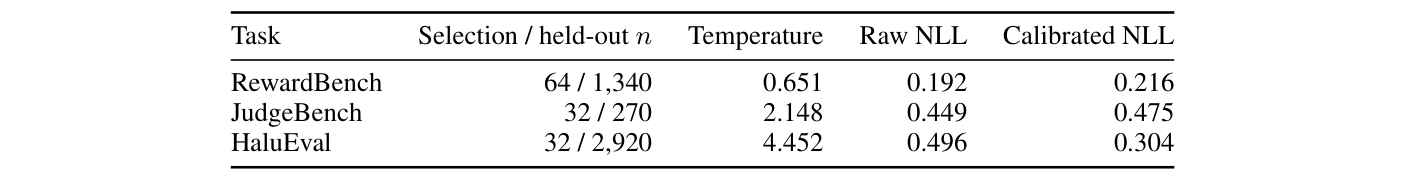
所以分流用的是 的相對高低。門檻不能憑「 大概就是 90% 會對」來設,必須用各任務自己的標註資料。
4.3 串接分流與門檻怎麼選
規則。 便宜判官先判全部題目,沒把握的才交給強判官:
- JEV 判每一題,得到 (成對題是兩個順序平均後的 )
- :JEV 的判決就是最終答案
- :交給強判官。強判官不看 JEV 的答案、獨立重判,它的判決整個取代 JEV
是「門檻」(放行線),下面再講怎麼選。
自編例子:6 題,。
| 題 | 去向 | |
|---|---|---|
| 1、2、3、4 | 直接採用 JEV | |
| 5、6 | 轉給 GPT-6 |
GPT-6 只收 2 題的費用。但 JEV 本身也要付費(成對題問兩次),所以「省錢」是拿「JEV 全部加轉出去的」跟「全部給 GPT-6」比。論文的費用比例就是這樣算的。
這個設計能成立的前提,是兩個判官錯在不同的題。 以 JudgeBench 全部 350 題的原順序判斷來看,JEV 錯 75 題,GPT-6 在其中答對 60 題;GPT-6 錯 24 題,JEV 在其中答對 9 題;兩邊共同錯的有 15 題。(下一章表中 JudgeBench 的 270 題只是其中 held-out 的部分,所以準確度數字不同。)如果有一個完美的挑題員,每題都挑到比較對的那一個,準確度可達 95.7%。反過來,兩邊都錯的題,串接怎麼轉都修不回來。
這只是眾多設計中的一種,而且論文只實測了這一種(其他設計見後面的概念詳解)。
4.3.1 門檻 τ 怎麼選:基本規則
一句話:拿一批有標準答案的題目把串接模擬一遍,挑「最省錢、而且準確度掉不超過 2 個百分點」的 。
把 想成安檢的放行線:
- 高過這條線:直接放行,用 JEV 的答案
- 低於這條線:轉出,改請強判官重判
- 線設得高:轉出很多題,花錢多,但成績接近強判官
- 線設得低:轉出很少題,花錢少,但可能放過一些 JEV 會錯的題
做法是對每條候選的線,在標註題上模擬串接,算「轉出的比例(代表花費)」與「串接的總分」,再跟強判官單獨作答的總分比。
自編例子:100 題的練習題,GPT-6 單獨作答得 90 分。
| 放行線 | 轉給 GPT-6 的比例 | 串接總分 | 比 GPT-6 差多少 |
|---|---|---|---|
| 0.99 | 80% | 90 | 0 |
| 0.95 | 55% | 90 | 0 |
| 0.90 | 35% | 89 | 1 |
| 0.80 | 20% | 86 | 4 |
| 0.60 | 8% | 83 | 7 |
選線的規則是:在「比 GPT-6 差不超過 2 分」的線裡,挑轉出最少(最省錢)的。0.99、0.95、0.90 都符合,其中 0.90 轉出最少,所以選 。
論文的實際做法:候選值是 0.5、0.6、…、0.99 共 7 個;在 96 題 pilot 選擇題(64 題 RewardBench、32 題 JudgeBench)上,挑「在強判官的選擇集準確度 2 點之內、接受 JEV 判決最多(coverage 最大)」的 ,之後完全不重新擬合。對 GPT-6 選出的是 。
4.3.2 門檻 τ 怎麼選:保守規則
練習題很少時,量到「只差 2 分」可能是運氣,所以保守規則改問「最壞情況可能差多少」,而不是「量到差多少」。
練習題只有一百題左右時,同一條線換一批題,可能量到差 0 分,也可能差 4 分。保守規則(論文稱 lower-bound rule)把量到的差再往壞的方向扣一個懲罰,懲罰的大小代表這個數字有多不穩,題目越少扣得越多,扣完還要在 2 分以內才通過。
論文的真實例子(PPE 選擇題):
| 放行線 | 量到的掉分 | 扣完懲罰後的最壞估計 | 通過嗎 |
|---|---|---|---|
| 0.90 | 2.0 分 | 4.3 分 | 不通過 |
| 0.95 | 0 分 | 論文未列 | 通過 |
基本規則下 剛好壓線通過;保守規則看到最壞可能掉 4.3 分,就改選 。(懲罰約 2.3 分,是我用論文兩個數字相減得到的。)
一般知識:這類懲罰大致跟題數的平方根成反比,題數從 100 變 1,000,懲罰約縮成原來的三分之一。代價是保守規則通常選更高的 ,轉出更多題、花費更高。
兩個規則在論文裡的用法不同:主要的 held-out 實驗用基本規則(96 題選擇集,選出 );前瞻性實驗用保守規則。
容忍度(掉幾分)是使用者自己訂的,不是模型替你算出來的。論文提到,如果知道答錯一題的成本,門檻應該由「錯誤成本與轉出成本的比值」推出,但沒有實測這個做法。
4.4 整合:完整流程與名詞總表
整套方法可以串成六步:
- 資料切成 select 與 held-out
- JEV 判每題,得到 (成對題兩順序平均)
- 用 AUROC 驗 能不能排出錯題,用 Brier、NLL 驗 的數字準不準
- 在 select 上選 (基本規則或保守規則)
- 低於 的題轉給 GPT-6
- 在 held-out 驗收
| 名詞 | 一句話 | 回答的問題 | 在哪一步 |
|---|---|---|---|
| 輸出契約 | 所有判官都只回判決加標籤機率,不寫理由 | 怎麼公平比較 | 1 |
| select / held-out | select 用來選參數,held-out 完全不碰、只驗收 | 怎麼避免自己騙自己 | 1、4、6 |
| JEV 對自己所選判決的機率(最大標籤機率) | 這題 JEV 有多有把握 | 2 | |
| 兩順序平均 | 成對題問兩次再平均,抵消位置偏見 | 穩不穩 | 2 |
| AUROC | 把錯題排在對題前面的機率 | 能不能排序 | 3 |
| Brier、NLL | 機率與實際結果的差距 | 的數字能不能當機率讀 | 3 |
| 溫度縮放 | 一個旋鈕,整體調平或調尖機率 | 能不能修校準 | 3 |
| 放行線, 高於它就採用 JEV | 轉多少題 | 4、5 | |
| 基本規則 | 挑最省錢、掉分不超過 2 點的 | 怎麼選 | 4 |
| 保守規則 | 同上,但用最壞估計判斷 | 題少時怎麼選 | 4 |
幾個關係要記住: 的排序決定「轉哪些題」, 的數字大小只影響你怎麼解讀。溫度縮放只修校準,不改準確度,二選一時也不改 AUROC,所以不影響分流。 是這條流程裡唯一真正決定成本與準確度的旋鈕,而它必須用目標任務自己的標註資料來選。
第 3 步其實是診斷,不是選 的必要條件,原因在後面的概念詳解有專門一節。
5 實驗
論文的實驗很多,這裡只收最能回答「這個串接能不能用」的三組:凍結政策在沒看過的題上的結果、換強判官時規則不通用、前瞻性即時測試。 本身好不好用的驗證,已在前面「信心:定義與驗證」一節講過。
先交代幾個名詞:
- 凍結(frozen):規則與門檻在看到任何 held-out 結果之前就定好,事後不調整。
- 離線模擬:強判官先對所有題判過,再事後假裝「只有被轉出的題才用強判官的答案」,算出串接的結果。
- 95% 信賴區間:如果重抽一批題,差距大概落在這個範圍。區間含 0,代表看不出兩者有差。
- (delta):串接的準確度減去強判官單獨的準確度。
5.1 凍結政策在沒看過的題上的結果
一句話:用 96 題選出 ,換到沒碰過的 1,610 題,簡單任務上串接又準又省,難任務上準但省得少。
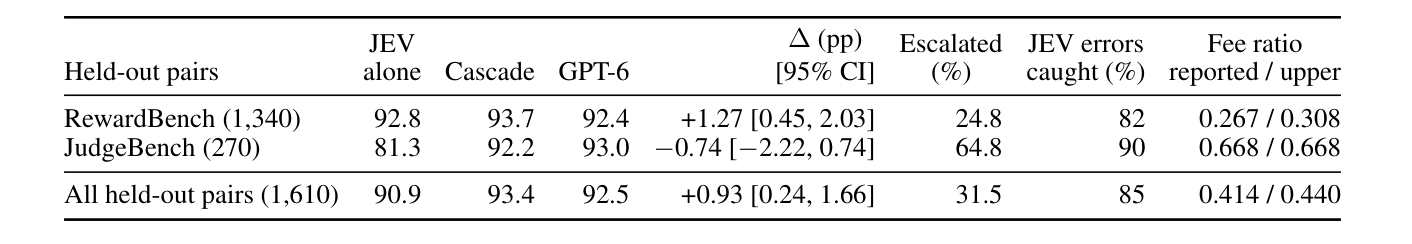
下表是我從原表挑出的重點欄位,原表的欄位更多:
| 任務 | JEV 單獨 | 串接 | GPT-6 單獨 | 串接 − GPT-6(95% 區間) | 轉出比例 | 費用(GPT-6 = 1) |
|---|---|---|---|---|---|---|
| RewardBench(1,340 題) | 92.8 | 93.7 | 92.4 | +1.27 [0.45, 2.03] | 25% | 0.27 |
| JudgeBench(270 題) | 81.3 | 92.2 | 93.0 | −0.74 [−2.22, 0.74] | 65% | 0.67 |
怎麼讀:
- RewardBench:只轉 25% 的題,費用只要 27%,準確度還略勝 GPT-6,區間不含 0,所以略勝是真的。原因是兩個判官錯在不同題,串接等於挑了各自擅長的部分。
- JudgeBench:要轉 65%,費用 67%,只省了三分之一。準確度與 GPT-6 看不出差別(區間含 0),但那是靠 GPT-6 補回來的。
- 小心合計列:論文另有一行「全部 held-out」的合計(串接 93.4,費用 0.41),但 held-out 有 83% 是 RewardBench,合計幾乎只反映 RewardBench,不要用它判斷難任務。
5.2 換強判官時,同一套規則不一定通用
同一套選 的規則,換一個強判官,選出來的 就不同,而且在難任務上可能失效。
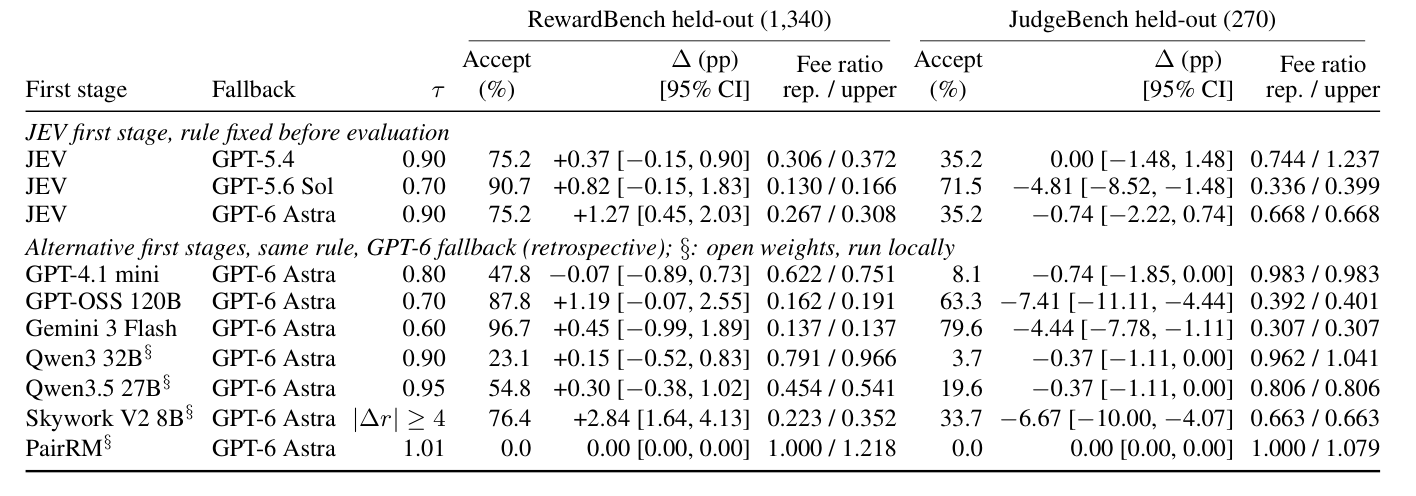
下表是原表的摘要。三個強判官,用同樣的規則、同樣的 96 題選擇集:
| 強判官 | 選出的 | RewardBench:串接 − 強判官 | JudgeBench:串接 − 強判官 |
|---|---|---|---|
| GPT-5.4 | 0.90 | +0.37(區間含 0) | 0.00(區間含 0) |
| GPT-6 | 0.90 | +1.27(區間不含 0) | −0.74(區間含 0) |
| GPT-5.6 Sol | 0.70 | +0.82(區間含 0) | −4.81 [−8.52, −1.48](區間不含 0) |
- 前兩列在兩個任務上都沒掉分。GPT-5.6 Sol 在 JudgeBench 掉了 4.81 分,超過 2 分的容忍度,而且區間完全在負的那一側,這不是運氣。
- 規則給它選了比較鬆的 ,所以在 JudgeBench 只轉出 28.5% 的題,漏掉太多 JEV 會錯的題。
- 論文的解釋:96 題選擇集裡 JudgeBench 只有 32 題,其餘是 RewardBench。RewardBench 上放寬門檻很安全,規則被這一大塊拉著選出偏鬆的 ,結果在難任務上失靈。
- 另一個結果:當強判官在選擇集上不比 JEV 準(GPT-4.1 mini、GPT-4.1、GPT-OSS 等),規則會選 ,也就是完全不轉出,因為轉出去沒有好處。
要帶走的重點: 不是 JEV 的屬性,而是「第一階段判官、強判官、任務」三者一起決定的,換任何一個都要重新選。
5.3 前瞻性即時測試
在兩個新任務上,用保守規則選門檻,串接的準確度跟 GPT-6 一模一樣,但因為 JEV 在這兩個任務上本來就弱,只省到約 25% 的費用。
「前瞻性(prospective)」是先把規則寫死,再去測沒看過的資料,沒有事後調整的機會。「即時(live)」是真的呼叫 API 跑串接,不是離線模擬。
設計是先凍結流程,每個任務抽 100 題當選擇集、用保守規則選 ,再在剩下的題上即時串接。兩個任務都刻意選 JEV 本來就弱的:
- PPE 正確性(500 題):同一模型針對同一題產生的一個對答案、一個錯答案,判官要分出哪個對
- JudgeBench Claude 分組(270 題):JudgeBench 中由 Claude 產生回覆的那一組,之前沒判過
選擇集上 JEV 比 GPT-6 差 12.5 分(PPE)和 17 分(JudgeBench),所以規則選了很嚴的 :PPE 是 0.95,JudgeBench 是 0.99。
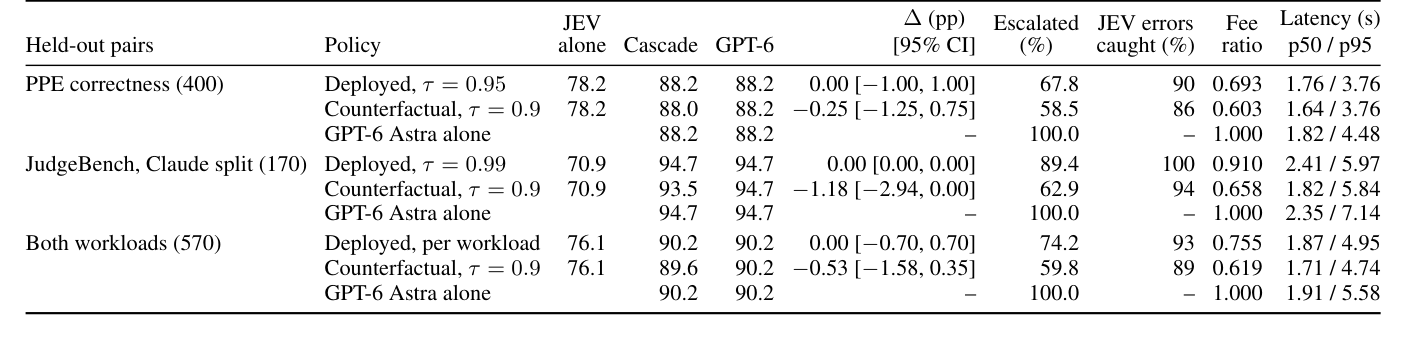
下表是原表的摘要(400、170 題是兩個任務在選出門檻後剩下的 held-out 題數):
| 任務 | JEV 單獨 | 串接 | GPT-6 單獨 | 轉出比例 | 費用(GPT-6 = 1) |
|---|---|---|---|---|---|
| PPE(400 題) | 78.2 | 88.2 | 88.2 | 68% | 0.69 |
| JudgeBench Claude(170 題) | 70.9 | 94.7 | 94.7 | 89% | 0.91 |
| 兩者合計(570 題) | 76.1 | 90.2 | 90.2 | 74% | 0.76 |
怎麼讀:
- 準確度跟 GPT-6 完全一致,保守規則在這兩個任務上沒有選太鬆。
- 但轉出比例高,JudgeBench 的省錢只有 9%。串接能保住的,只有 JEV 本來就答對的那一小部分。
- 反事實對照:如果當初沿用前面的通用 (原表另有一列算這個假設),費用降到 0.62,但準確度掉 0.53 分(區間 [−1.58, 0.35],含 0),在 JudgeBench Claude 分組上掉 1.18 分。所以「換任務要重選 」再次被驗證。
- 延遲幾乎沒有改善,見下表。p95 是第 95 百分位,也就是最慢那 5% 請求的起點。JudgeBench Claude 上串接甚至略慢,因為轉出的題要先等 JEV 再等 GPT-6。
| 延遲 | 串接 | GPT-6 單獨 |
|---|---|---|
| 兩個任務合計:中位延遲 | 1.87 秒 | 1.91 秒 |
| 兩個任務合計:p95 延遲 | 4.95 秒 | 5.58 秒 |
| JudgeBench Claude:中位延遲 | 2.41 秒 | 2.35 秒 |
6 整體評價
這是一份誠實的第三方評測,不是新方法。它的真正產出,是「便宜判官先過一遍、沒把握才轉給貴的」這套流程在哪裡成立、哪裡不成立。工程價值明顯高於研究價值。
研究價值低。 串接分流與保守選門檻都是既有做法,論文自己就引用了 FrugalGPT 一類的串接工作,以及 2017 年的選擇性分類文獻,沒有提出新演算法。能算貢獻的是做法的嚴謹:規則先凍結再驗收、把失敗案例(GPT-5.6 Sol、JudgeBench)攤出來、畫出「讀得出答案/需要推導」的界線。
工程價值中高,但有範圍。
- 成立:答案能從文字直接讀出的任務。RewardBench 只轉 25% 的題、費用 27%,準確度還略勝 GPT-6。
- 失敗時安全:弱任務上(PPE、JudgeBench Claude),串接的準確度仍等於 GPT-6,代價是多花錢(費用 0.69 到 0.91),不是掉分。
- 不成立:沒有證據可對照的任務, 的排序能力等於亂猜,不要用。
串接本身到底帶來什麼,可以看下面這張對照(都是 held-out 或前瞻實驗,不是事後挑的):
| 場景 | JEV 單獨 | 串接 | GPT-6 單獨 | 串接比 JEV 多的準確度(點) |
|---|---|---|---|---|
| RewardBench(1,340 題) | 92.8 | 93.7 | 92.4 | +0.9 |
| JudgeBench(270 題) | 81.3 | 92.2 | 93.0 | +10.9 |
| 前瞻實驗,兩個新任務(570 題) | 76.1 | 90.2 | 90.2 | +14.1 |
串接的功勞是把 JEV 的弱點補到 GPT-6 的水準。「超過 GPT-6」只出現在 RewardBench(+1.27),JudgeBench 沒超過,前瞻實驗是剛好打平。
另外有幾處要打折,所以數字看方向就好:
- 對照組是低推理強度的 GPT-6,不是它的最強設定
- 推廣範圍有限,只涵蓋幾個公開基準與兩個新任務
- 人工裁決(人工複查 JEV 與 GPT-6 跟基準標籤不一致的題)不是獨立進行的
- 論文沒有聲明作者與 TypeSafe(JEV 的提供者)的關係,致謝只提到 NIST、CMU 與 OpenAI 的 API 額度。前言說這是第三方評測,這點是讀的時候要留意的
7 值得帶走的東西
前面說工程價值中高,指的是這套流程在某些任務上能直接拿來用。但論文本身可帶走的新東西很少,真正耐用的收穫在第二類。下面依耐久度排序,最耐久的在前。
7.1 第一類:這篇論文本身的貢獻
7.1.1 一套可照做、且有前瞻驗證的串接流程
流程是:兩個順序平均、在標註題上選 、只轉出 低的題、用沒碰過的題驗收。它不是新方法,論文的價值是把整套流程事前凍結後,在兩個新的弱任務上實測,結果準確度與 GPT-6 一致、費用 0.69 到 0.91。能帶走的經驗是:這個流程在弱任務上不會掉分,只是省得少。
7.1.2 針對 JEV 1.13 量出來的適用界線
答案能從文字讀出的任務,JEV 跟 GPT-6 差在 2 點內;需要推導或核對的任務落後 7 到 28 點;沒有證據可對照的任務,信心完全失效。這個界線是針對特定版本量的,新版本出來就可能移動,但「判官強弱取決於任務是讀還是推導」這個分法本身成立(見第二類「判官能不能用,先問「答案能不能被讀出來或核對」」一項)。
7.1.3 具體數字最不耐久
JEV 的準確度、GPT-6 的費用與延遲,都跟特定模型版本、推理強度與當時定價綁在一起,很快會過期,不用背。
7.2 第二類:脫離這篇論文也成立的東西
7.2.1 評估「會給信心的分類器」,要分三件事看,三者互相獨立
準確度看判決對不對;AUROC 只看 的順序;Brier 與 NLL 看 的數字大小。三者量的是不同的東西,所以一個判官可以在其中一項很好、另一項很差。
| 要問的問題 | 看什麼 | 缺它會怎樣 |
|---|---|---|
| 判決對不對 | 準確度 | 一切白搭 |
| 能不能排出誰比較可能錯 | AUROC | 沒辦法用信心挑題 |
| 的數字能不能當機率讀 | Brier、NLL | 信心數字會誤導 |
具體例子見後面 AUROC 與 Brier 兩節:兩個判官的排序完全一樣、AUROC 都是 0.78,但一個的信心誠實、一個過度自信,Brier 差很多。
用途決定該看哪個指標:只要判決,看準確度;用信心挑出該複查的題(分流、人工覆核),看 AUROC;把信心當機率讀(風險估算、跟別的系統組合),看 Brier 與 NLL。
7.2.2 校準只動數字,不動排序,而且校準綁在任務上
溫度縮放把 logit 差 除以 ,再轉回機率。二選一時,新的信心是 的遞增函數,所以每題的先後順序、判決都不變:
- :兩個標籤的 logit(模型原始分數)差,取正值
- :溫度,一個正數; 是原本的機率, 把機率壓平, 把機率拉尖
- 白話:先把分數差除以 ,再照原本方式轉成機率
自編例子:()。 時 。每一題都被壓平,順序不變,所以準確度與 AUROC 不變,只有 Brier、NLL 會變。
論文的數字就是前面表 2:同一個 JEV,RewardBench 擬合出 (NLL 由 0.192 變 0.216,變差),JudgeBench 是 (0.449 變 0.475,變差),HaluEval 是 (0.496 變 0.304,變好)。方向不一致,其中兩個任務校準後反而更糟。
實務上:只做分流,不需要校準,排序夠好就行;要把 當機率讀,就要用「該任務自己的標註資料」另外校準。
7.2.3 串接的價值,來自「兩個判官錯在不同的題」
串接的結果是,被接受的題用第一階段的答案,被轉出的題用強判官的答案。如果第一階段錯的題,強判官大多答對,轉出去就能補回來。但兩邊都錯的題,怎麼轉都修不回來。
自編例子:100 題,強判官錯 10 題,JEV 錯 15 題,其中 3 題兩邊都錯。如果有一個完美的挑題員,只轉 JEV 會錯的題,剩下的錯題只有那 3 題,串接準確度 97%,比強判官單獨的 90% 還高。如果兩邊的錯一模一樣(15 題全重疊),串接最好也只能做到強判官的水準。
論文的真實數字在前面「串接分流與門檻怎麼選」一節列過(JudgeBench 350 題:JEV 錯 75 題、GPT-6 錯 24 題、共同錯 15 題),完美挑題員可達 95.7%,高於 GPT-6 單獨的約 93%。
選第一階段時要看:
- 選第一階段,除了看便宜,還要看它的錯是否跟強判官不同,也要看它的 能讓你放行多少題(便宜但幾乎放行不了,就省不了錢)
- 串接的天花板是兩者的共同錯,不是強判官自己的準確度
- 兩個判官越像(同家族、同訓練資料),串接越沒用(推論,論文沒有直接測)
7.2.4 判官能不能用,先問「答案能不能被讀出來或核對」
判官的工作是比對,不是從頭解題。答案能直接從文字讀出,小模型就夠;需要自己重新推導才知道對錯,小模型就不及。
自編例子:「這個回答有沒有拒絕使用者?」讀一遍就知道;「這段程式有沒有 bug?」要在腦中執行一遍才知道。
論文的數字:答案能讀出的任務,JEV 跟 GPT-6 差在 2 點內。需要推導的任務落後很多:知識 −7.0、程式 −12.9、數學 −14.3、邏輯謎題 −27.6(JEV 減 GPT-6 的準確度,單位為百分點)。
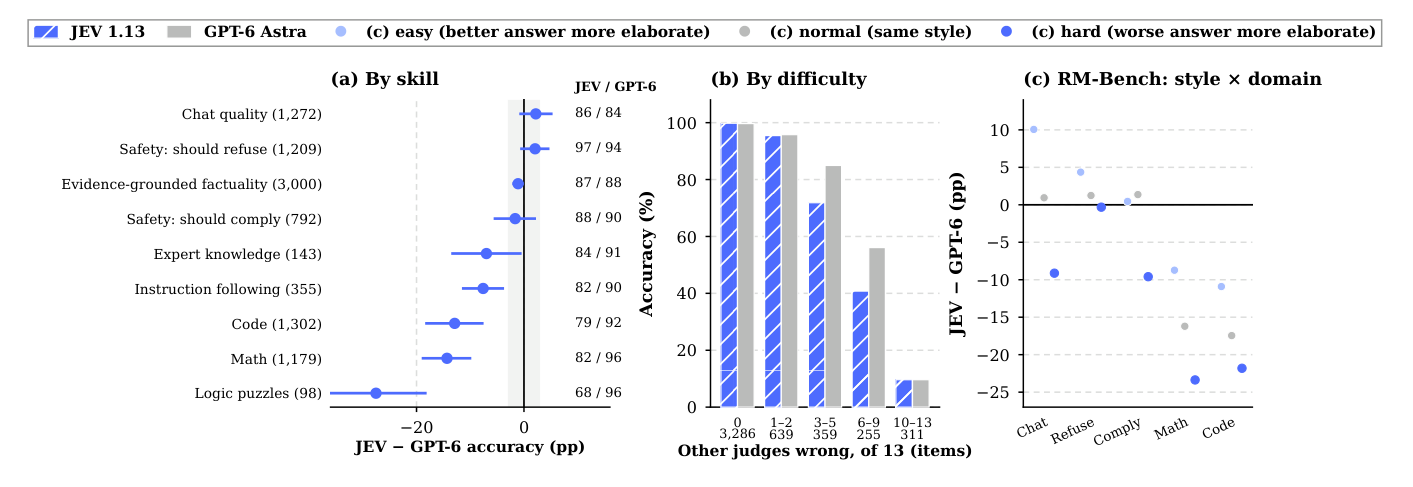
上線前的做法:先把任務分成三類。讀得出答案,便宜判官夠用;需要推導,預期要大量轉給強判官;沒有證據可對照,見下一項。
7.2.5 信心很高,不代表可靠,尤其在判官手上沒有東西可核對的時候
模型的機率反映的是「它對自己輸出的把握」,不是「這個答案跟事實的距離」。判官沒有證據可核對時,它仍然會給一個很有把握的答案。
附錄有一組直接的數字:200 題沒有證據可對照的回答,二選一,丟硬幣是 50%。三個判官都接近丟硬幣,卻都很有把握。JEV 的 AUROC 是 0.498,信心完全分不出對錯。
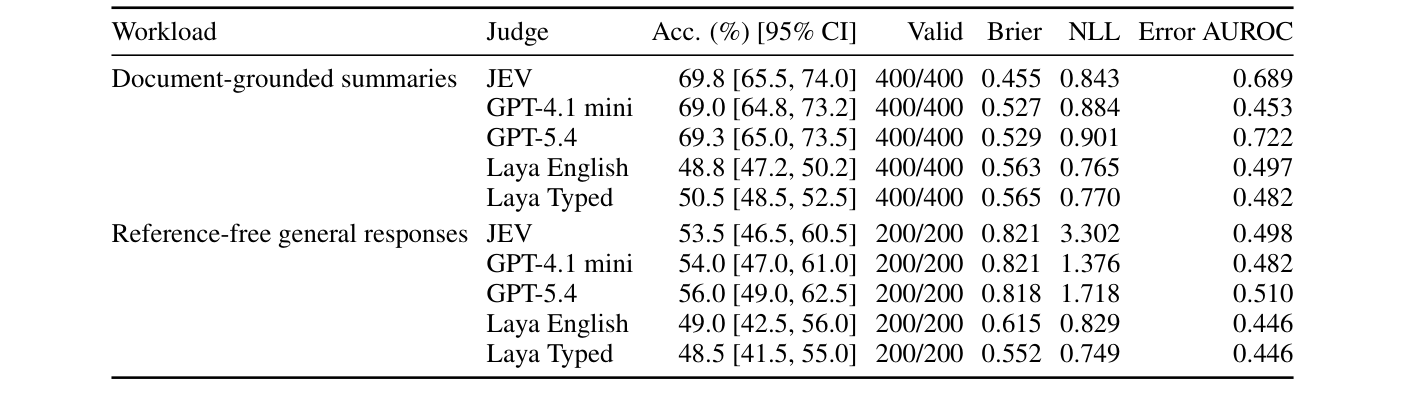
| 判官 | 準確度 | 平均最高機率 |
|---|---|---|
| JEV | 53.5% | 0.91 |
| GPT-4.1 mini | 54.0% | 0.94 |
| GPT-5.4 | 56.0% | 0.96 |
上線前的檢查:
- 信心分流的前提是「信心低的題比較容易錯」,上線前先用標註題量 AUROC 驗證
- AUROC 接近 0.5 時,不要用信心分流;轉出去也沒用,因為強判官也一樣近乎亂猜
- 限制:只有 200 題,論文自己說只能證明結果跟任務有關,不能斷言差別純粹來自有沒有證據。細節見後面「沒有參考答案的文章」一節
7.2.6 設計串接要看「失敗時的樣子」,好的設計失敗時是花更多錢,而不是掉分
串接的安全性來自一個結構: 低就轉給強判官,所以第一階段越不確定,轉出越多,最終答案越接近強判官單獨的結果。第一階段變弱時,系統是把成本推高,而不是把錯誤放行。
支持這點的是前瞻實驗(表 5):兩個任務 JEV 本來就弱,準確度仍與 GPT-6 完全一致,代價是費用接近 GPT-6 單獨的水準(PPE 轉出 68%、費用 0.69;JudgeBench Claude 轉出 89%、費用 0.91)。
這個保證有兩個限制:
- 只在門檻選對時成立。論文的反例:GPT-5.6 Sol 的 選到 0.70,在 JudgeBench 掉了 4.81 分。
- 沒有證據可對照的任務,強判官自己也近乎亂猜,轉出去不會變好,所以「失敗時變貴」的保證在這裡也不成立。
設計原則:設計任何分流或升級機制,都要問兩件事。第一階段失靈時,錯誤是被放行,還是被推高成本?門檻設錯時,壞掉的是哪一邊?好的串接設計,應該讓門檻設保守時,壞掉的永遠是成本這一邊。
8 概念詳解
這一段的每一節都能獨立閱讀,脫離這篇論文也成立。
8.1 資料切分:pilot 剩下的部分做什麼用
論文把 642 筆 pilot 資料切成 select(40%)與 test(60%),select 用來選門檻,那 test 的 60% 做什麼用?
論文沒有明確說明 pilot test 部分的獨立用途。 我在主文與附錄都沒找到它單獨出現在任何結果裡;溫度縮放的驗證與門檻的驗收,都是用 held-out,不是用 pilot test。
論文有講的是:pilot 在任何模型推論之前就先凍結;select 只用來擬合溫度與路由門檻。「source-cluster」的意思是,同一個題目的重複回答會留在同一邊,避免同題目同時出現在 select 與 test。數字就是前面「評測設計」那張表,單位是判斷次數。pilot 的 642 筆 = select 128 + test 192 + 不切分的 322。
我的推論(不是論文原文):pilot test 大概沒有獨立角色,只是併進表 1 的總體準確度。證據是 RewardBench 的 160 加 1,340 剛好等於表 1 的 1,500 筆,表示 pilot 的所有題目(含 select 與 test)都算在總體準確度裡。
這個切法有一個後果:select 的 128 筆同時也算進表 1 的準確度,所以那些數字不是完全乾淨的 held-out 結果。不過 128 筆佔 5,172 筆很小,對結論影響有限,不算嚴重缺失。
通用觀念是為什麼要把資料分成不同角色:
| 角色 | 做什麼 | 為什麼要獨立 |
|---|---|---|
| select(選擇集) | 決定參數,例如門檻 、溫度 | 這份資料已經被「看過」,用來選參數 |
| held-out(驗收集) | 只在最後驗收一次 | 必須完全沒參與選擇,數字才可信 |
用來選參數的資料,不能同時拿來證明參數選得好。舉例(自編):你在一批題目上挑出讓準確度最好的 ,再在同一批題目上報告準確度,數字當然好看,但那只是在證明「這個 適合這批題」,不是「這個 適合新的題」。把驗收用的題完全隔開,才能知道換到沒看過的題會怎樣。
8.2 AUROC:用排隊看懂它
AUROC 只問一件事:把所有題目照 從低到高排成一排,答錯的題是不是排得比答對的題前面?
它的全名是 Area Under the ROC Curve,在這裡衡量「 排序錯題的能力」。白話意思是:隨機抽一題答錯的、一題答對的,答錯那題的 比較低的機率。0.5 等於亂猜,1 等於完美。
自編例子:6 題,JEV 對 3 題答錯、3 題答對,每題有一個 。先照 由低到高排隊:
| 排序 | 實際 | |
|---|---|---|
| 1 | 0.55 | 錯 |
| 2 | 0.60 | 對 |
| 3 | 0.70 | 錯 |
| 4 | 0.90 | 錯 |
| 5 | 0.95 | 對 |
| 6 | 0.99 | 對 |
如果 是個完美的錯題偵測器,3 題錯的會全部排在最前面。實際上第 2 名是答對的,混在錯題中間。
要把「排得好不好」變成一個數字,做法是把每一題錯的跟每一題對的配成一對,共 3 × 3 = 9 對,每一對只問「錯的那題, 是不是比對的那題低?」
| 錯題 \ 對題 | 0.60 | 0.95 | 0.99 |
|---|---|---|---|
| 0.55 | ✓ | ✓ | ✓ |
| 0.70 | ✗ | ✓ | ✓ |
| 0.90 | ✗ | ✓ | ✓ |
9 對裡有 7 對排對了,所以 AUROC = 7 / 9 ≈ 0.78。
數字的感覺如下(一般知識,不是論文內容):
| AUROC | 感覺 |
|---|---|
| 0.5 | 跟對錯完全無關,等於丟骰子 |
| 0.7 | 有點用,但排錯題的能力不穩 |
| 0.8 到 0.9 | 實用等級,大部分錯題會排在對題前面 |
| 1.0 | 完美,實務上幾乎不會出現 |
AUROC 只看順序,不看 的大小。 把上表的 全部改成 0.01、0.02、0.03……只要順序不變,AUROC 還是 0.78。
這個盲點的後果(自編例子):沿用同樣 6 題,實際只答對 50%。判官 X 的 是 0.55、0.60、0.70、0.90、0.95、0.99;判官 Y 的 是 0.950、0.960、0.970、0.980、0.985、0.990。兩者排序一模一樣,AUROC 都是 7/9。但判官 Y 每題都宣稱有 95% 以上的把握,實際只對一半。AUROC 完全看不出兩者的差別,這要靠 Brier 之類的指標(見後面「怎麼量校準」)。
回到論文:HaluEval 上,GPT-6 與 JEV 的 AUROC 幾乎一樣(0.831 對 0.827),但 Brier 並不相同(0.213 對 0.196)。排序能力相同,機率品質不同。(不過前面「信心:定義與驗證」一節提過,這個 Brier 差距經不起標籤修正,這裡只拿來說明「AUROC 相同時 Brier 可以不同」。)
論文裡的數字(單次呼叫的 AUROC)就是前面「信心:定義與驗證」那張表的前兩欄。RewardBench 與 HaluEval 上,JEV 的 排錯題的能力跟 GPT-6 差不多。JudgeBench 才是重點:GPT-6 是 0.907,JEV 是 0.745。這是最難的一組題目,GPT-6 不只答得比較準,也比較「知道自己什麼時候會錯」。
看一個會給信心的分類器,AUROC 只回答「 能不能排出誰比較可能錯」,不回答「 是不是真的代表 90% 會對」,也不回答「判決對不對」。三者要分開看。
8.3 AUROC 低時,分流會變成什麼樣
AUROC 低,代表很難知道哪些題該交給貴的判官,所以要多付錢、或多承擔錯誤,但不是「全部轉出去」。
分流要的就是「把可能錯的題挑出來轉給貴的判官」。AUROC 高,只轉少量題目,就能攔下大部分錯題;AUROC 低,要轉很多題才攔得住,省下的錢就少了。
AUROC 低不代表只能把大部分題目都交給貴的判官。方向上確實要多轉,但實際上是你在「轉出多少題」和「漏掉多少錯題」之間取捨,AUROC 低只是讓這筆交易變貴。
自編例子(粗估,只為說明方向):100 題裡有 10 題 JEV 會答錯。
| AUROC 高(約 0.9) | AUROC 低(約 0.6) | |
|---|---|---|
| 想攔下 8 題錯題 | 轉約 20 題就夠 | 可能要轉 60 題以上 |
| 只轉 20 題 | 能攔下約 8 題錯題 | 只能攔下約 3 到 4 題錯題 |
AUROC 低時你有兩種選擇:多付錢(轉更多題),或多承擔錯誤(轉一樣多、漏掉更多錯題)。「全部轉」是其中最極端的選法。
論文的實測:門檻 時,4,850 題裡轉走 1,106 題(約 23%),其餘 3,744 題直接用 JEV 的答案。這 23% 就是「在 JEV 的 排序能力下」選出的取捨點。
8.4 校準:機率說 90%,實際是不是 90%
校準(calibration)就是模型說「有 90% 把握」的那些題,實際上真的大約有 90% 是對的:
- :模型給的信心
- :某個具體的信心數值,例如 0.9
- 左邊:在所有 剛好等於 的題目中,判決正確的比例
- 白話:信心 0.9 的題目,正確率就該是 0.9
自編例子:判官 Y 對 100 題都說 ,實際只對 50 題。理想上該有 96 題對,實際只對 50,所以 Y 是過度自信(overconfident)。反過來,如果說 0.6 卻對了 90%,就是信心不足(underconfident)。
排序與校準是兩個獨立的性質:
| 校準好 | 校準差 | |
|---|---|---|
| 排序好 | 理想 | 能排出錯題,但數字不能直接讀 |
| 排序差 | 數字誠實,但幫不上忙 | 兩頭落空 |
評估一個會給信心的分類器,至少有三個獨立的問題:判決對不對看準確度, 能不能排出誰比較可能錯看 AUROC, 的數字本身可不可信看校準指標(Brier 等)。一個判官可以在其中一項很好、另一項很差。AUROC 只管排序,校準指標見下一節。
8.5 怎麼量校準:可靠度曲線、Brier、ECE、NLL
量校準有幾種常見工具,差別在於你想看「哪裡偏」還是「總共偏多少」。
8.5.1 可靠度曲線(reliability curve):看哪裡偏
把題目依 的大小切成幾個區間,每個區間算一個點,一條曲線就是幾個點連起來:
| 要算的 | 怎麼算 | 畫在哪 |
|---|---|---|
| 平均信心 | 區間內所有題目 的平均 | 橫軸 |
| 實際正確率 | 區間內答對的題數 ÷ 總題數 | 縱軸 |
完美校準時,每個點都落在 的對角線上。
自編例子:10 題, 與對錯如下,切成 3 個區間。
| 區間 | 區間內的 | 平均信心 | 答對 | 正確率 |
|---|---|---|---|---|
| 0.5 到 0.7 | 0.52、0.58、0.63、0.67 | 0.60 | 2/4 | 0.50 |
| 0.7 到 0.9 | 0.72、0.78、0.85 | 0.78 | 2/3 | 0.67 |
| 0.9 到 1.0 | 0.91、0.96、0.99 | 0.95 | 3/3 | 1.00 |
三個點是 (0.60, 0.50)、(0.78, 0.67)、(0.95, 1.00)。
區間怎麼切有兩種方法(一般知識,不是論文內容):
| 等寬分組 | 等量分組 | |
|---|---|---|
| 做法 | 每組寬度一樣,例如 0.0 到 0.1、0.1 到 0.2…… | 每組題數一樣,邊界由資料決定 |
| 優點 | 簡單,橫軸容易讀 | 每個點的可信度相近 |
| 缺點 | 題目常堆在少數幾組,其他組只有幾題,點很抖 | 單組的 範圍可能很寬 |
經驗法則: 的分布集中在一端時,用等量分組,或把擠滿題目的那一端切細。
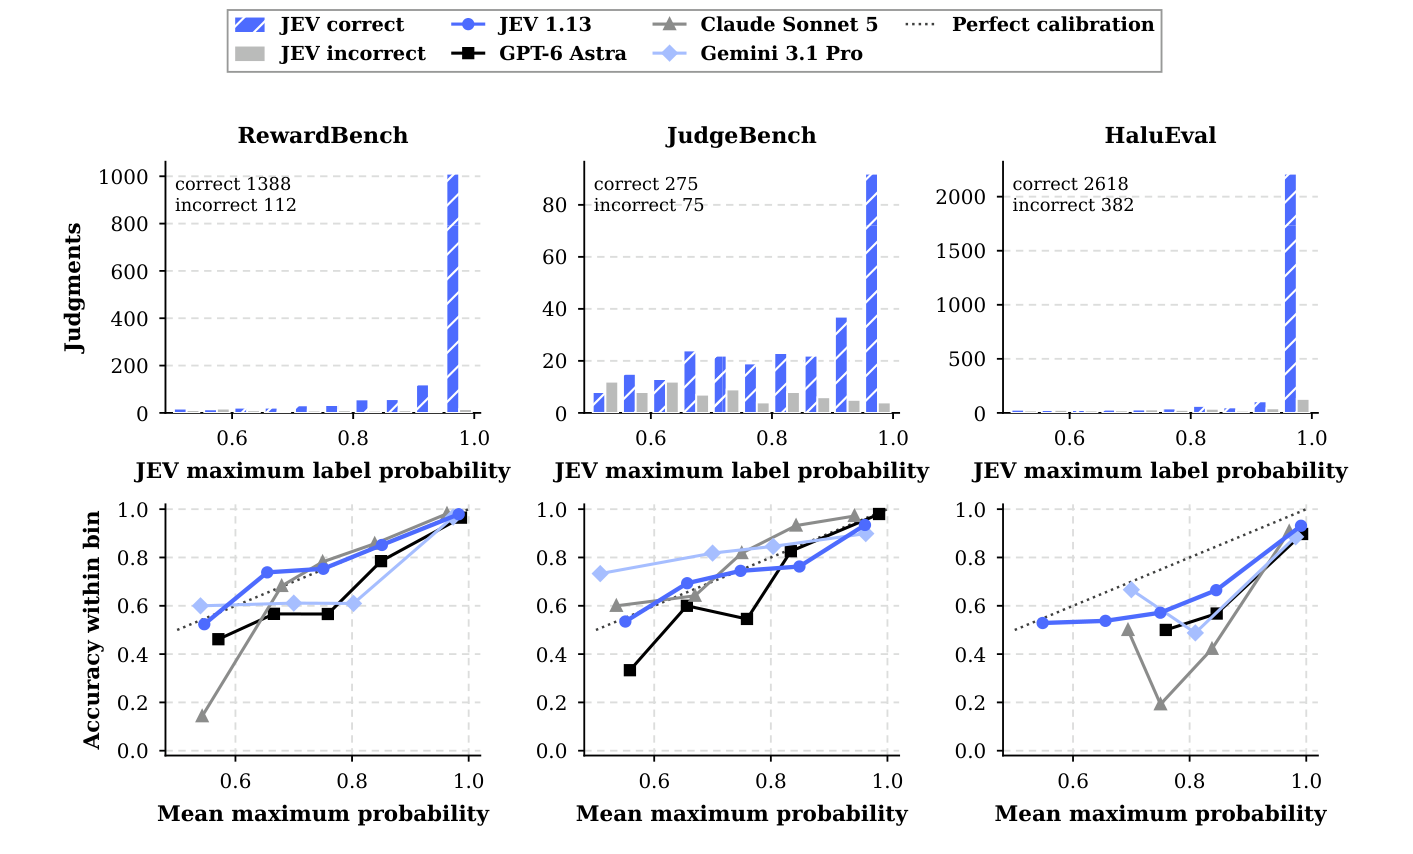
論文裡的可靠度曲線在下面這張圖的下排。圖說只寫了「每組至少要有 5 題才畫」,邊界怎麼切沒有明講。前面圖 2 的邊界不等寬(<0.6、0.6、0.7、0.8、0.9、0.95、0.99、=1),高信心端切得特別細,因為 JEV 的 大量堆在接近 1 的地方( 就有 2,332 題)。
8.5.2 Brier 分數:總共偏多少,一個數字
- :第 題的信心
- :第 題實際結果,答對 1、答錯 0
- :題數
- 白話:每題「信心與結果的差」平方後取平均,越低越好
自編例子:沿用 AUROC 那 6 題。判官 X 的 是 0.55、0.60、0.70、0.90、0.95、0.99,結果是 錯、對、錯、錯、對、對,Brier 。判官 Y 的 是 0.95、0.96、0.97、0.98、0.985、0.99,同樣結果,Brier 。排序一樣(AUROC 都是 0.78),Brier 卻差很多。
這是簡化版,只看 對不對。論文的 Brier 對所有標籤的機率計算,細節略有不同。
8.5.3 ECE(期望校準誤差):把可靠度曲線壓成一個數字
- :分成幾組
- :第 組有幾題;:全部題數
- :第 組的實際正確率
- :第 組的平均信心
- 白話:每組算「偏多少」,題目多的組算得重一點,再加總
用上面可靠度曲線的 10 題例子算:
| 區間 | 題數 | 平均信心 | 正確率 | 差距 | 權重(題數 ÷ 10) | 貢獻 |
|---|---|---|---|---|---|---|
| 0.5 到 0.7 | 4 | 0.60 | 0.50 | 0.100 | 0.4 | 0.040 |
| 0.7 到 0.9 | 3 | 0.78 | 2/3 | 0.113 | 0.3 | 0.034 |
| 0.9 到 1.0 | 3 | 0.95 | 1.00 | 0.050 | 0.3 | 0.015 |
ECE 0.089,意思是平均偏差約 9 個百分點。
兩個設計值得注意:取絕對值,是為了讓「過度自信」和「信心不足」不會互相抵消;用題數加權,是因為題目少的組本來就不可靠。ECE 的缺點(一般知識)是它的值會隨分組方式改變。
論文的用法:主文以 Brier 和 NLL 為主;附錄也報 ECE(用 10 個最大機率區間)。主文為什麼不選 ECE,論文沒有說明。
8.5.4 NLL(負對數似然):特別嚴懲「很有把握卻答錯」
每題取「模型給正確答案的機率 」,算 ,再對所有題平均,越低越好。
| 模型給正確答案的機率 | |
|---|---|
| 0.9 | 0.11 |
| 0.5 | 0.69 |
| 0.1 | 2.30 |
| 0.01 | 4.61 |
跟 Brier 的差別在於:一個判官有 99% 把握卻答錯,等於給正確答案只有 0.01。Brier 的這題懲罰最多是 1(平方後頂多 1),NLL 是 4.61,而且 越接近 0 它會一直往上衝,沒有上限。所以 NLL 對「很有把握卻答錯」特別嚴格,Brier 比較溫和。論文同時報兩個,就是為了從兩個角度看機率品質。
8.6 為什麼模型常常校準不好
訓練時沒有任何一項在逼模型「機率要說實話」,而且有些訓練步驟還會推它過度自信。以下是一般知識,不是論文內容。
原因 1:訓練目標只獎勵「答對」,不獎勵「機率誠實」。 類比一下:考試只看你有沒有選對,沒人檢查你寫的「我有幾成把握」,時間久了,你就沒有理由學會把把握度寫準。
底層機制是這樣:分類模型最後會把原始分數(logits)轉成機率(softmax)。訓練用的損失函數 cross-entropy(其實就是 NLL)在答對時,仍然會因為「正確答案的機率還沒到 1」而繼續給獎勵。自編例子,兩個類別的 logits:
| logits(對的、錯的) | 對的那類機率 | 答對時的損失 |
|---|---|---|
| [2, 0] | 0.881 | 0.127 |
| [4, 0] | 0.982 | 0.018 |
兩種情況判決都對,但第二種損失更低。所以訓練會一直把分數差拉大,機率越來越靠近 1,但對的機率不會因此真的跟著變高。這是 Guo et al. 2017(論文也引用)指出的現象,現代深度網路普遍偏向過度自信。
原因 2:後訓練(post-training)會把機率推向極端。 預訓練模型的 token 機率通常還算誠實,經過 RLHF 這類以人類偏好為目標的訓練後,輸出會被推向「聽起來很肯定」。
原因 3:校準是「對某一種題目」才成立的。 在 A 類題目上調好的機率,換到 B 類題目就會跑掉,因為模型在不同題目上的難度與錯法不同。論文的直接證據在論文 7.2 節:同一個 JEV、同一套溫度縮放流程,在 RewardBench 上擬合出 (把機率調尖),在 JudgeBench 和 HaluEval 上卻是 與 (把機率調平)。
8.7 二選一時 q 與 logit 差、溫度縮放、為什麼不改準確度與 AUROC
二選一時, 只由「兩個分數的差距」一個數字決定;溫度縮放就是把這個差距整體除以 ,所以判決與題目之間的先後順序都不變,變的只有機率數字。以下針對二選一(論文的主要任務),內容是一般知識,除非特別註明。
8.7.1 q 與 logit 差的關係
logit 是模型對每個標籤的原始分數,softmax 把它們轉成機率。兩個標籤時:
- 、:兩個標籤的 logit
- :兩者的差,記為
- 白話:兩個分數的絕對大小不重要,只有差距決定機率
對 JEV 要小心:論文通篇沒有提到 logit,也沒說 JEV 內部怎麼產生機率,所以「JEV 是不是由 logit 差算出」,論文沒有講。但不需要知道,只要有機率,就能反推出 ,這叫 log-odds(對數勝算):
自編例子:判官說某題 ,。
8.7.2 溫度縮放怎麼做
- 拿到機率
- 換成分數差
- 除以
- 轉回機率
- 在選擇集上試很多個 ,挑讓 NLL 最低的
- 拿去 held-out 驗收
機率被壓平,比較不自信; 機率被拉尖,更自信; 是原本的機率。
自編例子,logits 是 [4, 0](),對的那類機率隨 變化如下:
| 除完的分數差 | 對的那類機率 | 效果 | |
|---|---|---|---|
| 0.5 | 8 | 0.9997 | 調尖,更自信 |
| 1 | 4 | 0.982 | 原本 |
| 2 | 2 | 0.881 | 調平 |
| 4 | 1 | 0.731 | 調得更平 |
白話:判官對某批題目都說 0.982,實際只對 7 成。 把機率降到 0.731,接近真實的 0.7,所以 大約落在這一帶。(實際擬合是讓全部題目的 NLL 最低,不是對齊單一數字。)
論文的做法是用 select set 擬合 ,再到 held-out 驗收(表 2)。第 2 步用機率反推 是我的推論,論文沒有交代它實際怎麼對 JEV 做縮放。
8.7.3 為什麼不改準確度與 AUROC
這裡有兩個不同層次的排序,不能混在一起:
| 指標 | 不變的原因 |
|---|---|
| 準確度 | 判決取的是機率最大的那個標籤。每個分數都除以同一個 ,各標籤之間誰大誰小不會變,所以選的標籤不變 |
| AUROC | 它看的是不同題目之間 的排序。二選一時, 是 的遞增函數,調 只是把它整體壓平或拉高,題目之間的先後順序不變 |
自編例子:3 題,logit 差 分別是 0.5、1.5、3.0。
| 題目 | 的 | 的 | |
|---|---|---|---|
| 甲 | 0.5 | 0.623 | 0.562 |
| 乙 | 1.5 | 0.818 | 0.679 |
| 丙 | 3.0 | 0.953 | 0.818 |
從 1 變 2,每一題的 都往 0.5 靠,但甲 < 乙 < 丙 的順序沒變。所以如果原本錯題都排在前面,現在還是排在前面,AUROC 不會變。
調 之後,準確度與 AUROC 不變,Brier、NLL、ECE 會變(這三個都在量「機率數字準不準」)。溫度縮放只修「校準」,這正是準確度、AUROC、校準指標各管一件事的好處。
8.8 驗證 q 的那一步,是選門檻的必要條件嗎
方法流程裡有「驗證 好不好用」(AUROC、Brier、NLL)這一步,但只要有「在標註題上模擬串接、選 」與「用 held-out 驗收」這兩步,似乎就能選出最好的門檻,為什麼還需要驗證 ?
就「選出 」這件事,驗證 不是必要的。 模擬串接時直接量最終結果(花多少錢、掉多少分),已經包含了 好不好用的資訊。驗證 是診斷,不是前置條件。
驗證 能多做的事:
| 驗證 多給的東西 | 模擬串接能不能給 |
|---|---|
| 為什麼會失敗:是排序差,還是機率偏? | 不能。模擬只會告訴你「沒有 通過」或「通過」 |
| 判斷這個任務值不值得做串接 | 部分能。例如沒有參考答案的文章 AUROC 0.498,模擬最後也會得到「全部轉出去」,但你得先跑完兩個判官才知道 |
| 換強判官時可以重用(推論,論文沒這樣講) | 不能,每換一個強判官,模擬都要重做 |
第一項是主要價值。第二項只是省一點成本:AUROC 只需要第一階段判官跑過、有標準答案,不用付強判官的費用。
Brier 與 NLL 更不是必要的。分流只用到 的排序,不用把 當機率讀,所以它們完全不影響 怎麼選。它們的用處是:你想把 當「答對機率」來報告、跟別的判官比較機率品質,或做別的需要機率數字的事。
工程上的判斷:
- 要選 :只需要「模擬串接」與「驗收」
- AUROC 當成便宜的前置篩檢就好,Brier、NLL 可以省略
- 論文把驗證 寫那麼完整,是因為它要回答研究問題「這個做法在哪些任務上成立」,這是研究價值,不是部署必要
一個保留(推論):選 的標註資料很少時,結果會不穩(見前面的「保守規則」),這時 AUROC 可以當作交叉檢查。論文沒有驗證這個用法。
8.9 串接有哪幾種設計、論文驗證了哪些
論文只實測了「獨立、替換」這一種,另外兩種沒有驗證,所以不能說它是最好的。論文自己的說法是,融合、讓強判官看 JEV 的判決、以及把兩個判官錯誤的相關性納入規則,都留給未來研究(論文第 7 節末尾)。
三種設計都是「便宜判官先判、沒把握轉給強判官」,差別在強判官怎麼用:
| 設計 | 做法 | 缺點與來源 |
|---|---|---|
| 獨立、替換(論文選的) | 強判官不看 JEV 的答案,直接取代 | 強判官也答錯的題,修不回來(論文原文) |
| 讓強判官看 JEV 的判決 | 資訊多,像辯論 | 兩者錯誤變得互相依賴(論文原文) |
| 兩個都判全部再融合 | 取機率平均 | 強判官每題都要付費,省不了錢(我的推論,論文沒有測融合,也沒有算它的費用) |
論文實際比較過的,是別的東西:
| 比較對象 | 在回答什麼 | 能不能說明「這個設計最好」 |
|---|---|---|
| 隨機轉出,花同樣的錢(後面圖 7 的灰線) | 用 挑題,比亂挑好嗎 | 不能,只證明 有用 |
| 換不同的強判官(GPT-5.4、GPT-5.6 Sol、GPT-6) | 這個設計換判官還成立嗎 | 不能,設計沒變 |
| 換不同的第一階段判官 | JEV 是不是特別適合當第一階段 | 不能,設計沒變 |
這三組比較都固定在「獨立、替換」之下。所以論文能支持的結論是:在這個設計下,用 分流有效,而不是「這個設計優於其他設計」。
我的看法(推論):這個設計是最簡單、最省錢、最容易部署的一種,但「最簡單」不等於「最好」。要不要換成別種組合,只能靠自己的資料測。
8.10 沒有參考答案的文章是什麼意思、為什麼信心會失效
「沒有參考答案」指判官只拿到「問題加回答」,手上沒有任何證據文件或標準答案可以對照,要完全靠自己的知識判斷這段回答有沒有胡說(幻覺)。在這種任務上,JEV 的 既不準,也分不出該轉給誰。
自編例子對照:
| 有證據可對照 | 沒有參考答案 | |
|---|---|---|
| 判官拿到什麼 | 一份文件加一句摘要 | 只有一個問題加一段回答 |
| 問什麼 | 摘要有沒有被文件支持? | 這段回答有沒有胡說? |
| 判官怎麼判 | 把摘要拿去跟文件對照 | 只能靠自己腦中的知識猜 |
論文的數字見前面表 6 和它下方的小表:200 題沒有參考答案的一般回答,二選一,三個判官都接近丟硬幣,卻都很有把握(平均最高機率 0.91 到 0.96)。JEV 的 Brier 是 0.821,AUROC 是 0.498,也就是 完全分不出哪些題會錯。
這會讓串接失效,因為分流的前提是「 低的題比較容易錯」。這裡 都很高,而且高低跟對錯無關,所以沒有任何門檻能把該轉的題挑出來。而且就算轉出去,強判官 GPT-5.4 也只有 56%,轉了也沒用。論文的結論是「沒有任何受測判官能用在這類題目上」,所以這不是 JEV 特有的問題。
要保留的限制:
- 只有 200 題,95% 信賴區間 [46.5, 60.5]
- 論文自己說,這組跟有證據的那組在內容和標籤來源上都不同,所以只能說「結果跟任務有關」,不能斷言差別純粹來自有沒有證據
通用觀念:信心反映的是模型對自己輸出的把握,不是答案跟事實的距離。判官沒有東西可核對時,它仍然會給一個很有把握的答案,所以上線前一定要用標註題量 AUROC 驗證信心有沒有用。
8.11 串接的成本與準確度怎麼取捨
任何串接都有成本與準確度的取捨,連把題目隨機轉給強判官也有。論文真正想證明的是:用 挑題,比隨機挑好,而且你能事先知道在哪些任務上成立。
門檻設高,仍然能省一點成本。 表 5 的 JudgeBench Claude 分組,、轉出 89.4% 的題,準確度跟 GPT-6 完全一樣(94.7%),費用只省到 0.91。
直接用強判官是最穩的基準,但不一定最快:
- 最穩:準確度最高的就是直接用強判官
- 延遲:轉出去的題要先等 JEV 再等 GPT-6,JudgeBench Claude 的中位延遲 2.41 秒,比 GPT-6 單獨的 2.35 秒還慢
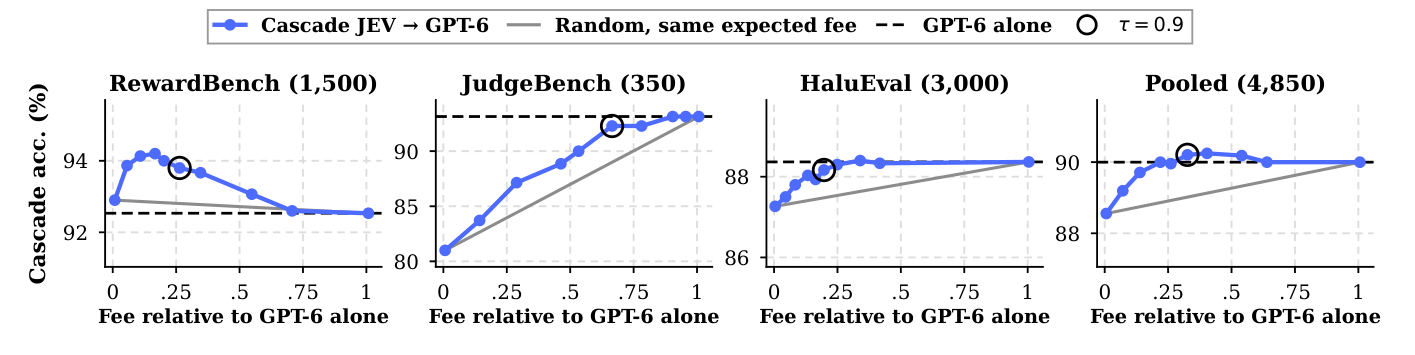
用 挑題比隨機好,下面這張事後掃描可以看到。它是在同一批題上讀出的,所以偏樂觀: 時串接 90.2%,隨機轉出同樣費用只有 89.0%。曲線形狀才是重點,不是權衡本身。
選門檻看起來只是窮舉,但難點不在搜尋。 只有一個參數、候選值才 7 個,窮舉本身很便宜。真正難的是標註題很少時,量到的掉分很不穩,論文用保守規則處理(見前面「門檻怎麼選」一節)。這個規則不是新方法,容忍度是人訂的,也沒有統計保證;論文提到若知道錯誤成本,門檻應由成本比推出,但沒有實測。
9 結論
這篇論文證明了一件有範圍的事:用 JEV 的最大標籤機率 當信心,沿著「有把握就採用、沒把握就轉給 GPT-6」分流,在答案能從文字讀出的任務上又準又省(RewardBench 費用 27%、準確度略勝 GPT-6),在難任務與新任務上,門檻選對時準確度不掉、但省得有限(9% 到 33%)。
幾個要記住的點: 只適合排序,不適合當機率讀; 是第一階段判官、強判官、任務三者的函數,換任何一個都要用自己的標註資料重選;沒有證據可對照的任務,信心完全失效,不要用。具體的準確度與費用數字會很快過期,真正耐用的是 AUROC 與校準的分工、資料切分的紀律,以及「好的串接失敗時是變貴,而不是變錯」這個設計原則。