範例不是塞越多越好:Many-Shot CoT-ICL 的三個反直覺發現與 CDS 排序法
 Hong-Wei Wu
收錄於 論文介紹
1 前言
長上下文模型讓我們可以一次塞進幾十甚至上百個範例做語境學習(In-Context Learning, ICL),過去在分類、意圖辨識這類簡單任務上,業界累積出兩條近乎常識的經驗法則:範例越多越好、順序基本不影響結果。這篇論文「Many-Shot CoT-ICL: Making In-Context Learning Truly Learn」要問的問題是:當範例本身帶著思維鏈(Chain-of-Thought, CoT),任務也換成幾何證明、數論這種需要多步推理的題目時,這兩條法則還站得住腳嗎?
答案是不太行。作者發現 Many-Shot CoT 在推理任務上會出現一系列反直覺的翻車現象,範例給得越多表現反而越不穩定,找「最相似」的範例當參考居然是陷阱,順序的影響力也隨著範例數量增加而暴增。針對這些問題,論文提出兩個設計原則——範例內容要「看得懂」、範例順序要「夠平滑」——並用一個叫 CDS(Curvilinear Demonstration Selection)的排序演算法把第二個原則落地。這篇筆記會照著這個脈絡,把論文的核心發現和 CDS 的運作機制講清楚。
- 在需要多步推理的任務上,ICL 的舊法則全面失效:範例越多準確率反而震盪甚至下滑,順序造成的標準差也隨範例數暴增——但這只發生在非推理模型身上,QwQ、DeepSeek-R1 這類內建顯式推理機制的模型仍呈現正向 scaling。
- 語意相似度檢索在推理任務上是陷阱:「最相似」的範例表現一致地比「最不相似」和隨機挑選還差,因為語意相似不等於解題程序相容。
- 內容原則是「分佈對齊」:模型自己生成的思維鏈(就算算錯)表現穩定勝過資料集的人類標準答案。
- 排序原則靠 CDS 落地:把範例排序當成高維空間的 TSP 問題求解,同時最小化距離與轉彎曲率,單核 CPU 一分鐘內跑完,不用動模型參數。
2 一、典範轉移:ICL 不是抄答案,而是「測試時的即時學習」
要理解為什麼舊法則會失效,得先搞懂作者對 ICL 的重新定義。
傳統上我們把長上下文當成一個靜態的檢索緩衝區:模型在 Prompt 裡找和目前問題表面特徵最像的範例,然後把答案格式「抄」過來。這套邏輯在分類任務上很管用,畢竟分類只需要辨識標籤的分佈特徵。但作者主張,面對複雜推理時,Many-Shot CoT 實際上更接近一種無梯度的即時適應——Prompt 不再只是參考資料,而是模型在 forward pass 當下用來動態塑造內部解題程序的訓練訊號。這個「模型在推論當下邊做邊學」的視角,和我們之前介紹過的 Dynamic Cheatsheet 的測試期學習(test-time learning)思路是同一條脈絡。
換個方式理解:傳統做法像是給學生一張寫滿考古題的小抄,考試時字面對得上就直接抄答案,簡單題目夠用。但複雜的數學推理題型一變、數字一換就沒用了,這時候學生需要的是一本「考前衝刺講義」——難易度要貼近他目前的理解程度,題目編排也要循序漸進。
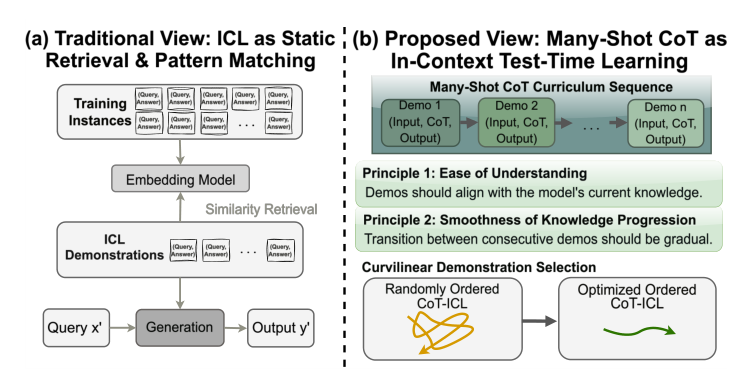
這個「教育學視角」的轉換,直接導出了論文後面兩個核心設計原則:內容要可理解、順序要平滑。下一節先看看,如果沒有照著這兩個原則做,會踩到哪些坑。
3 二、三個反直覺現象:Many-Shot CoT 到底哪裡出問題
3.1 2.1 範例越多,模型反而越亂
按照舊法則,範例數量從 16 增加到 128,表現應該穩步上升。論文在非推理任務(如 SuperGLUE、BANKING77)上確實觀察到這個趨勢,但換成幾何、數論、GSM8K 這類推理任務,準確率曲線開始劇烈震盪,甚至明顯下滑。
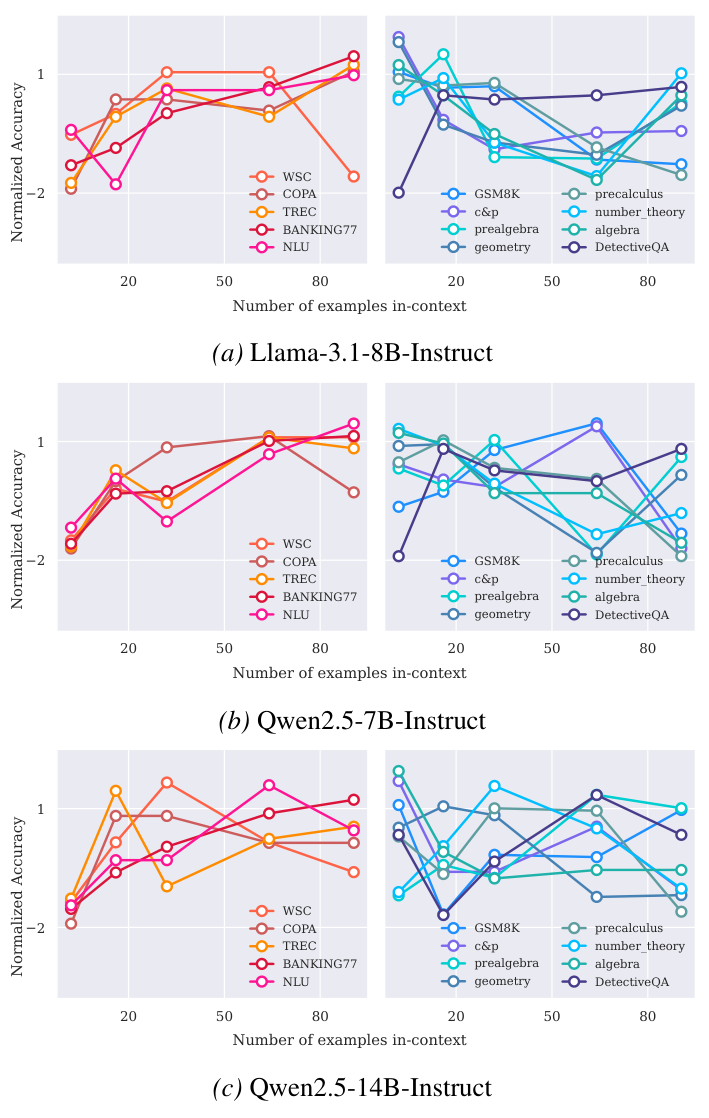
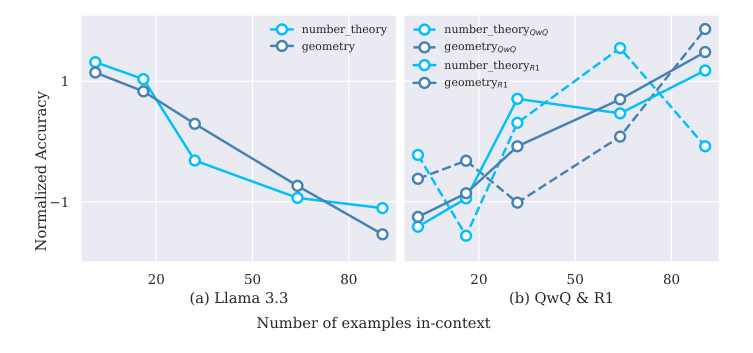
這個負面 scaling 一開始看起來像是模型規模不夠大導致的,但作者發現即使把規模拉到 LLaMA 3.3 70B,增加範例照樣帶來負面收益。真正的分野不在規模,而在模型類型:像 QwQ、DeepSeek-R1 這種訓練時就內建顯式推理機制(例如產生 <think> 標記)的「推理模型」,在同樣的任務上反而隨範例增加穩定進步。
這其實不難想像:找一個資質普通的學生,塞給他一本一百頁、寫滿複雜幾何證明題的題庫,卻沒給任何引導。他不會因為多看幾頁就突然開竅,反而容易被龐大的資訊量搞到腦袋打結,連原本會寫的簡單題都寫錯。
3.2 2.2 找「最相似」的範例,反而是陷阱
傳統 RAG 的黃金標準是語義相似度檢索——找字面上最像測試題的範例,模型最容易模仿。但論文發現,在推理任務裡,最相似的範例往往是毒藥。
問題出在「語義相似」不等於「程序相容」。舉個論文裡的例子:兩道幾何題字面上都提到「直角三角形、角度為 30°-60°-90°」,語義相似度極高,但一題要用三角形相似性質證明邊長關係,另一題要用畢氏定理和面積公式求高。如果模型照抄第一題的解題步驟去解第二題,邏輯完全對不上,自然全盤皆輸。
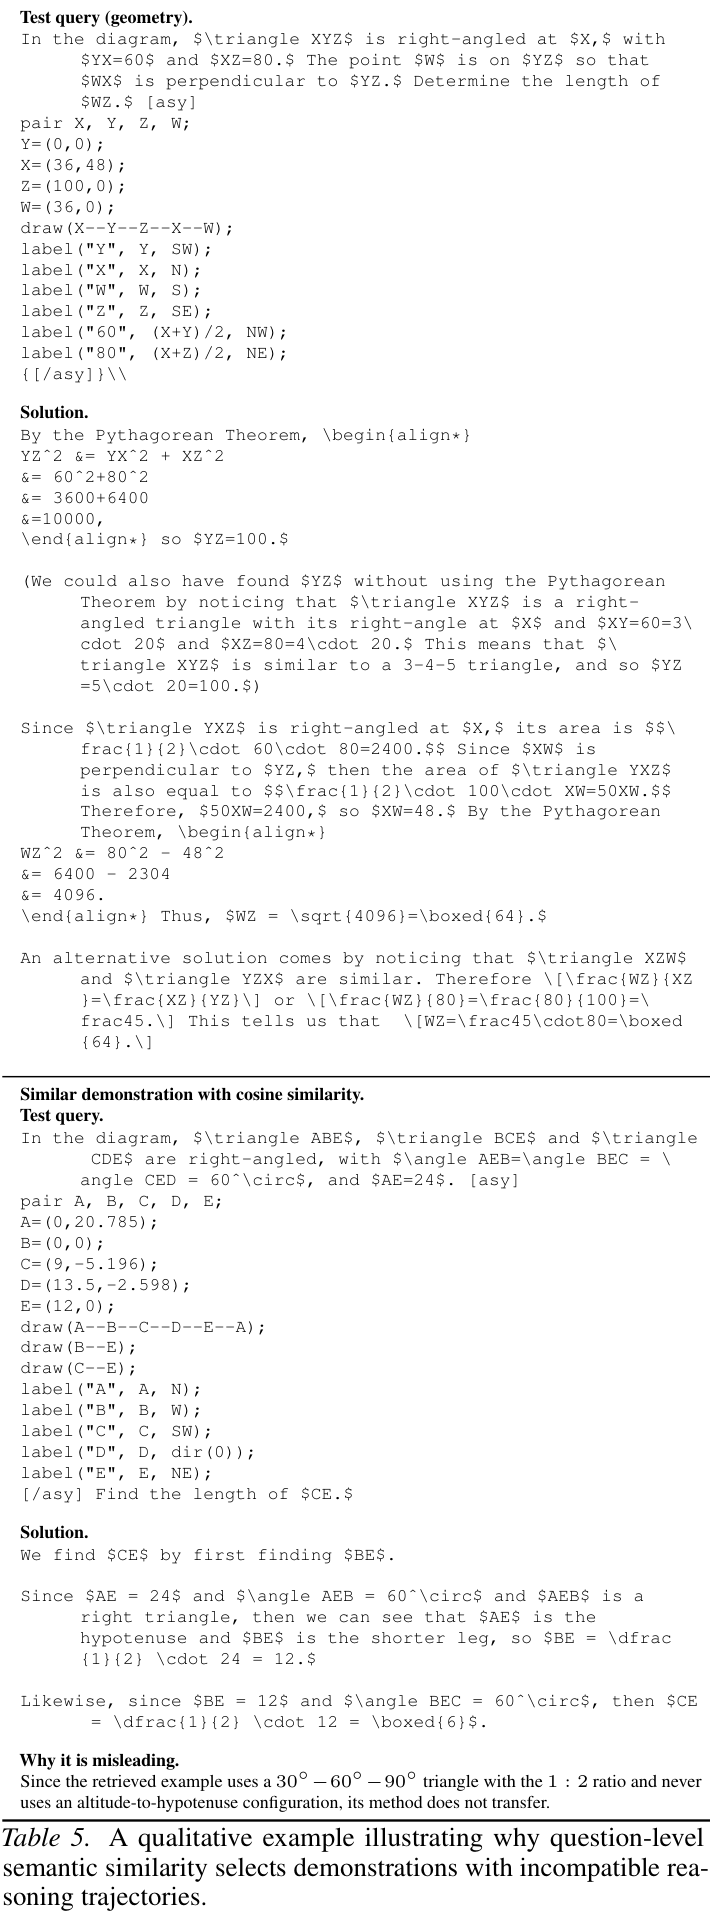
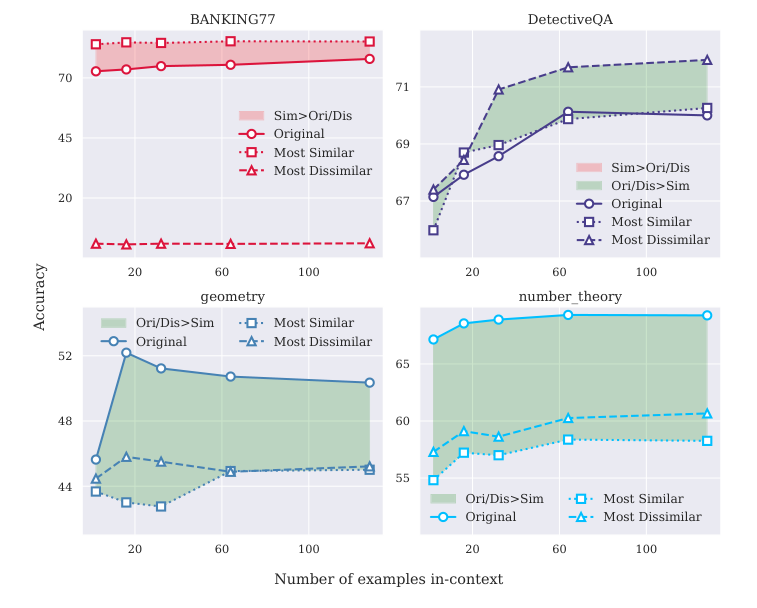
作者在論文第 4.3 節做了對照實驗:在非推理任務中,「最相似」範例表現最好;但在幾何、數論、DetectiveQA 這些推理任務上,「最相似」的表現一致地比「最不相似」和隨機挑選還差。原因就是語義相似度只是個弱代理指標,它保證不了範例和測試題之間的解題程序是相容的。
3.3 2.3 範例一多,順序的影響力反而暴增
按照舊法則,範例數量夠多時,隨機打亂順序對結果幾乎沒有影響——這叫「順序魯棒性」。論文透過 5 種不同隨機順序測量準確率的標準差,結果分類任務確實符合舊法則:範例越多,標準差越小,模型越穩定。但推理任務完全相反,標準差隨範例數增加而爆發式成長。
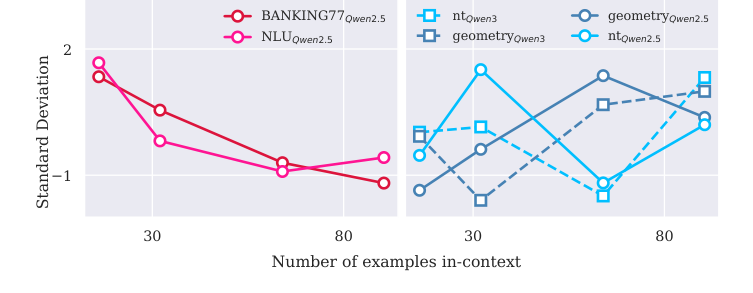
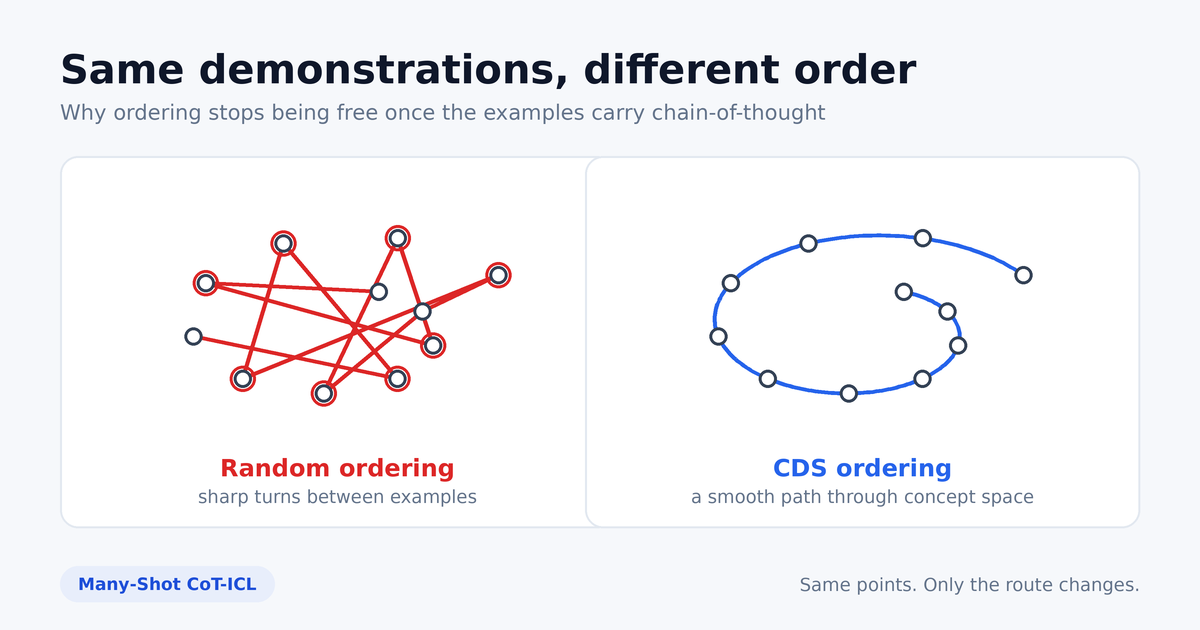
這代表 Many-Shot CoT 存在明顯的「路徑依賴」——把一百個推理範例隨機排列,就像一本編排混亂的教科書,第一頁教加法,第二頁跳去教微積分,第三頁又跳回減法。這種概念上的急轉彎會讓模型的推理軌跡瘋狂折返,範例數量越多,出現這種「邏輯斷崖」的機率也越高。
4 三、原則一:範例要「看得懂」,而不是「寫得好」
第一個挑戰的解法,是教育心理學裡「近側發展區間」(Zone of Proximal Development)的概念:最有效的教材不是難度最高的教科書,而是落在學生「在適當引導下能夠理解」的範圍內。
論文把這個概念套到語言模型上,提出「分佈對齊」(Distributional Alignment)的說法:如果範例的語言風格、推理步長、邏輯架構越貼近目標模型自己的輸出分佈,模型就越容易把這些推理步驟內化。說白了,資料集裡人類寫的標準答案就像大學教授寫的課本,邏輯精煉但跨度大,一個 8B 的小模型看了未必吃得下;反倒是模型自己生成的思維鏈,就算寫法笨拙、甚至算錯,因為用的是「同分佈的語言」,模型反而學得更快。
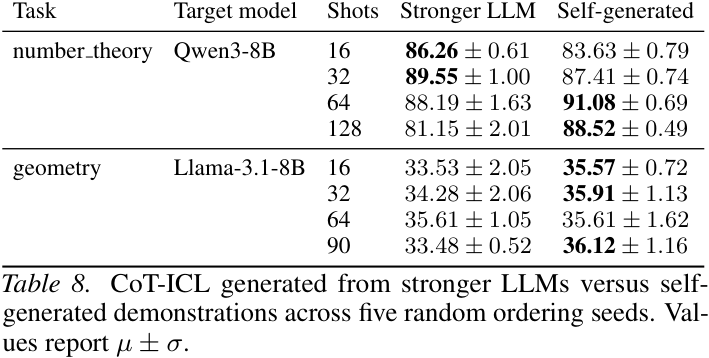
為了驗證這個猜想,作者讓 LLaMA 3.1(8B)在推理任務上分別使用三種範例來源:資料集的標準答案(origin)、模型自己生成且算對的範例(cr)、模型自己生成但算錯的範例(wr)。結果相當意外:不管是算對還是算錯,只要是模型自己生成的 CoT,表現都穩定超越標準答案。
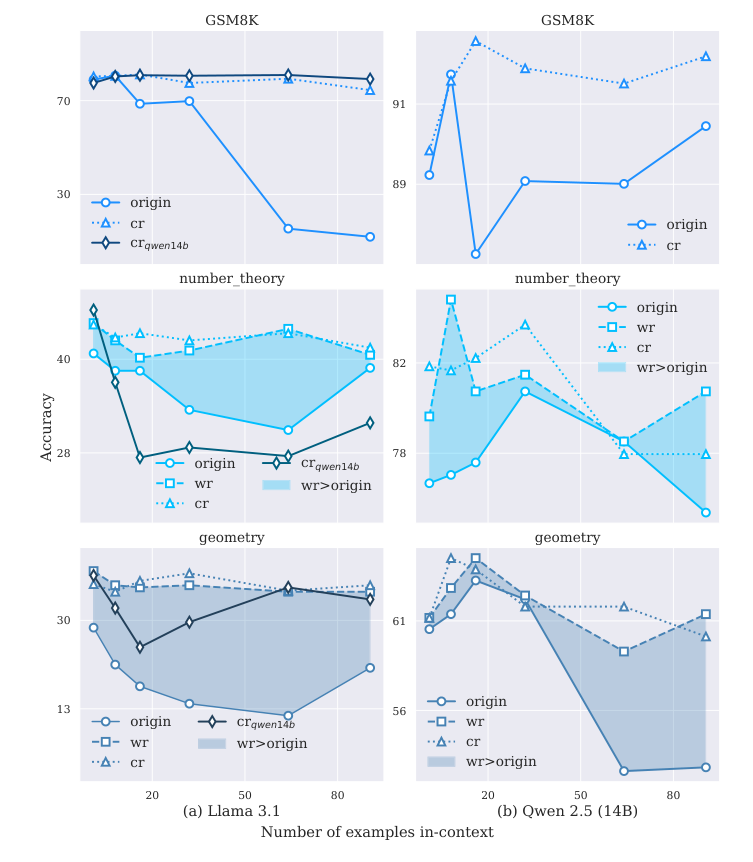
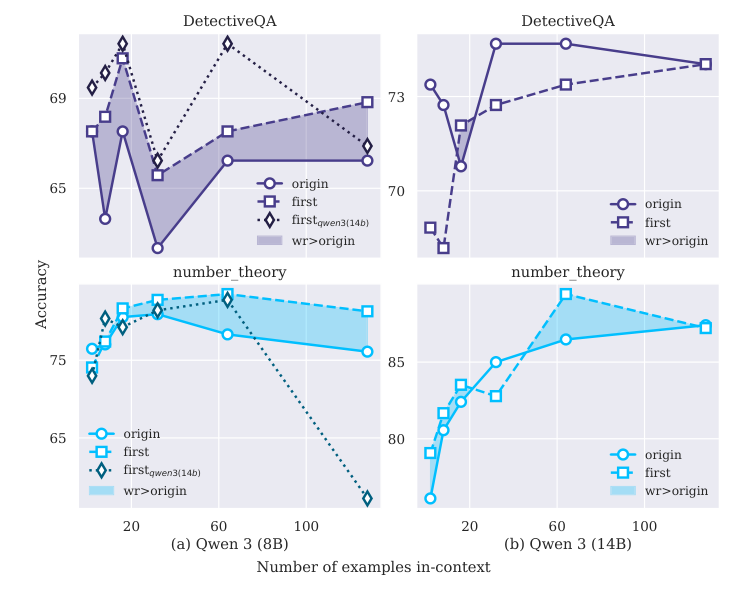
也就是說,模型在 ICL 過程中真正吸收的是「程序性監督」——也就是解題的邏輯框架與步驟——而不是死記最後的答案數字。這個優勢會隨著模型規模變大而縮小,因為理解能力越強的模型,越有能力穿透高難度標準答案裡的語意結構;而 Qwen 3、DeepSeek-R1 這類前面提到的推理模型,也對不對齊的標準答案表現出更高的抗干擾能力。
5 四、原則二:CDS——把排序問題變成一趟不急轉彎的旅行
解決了「選什麼內容」,接下來要處理「怎麼排序」。這是論文最有份量的貢獻,作者提出了 CDS(Curvilinear Demonstration Selection,曲線範例選擇)演算法。
5.1 4.1 把範例排序想成一趟高維空間裡的旅行
把每個範例(問題 + 思維鏈 + 答案)丟進 embedding 模型,它就變成高維空間裡的一個點。如果有 100 個範例,就有 100 個點,排序的本質就是找出一條「一筆畫」穿過這 100 個點的路線。路線在概念空間裡不斷急轉彎、瘋狂折返,模型的推理思維就容易亂;路線走得平滑,概念與概念之間的過渡自然,模型才吸收得順。
這正好對應到一個經典的最佳化問題:旅行推銷員問題(Traveling Salesperson Problem, TSP)——訪問所有城市各一次、最後回到起點,並讓總路程最短。TSP 是 NP-hard 問題,100 個城市就有 100! 種排列組合,實務上得靠啟發式演算法在合理時間內找出「夠好」的解,而不是求全域最優解。放到 CDS 的情境裡,城市就是範例,路線就是排列順序,車資則是「讀完前一個範例後,再讀下一個範例的理解負擔」。
5.2 4.2 成本函數:同時考慮距離和轉彎角度
CDS 中,從範例 走到範例 的成本由兩部分組成:
是兩點間的歐式距離,確保相鄰範例在概念上循序漸進、不跳題型; 則是曲率代理成本,目的是量化路徑會不會急轉彎。
這裡有個技術上的眉角:要判斷路徑在 點有沒有急轉彎,理論上要同時知道前一步()和下一步()的方向,但排到 的時候,演算法根本還不知道下一步會是誰。作者的解法是找出離「 和 的幾何中點」最近的候選範例,把它當成「預想的下一步 」,再用內積算出 與 之間的夾角,轉彎角度越大,曲率成本就越高。
5.3 4.3 四步工作流程:貪婪初始化 → 局部搜尋 → 多起點 → 剪斷迴圈
CDS 實際運作可以拆成四步:
- 貪婪初始化(Nearest Neighbor):隨機挑一個起點,每步都選成本最低的下一個點,直到繞完一圈,建立一個初始迴圈——但這個迴圈通常有不少自我交叉的「打結」處。
- 2-opt 局部搜尋:反覆檢查有沒有更便宜的連接方式,透過反轉子序列來消除交叉,把路線微調得更平滑。
- 多起點嘗試(Random Restart):局部搜尋容易卡在局部最佳解,所以換不同的隨機起點重跑,最多跑 10 次,挑出平滑度分數最高的一條。
- 剪斷最長邊:TSP 算出來的是閉合迴圈,但 Prompt 是一條直線,所以最後要找出路線裡跨度最大、最突兀的那條邊,一刀剪斷,變成有頭有尾的序列。
2-opt 這一步值得再拆細一點,因為它是整個演算法真正在「動手術」的地方。假設目前的排列是 [0, 1, 2, 3, 4, 5, 6, 7, 8, 9](最後一點會連回起點),演算法用雙層迴圈挑兩條不相鄰的邊,比如 0→1 和 4→5。它會去成本矩陣裡查兩種連法的總成本:原本的 Cost(0,1) + Cost(4,5),以及反轉後的 Cost(0,4) + Cost(1,5)。如果反轉後成本更低,就把 1 到 4 這一段整段倒過來,排列變成 [0, 4, 3, 2, 1, 5, 6, 7, 8, 9]。每次修改後重新從頭巡邏,直到找不到任何能降低成本的反轉為止,才算收斂。
整個流程單核 CPU 執行時間在一分鐘以內,不需要更動模型參數,算是相當划算的一個 Prompt 前處理模組。
6 五、實驗數據總覽:這些原則真的有用嗎?
前面講的都是機制,這一節看實際數字。
6.1 5.1 語義相似度在推理任務上全面失靈
對比原裝(ori)、語意相似(sim)、語意不相似(dis)三種範例挑選方式,在非推理任務(BANKING77)裡 sim 表現最好;但在幾何、數論、DetectiveQA 三個推理任務裡,sim 幾乎全程墊底,找「最不相似」的範例反而比找「最相似」的表現更好。
6.2 5.2 自我生成範例的優勢有具體數字支撐
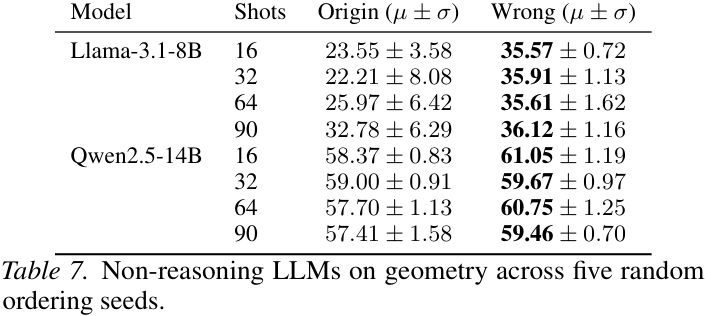
LLaMA 3.1(8B)在 32-shot 設定下,用標準答案(origin)準確率只有 22.21%,換成自己寫錯的答案(wrong)反而衝到 35.91%。把更強模型(如 Qwen 2.5 14B)生成的範例餵給 LLaMA 3.1 8B,表現(33.53%–34.28%)也顯著低於餵給它自己生成的範例(35.57%–35.91%)。
6.3 5.3 CDS 排序帶來穩定且跨模型的提升
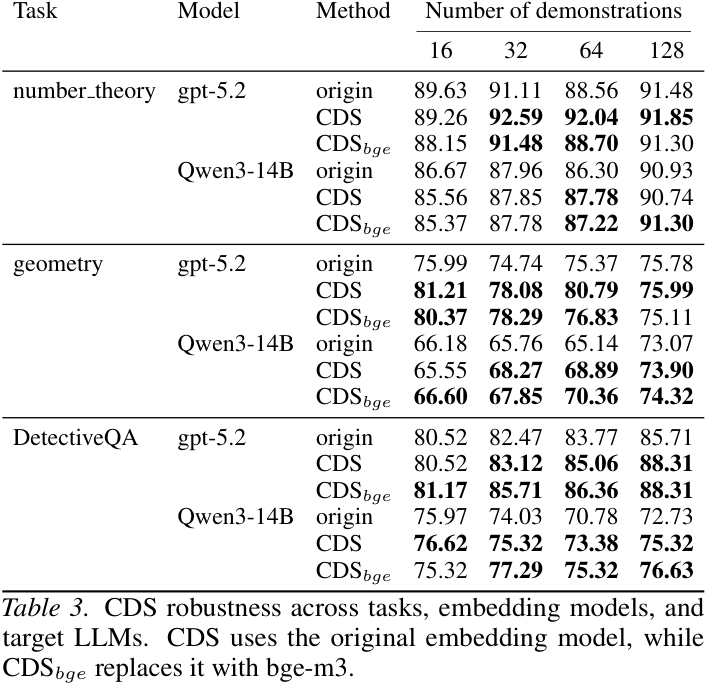
在 Qwen3-14B 的幾何任務上(64-shot),隨機排列準確率只有 65.14%,經過 CDS 排序後提升到 68.89%;換成開源的 bge-m3 embedding 排序,甚至能再拉高到 70.36%。這個提升不是單一模型的巧合——換成閉源模型 gpt-5.2,在數論任務(32-shot)上,CDS 一樣能把準確率從隨機排列的 91.11% 推到 92.59%,證明這個方法不挑 embedding 模型,也不挑 LLM。
6.4 5.4 曲率才是關鍵因果變數,不只是群聚效應
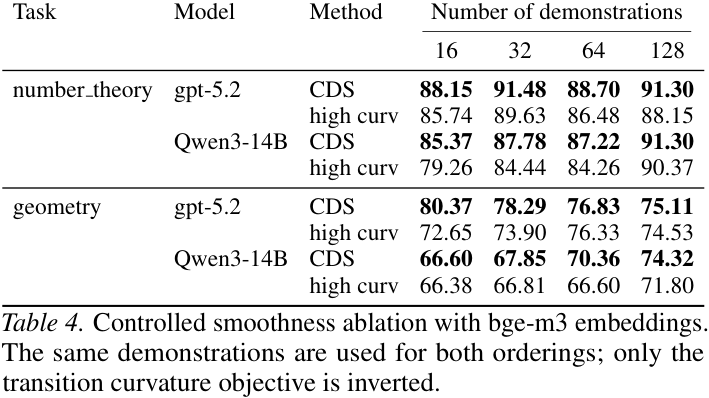
為了排除「CDS 表現好只是因為把相似題目分在同一區塊」這個質疑,作者設計了一組刻意製造急轉彎的對照組(high curv)——兩組都用歐式距離把相似題聚在一起,但 high curv 組在區塊過渡時故意選轉彎角度最大的排法。結果兩邊都輸得明明白白:Qwen3-14B 在數論任務(16-shot)上,CDS 準確率 85.37%,high curv 只剩 79.26%;gpt-5.2 在幾何任務(16-shot)上,CDS 是 80.37%,high curv 掉到 72.65%,差距高達 7.72 個百分點。這說明轉彎角度本身就是造成表現差異的因果因素,不是群聚效應的副產物。
7 結論
這篇論文的核心結論,可以濃縮成兩句話給做 Prompt Engineering 的工程師:內容要看得懂,順序要走得順。在挑選範例內容時,與其追求由最強模型生成的完美解答,不如優先用目標模型自己生成的思維鏈——就算偶有瑕疵,分佈對齊帶來的吸收效果反而更好;在排序範例時,與其依賴語意相似度的傳統 RAG 檢索,不如用 CDS 這類方法把曲率降到最低,替模型鋪一條沒有急轉彎的推理路徑。
CDS 本身運算成本低、不用動模型參數,很適合直接接進現有的 LLM pipeline 當一層 Prompt 前處理——這種「不改模型、只動 Prompt 就有收益」的路線,和 Prompt Repetition 這類零延遲的前處理技巧屬於同一類工程槓桿。往後如果要延伸,一個自然的方向是把它跟現有的 RAG 架構結合,讓檢索增強生成不只挑「知識片段」,也一併排好「思維軌跡」;另一個值得關注的方向,是這套「模型讀自己生成的推理軌跡來自我提升」的機制,在 Agent Planning 或程式碼生成這類需要多步驟決策的任務上,可能也有發揮空間。