Naive Prompt Optimization:拿掉搜索之後還剩下什麼
 Hong-Wei Wu
收錄於 論文介紹
1 前言
如果你研究過 automatic prompt optimization(自動優化 prompt 的技術),大概會發現這個領域最近的方法一個比一個複雜:維護一整池候選 prompt、做 beam search、做 Pareto 篩選。GEPA 就是這類方法的代表。
Purdue 大學這篇論文《Naive Prompt Optimization》問了一個看似天真的問題:如果餵給負責改寫 prompt 的「teacher model」更豐富的回饋——不只是一個總分,而是完整的執行過程加上每題分數——再配一個夠強的 teacher,是不是根本不用搜索、只維護「一條路線」的 prompt 修訂,也能打平甚至打贏那些複雜方法?他們把這個做法叫做 NPO(Naive Prompt Optimization)。
先把結論說在前面:這篇論文本身的方法論貢獻並不高,NPO 說穿了是既有技術 OPRO 的小幅修改,而且它「用更少執行次數打贏 GEPA」這個賣點,本身藏著一個沒處理乾淨的漏洞(後面會細講)。但論文在「怎麼公平比較不同方法」這件事上做得很紮實——配對隨機種子、約束解碼——這套實驗設計本身的可遷移價值,比 NPO 這個方法還要高。這篇文章會照這個比重來寫:方法本身講清楚,但花更多篇幅在這套實驗方法論上。
2 背景:Prompt Optimization 為什麼越做越複雜
2.1 調整權重,還是調整 prompt
如果你手上有一個「student model」(實際要拿去執行任務的模型),想讓它表現更好,大致有兩條路:一是調整模型權重,例如用 RLHF、PPO、GRPO 這類強化學習方法直接更新參數;二是完全不動模型,只是換一段更好的指令,也就是調整 prompt。
第二條路的好處很直接:輕量、可攜。不需要為每個任務、每個使用者訓練並維護一份專屬權重,只要換一段文字,就能部署到任何透過標準 API 存取的第三方模型上。Automatic prompt optimization 研究的就是「怎麼自動找到那段更好的指令文字」。
2.2 主流方法都在做同一件事:多候選 + 搜索
論文列了幾個代表性方法的演進,脈絡看下來是同一個方向越滾越大:
- OPRO:把 LLM 當優化器,根據「之前試過的 prompt 版本+對應分數」提出下一版。
- ProTeGi:結合「文字梯度」的概念與 beam search,同時追蹤多條候選路線。
- MIPRO:用模型生成候選,再加上貝氏優化(用機率模型猜測「下一個該嘗試的設定」)。
- GEPA:維護一整個候選 prompt 的池,透過反思(reflection)產生新候選,用 Pareto-based selection 保留「沒有被其他候選全面超越」的那些候選。
這幾個方法有個共同點:都在同時維護多個候選版本,並用某種機制決定該往哪個方向修改。(我們之前也介紹過兩篇同樣拿 GEPA 當比較基準、但問題設定不同的論文:把 AI Agent 的技能文件當成可訓練權重來優化的 SkillOpt,以及用會演化的 context 而非單一 prompt 來累積經驗的 Agentic Context Engineering。)
這種設計背後藏著一個沒有明講的假設:如果只走一條路線——一次只有一個 prompt 版本,改壞了也回不去——很容易卡進局部最優,某一步修壞了就一路壞下去,白白浪費掉有限的執行次數(rollout)預算。維護多個候選、保留表現好的分支,就是為了不把所有籌碼押在一條可能走偏的路線上。
3 NPO 的提問:回饋給得夠多,還需要搜索嗎?
NPO 反過來問:如果每次修訂時,餵給 teacher model 的回饋夠豐富——不是只有「上一版+一個總分」,而是完整的執行過程與逐題分數——再加上 teacher model 本身夠強,那麼「只走一條路線、不做搜索」是否就足夠好,讓那些搜索機制的邊際效益趨近於零?
這是整篇論文的立論起點:不是提出新演算法,而是質疑既有複雜度是否必要。論文摘要用的原文措辭是「stronger teacher reasoning can partially substitute for optimizer-side search complexity」——注意是 partially substitute(部分取代),不是「完全不需要」。這是一個有條件的主張,不是斷言式的結論,這個分寸後面看實驗結果時要記住。
4 NPO 方法本身
4.1 一句話講完整個邏輯
每一輪:用目前的 prompt 跑一批任務,收集這批任務的執行過程與分數,把「最近幾輪」的執行過程與分數一起丟給 teacher model,讓 teacher 產生下一版 prompt。重複固定輪數,就是 NPO 的全部。
4.2 Algorithm 1:符號對照表
論文的 Algorithm 1(標題為 Naive Prompt Optimization with Sliding-Window Rollout Feedback)用了一批符號,先把它們對照清楚:
| 符號 | 意思 |
|---|---|
| 第 輪的 prompt 版本, 從 0 開始 | |
| 完整的任務資料集 | |
| 每輪抽樣的 minibatch 大小 | |
| 第 輪從 抽出的 題任務 | |
| 第 輪跑完後收集到的:每題完整執行過程(rollout trace)+每題分數(reward) | |
| sliding window 大小,teacher 這次能看到「過去幾輪」的資料範圍 | |
| teacher model,負責改寫 prompt | |
| 總共執行的輪數 |
核心步驟寫成公式:
白話講:teacher 拿到「目前這版 prompt」加上「最近 輪(含這一輪)的所有執行結果」,改寫出下一版 prompt。 這個寫法是處理「輪數還不夠 輪」的邊界情況——例如 時往前推 輪會變成負數,這時候就從 0 開始算,不會出錯。
有一點容易被忽略:teacher 實際看到的不只單題資料。論文原文明講 teacher 收到的是「the prompts, corresponding rollout traces, and rewards」——複數的 prompts。如果 window 涵蓋 2 輪,teacher 拿到的完整輸入其實是:這 2 個版本的 prompt 文字本身、這 2 個版本各自的平均分數,以及這 2 輪、每輪 題、總共 筆的(題目、執行過程、模型輸出、單題分數)。
這一點很關鍵:如果 teacher 只看到單題結果,它只能判斷「這題錯在哪」;但因為它同時看得到「連續兩輪的平均分數變化」,才有機會判斷「上一次的修改到底有沒有效」——這正是 sliding window 設計想達成的效果。不過下面會說明,這個效果其實沒有被保證。
4.3 用論文自己的例子跑一次
論文的 Figure 1 給了一個具體示範。假設 minibatch 裡有一題是「What is the capital of France?」:
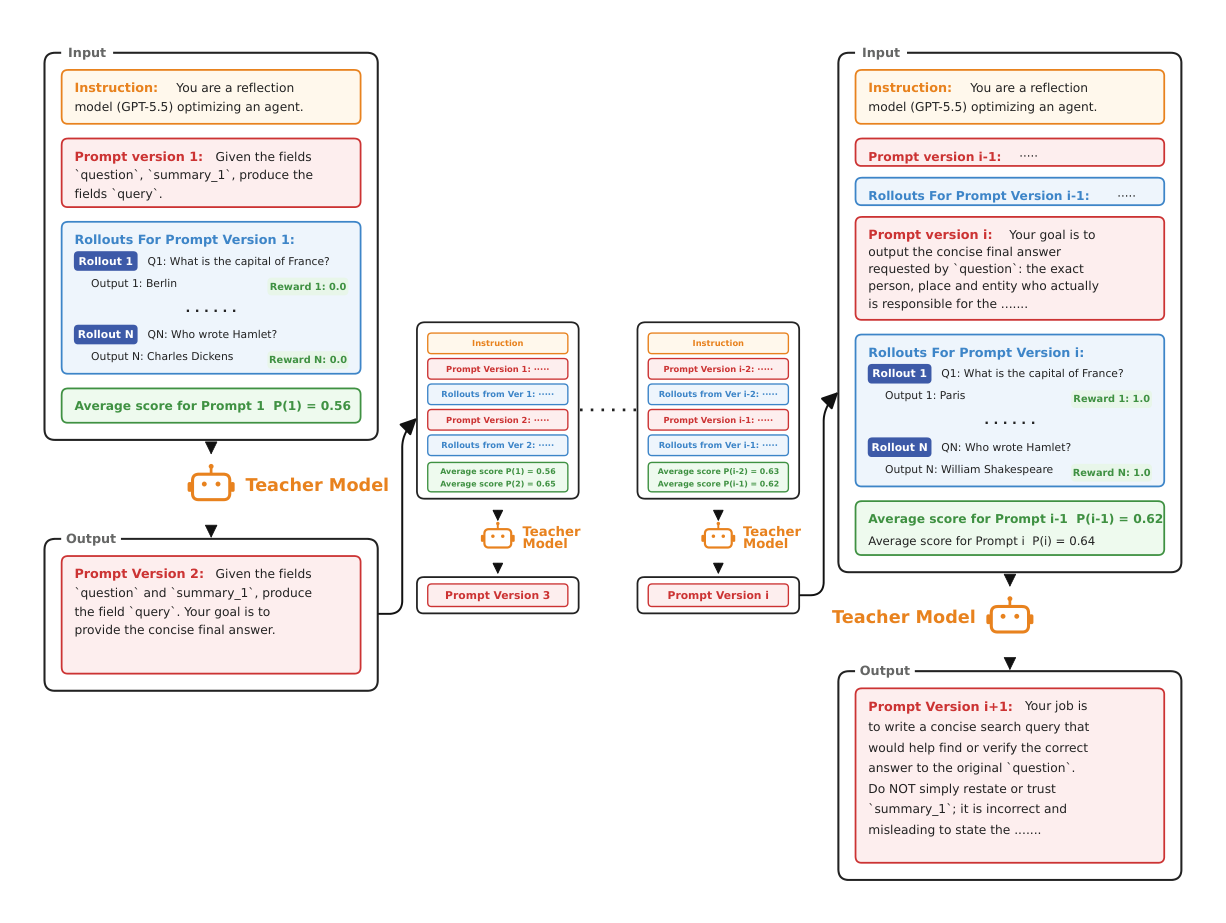
- (第 1 版 prompt):
Given the fields 'question', 'summary_1', produce the fields 'query'. - 用 跑這題,模型輸出是 “Berlin”,reward = 0(答錯)。
- 整批 minibatch 跑完, 的平均分數是 0.56。
- Teacher 看到「 的文字+一堆包含錯誤答案的執行紀錄」,判斷問題出在 prompt 沒講清楚「要給最終答案」,於是改寫出 :
Given the fields 'question' and 'summary_1', produce the field 'query'. Your goal is to provide the concise final answer.
短短一輪,就能看出 NPO 的修訂邏輯很直觀:teacher 看到具體的錯誤案例,直接對症下藥。
4.4 Sliding Window 的視覺化
論文 Figure 2 把「NPO 跟 GEPA 的路線差異」跟「sliding window 怎麼滑動」畫在同一張圖裡:
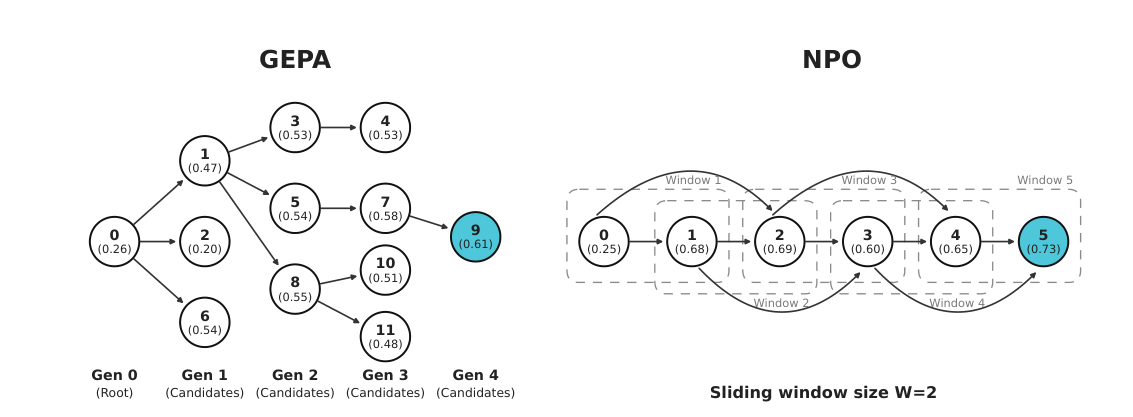
以 為例,先看每一輪的分數:
| 輪次 | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| 分數 | 0.25 | 0.68 | 0.69 | 0.60 | 0.65 | 0.73 |
窗格隨輪次滑動的樣子是這樣的:
| 窗格 | 涵蓋輪次 | 產生 |
|---|---|---|
| Window 1 | ||
| Window 2 | ||
| Window 3 | ||
| Window 4 | ||
| Window 5 |
每個窗格只涵蓋「最近兩輪」的資料,窗格之間會重疊(Window 2 和 Window 3 都包含輪 1),這讓 teacher 修訂時,既能看到最新結果,也保有一點更早的脈絡。對照圖 2 左半邊的 GEPA:GEPA 是一棵樹,可以從表現好的節點分支出新候選;NPO 完全是一條線,,沒有分支,只有「往前看幾步」的差異。
4.5 與 OPRO 的差異
NPO 用「LLM 當迭代式 prompt 優化器」這個手法最早由 OPRO 提出。差異在於:OPRO 只把「之前評估過的 prompt+對應的純量分數」給 teacher 看,而 NPO 給的是「完整的執行過程+逐題分數」。論文對這個差異的說明就到這裡為止,沒有再展開細節——換句話說,NPO 相對 OPRO 的技術跨度其實不大,主要就是把回饋資訊從「一個數字」升級成「完整紀錄」。
Algorithm 1 第 2 行寫的是「Sample minibatch of size from 」——也就是每一輪都重新從整個資料集裡隨機抽樣一批新的 題,不是固定用同一批題目。
這件事對 sliding window 的設計意圖造成一個問題。Teacher 之所以能看到「連續兩輪的平均分數」,原本用意是判斷「上一次的修改到底有沒有效」。但如果 的分數是在批次 A(例如某 40 題)上算出來的, 的分數是在批次 B(另一組完全不同的 40 題)上算出來的,這兩個分數的差異裡就同時混雜了「prompt 有沒有變好」跟「這批題目剛好比較難或比較簡單」兩種原因。Teacher 沒辦法單從這兩個數字判斷差異到底來自哪一個。
論文 2.4 節確實有「shared pseudorandomness」(配對隨機種子)機制,但那是用來確保 NPO、GEPA、GRPO 三種方法之間比較公平(下面〈配對隨機種子〉會細講),並沒有被用來處理「NPO 自己內部、連續輪次的 minibatch 是否一致」這個問題。論文完全沒有討論或做敏感度分析。
一個可能稍微緩解問題的因素是,每輪分數是 題的平均值而非單題分數,樣本數夠大時,批次難度的隨機波動理論上會被平均掉一部分——但這只是緩解,不是解決。像 IFBench(測試模型是否遵守指令中格式、字數等限制的基準)這種任務,不同題目對應的約束類型難度差異可能很大,就算平均 40 題,批次組成不同仍可能造成分數有系統性落差,而非單純隨機雜訊。這一段推論是我自己補上的,論文本身沒有寫。
5 對照方法:GEPA 與 GRPO(簡述)
後面的實驗會反覆拿 NPO 跟這兩個方法比較,這裡只記錄理解結果所需的最低限度背景,不深入拆解演算法細節。
GEPA:維護一個候選 prompt 的池。從池中抽出一個「父代」prompt,用一批反思資料(reflection minibatch)修訂它,修訂後的版本只有在「對這批反思資料有改善」時才會被接受。被接受的修訂會在驗證集上評估、加入候選池,之後用這個驗證表現做 Pareto-based 的父代篩選(保留沒有被其他候選全面超越的版本)。論文使用標準 GEPA 流程,不含 GEPA-merge 變體。
GRPO:作為「權重層級」的 RL 對照基準。對每一組執行結果(rollout group),把獎勵減去該組平均值、除以標準差,得到相對優勢,用來更新一個 LoRA(低秩適應)adapter,主幹權重與 prompt 都保持固定。在雙人遊戲環境中,訓練中的一方對戰一個固定、未訓練過的基礎模型,只有訓練中一方的 LoRA 參數會更新,並且刻意讓訓練中一方在一半的隨機化回合中先手、另一半後手,避免先後手造成的獎勵分布差異汙染訓練訊號。
6 真正的重點:怎麼做一個乾淨的方法比較
如果只看 NPO 這個方法本身,老實說沒有太多可講的——就是把 OPRO 的回饋資訊量加大。但這篇論文在「怎麼公平比較 NPO、GEPA、GRPO 這三種南轅北轍的方法」這件事上,做了兩套值得學起來的工程紀律:配對隨機種子,以及約束解碼。這兩套技巧都不是論文原創,但把它們用在「比較不同 prompt optimizer」這個場景上,是紮實的工程實踐,值得抽出來獨立看待。
6.1 配對隨機種子(Shared Pseudorandomness)
要解決的問題:比較 NPO、GEPA、GRPO 三種方法時,如果每個方法各自在「隨機生成」的環境上執行——例如 Minesweeper 每次隨機佈雷、地雷位置都不同——最後分數的差異可能不是「方法本身比較強」造成的,而是「剛好抽到比較簡單的關卡」造成的。這是一個典型的干擾變因:想比較的是方法優劣,卻混進了環境難度的隨機波動。
機制:針對每個環境,先用一組固定的隨機種子生成一批環境實例,讓 NPO、GEPA、GRPO 共用同一組種子序列。也就是說,NPO 執行的第 135 次 rollout,跟 GEPA 執行的第 135 次 rollout,起始盤面完全一樣——同樣的地雷位置、同樣的已知數字——只有各自的 prompt 或 policy 不同,導致後續動作不同。
這跟統計實驗裡的「配對比較」(例如 paired t-test,或醫學實驗裡「同一批受試者服藥前後比較」)是同一套邏輯:把會造成雜訊的變因鎖定成相同,讓組間差異只反映真正想測的那個變因。這裡鎖定的變因是「環境實例的隨機性」,想測的變因是「optimization 方法的好壞」。不鎖定隨機種子時,比較的是獨立樣本(unpaired),組間變異會被環境難度的隨機波動稀釋,需要更多樣本才能看出真正差異;鎖定種子後等於做了配對,雜訊被大幅消除,統計檢定力明顯提高。
論文的 Figure 3 正好示範了這件事:
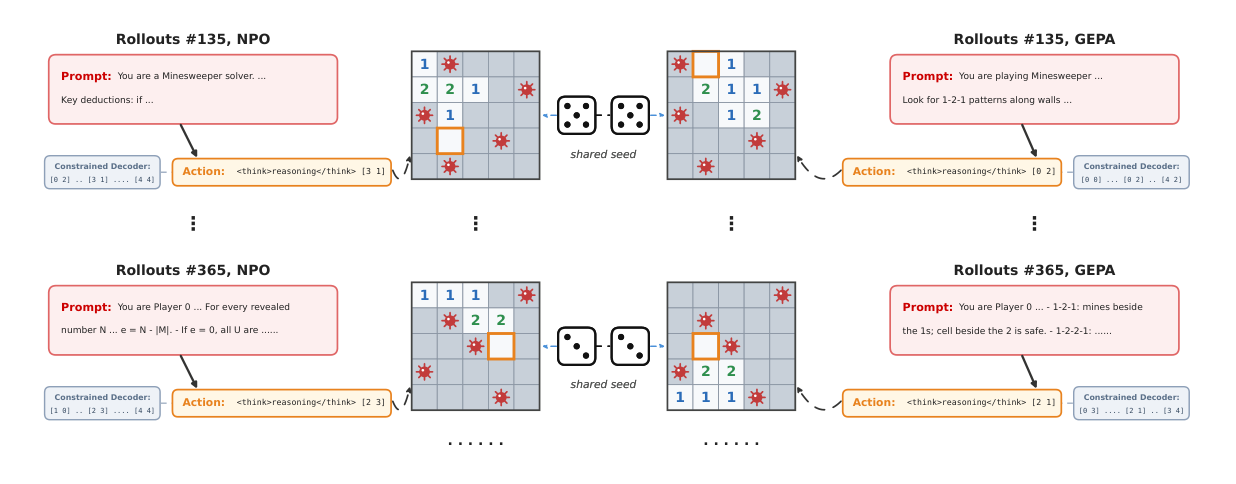
圖中「Rollouts #135, NPO」與「Rollouts #135, GEPA」的盤面(地雷位置、已知數字)完全相同,差異只出現在 prompt 不同,導致模型做出不同判斷(NPO 選了 [3 1],GEPA 選了 [0 2])。
6.2 Constrained Decoding 完整機制
要解決的問題:論文提到前期實驗發現,格式錯誤(模型輸出的動作字串不符合環境要求)佔了失敗案例中不小的比例。如果 A 方法的失敗大多來自「格式寫錯」而非「決策真的比較差」,把這些失敗算進最終分數,就等於錯誤地懲罰了 A。他們要把「決策品質」跟「格式遵循能力」分開,只評測前者。
第一步:怎麼「遮蔽」不合法的 token
模型每一步生成下一個 token 時,原本會對詞彙表裡所有 token 都算出一個機率。Constrained decoding 做的事,是把不合法的 token 機率設成 0,只留下合法的那幾個,重新正規化成一個機率分布。用一個簡單數字示範:假設某一步,原始機率是 、、、、,但這一步只有 、 合法。做法是把 、、 設成 0,剩下 、,相加是 0.7,重新除以 0.7,得到 、。
論文用的公式(等價於上面的計算):
其中 是目前已生成的前綴字串, 是這個前綴之後合法的下一個 token 集合, 是模型對 token 的原始分數(logit)。
第二步:為什麼需要一棵「樹」
單一步驟的遮蔽只解決了「這一步要選哪個 token」,但完整的動作字串(例如 [3,4])通常要好幾個 token 才能拼完,而且每一步「合法的 token 有哪些」會隨著前面已經打出來的內容而改變。
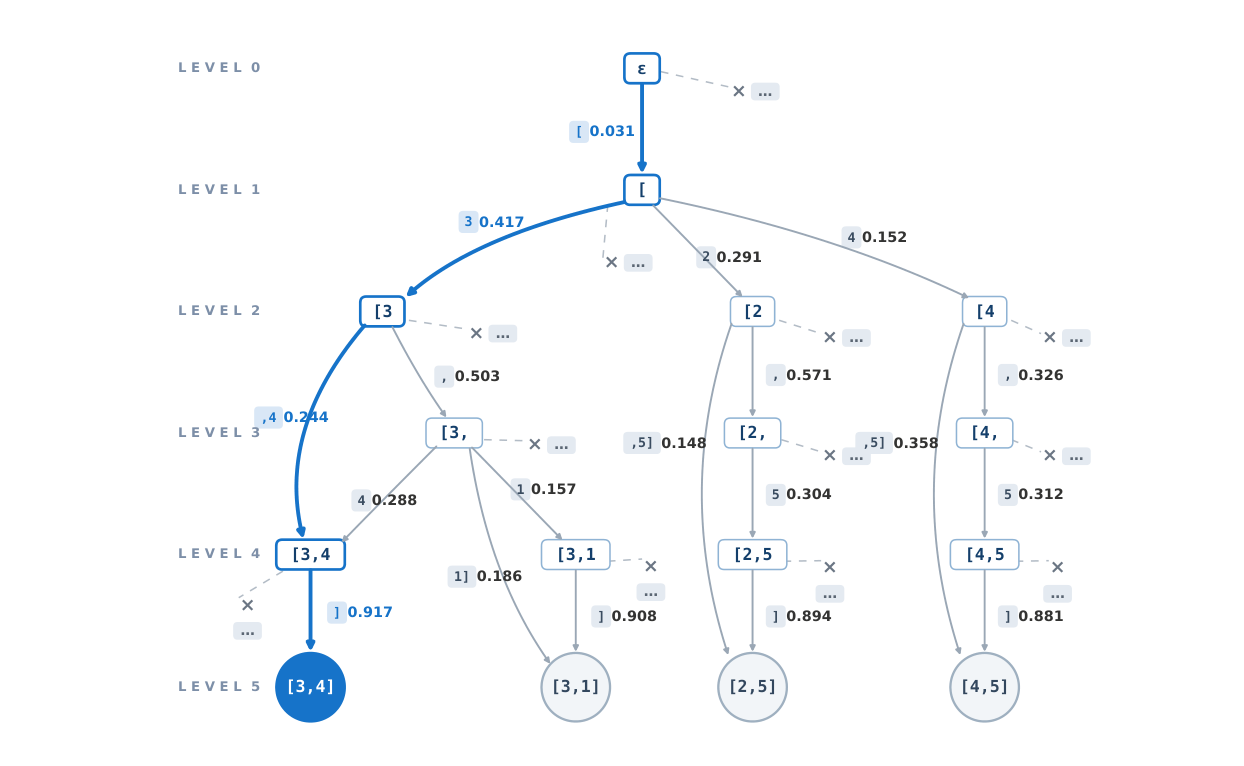
舉例:假設環境只允許兩個合法動作 [3,4] 和 [2,5]。一開始合法的第一個 token 只有 [;打完 [ 之後,合法的下一步變成 3 或 2;選了 3 之後下一步只剩 ,,再來只剩 4,最後只剩 ]。「合法 token 集合」在每一步都不同,且取決於前面打了什麼——這正是需要**字首樹(prefix trie)**的原因。樹的每個節點代表「目前已生成的前綴」,從節點出發能走的邊就是「合法的下一個 token」,走到葉節點就代表湊出一個完整合法動作:
根節點(尚未生成)
  --[--> "["
           --3--> "[3" --,--> "[3," --4--> "[3,4" --]--> "[3,4]" (葉節點)
           --2--> "[2" --,--> "[2," --5--> "[2,5" --]--> "[2,5]" (葉節點)
第三步:把遮蔽跟樹接起來
在樹上每個節點都重複同樣的事:看這個節點下有哪些合法子節點,對這些合法選項的原始分數做遮蔽加重新正規化,依機率選一個、走到對應子節點,重複直到走到葉節點。
用上面的兩動作範例走一次,並算出 [3,4] 的完整機率——根節點合法下一步只有 [ 一個選項,機率鎖定為 1;[ 節點有 3、2 兩個真正的分岔點,假設遮蔽加正規化後算出 、;後面 [3、[3,、[3,4 節點都只有唯一合法選項,機率同樣鎖定為 1。整條路徑機率連乘:
關鍵效果:除了「選 3 還是選 2」這個真正的分岔點之外,其他每一步都是唯一選項(機率鎖定為 1),所以整條路徑的機率幾乎完全由「真正的決策分岔點」決定——格式相關的 token([、,、])完全不影響最終機率。
論文 Figure 11 用一個具體的四動作範例畫出帶數字的字首樹:
額外的邊界情況:如果模型在推理 token 用完前,都還沒生成結束推理的標記,論文不會直接把它算成失敗——因為那樣會把「決策品質差」跟「不知道自己快沒 token 額度」混在一起算。做法是在額度快用完前,強制插入結束推理的標記,再用一小段保留的動作預算,逼模型仍要從合法動作裡選一個。
Constrained decoding 這套技術本身不是這篇論文原創的——locally constrained decoding、「local product of experts」有既有文獻,grammar-constrained 生成在業界也很常見(論文引用了 lm-format-enforcer,Outlines 這類工具也是基於同樣原理)。論文是把既有工具套用在「消除跨方法比較的格式雜訊」這個場景。
6.3 Local vs Global:兩種機率算法的取捨
論文提到計算「葉節點(完整動作)機率」有兩種方式,這篇論文選用其中一種,另一種只是拿來對照說明。
- Local(這篇論文採用的):每走到樹上一個節點,就先遮蔽不合法 token、對合法選項重新正規化,再往下走一步——就是上面〈第三步〉描述的逐步流程。
- Global:不在中途做任何遮蔽或正規化,讓模型用原本自由生成時的機率,把整條路徑的每一步機率直接連乘;等所有合法動作(葉節點)的乘積都算完後,最後才在這些葉節點之間做一次正規化。
Global 需要用到「teacher forcing」這個技巧:正常生成是模型自己一個 token 接一個 token 生成;teacher forcing 則是強制塞給模型一段指定好的內容,只問模型「如果前面是這段內容,你對下一個 token 的機率分布長怎樣」,藉此算出「模型生成出某段固定文字」的機率,即使模型自己從未真的生成過這段話。Global 的完整流程分五步:先窮舉所有合法的完整動作字串;對每個候選字串,用 teacher forcing 依序問模型原始、未被遮蔽過的逐步機率;把這些機率連乘,得到這個候選的原始分數;對其他候選重複同樣流程;最後把所有候選的原始分數放在一起做正規化,再從中採樣或選出最終動作。也因為第一步要「窮舉」,Global 只適用在動作集合有限、可窮舉的場景——如果合法輸出是開放式自然語言就做不到。
用一組自建的數字(同樣是示範用,不是論文原圖數字)比較兩者的結果差異。假設模型原本(自由生成、未遮蔽)對每一步的原始機率是:
| 路徑 | 分岔 token | 下一數字 | |||||
|---|---|---|---|---|---|---|---|
[3,4] | 0.05 | 3 | 0.02 | 0.90 | 4 | 0.015 | 0.85 |
[2,5] | 0.05 | 2 | 0.015 | 0.88 | 5 | 0.01 | 0.65 |
(0.85 與 0.65 這兩個「該不該收尾打 ]」的信心值差異,純粹是模型 tokenizer 或訓練資料造成的巧合,跟「該選哪個動作」這個真正的決策完全無關——這正是問題所在。)
Global 算法(直接連乘,最後才正規化):
Local 算法(每個節點先遮蔽再正規化):只有 [ 節點是真正的分岔點,,,其他節點機率都鎖定為 1,所以 、。
兩者並列比較:
[3,4] | [2,5] | |
|---|---|---|
| Global | 0.73 | 0.27 |
| Local | 0.571 | 0.429 |
Global 算出的 0.73 對 0.27,差距這麼大,有很大一部分其實是被 ] 這個 token 的原始信心值(0.85 對 0.65)拉出來的,而這個信心值差異只是格式收尾時的雜訊,跟「該選哪個動作」的真正決策無關。Local 因為把「別無選擇」的節點直接鎖定成 1,結果只剩真正的決策分岔點在決定最終機率,更貼近「模型真正想選哪個動作」的訊號——這也是論文選 Local 的理由:確保比較不同 optimization 方法時,看到的機率差異反映的是決策品質,而不是格式收尾 token 剛好比較幸運。
Global 的優勢在於它剛好等於用貝氏定理算出來的條件機率——這是機率論的一般知識,論文完全沒有討論這個角度,但值得記下來。想像完全不做任何限制,讓模型自由生成,生成出不合法動作就丟掉重來(這叫拒絕採樣,rejection sampling),一直重複直到抽到合法動作為止,這個過程最終收斂到的分布,用貝氏定理寫出來正好是:
這正是 Global 算法的公式本身。換句話說,Global 是「不斷重新生成、丟掉不合法結果,直到抽中合法動作為止」這整個過程最終會收斂到的機率分布,完整保留了模型對每個合法選項原本真正的相對信心,沒有被人為扭曲過。而 Local 每走到一個節點就先局部正規化,等於主動抹掉了模型對格式收尾等 token 的部分原始信心資訊——不是巧合誤差,是這個算法設計上必然發生的系統性偏移,用這個代價換取「一次生成就完成、不用窮舉候選」的運算效率。
兩者取捨整理成一張表:
| Local | Global | |
|---|---|---|
| 運算量 | 低(一次自迴歸生成即可) | 高(每個候選都要跑一次 teacher forcing) |
| 是否等於模型原始信心的真實條件分布 | 不是,會被格式 token 等雜訊系統性扭曲 | 是,數學上等價於拒絕採樣得到的分布 |
| 適合場景 | 想要的是「決策品質」,格式雜訊是想主動消除的東西(本篇論文的情境) | 想精確得知模型對每個選項的真實相對信心,例如模型校準度(calibration)分析 |
| 是否保證輸出合法 | 保證 | 保證 |
值得強調的是:Local 跟 Global 從來不是「要不要保證格式合規」的取捨——兩者都 100% 保證輸出合法,合法動作清單本身就是有限、事先窮舉好的集合,差別只在於「合法選項之間的機率該怎麼分配」。
7 主要結果
7.1 執行效率:teacher 夠強,NPO 才有優勢
論文 Figure 4 比較 NPO 與 GEPA 在 IFBench、HotpotQA(多跳問答,需要串連多份文件才能找到答案)這兩個任務上、換用不同 teacher(Qwen3-8B、DeepSeek-V4-Flash、GPT-5.5)時的表現:
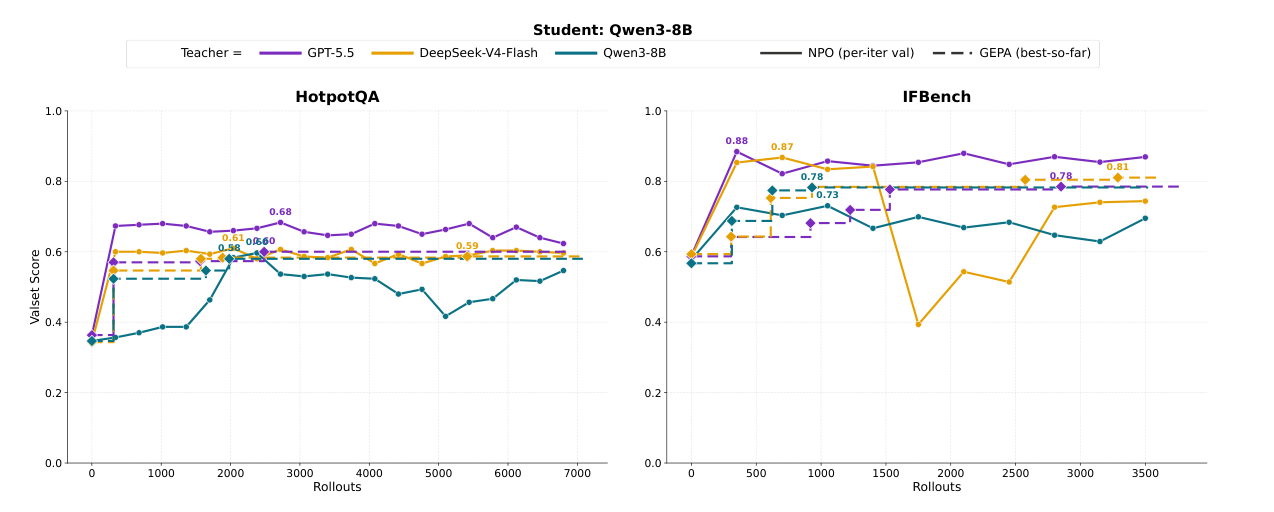
NPO 換成更強的 teacher 時表現明顯提升:teacher 換成 GPT-5.5 時,NPO 收斂最快、最終分數最高,兩個任務都能用比 GEPA 更少的執行次數(rollout)達到同等或更好的表現。反觀 GEPA 換 teacher 影響較小:GEPA 搭配 GPT-5.5 跟 GEPA 自己當自己的 teacher(搭配 Qwen3-8B)表現大致持平。
不過這裡有個很現實的限制,而且是承接前面〈批次抽樣的隱藏問題〉之外的另一個混淆變因:NPO 使用的 reflection minibatch 大小是 50(IFBench)或 40(HotpotQA),而 GEPA 用的是原論文預設的 3——差了 10 到 15 倍。雖然兩者最終「總 rollout 預算」相近(NPO 3,500/6,800,GEPA 3,593/6,871),但這代表 NPO 每次修訂看到的回饋資訊量遠比 GEPA 豐富。論文完全沒有做「把 GEPA 的 minibatch 也調到 50 重跑一次」這樣乾淨的對照實驗。也就是說,「NPO 比 GEPA 更有效率」這個結論裡,混雜了「單一路線 vs. pool 搜索架構誰比較好」跟「每次修訂看到的回饋資訊量誰比較多」兩個變因,論文自己沒有拆開驗證——這個結論本身可信,但「贏在哪」無法確定歸因。
7.2 跨模型 Prompt 遷移:小模型調好的 prompt,能不能直接套到大模型
論文 Figure 5 測試把在小模型(Qwen3-8B、Llama-3.1-8B)上優化好的 prompt,原封不動套用到更大的模型上(不重新優化):
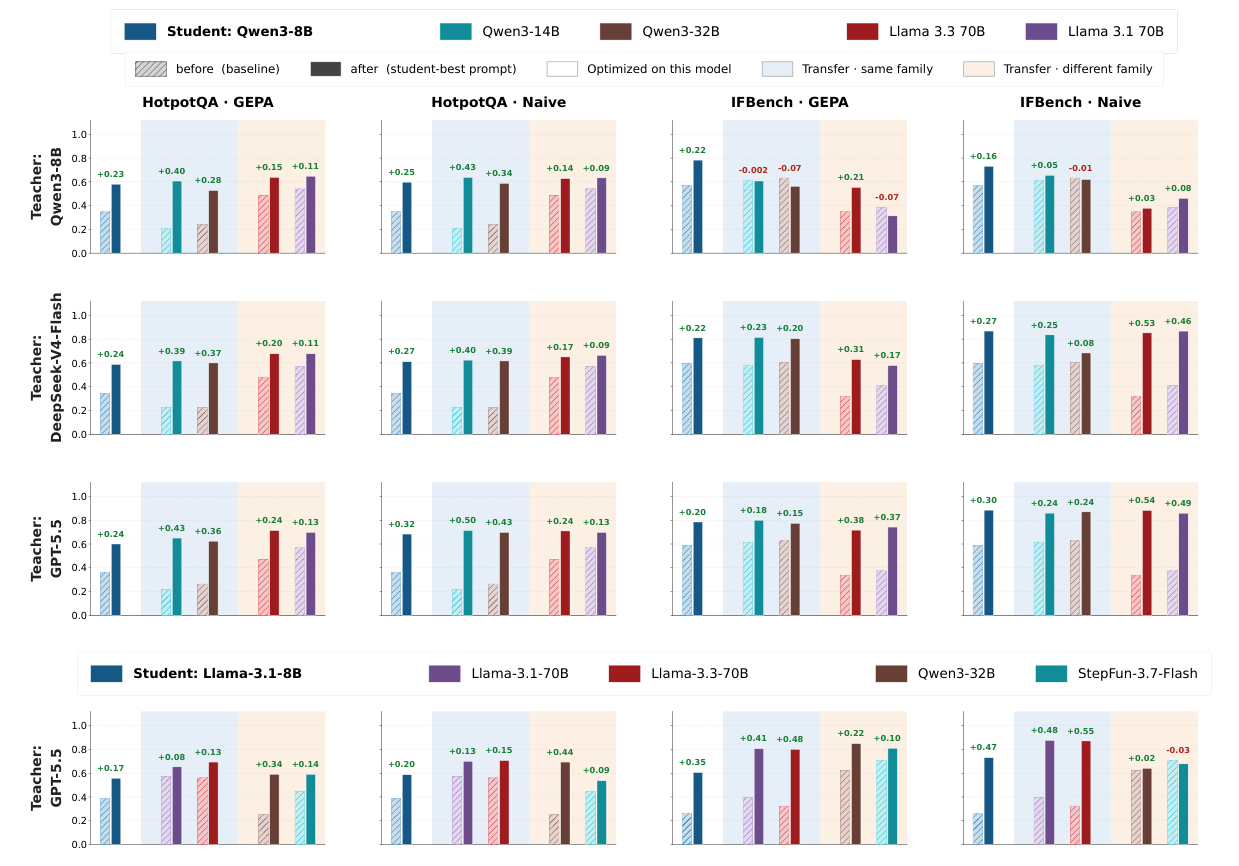
同一個模型家族內的遷移效果最強,大多穩定為正——例如 Qwen3-8B 優化好的 prompt 套到 Qwen3-14B、Qwen3-32B。跨家族遷移(例如套到 Llama 系列)也大多正向,但幅度較小、變異較大。少數例外是負值(例如 IFBench 搭配 GEPA 遷移到某些模型出現 -0.07、-0.002),但屬於少數情況,不是普遍現象。
這一節證明的其實是 prompt optimization 相對於權重層級 RL 的一個實際優勢——不需重新訓練就能遷移。但要注意,NPO 和 GEPA 在這一點上表現相近,這不是 NPO 獨有的優勢。
7.3 與 GRPO 的比較:沒有全面贏家
論文 Figure 6 在 22 個 TextArena(一套提供給 LLM agent 測試的文字型遊戲平台)遊戲環境中,控制相同的 rollout 預算,比較 NPO、GEPA、GRPO:
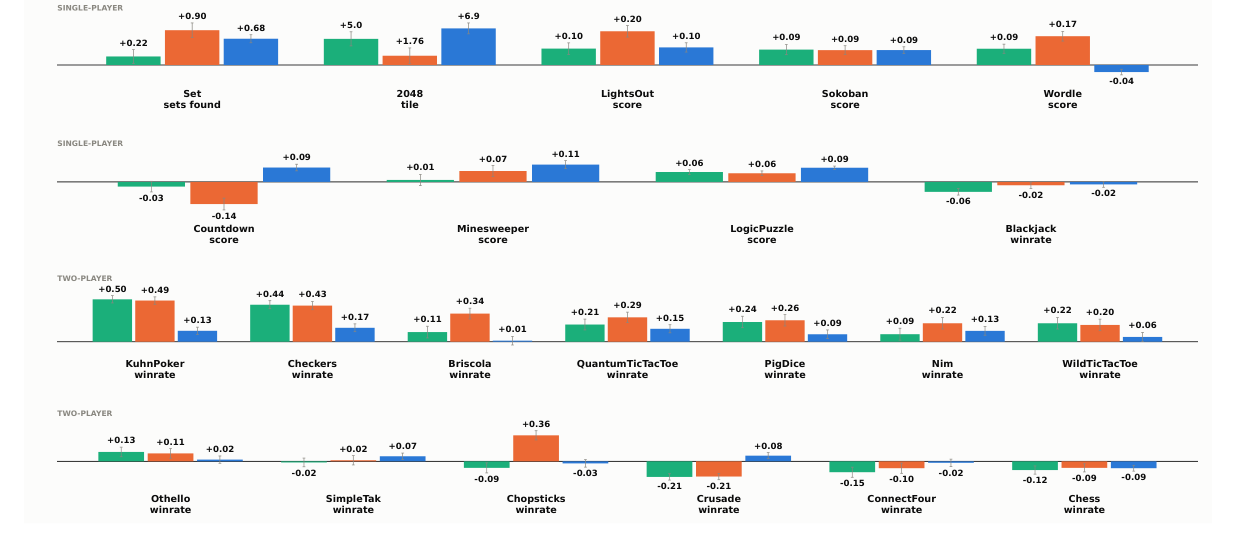
沒有全面贏家:NPO 與 GEPA 表現大致相當,沒有誰系統性地比較好;GRPO 在部分「prompt optimization 較無力」的任務上明顯更強。以 2048 遊戲為例:
| 方法 | 效能提升 |
|---|---|
| GRPO | +6.9 |
| GEPA | +0.90 |
| NPO | +0.22 |
GRPO 的提升幅度遠超另外兩者。部分雙人策略遊戲(如 Chess、ConnectFour、Crusade)三種方法表現都不佳、甚至出現負值,顯示這類任務可能本質上不太適合這三種方法中的任何一種。
論文明確指出,這個結果跟過去文獻常見的「GEPA 系統性優於 RL」印象不同——這裡沒有觀察到 GEPA 全面勝過 GRPO 的現象。老實說,這反而是這篇論文比較誠實、也比較有價值的一個發現,下一節會再談。
7.4 有沒有評估答案洩漏
因為 NPO 搭配強 teacher 時常產生比 GEPA 長很多的 prompt,論文額外檢查了一件事:這些 prompt 是否不小心「背」進了訓練或驗證集的正確答案,導致分數提升只是資料污染而非真實能力提升。
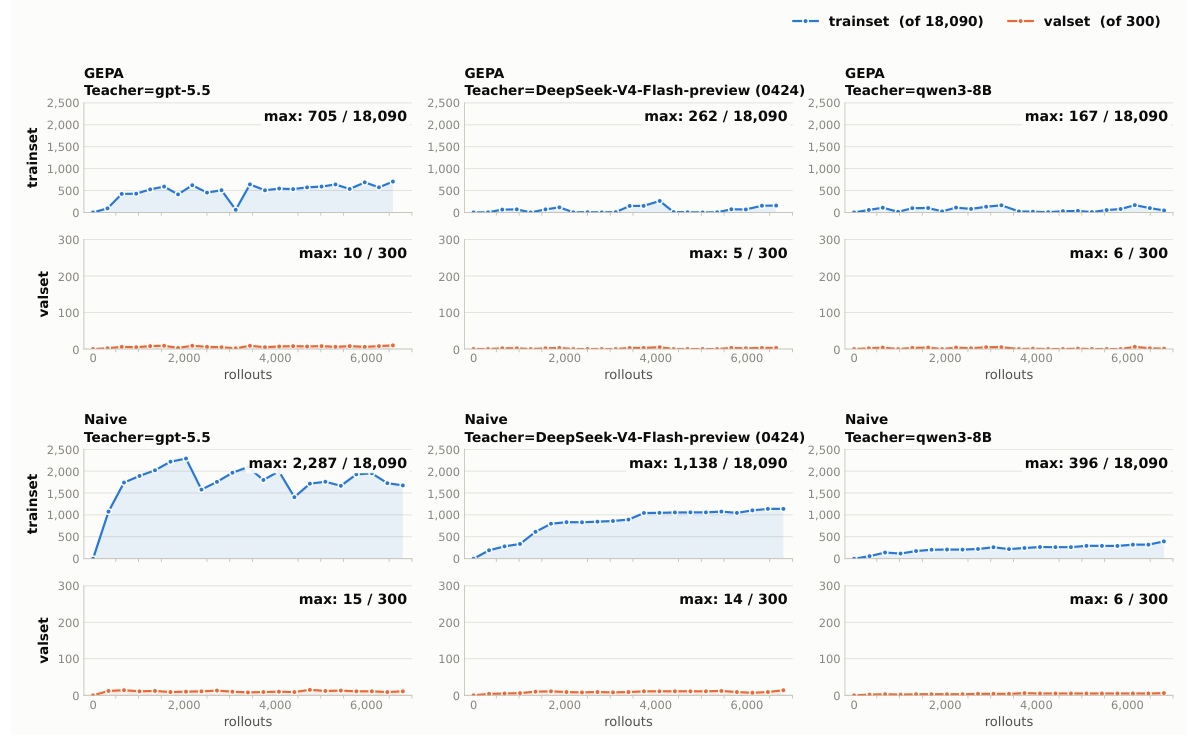
優化後的 prompt 跟訓練集答案的重疊度會隨迭代自然上升——這符合預期,因為 prompt optimization 本來就該從訓練範例中萃取有用資訊——但跟驗證集答案的重疊度幾乎沒有增加,人工檢查也確認少量重疊只是訓練跟驗證題目剛好共享同一個答案,不是直接洩漏驗證題目本身。結論是:觀測到的效能提升不太可能是評估答案洩漏造成的。這算是論文對自己實驗誠信度的把關,屬於加分項,不是核心貢獻。
8 這篇論文真正值得帶走的東西
8.1 論文本身的貢獻,說實話偏低
把前面幾節攤開來看,NPO 這個核心方法——用 sliding-window 回饋取代 pool-based 搜索——是 OPRO 的漸進式修改,不是新機制。核心賣點「NPO 用更少 rollout 打平或贏過 GEPA」這個結論,因為 reflection minibatch 大小沒對齊(NPO 50 對 GEPA 3)而混雜了兩個變因,論文自己沒有拆開驗證,所以「贏在哪」無法確定歸因。
反而比較站得住腳的貢獻是修正性的:推翻了「GEPA 系統性優於 RL(GRPO)」這個過去文獻的印象,誠實展示三種方法各有勝負、沒有全面贏家。這種「打臉過度宣稱」的價值,通常比正面宣稱更可信。Gold-answer leakage 的檢查算是加分項,不是核心貢獻。
一句話總結:這篇論文的貢獻接近一份乾淨的 ablation/baseline 研究,方法論創新趨近於零,真正的價值在下面這三點,而且這三點都獨立於 NPO 這個方法本身,脫離這篇論文也照樣成立。
8.2 心法一:配對隨機種子做公平比較
跟統計上的配對設計(paired design)是同一個邏輯:把會製造雜訊的變因鎖死成相同,才能讓組間差異乾淨反映真正想測的變因。以後要比較任何兩套系統或流程——不限 AI——這個原則都適用。
8.3 心法二:Constrained Decoding 的完整機制
字首樹(prefix trie)加逐節點遮蔽/重新正規化,是 Outlines 這類約束生成工具的底層邏輯。這不只是「知道有這個功能」而已,而是具體知道它逐 token 怎麼運作,遇到需要自己實作類似機制時才不會卡關。
8.4 心法三:Local vs Global 的取捨規則
這是整篇筆記技術含量最高的部分。Local 運算量低、一次生成就完成,但系統性地抹掉格式 token 的原始信心,只保留真正的決策分岔點,適合只在乎「決策品質」、想主動消除格式雜訊的場景。Global 數學上等價於拒絕採樣(rejection sampling)得到的真實條件機率,忠實保留模型原始信心,但運算量高——每個候選都要跑一次 teacher forcing——適合需要精確得知模型真實相對信心的場景,例如模型校準度分析。
背後更通用的觀念是:拒絕採樣與條件機率的等價關係。這在機率論與 MCMC(馬可夫鏈蒙地卡羅)方法中是通用工具,不只用在 constrained decoding 這一個場景,值得當成一個獨立的知識點記下來。
9 結論
NPO 這篇論文表面上的主張,是「回饋給得夠豐富、teacher 夠強,就能用一條路線的 prompt 修訂打平甚至打贏複雜的搜索式方法」。實驗結果部分支持這個主張,但因為 reflection minibatch 大小沒對齊,「贏在架構簡單」還是「贏在回饋資訊給得多」這兩個原因沒有被拆開驗證,所以只能算部分證實,不是斷案。
真正值得留下來的,反而是這篇論文示範的實驗方法論:用配對隨機種子把環境難度的雜訊鎖死,用約束解碼加上字首樹把格式雜訊跟決策品質分開,並且在 Local 與 Global 兩種機率算法之間做出清楚的取捨說明。這三件事都跟 NPO 這個方法本身無關,卻是這篇論文留下來最耐久的部分——下次自己要設計任何兩套系統的公平比較時,這套工程紀律可以直接拿來用。