PDF 解析排行榜能信嗎?拆解 ParseBench 的評分設計
 Hong-Wei Wu
收錄於 論文介紹
1 前言
PDF 解析(parsing)這件事最近有一個微妙的變化:以前解析出來的內容是給人看的,現在越來越常是直接餵給 AI agent 去做決策的。這篇論文《ParseBench: A Document Parsing Benchmark for AI Agents》就是針對這個變化,重新設計了一套評分方式。
它不是新的解析模型,甚至也不是新的解析方法——它提出的是新的評分方式,用來衡量「PDF 轉結構化內容」這件事做得好不好。作者來自 LlamaIndex/LlamaParse 團隊,論文裡也拿自家的 LlamaParse 打了個第一名,這點後面會回頭談。
先講結論,省得你讀到最後才知道值不值得:這篇論文研究價值偏低,工程價值偏高,而且高在「評分設計的思路」,不在排行榜的數字。如果時間有限,直接跳到本文「表格怎麼評」跟「可以帶走的三個技巧」兩節就好。
2 PDF 解析的讀者換人了,舊指標為什麼失靈
論文的核心觀察很直白:文件解析的服務對象變了。以前的標準是「好到能讓人讀懂」,現在要的是「可靠到能讓 agent 直接拿去做事」。差別聽起來抽象,但論文舉的幾個例子很具體:
- 表頭錯位,agent 核保理賠時抓到錯的數字。
- 圖表被壓成一段純文字,agent 手上沒有數字可以計算。
- 刪除線被解析工具丟掉,agent 把已經作廢的舊報價當成現在的價格。
- 上標被壓平成一般文字,腳註編號「1」被 agent 當成數量「1」。
這四個例子有一個共同點:文字相似度指標完全看不出問題。字幾乎都對,意思卻全錯了。論文把「意思要對」這個要求取了個名字,叫 semantic correctness(語意正確性)——這是全篇最重要的一個概念,後面所有維度的設計都是圍繞它展開的。
論文對既有基準的批評有兩點:文件分佈不對(大多是學術論文或乾淨截圖,不是真正驅動企業自動化的文件),指標也不對(比表面文字相似度,抓不到結構性的失效)。
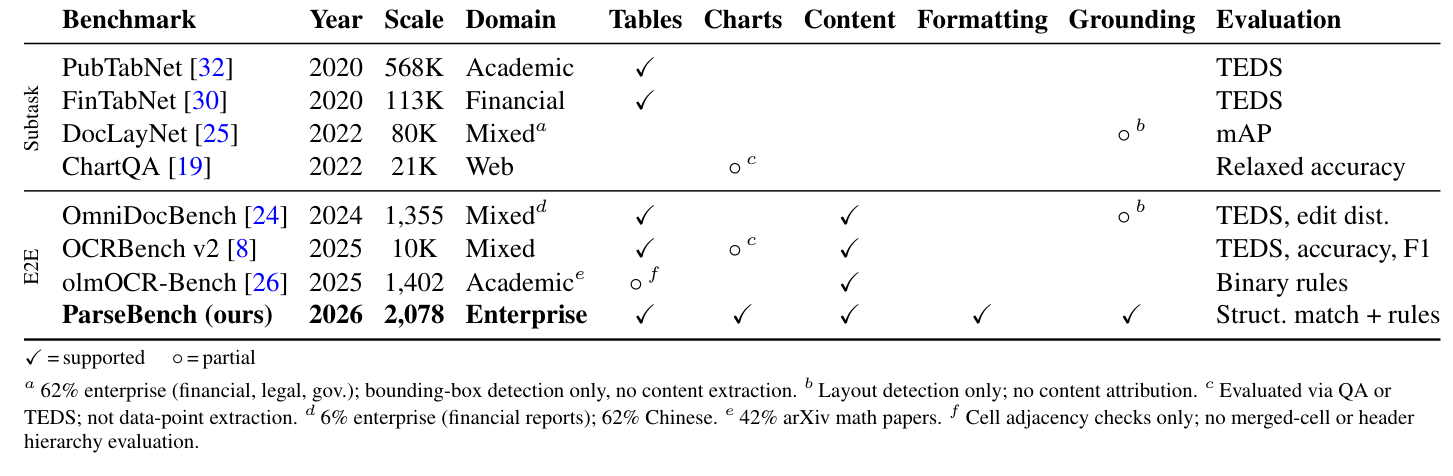
這張表的註腳其實比表格本身更有殺傷力:OmniDocBench 只有 6% 是企業文件,62% 是中文;olmOCR-Bench 有 42% 是 arXiv 數學論文;DocLayNet 只做 bounding box 偵測,根本不做內容抽取。換句話說,用這些基準去衡量「能不能餵給企業 agent 用」,本來就文不對題。
3 ParseBench 的五個維度,以及一個要先說在前面的細節
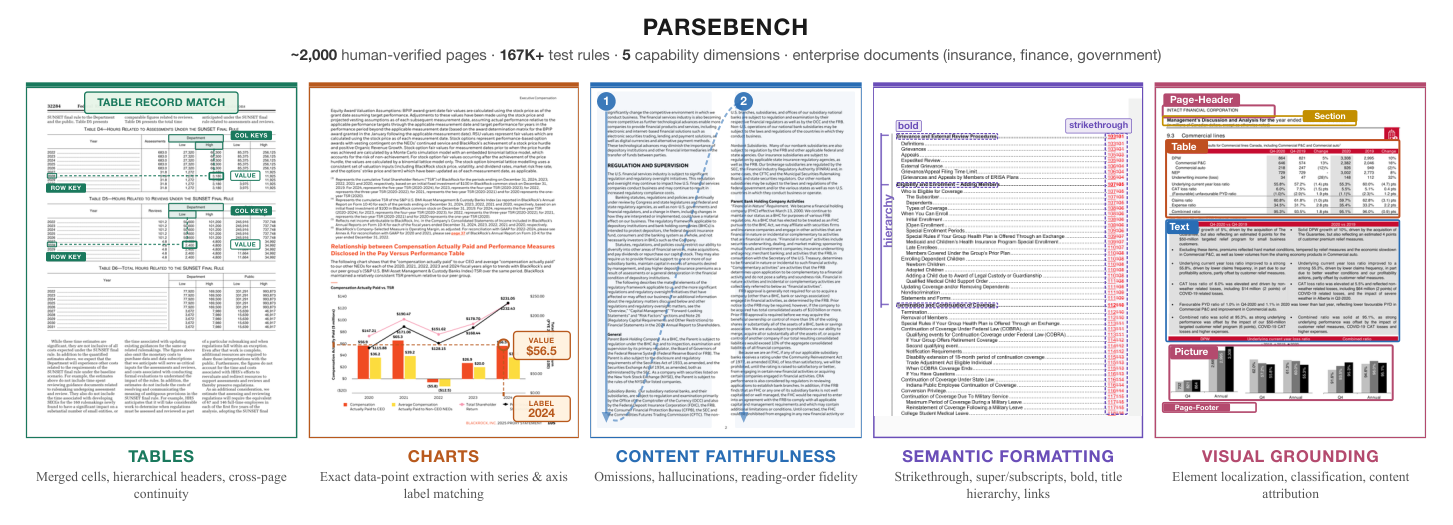
ParseBench 把「語意正確性」拆成五個維度,每個對應一種真的會弄壞 production agent workflow 的失效模式:
- 表格:合併儲存格、階層表頭、跨頁接續。
- 圖表:把圖表還原成精確數值點,不是文字描述。
- 內容正確性:漏字、幻覺、閱讀順序。
- 格式:刪除線、上下標、粗體、超連結。
- 視覺定位:每個抽出的元素能不能追回頁面上的原始位置,這一項的動機是稽核。
規模上總共有 2,078 頁、1,180 份文件、169,011 條規則。
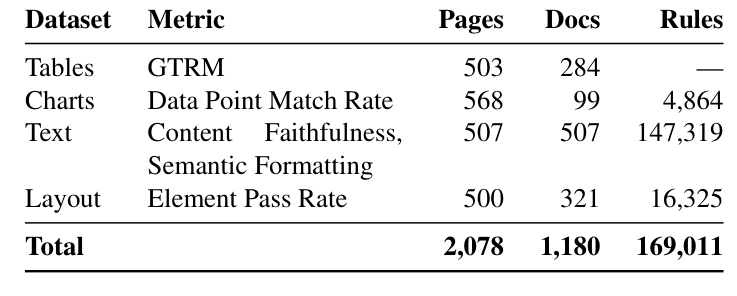
但這裡有兩個容易被行銷語言帶過去的細節:內容正確性跟格式這兩個維度共用同一批 507 份文件,只是套不同的規則集,所以「五個維度」實際上只對應四份資料集;而且這 16.9 萬條規則裡有 87% 集中在文字那份資料集,「169K test rules」聽起來很驚人,但主要是文字比對規則自動展開出來的量,不是 169K 個獨立設計出來的考點。
4 表格怎麼評:從 TEDS、GriTS 到 TableRecordMatch
這一節是全篇最有料的部分,先講兩個舊指標打底,再看論文自己提出的新東西。
4.1 兩個舊指標:TEDS 與 GriTS
**TEDS(Tree Edit Distance based Similarity)**出自 PubTabNet 論文,世界觀是把表格看成一棵樹:table 底下是一列列的 tr,每列底下是一格格的 td。它問的問題是「把預測的樹改成正確的樹,最少要付多少代價」——插入或刪除一個節點代價是 1,替換節點如果標籤不同代價也是 1,如果只是文字內容不同,代價則是兩段文字的正規化編輯距離(0 到 1 之間)。
這裡的關鍵是「替換的代價是文字的編輯距離」,後面解釋一個離譜高分時會用到。
**GriTS(Grid Table Similarity)**出自微軟 Table Transformer 團隊,世界觀是把表格看成一個矩陣,找出「同時保持行順序、也保持列順序」的最佳對應關係,再比對對齊上的每一對格子。計分套一個類似 F-score 的公式,分母是兩邊格子數的和,所以任何一邊多出來的格子都會稀釋分數。注意「保持順序」這個限制——這正是它會重罰欄位重排的原因,即使重排完全不改變表格的意思。
這兩個指標有一個共同的盲點:它們把表頭格和資料格一視同仁,對它們來說表頭只是「另一個格子」,沒有「表頭定義了整欄資料意義」這個概念。
4.2 TableRecordMatch:把表格看成一袋記錄
論文提出的 TableRecordMatch(TRM) 就是在補這個洞,做法是把表格從「格子的排列」改看成「一袋記錄」:一列變成一筆記錄,記錄裡每個值都用它所在欄的表頭當 key。「一袋」的意思是無序的,不管列怎麼排、欄怎麼排,袋子裡的內容都一樣——這就是它對排列不敏感的原因。反過來,表頭一旦掉了或錯位,每個值的 key 都變了,整袋記錄會全部對不上,這正是它想要的懲罰。這個概念其實來自關聯式資料庫(一列就是一筆有欄位名的記錄),數學形式是 Jaccard 相似度的變形。
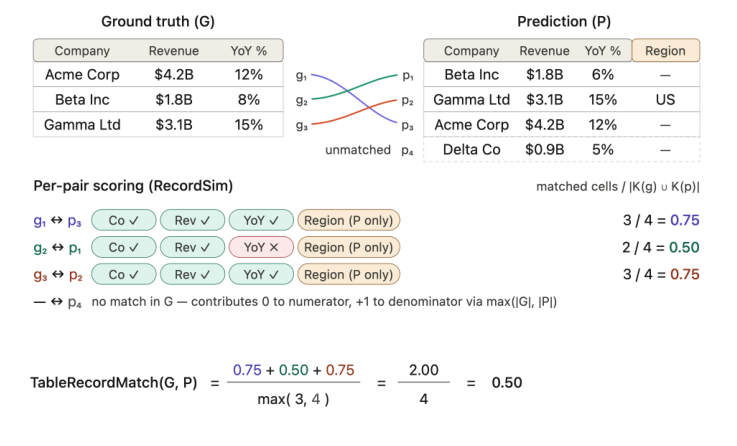
公式長這樣:
是正確答案那袋記錄, 是預測出來那袋,兩者先找出最佳配對,再逐對算 。用一個算例會比公式好懂:正確答案有三筆記錄(Acme、Beta、Gamma,各有 Company/Revenue/YoY% 三個欄位),預測出來的四筆記錄裡多了一個 Region 欄,還多冒出一筆憑空出現的 Delta,而且 Beta 的 YoY% 從 8% 錯寫成 6%。逐筆比對後,配上的三對分數分別是 0.75、0.50、0.75(都因為多出的 Region 欄被聯集稀釋),配不到任何正確答案的 Delta 那筆貢獻 0 分。加總除以 ,最後 TRM 只有 0.50。
這個算例同時示範了兩種懲罰:欄位層級的懲罰(聯集分母對稱地懲罰多出或少掉的欄位,表頭被丟掉正是走「少了一欄」這條路),跟記錄層級的懲罰(分母用 4 而不是 3,多餘的 Delta 白白佔一個位置卻沒有分子貢獻)。
4.3 TRM 的實作細節與 GTRM
不過老實說,如果你想自己實作 TRM,論文給的是評分哲學,不是可複現的規格。有三個關鍵細節從頭到尾沒交代:配對演算法要優化什麼目標函數、用什麼演算法求解(如果是二分圖最大權匹配,標準解法是 Hungarian algorithm,但這是我的推論,論文沒寫),以及欄位 key 怎麼比對——是要求表頭字串完全相符,還是允許模糊比對(大小寫、空白、Revenue 跟 Revenue (USD))?最後這一點在實作上最會咬人:如果是嚴格字串相等,parser 只要在表頭多帶一個單位符號,整張表就掛了。這也代表別人若獨立實作 TRM,不見得能複現論文表格裡的數字。
主結果表裡「Tables」那一欄報的其實不是純 TRM,而是 GTRM,也就是 ,不加權,各佔 50%。矛盾的是,論文花了一整段篇幅論證 GriTS/TEDS 不適合現代生產環境,附錄還給了實例坐實這個批評,結果卻把這個「會給出 0.998 錯誤高分」的指標,以 50% 權重放進最終分數裡。論文對這個決定的全部說明只有一句「we combine both perspectives into a single score」,沒有解釋為什麼要合併、為什麼是 50/50。
4.4 附錄的兩個對照例子
附錄的兩個對照例子把這個矛盾具體化了:
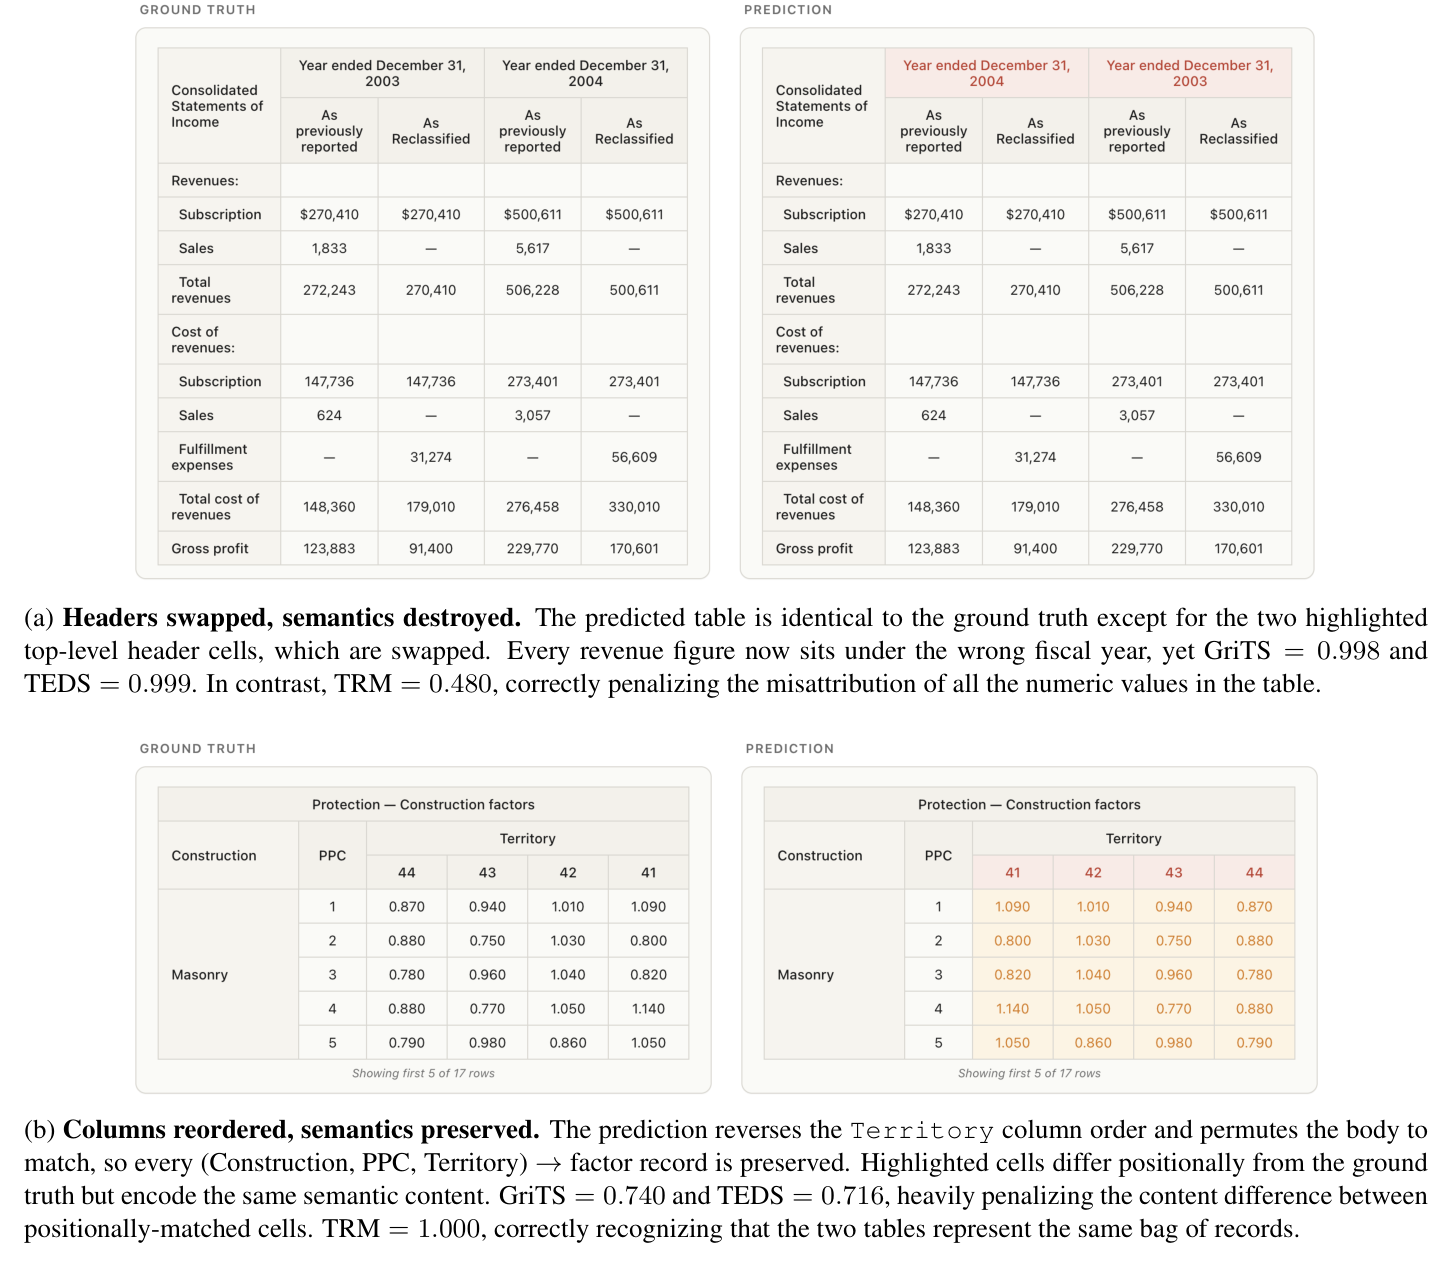
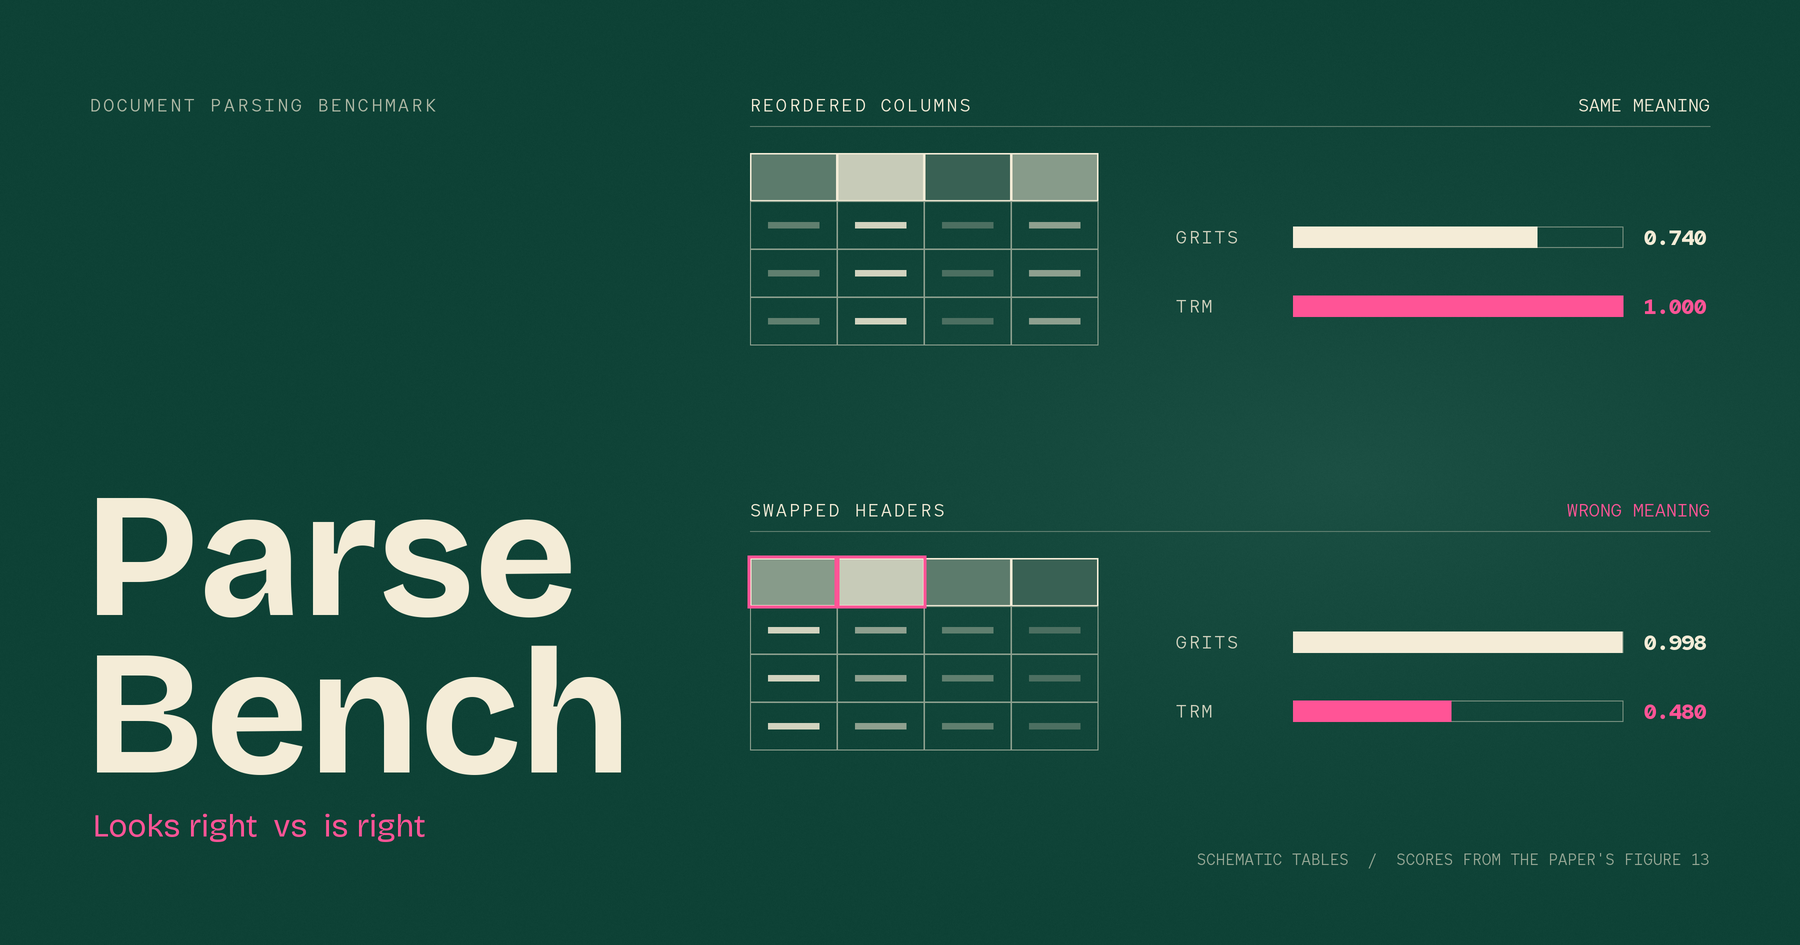
(a) 表頭被對調,所有數字都掛錯年份,GriTS 給 0.998、TEDS 給 0.999,TRM 只給 0.480。(b) 欄位順序重排,語意完全等價,GriTS 卻給 0.740、TEDS 給 0.716,TRM 給滿分 1.000。這兩個數字讓「既有指標有問題」從主張變成事實,是全篇最值得記住的證據。
為什麼 (a) 可以拿到 0.999 這麼離譜的高分?因為被對調的兩個表頭是「Year ended December 31, 2003」跟「Year ended December 31, 2004」,28 個字元只差 1 個。每個替換的代價約 ,兩個加起來約 0.071,而那張表大概有 60 到 70 個節點,算下來 ——這段拆解是我根據 TEDS 定義推算的,論文只給了 0.999 這個結果,但它完美解釋了分數為什麼這麼高。語意上,整張財報每個數字都掛到錯的年份;數學上,這只是 0.07 刀的編輯距離。順帶一提,論文其實對 TEDS 做了對它有利的調整(先把表頭儲存格降級成一般資料格,因為 TEDS 預設不比對表頭內容),所以「0.999」還是調整過的結果,不調整只會更寬鬆。
4.5 TRM 失效的兩種表格
TRM 也不是萬用的,它整個前提是「一列等於一筆記錄,key 來自上方的欄表頭」,這個前提一旦破了就會失效。第一種情況是表格中間插入不連續的分區標題列(例如按地區分組),TRM 會把分區標題也當成一筆普通記錄,原本「屬於北美」這個資訊就整個消失了,如果剛好有兩個地區的公司數字一樣,兩筆記錄還會完全無法區分——因為 TRM 是無序的一袋,連前後順序都不看。
第二種情況是表格同時有上方跟左方兩種表頭(例如列是 Revenue/Cost,欄是 Q1/Q2/Q3),這種表格的每個值需要兩個表頭才能定義,但 TRM 只認欄表頭,會讓列表頭被降級成一個普通的值。這裡還有個蠻諷刺的推論:這種表格轉置後語意完全等價,但轉置後整組 key 都換了,TRM 反而會給接近 0 分——它最引以為傲的「對排列不敏感」,在這類表格上恰好失效。論文對這兩類案例的處理是人工審查標記、一律改報 GriTS,做法一致也算誠實,但沒說這類表格佔多少比例,所以主表「Tables」那一欄裡有多少分數其實是純 GriTS 貢獻的,無從得知。
5 圖表怎麼評:只抽查資料點的 ChartDataPointMatch
圖表的評分邏輯完全不同,論文的理由是:幫每張圖標出完整的正確答案表格「成本高又脆弱」,畢竟讀圖表本身就帶主觀性——一條股價折線,該標日、週還是月?
所以它改成抽查:每張圖標最多 10 個資料點,每個點包含要一起出現的標籤(系列名、x 軸類別、圖表標題)、期望的數值,跟一個容差。指標就是成功驗證的資料點比例,沒有公式。容差怎麼定:有明確標數字的圖表用完全比對,沒標數字要用眼睛估的則用相對容差,預設是 1%,但實務上容差是人工在標註時逐點決定的。
一個具體的例子能看出容差怎麼跟著讀圖難度調整:
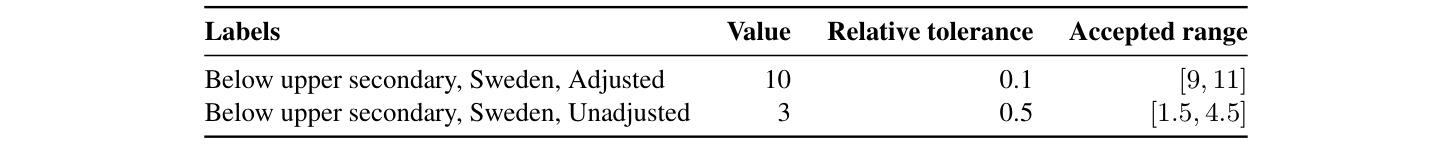
同一張圖裡,數值為 10 的那個點容差只給 10%(接受區間 [9, 11]),另一個數值只有 3 的點容差卻寬到 50%(接受區間 [1.5, 4.5])——因為那根長條在 3D 圖上非常短,很難精確讀出來。
驗證流程分四步:先從輸出裡抽出 Markdown 或 HTML 表格,接著用周圍文字(粗體、標題、caption)定位到相關的表,再做模糊比對加數值正規化找到值(貨幣符號、k/M/B 後綴、千分位都會被吃掉,所以 $1,234K、1234000、1.234M 會被當成同一個數),最後確認其餘標籤有沒有正確關聯到那個值。這套設計聰明的地方在於它對輸出表格的格式完全不敏感——附錄示範四個 provider 用橫式、縱式、Markdown、HTML 四種完全不同的結構輸出同一張圖,評分完全不受影響,因為它只在乎「標籤跟數值有沒有共同出現」。
要打折的地方也很明顯:容差是人工逐點決定的,論文只給了兩個範例,沒公布整體容差分佈,這是一個沒被量化揭露的自由度;另外抽查 10 個點不等於整張圖都對,一張有 40 個資料點的圖,抽 10 點全對只代表這 10 點對,論文對此沒有討論。
6 內容正確性:兩層平均,不讓數量決定話語權
這個維度論文說是「最基礎、最 table-stakes」的一個——漏字、幻覺、順序錯,agent 的整個上下文就髒了。規則分兩大類:文字正確性(漏字、幻覺、片段該在或不該在、數字出現頻率分佈)跟閱讀順序(每條規則指定兩個文字片段「before」跟「after」,通過條件是 before 的第一次出現要早於 after 的最後一次出現)。用「第一次」對「最後一次」而不是兩邊都取第一次,是因為某些片段會重複出現(例如標題也出現在目錄裡),這樣才不會因為 parser 管不到的重複而誤判正文順序錯誤。
兩層平均是這節真正的設計亮點,要解決的問題很直覺:一份密集排版的文件可能有 500 條漏字規則,但只有 3 條幻覺規則,全部丟進去平均的話,漏字會完全淹沒幻覺。做法是先在同一個規則型別內部平均(500 條漏字規則先壓成 1 個數),再跨型別平均(漏字的 1 個數跟幻覺的 1 個數等權平均),數量就不再等於話語權。最後合成總分時,文字正確性權重 1.0、閱讀順序權重 0.5——論文說是因為文字正確性是更關鍵的失效模式,但老實說這個比例沒有任何依據或敏感度分析。
單一總分會掩蓋不同的失效模式,這點在下面這個例子看得特別清楚:
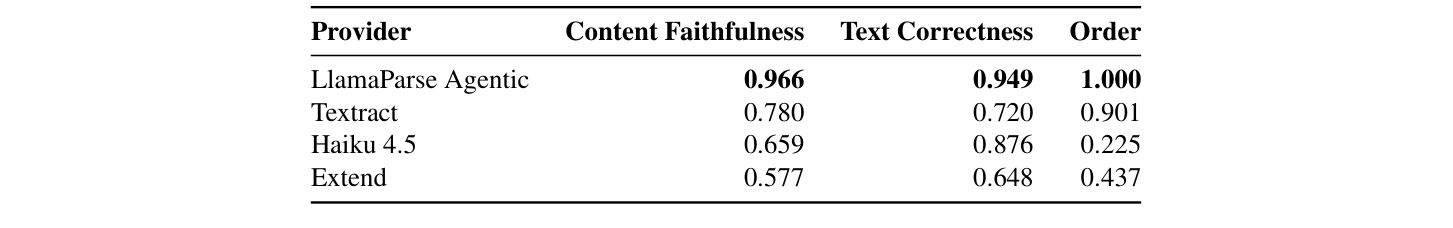
Textract 的問題是內容重複,Haiku 4.5 是幻覺加欄位順序打亂,Extend 則是跨欄橫向讀取。三種完全不同的病,但如果只看一個總分,你看不出來是哪一種——這正是拆成子分數的價值所在。
這個維度的資料是從網路上隨機抓 500 份 PDF,每份取一頁,而且刻意排除了表格、圖表很多的頁面。內容正確性跟格式維度用的是同一批文件,只是套不同規則集:
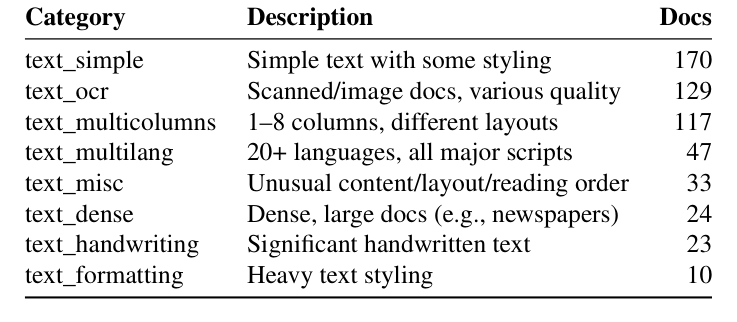
類別分佈很不平均——重排版(text_formatting)只有 10 份文件,而這批文件同時也拿去評格式維度,用 10 份文件去評「重度排版」能力,樣本明顯偏薄。
順帶一提,bag_of_digit_percent 這條規則專門抓數字誤認(例如 OCR 把 6 看成 8),做法是統計輸出裡每個數字出現幾次,跟正確答案的分佈比。論文自己承認,只有在兩個數字出現頻率剛好相同、又剛好雙向互換時才會抓不到,這個條件相當苛刻,接受這個限制算合理。但這裡有個論文沒提到的更大的洞:這個規則本來就不看位置,所以「Revenue 2.0M USD, Cost 0.2M USD」被輸出成「Revenue 0.2M USD, Cost 2.0M USD」,數字分佈完全一樣,會直接放過。說來諷刺,論文開頭正是拿「2.0% 被讀成 0.2%」當核心動機案例,說這種錯誤會讓下游財務模型完全失真,但它自己的數字級檢查對這種位置交換偏偏是盲的。
7 格式:抓「有沒有意義的格式」,但公式有一個算反的地方
這個維度只測帶有語意的格式,不測純裝飾:刪除線標示已作廢的內容(丟掉的話 agent 會把舊價當現價),上下標對應腳註或化學式(壓平的話 x² 會變成 x2),粗體標示定義詞或關鍵數值。
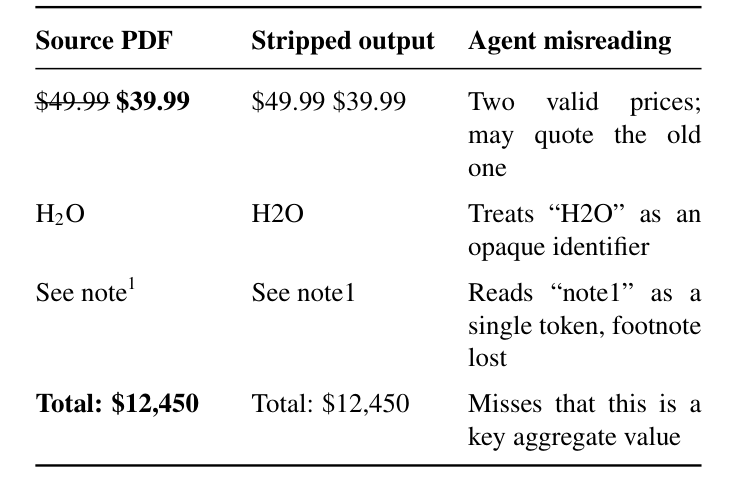
每個類別都成對設計正反兩種規則,is_strikeout 抓「該標的沒標」,is_not_strikeout 抓「不該標的卻誤加」——只測正向會獎勵「什麼都標」,只測反向會獎勵「什麼都不標」,成對測試才公平。
子分數用的是加權調和平均,形式跟 F-score 一樣,只是把 precision/recall 換成正向規則跟反向規則各自的平均通過率。用調和平均的用意是對的:任一邊很低,總分就會被拉下來,換成算術平均就不會有這個效果(正向 1.0、反向 0.0,算術平均還有 0.5,調和平均會趨近 0)。
但仔細代數字驗算後會發現,這個公式本身算反了。論文說設定 是為了「更重罰誤加格式(false styling),而不是漏標格式」。實際代進去算:正向全對、反向差的情境算出來是 0.833 分,正向差、反向全對的情境卻只有 0.556 分——這代表公式實際上罰「漏標」比罰「誤加」重,跟論文宣稱的完全相反。原因在於標準 F-score 裡 加重的是分母裡沒有 那一項對應的那個量,而論文把正向通過率放在那個位置,於是被加重的變成正向規則。想達成論文宣稱的效果, 應該要大於 1 才對。這是論文本身公式跟文字描述不一致的地方,可能是公式寫錯,也可能是說明寫錯,論文沒給任何數值示範可以判斷。
另外這個維度還有一個更根本的疑慮,一個資訊圖表的例子讓這個疑慮特別清楚:
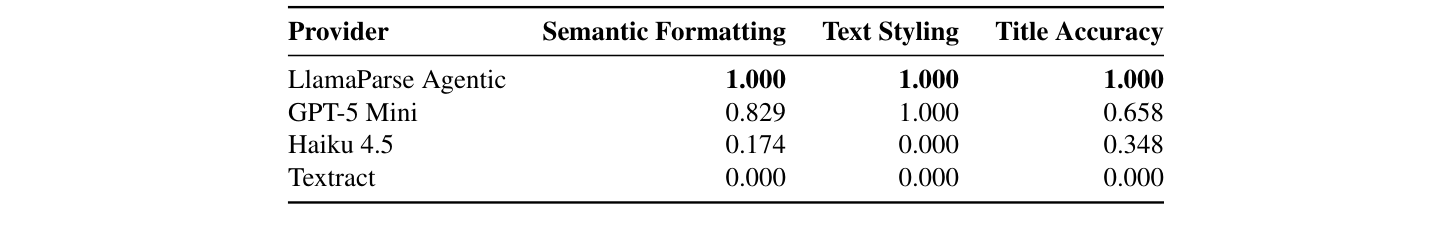
有個模型把文字都抓對了,但輸出的是 HTML 標籤(<h3>、<strong>)而不是 Markdown 語法,規則期待的是 **text**,於是整個 styling 分數直接歸零。一個能正確辨識出 <strong> 的模型,你很難說它「不理解語意格式」——它只是輸出格式不符合規則預期而已,這也部分解釋了主表裡那些接近 0 的分數到底是怎麼來的。
8 視覺定位:三段全過才算數,以及為什麼用 IoA 不用 IoU
這個維度測的是每個抽出來的元素能不能追回頁面上正確的區域。論文有句話點得很好:一個 parser 完全可能產出讀起來正確無誤的 Markdown,卻在視覺定位上徹底失敗——因為它把對的字配到了錯的區域。
8.1 計分方式與 IoA
計分方式是三段相乘,一段掛掉全部歸零:定位(IoA 過關與否)、分類(標籤對錯)、內容歸屬(適用時,token 是否對得上)。論文明講不用平均的理由是「平均會過度獎勵那些仍然破壞了追溯性的部分成功」。
定位方法的選擇是全篇最務實的技術決定:用的是 IoA,而不是常見的 IoU。IoU 是對稱的,分母是兩邊區域的聯集;IoA 是非對稱的,分母只看其中一邊自己的面積。文件解析裡「切開」跟「合併」是家常便飯——同一大塊文字,系統 A 輸出 1 個框、系統 B 輸出 3 個小框,兩種都不算錯,但 IoU 會因為聯集被撐大而重罰這種差異,IoA 用單邊面積當分母就能容忍。論文用了兩個方向的門檻:ground truth 至少一半要被預測框蓋到(要求實質覆蓋),預測框至少兩成要落在 ground truth 內(擋掉一個框蓋整頁的偷吃步),門檻設得這麼寬鬆就是為了容忍切分。
內容歸屬也有自己的一組門檻:候選框先用比較寬鬆的 IoA(至少三成落在 ground truth 內)蒐集,文字正規化後比對,一般元素要 token 層級的 F1 達到 0.80 才算過,圖表類的元素則改用 recall 達到 0.80——因為圖表裡有些數值標籤本來就沒辦法窮舉所有合理的描述方式,抓到該抓的就算過,多寫的內容不罰。
8.2 懸崖效應,以及為什麼刻意用二元判定
代價是懸崖效應:IoA 算出來 0.51 就過關、記 1 分,算出來 0.49 就掛掉、記 0 分,兩個畫得幾乎一模一樣的框,分數可以差到 100%。而這個維度一共有四個門檻(0.50、0.20、0.30、0.80),三段又是相乘的,任何一個門檻微調都會被放大,論文完全沒做敏感度分析,也沒說明門檻是怎麼定出來的。
為什麼設計成三段相乘、而不是把 IoA 這種連續分數直接拿來用?因為分類這一段根本沒有連續分數可用——你不可能說一個 Table 被標成 Picture 是「分類對了七成」。既然中間有一段只能是二元判定,要串成一條鏈就得統一成二元,而在乘法鏈裡只要有一段是二元的,整條鏈的連續性其實是假的:定位 0.9 分但分類錯了一樣算 0 分,定位只有 0.3 分但分類錯了也是算 0 分。更根本的理由是,這個指標問的是「可不可用」而不是「有多接近」——稽核本來就是二元問題,一個元素能不能追回原位置,能就是能,不能就是不能,「IoA 0.45,所以追回了四成五」對稽核沒有意義。附錄倒是保留了連續版本的診斷指標,論文自己說得很清楚,那些是拿來輔助判讀的診斷摘要,不是要平均進主分數的獨立項目——主指標故意選二元,連續資訊留在旁邊當診斷用,這個分工其實蠻合理的。
9 開不開源?評分方法送你,得分的產品要付錢
開不開源這件事要分三層看,答案完全不一樣:評分方法(也就是上面那些公式)論文裡寫得清清楚楚,公開的,可以自己實作,不需要任何授權;資料集加評測程式碼,論文宣稱開源在 HuggingFace 跟 GitHub,可以拿來跑自己的 parser(但實際 repo 狀態跟授權條款我沒有查證,這是論文自己的宣稱);至於拿到第一名的 LlamaParse 本人,不開源,是要付費的 API。
這其實反映了一個很重要的事實:這篇論文提出的「方法」是評分方法,不是解析方法,它完全沒告訴你怎麼把 PDF 解得更好。論文對自家系統的描述只有一句話——多步驟 pipeline、編排 VLM、搭配專用工具、迭代精修,沒有任何實作細節、沒有架構圖、沒有 prompt。附錄反而把所有競品的 prompt 全文貼出來了,自己的一個字都沒有。說白了,評分規則是送你的,但得分的產品要你付錢。
10 排行榜數字:84.9% 這個第一名,要打多少折
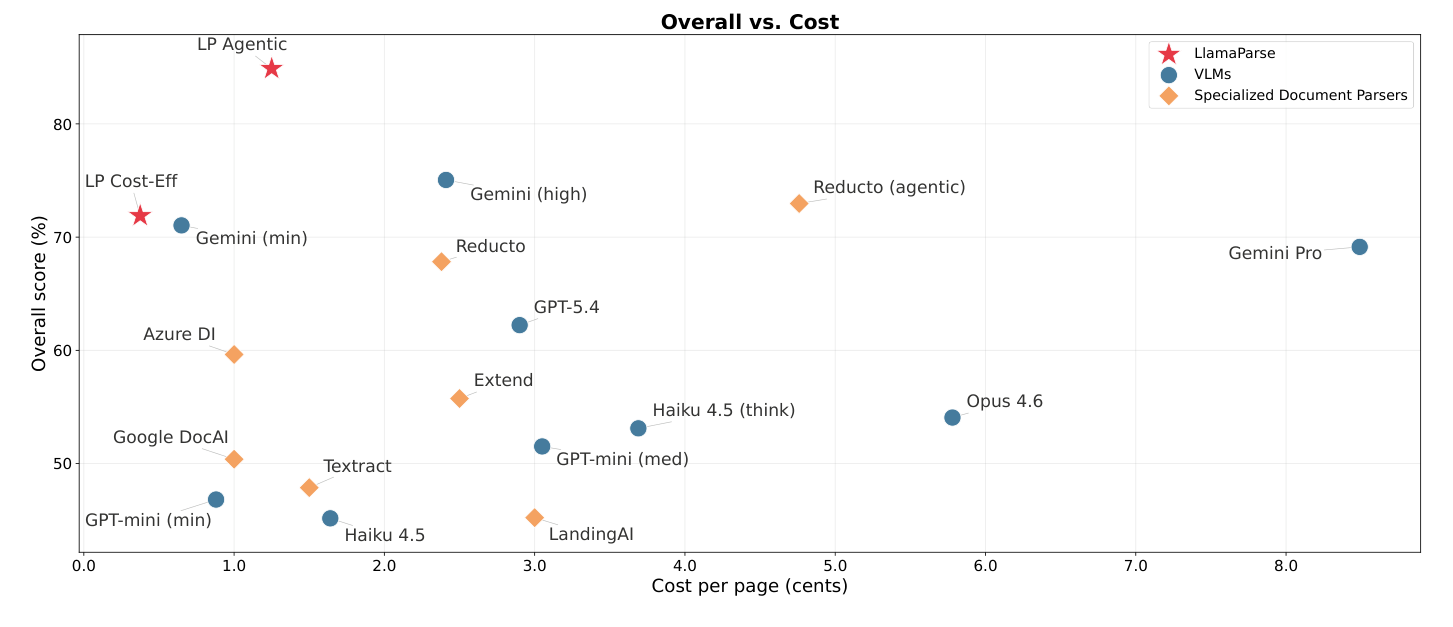
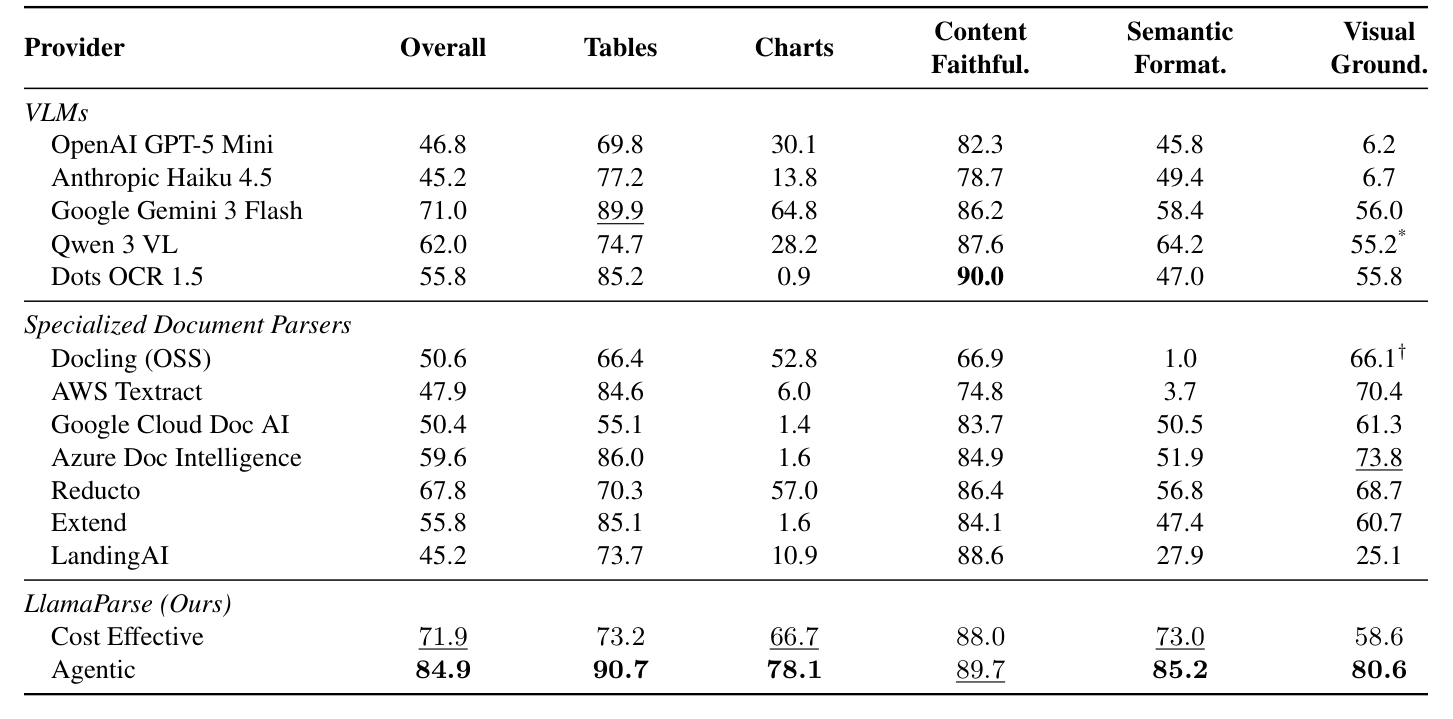
論文宣稱的結果是 LlamaParse Agentic 以 84.9% 居冠,最強的外部競品是 Gemini 3 Flash(71.0%)跟 Reducto(67.8%)。這個第一名有三個理由要打折。
第一,這是廠商自家的 benchmark,作者信箱清一色是 @runllama.ai——自己出題、自己訂評分標準、自己拿第一名。論文有意識到這點,寫了一句「我們鼓勵獨立複現,外部得到更強結果會證實這個 benchmark 有用,而不是削弱它」,這句話寫得很漂亮,但不改變評分規則裡每一個設計選擇都是他們自己做的這個事實。
第二,比較對象根本不對等:競品的 VLM 是用單一 prompt 呼叫一次,商用 parser 是用預設設定,自家系統卻是多步驟、帶工具、會迭代精修的 agent pipeline。拿 agent pipeline 去比單次推論,贏了並不奇怪——這不是模型能力的比較,是「系統 vs 單次呼叫」的比較。論文自己也提供了佐證:另一家競品切換成 agentic 模式後,整體多了 5 分,表格多 10 分,圖表多 16 分。光是「換成 agentic」這個動作本身就值不少分,跟是誰做的沒關係。
第三,Overall 是五個維度未加權平均,而 charts 跟 semantic formatting 這兩個維度,大多數競品接近 0 分(某些傳統 parser 的 charts 只有 1 到 6 分)。這不是能力差距,是「有沒有做這個功能」的差距——傳統 IDP 產品從來沒打算把圖表轉成資料表。
如果只看三個大家都真的有在做的維度(表格、內容正確性、視覺定位),LlamaParse Agentic 的三維平均是 87.0,最佳外部競品(這裡換成 Azure DI)是 81.6,差距從五維的 13.9 分縮到 5.4 分,而且最強競品的身分還換了人。領先仍然是真的,只是沒有排行榜看起來那麼誇張。
成本前緣圖(上面那張圖 5)也一樣要保留:論文自己的成本是內部數字,跟別人公開標價比,不是同一種東西,圖看看就好。
排名之外,論文其實提到一個更該放在心上的現象:VLM 擅長內容層級的理解,專用 parser 擅長結構跟版面感知的抽取,而下游的 document agent 兩者都需要。附帶一個具體的失效樣態——單次呼叫的 VLM 在視覺定位上幾乎全滅,有的只拿 6 分,原因不是框畫歪了一點,而是它們輸出的是「頁面級的粗略大區塊」,根本沒在做元素級的分解。要求一個 VLM 在單次呼叫裡同時輸出內容跟幾十個 bounding box,這個任務對它太重了。
11 可以帶走的三個技巧
先把這篇論文的體質認清楚:它是一份工程產物,不是一個理論框架。五個維度各用一套完全不同的評分機制,彼此沒有共同的數學基礎,每一套裡都塞了拍板決定的常數——GTRM 的 50/50、內容正確性的 1.0/0.5、格式維度的 、視覺定位 IoA 的四個門檻,沒有一個給了依據或敏感度分析。所以讀它的方式不是把它當一個整體來記,而是挑幾個有用的技巧帶走。
底下唯一的一條主線是:當下游消費者從「人」變成「agent」,評分標準就得從「看起來像不像」改成「意思對不對」。這句話本身不新鮮,但論文把它具體化成可執行的指標,這是它真正的貢獻。三個可以直接搬走的技巧:
① TableRecordMatch 的概念轉換,把表格從「格子的排列」重新理解成「以表頭為 key 的一袋記錄」。拆開來看有兩個設計技巧可以單獨用:分母用聯集,同時懲罰多出來跟缺少的欄位;分母用兩邊記錄數的最大值,懲罰多餘的記錄。這是全篇唯一一個真正新的看事情的方式,不只是新的算法。
② 兩層平均,解決規則數量不均的問題。評分底層如果是一堆數量懸殊的檢查項(500 條漏字 vs 3 條幻覺),先按型別內部平均、再跨型別平均,數量就不再等於話語權。這個技巧跟文件解析完全無關,任何規則式評測都能用。
③ 「該通過的」跟「不該誤判的」要成對測試,像 is_strikeout 一定要配 is_not_strikeout。只測正向會獎勵「什麼都標」,只測反向會獎勵「什麼都不標」,成對加上調和平均,任一邊崩掉總分就會跟著崩——但要提醒一句,論文那個 的方向是算錯的,真的要用這招得自己重新驗算。
TEDS/GriTS 的失效模式(表頭對調拿 0.999、語意等價的欄位重排卻只有 0.740)是「指標跟任務不匹配」的一個好教材。但要公平地說,TEDS 跟 GriTS 不是爛指標,它們是為「表格結構辨識」設計的,那個任務關心的就是格線在哪、合併儲存格對不對,在那個脈絡下它們很合理。問題出在任務換了,不是指標本身錯了。
至於排行榜數字、LlamaParse 自己的做法(論文一個字都沒寫)、成本前緣圖、還有那一堆拍板決定的常數,這些就不用太當真了,要用都得自己重新校準。
12 結論
這篇論文把「評分標準要從像不像換成對不對」這句話,落地成五組可執行的指標,這是它真正站得住腳的貢獻。真正有價值的部分很集中:TableRecordMatch 把表格重新理解成一袋記錄的概念轉換,兩層平均解決規則數量不均的技巧,以及正反成對測試的設計——這三個拿到別的評測場景一樣能用。至於排行榜上 84.9% 這個第一名,記得它是廠商自家出題、拿 agent pipeline 打單次呼叫、又用未加權平均放大對手沒做的功能,打完折之後領先幅度會從 13.9 分縮到 5.4 分。整篇論文值得讀的部分,大概只佔兩成。