拆解 Persona-Aware-D2S:同一份文件,怎麼依受眾和長度長出不同簡報
 Hong-Wei Wu
收錄於 論文介紹
1 前言
把一篇論文變成投影片,這件事沒有標準答案。講給同領域的研究者聽,你會直接跳進模型架構;講給業務主管聽,你得先講清楚這東西能解決什麼問題,架構細節反而是干擾。但市面上的「文件轉投影片」(document-to-slides,以下簡稱 D2S)系統幾乎都是單一輸出:文件丟進去,吐出來的永遠是同一份大綱。
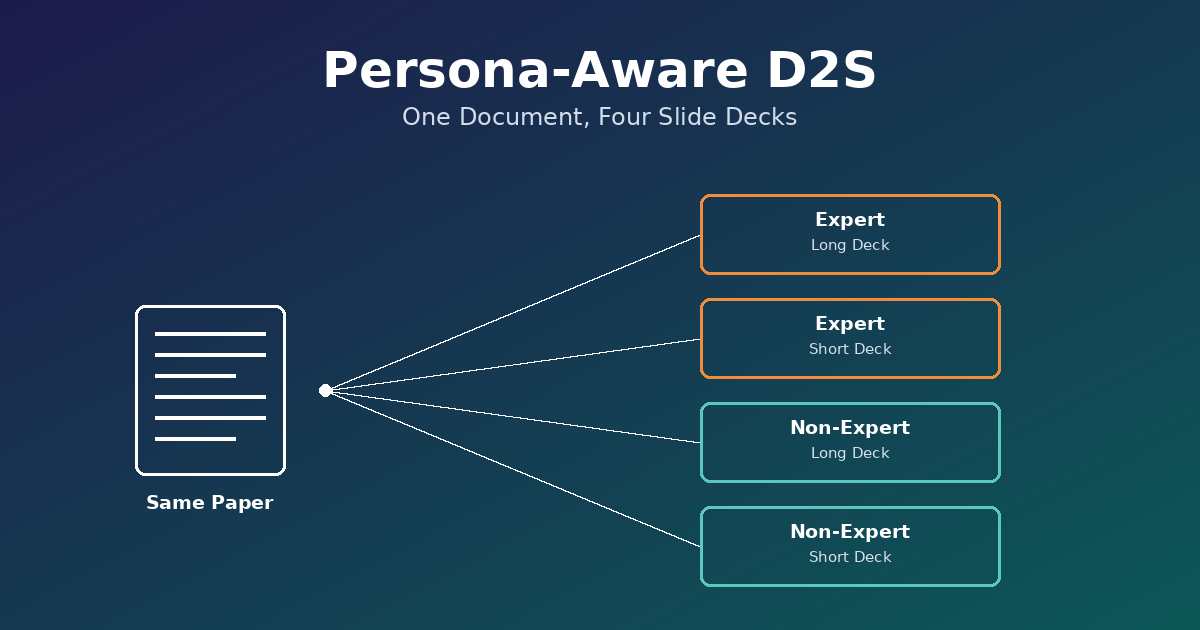
EACL 2024 的 Persona-Aware-D2S 想補上這個缺口。它把「受眾是不是專家」「簡報要長還是短」變成模型的輸入條件,讓同一份文件長出四種版本的投影片內容;訓練上用 SFT 搭配一種借自 Decision Transformer 的輕量偏好微調,繞開 PPO(RLHF 主流的強化學習演算法)那套基礎設施。這篇文章會照三階段 pipeline 把方法拆開,補上兩個你大概會卡住的技術背景(Decision Transformer 與 Bradley-Terry model),然後誠實評估它在工程上值不值得複現。先把結論放前面:這篇論文的貢獻主要在任務定義與資料集,方法本身是現成技術的拼裝,而且有幾個架構層級的問題會直接擋住落地。
- 任務定義:Persona-Aware-D2S(EACL 2024)把「同一份文件,依受眾(專家/非專家)和長度(長版/短版)生成四種投影片內容」這件事變成一個定義清楚的任務,並建立了對應的平行資料集。
- 方法:三階段 pipeline(大綱生成 → 內容抽取 → 摘要與重排),前兩階段用監督微調加上借自 Decision Transformer 的輕量偏好微調(reward-conditioning),但實作上是為四種 persona 組合各訓練一個獨立模型,而不是訓練單一條件式模型。
- 最划算的部分:Stage 2 第一步的兩段式檢索(字面比對優先、語意比對備援),以及 Stage 3 完全不需訓練的「摘要加重排」,論文自己的消融實驗證實後者確實提升了可讀性與連貫性。
- 站不住腳的地方:訓練資料規模很小(大綱生成只有 80 筆樣本、dev split 僅 5 篇論文)、reward model 只有 66M 參數且沒做容量消融、四種 persona 各訓一個模型的架構無法隨 persona 維度擴展。
2 這個任務為什麼值得被重新定義
論文開頭的例子很直覺:在面對一般大眾或業務人士的場合,技術密度過高的內容反而會降低參與度,因為這群聽眾想知道的是「這東西拿來幹嘛」,不是模型裡有幾個模組。這正是整篇論文的核心動機:同一份輸入,兩種輸出,差別不在品質好壞,而在對誰說話。
把論文在 §1 和相關研究裡談的問題攤開來看,其實是五個彼此有依賴關係的挑戰:
| # | 挑戰 | 過去方法怎麼做 | 為什麼不夠 |
|---|---|---|---|
| 1 | 單一輸出,無法因應不同受眾 | Doc2PPT(Fu et al., 2021)、D2S(Sun et al., 2021) | 架構上就是「文件 → 單一投影片」的固定映射,根本沒有「受眾」這個輸入變數,想擴充也無從下手 |
| 2 | 無法因應時長限制 | 同上 | 一小時報告跟五分鐘概覽需要的張數與資訊密度完全不同,但 duration 同樣沒被當作條件 |
| 3 | 訓練目標跟人類的多元偏好不對齊 | 最大化與單一 gold reference 的相似度(ROUGE,比對生成結果與參考答案的字詞重疊程度) | 這種最大概似(MLE)訓練預設「只有一種正確答案」,跟 persona 問題本質上的「一對多」直接衝突 |
| 4 | 抽取式方法內容不連貫 | 啟發式規則(Masum et al., 2005 等)、ML-based extractive(Hu & Wan, 2013 等) | 規則法靠手工特徵、泛化性差;抽取法只能從原文撈句子,沒有摘要與改寫能力,讀起來生硬 |
| 5 | 缺乏可訓練與評測的資料集 | — | 過去的研究多半只處理「技術研討會簡報」這一種型態,沒有同篇論文對多種 persona 的平行資料 |
這五點不是平行並列的。挑戰 5 是前提:沒有資料就談不上條件式生成;有了資料才能把挑戰 1、2 的條件變成模型輸入;而一旦要訓練這種條件式模型,就必須面對挑戰 3(單一 reference 撐不起多元偏好)。挑戰 4 則是獨立的內容品質問題,跟 persona 無關但同樣得解。
3 方法拆解:從問題形式化到三階段 pipeline
3.1 先把符號講清楚
論文的形式化其實不難,但符號散在各節,這裡先集中整理:
| 符號 | 意義 |
|---|---|
| 整份文件(論文) | |
| 的章節集合 | |
| 文件中所有圖表構成的集合 | |
| 第 個圖表,含圖片 與 caption | |
| 論文正文內容 | |
| / | 論文標題 / 摘要 |
| 受眾背景:專家 / 非專家 | |
| 簡報長度:長 / 短 | |
| 模型輸入的三元組 | |
| 投影片標題序列,也就是大綱 | |
| 從文件篩出的候選內容片段(句子加 caption) | |
| 最終的投影片輸出 |
這裡有個容易被忽略的設計: 雖然寫成「圖片 + caption」,但模型實際上只吃 caption 這段文字,圖片本身從頭到尾沒有被理解過。後面談限制時會回來算這筆帳。
整體目標是建模 。這個聯合機率沒辦法直接訓練,pipeline 實際上把它拆成三段(這個分解是我對照三個 Stage 推出來的讀法,論文沒有明寫成一條式子):
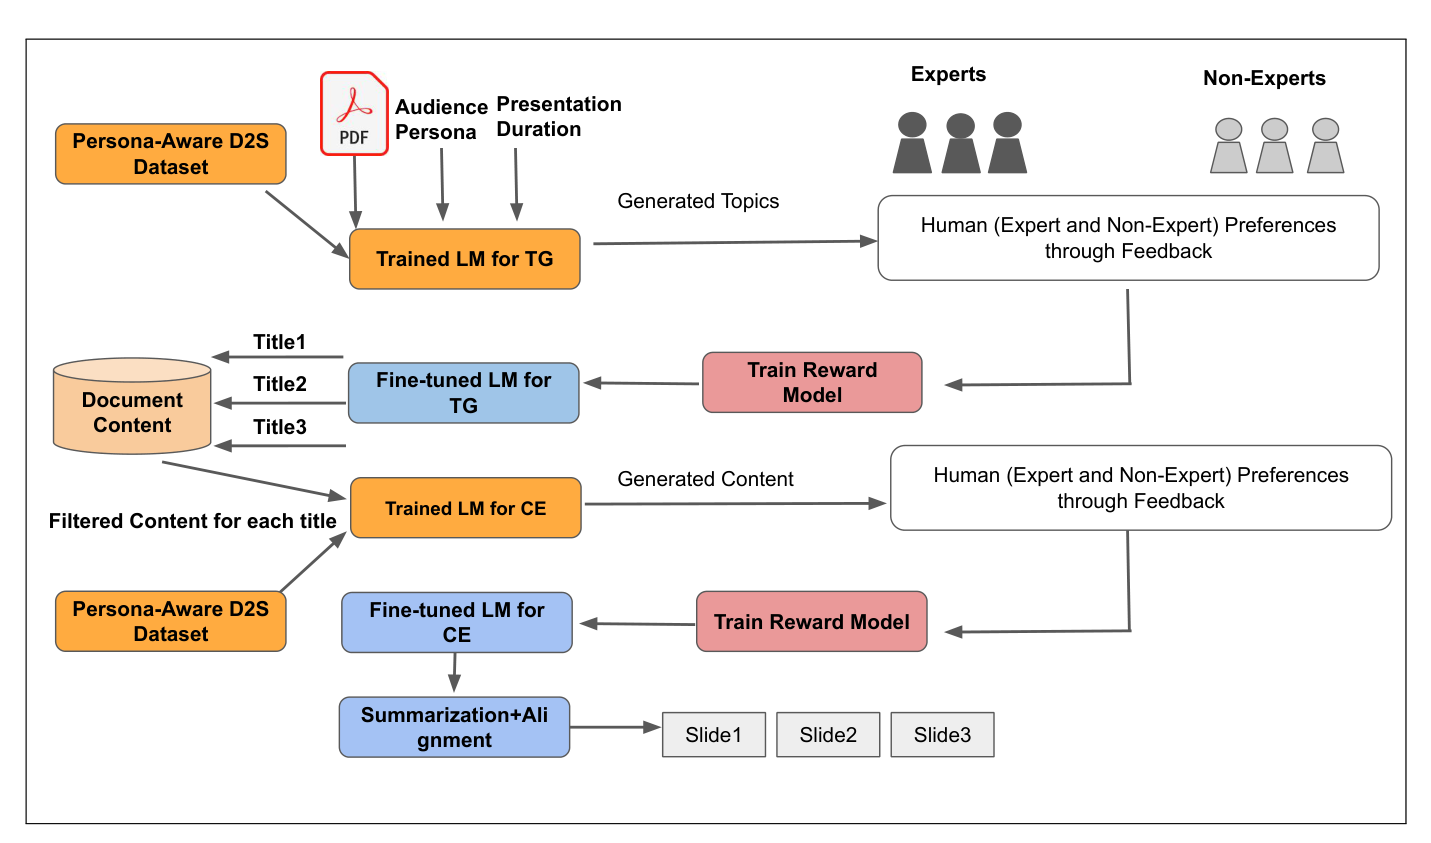
這張圖可以當成整節的地圖:接下來三個小節分別對應圖上的三段。
3.2 Stage 1:生成帶 persona 的投影片大綱
這一階段的目標是給定論文內容加上 persona 條件,生成投影片的標題序列 。它分成兩步走:先做監督微調,再做偏好微調。
3.2.1 監督微調(SFT-F)
做法本身很標準:用 cross-entropy loss,最小化生成標題與 ground-truth 標題之間的差距。真正值得注意的是架構決策——論文訓練的是四個獨立模型,分別對應四種 persona 組合:
而不是訓練單一模型、把 和 當成 prompt 裡的條件。這個選擇在效果上也許更乾淨,但代價很大,後面談 scalability 時會是主要的攻擊點。
訓練規模則相當袖珍:train split 只有 20 篇論文,乘上 4 種配置等於 80 筆訓練樣本,拿去微調 GPT-3.5-turbo(3 epochs、lr=0.2、batch size 256)。
3.2.2 偏好微調(P-F)
這一步是為了處理前面的挑戰 3:單一 gold standard 撐不起多元偏好。流程有三段。
第一段是收集人類偏好資料。 四個 各自用不同的 temperature、top-K、top-p 生成 5 組候選大綱;3 位專家負責對專家的兩種配置(長 vs 短)做成對排序,3 位非專家對非專家的兩種配置做同樣的事。評分準則有兩個:對目標受眾的可理解度(comprehensibility),以及長度上的滿意度。只有多數決有共識的樣本會被保留,沒共識的直接丟掉。
第二段是訓練 reward model,用的是 Bradley-Terry loss:
其中 是被選中(chosen)版本的分數, 是被淘汰(rejected)版本的分數。因為評分準則有兩個、受眾有兩種,最後會得到四個 reward model:、(專家的可理解度與長度)以及 、(非專家的對應版本)。
第三段是最終的偏好微調,借用 Decision Transformer 的 reward-conditioning 技巧(下一節會完整解釋這個技巧在原本的脈絡裡是什麼)。步驟是:從 train set 抽 prompt,用 生成 5 組大綱,用 reward model 給每組打分,得到「(prompt, reward) → 大綱」這樣的訓練配對,再拿這批配對去微調 LLM。本質上仍然是監督學習,只是輸入裡多塞了一個 reward 當條件。推論時就直接把「最大 reward 值」餵進去,讓模型生成對應高分的大綱。
論文在這一步略過了兩個細節:所謂的「maximum reward」具體數值怎麼來(是訓練資料裡的觀察最大值?還是手動設的常數?),以及兩個 reward 分數是合併成單一純量、還是兩個都塞進 prompt。缺了這些要複現會很痛苦。
3.3 Stage 2:抽出每張投影片該放的內容
有了大綱之後,要為每個標題找出對應的句子和圖表 caption,也就是 。這階段分成兩步:先用便宜的方式把候選範圍縮小,再用訓練過的模型從候選裡挑內容。
3.3.1 第一步:高 recall 的章節過濾器(不動用 LLM)
為什麼需要這一步?把整篇論文直接丟給 LLM 挑句子,一來成本高,二來塞不進 GPT-3.5-turbo 的 4096 token 限制。所以論文先用便宜的方式縮小範圍:
- 每個投影片標題 跟論文的 section headings 做 fuzzy match(字面相似度),取相似度超過門檻 的 top-k。
- 如果沒有任何 section 過得了門檻,改用 Sentence-BERT(Reimers & Gurevych, 2019)算語意相似度,挑最接近的 section。
- 選定 section 之後,把該 section 的所有句子與 caption 全部串接成 。
說白了就是「先用便宜的字面匹配,字面匹配失敗才動用語意模型」的兩段式檢索——很經典的 retrieve-then-rerank 思路,也是整篇論文裡我認為最值得直接借鑑的設計。
3.3.2 第二步:帶 persona 的內容抽取
這一步完全重用 Stage 1 的機制——同樣的 cross-entropy SFT、同樣的 Bradley-Terry reward model、同樣的 Decision-Transformer-style 偏好微調,只是輸入輸出換成「 → 相關片段」,訓練出來的就是一個專門做內容抽取的 policy。
3.3.3 省下的 API 成本,代價是什麼
論文宣稱這套候選過濾能把 GPT 呼叫次數壓到約八分之一。這個宣稱有數據支撐,但也有代價:
表 1 — 候選過濾的成本與 recall 取捨(原文 Table 10):呼叫次數愈多,recall 愈高。
| 策略 | 平均 GPT 呼叫次數 | Recall |
|---|---|---|
| 論文提出的輕量 filter | 約 1 次 | 78.89% |
| 中等範圍候選 | 約 5.3 次 | 81.34% |
| 幾乎用整篇論文 | 約 8.2 次 | 100% |
關鍵在於這一步的篩選不可逆:被這一步濾掉的句子,後面的 Stage 再也看不到。所以那 21% 的相關內容不是「暫時沒被選上」,是永久消失。用八分之一的呼叫成本換掉五分之一的內容涵蓋度划不划算,得看你的應用能容忍多少遺漏。
3.4 Stage 3:摘要與邏輯重排
前兩階段抽出來的是零散的句子片段,直接貼上投影片會很難讀。Stage 3 負責把它整理成連貫的最終輸出,機制是兩步驟 prompting:先把 的內容摘要成 bullet points,再把這些 bullet points 丟回 LLM,要求它在同一標題內部、或跨標題之間重新排列,讓順序更符合聽眾的理解節奏。具體來說,就是把「實驗結果」那張投影片裡先丟數字、後補實驗設定的順序倒過來,或把定義類的 bullet 提到應用類的前面。
Stage 3 的資源分配明顯斷了一層:Stage 1 和 Stage 2 都投入大量心力做 SFT 加偏好微調,但對使用者體驗影響最直接的 Stage 3,完全沒有做任何客製化訓練,純靠 prompting。論文沒有解釋這個資源分配上的不對稱是刻意還是偶然。
先看輸出實際長什麼樣:
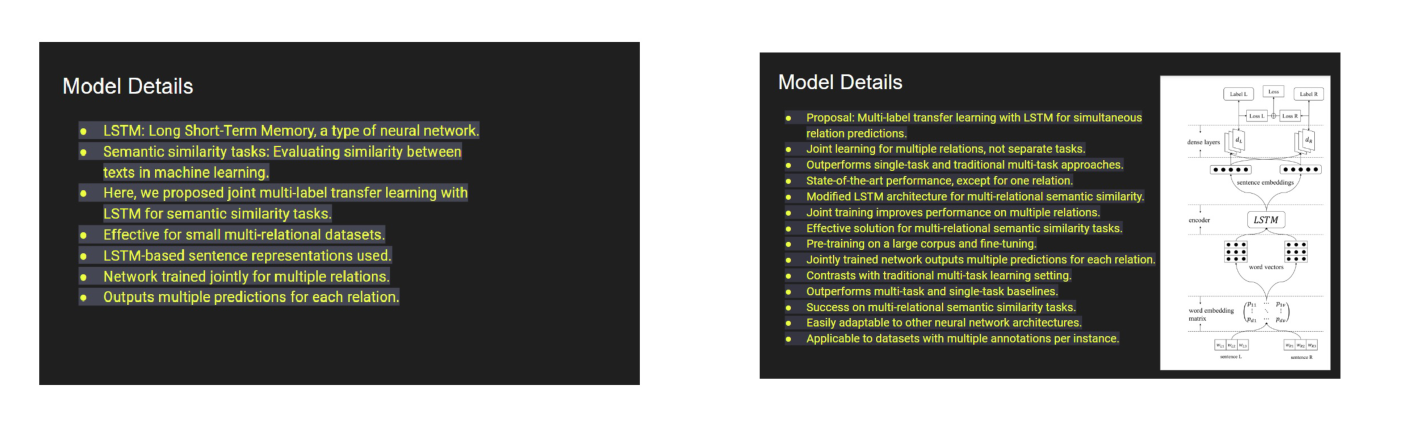
這張圖是檢驗整條 pipeline 最直接的方式——不用看任何分數,直接比對左右兩邊的用詞密度和細節深度,就知道條件有沒有真的生效。
至於 Stage 3 本身有沒有用,論文做了 before/after 的消融實驗(10 篇論文,Stage 2 的抽取版 vs Stage 3 的摘要重排版):
| 指標 | 變化 |
|---|---|
| Coherence | +0.5 |
| Readability | +1.0 |
| Coverage | -0.05(幾乎不變) |
| Relevance | 0(不變) |
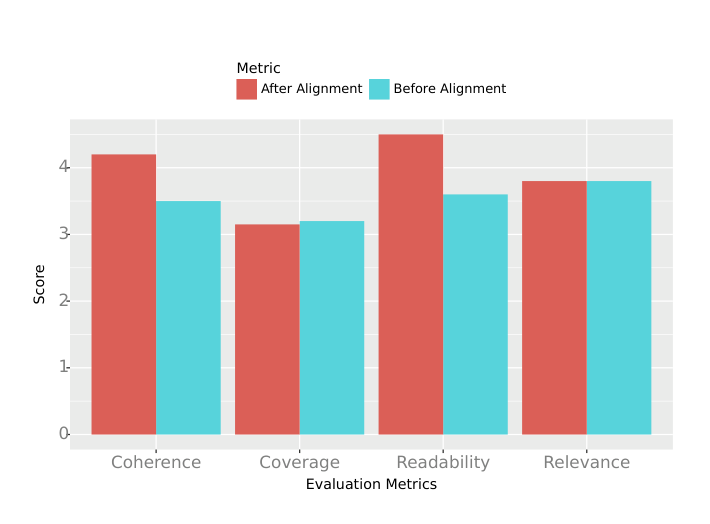
這是全篇論文裡證據力相對紮實的一個實驗:直接的 before/after 對照,證實摘要加重排確實提升了可讀性與連貫性,而且沒有明顯犧牲內容涵蓋度。不過樣本數只有 10 篇,評分者也不是獨立第三方。
幻覺怎麼處理? 論文沒有做自動化事實查核,而是讓標註者對「內容相關性」評分,用這個分數間接代表有沒有幻覺。
附錄 D–G 提供了 zero-shot / few-shot 版本的大綱生成與內容抽取完整 prompt,但沒有提供 Stage 3 用的 prompt template。四個模組裡,這是唯一無法從附錄還原的一步——偏偏它還是最容易直接搬來用的那一步。
4 背景知識:兩個你可能會卡住的技術
這節補兩個 Persona-Aware-D2S 借用、但論文本身只是一筆帶過的技術背景。它們的價值獨立於這篇論文之外——就算你對投影片生成沒興趣,這兩段知識在其他地方一樣用得上。
4.1 Decision Transformer:把強化學習包裝成序列預測
Decision Transformer(Chen et al., 2021)2021 年 6 月掛上 arXiv,同年在 NeurIPS 發表。時間點卡在 GPT-3 之後、ChatGPT 之前,屬於「Transformer 能不能用來解序列決策問題」那波研究風潮的代表作。
它想解決的是傳統 RL 的老毛病:Q-learning、policy gradient 這類方法訓練不穩定、需要精細調參、而且常常得跟環境 online 互動。Decision Transformer 的提案是一個典範轉移——把 RL 問題重新包裝成序列預測問題,用 GPT 式的監督學習訓練,完全不估計價值函數、不做 bootstrapping。
具體怎麼運作,用走迷宮來想最容易:
- 一條軌跡(trajectory)由一連串的 (state, action, reward) 組成。
- 訓練前先把 reward 轉成 return-to-go:從現在這一步到終點,總共還會拿到多少分。
- 模型的輸入是交錯排列的三元組序列:
[return-to-go, state, action, return-to-go, state, action, ...]。 - 訓練時蓋住 action,讓模型根據前面的 (return-to-go, state) 預測該輸出什麼 action。學到的映射大致是「我還想拿到 10 分,而我現在在位置 A → 往右走」。
- 推論時使用者先許願:設定一個目標 return(例如「我想拿 10 分」),模型根據這個目標加上目前 state 吐出動作;每走一步,剩餘的 return-to-go 就按實際拿到的分數遞減,重複到走完。
一句話總結:訓練時是「觀察別人怎麼走、最後拿多少分,學會兩者的關聯」;使用時是「你先設定想要的分數,模型回推該怎麼走」。
它後來有變成主流嗎? 在研究圈內確實有影響力:同期有 Trajectory Transformer(Janner et al., 2021)提出類似想法,後續有 Online Decision Transformer,也被延伸到推薦系統、機器人、embodied AI、網頁導航 agent 等領域。但它沒有成為 LLM alignment 的主流路線——今天的 RLHF 生態主流仍然是 PPO(InstructGPT 那條線)或後來的 DPO。Decision Transformer 比較像是在 offline RL 與機器人控制這個子領域持續發揮影響力,不是一個家喻戶曉的產品級技術。
回到這篇論文:它只借用了「reward-conditioned generation」這個訓練技巧——把 reward 當條件塞進輸入,用監督學習訓練,藉此繞開 PPO 的基礎設施複雜度。但這是個不完整的挪用。Decision Transformer 真正的威力在於處理多步驟、有前後因果關係的序列決策:這一步怎麼選,會影響下一步能拿到多少分。而 Persona-Aware-D2S 的場景是單次生成,prompt 丟進去、完整大綱吐出來,沒有多步驟決策結構,也沒有軌跡的概念。
| Decision Transformer 概念 | Persona-Aware-D2S 的對應 |
|---|---|
| return-to-go(還想拿多少分) | reward model 打出的分數 |
| state(目前在哪) | prompt(論文內容加上 persona 條件) |
| action(要往哪走) | 要生成的大綱 |
| 一整條軌跡 | 不存在,只有單步生成 |
表格最後一列才是重點:借了表層技巧,但沒有用到它真正被設計來解決的核心問題。
4.2 Bradley-Terry Model:從球隊排名到 RLHF 的共同底層
Bradley-Terry model(Bradley & Terry, 1952)是個很老的統計模型,原本處理的問題是「兩兩比較之後怎麼推算整體排名」,例如球隊戰績排序,跟 AI 一點關係都沒有。
它的核心假設是:每個項目都有一個看不見的「實力值」,而比較結果只是這個實力值的機率反映,不是絕對保證。寫成式子就是:
舉個具體的例子:A 隊實力值 8、B 隊實力值 2,則 。A 實力強四倍,贏面八成,但 B 仍有兩成機率爆冷。這種容許不確定性的設計,正好適合套在「人類偏好」這種有雜訊、同一個人不同時候判斷也未必一致的場景。
把 重新參數化成指數形式(令 ),就會得到 reward model 訓練裡常見的 形式——也就是前面 Stage 1 那條 loss。這是 RLHF 領域最廣泛採用的偏好模型,從 Christiano et al. (2017) 這篇 RLHF 開山文獻、OpenAI 的 InstructGPT,一路到後來的 DPO,底層數學都是同一套 Bradley-Terry loss,差別只在怎麼用。換句話說,Persona-Aware-D2S 的 reward modeling 完全不是原創,是直接套用業界標準做法。
實際訓練起來會長這樣:reward model 對 chosen 版本打 3.5 分、rejected 打 1.0 分,則 ,,loss 是 ——很小,代表模型判斷準確。反過來如果打分方向弄反(chosen 反而拿低分),loss 會飆到 2.53 左右,梯度就會用力把它修回來。
為什麼要用成對比較而不是直接打分? 因為直接打分(像是「請給 1 到 10 分」)在標註者之間的一致性很低,每個人心裡的 7 分不一樣;但「A 跟 B 哪個比較好」人類直覺上容易判斷,共識度高得多。這也是為什麼論文的標註流程設計成 pairwise ranking。
5 效果如何:端到端評測
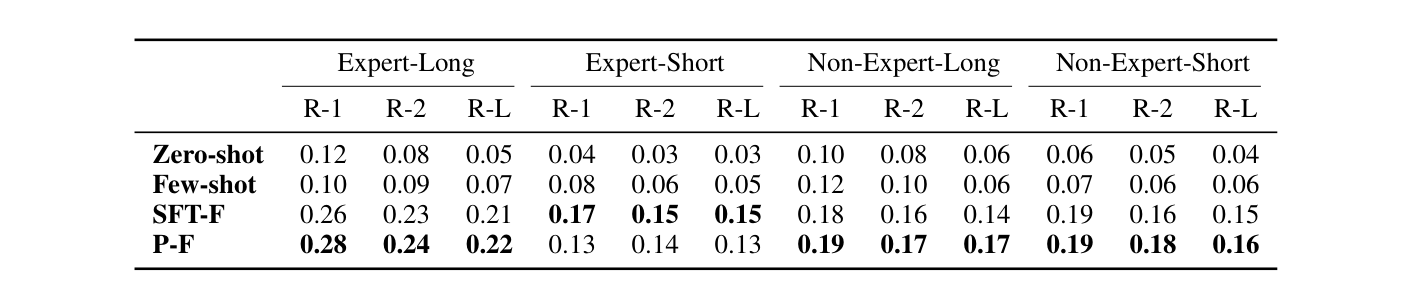
這張表是「微調確實有效」這個結論的主要量化依據,也是評估工程 ROI 時最該看的數字來源(提醒一下前面的縮寫:SFT-F 是純監督微調,P-F 是再加上偏好微調的版本)。兩個觀察:
- SFT-F 與 P-F 全面壓過 zero-shot 和 few-shot baseline,差距不小。這部分的結論算是站得住。
- P-F 在多數配置勝出,但 Expert-Short 這個配置例外,反而是純監督微調更好(R-1:SFT-F 0.17 vs P-F 0.13)。論文的解讀是純監督微調在「為專家做精簡摘要」這件事上表現更好。不管解讀對不對,這至少說明偏好微調不是無條件的提升。
6 批判性評估
6.1 論文自己承認的限制
論文的 Limitations 章節列了五點,都挺實在:
- 方法受限於必須忠於文件內容。
- 大部分技術術語需要額外解釋才能讓非專家理解,但模型在這方面能力有限。
- 完全依賴人類撰寫的圖表 caption,不會生成原創圖表,也不理解圖片本身的內容。
- 只能產生 bullet-point 格式的文字摘要,不涉及任何排版設計。
- 沒有多模態表徵能力,圖片相關的資訊可能在過程中流失。
第 3 點和第 4 點加起來,其實就決定了這個系統的輸出離「可以直接開場報告的投影片」還有很長一段距離。
6.2 論文沒提、但我認為存在的問題
| 面向 | 問題 |
|---|---|
| 訓練資料規模 | 大綱生成只有 80 筆訓練樣本(20 篇 × 4 配置),dev split 只有 5 篇。小樣本微調很容易 overfit 到這批論文的寫作風格,換 domain 的泛化能力存疑 |
| 架構 scalability | 四種 persona 配置要訓練 4 個獨立 SFT 模型加 4 組 reward model。如果要再加一個 persona 維度(例如角色:PM/工程師/主管),模型數量是乘法成長,完全不 scalable |
| 檢索機制的隱藏成本 | 章節過濾不可逆,21% 的相關內容會被永久漏掉;門檻值只在 5 篇論文上調過;而且高度依賴標準化的 section 結構,非結構化文件直接失效 |
| Reward model capacity | 用 66M 參數的 distilbert-base-cased 去判斷「可理解度」這種語意複雜的任務,夠不夠用完全沒有驗證 |
| 偏好微調的細節缺失 | 「maximum reward」數值怎麼決定、reward 是純量還是多維,論文都沒交代,難以複現 |
| Stage 3 資源分配不對稱 | 對最終體驗影響最大的摘要重排,反而是唯一沒做客製化訓練的環節,論文沒解釋原因,附錄也沒給該步驟的 prompt |
| 幻覺評測方法薄弱 | 用相關性評分 proxy 幻覺,測不出「內容相關但細節捏造」這一類 |
| 實驗樣本數普遍偏小 | 質化分析 10 篇、認知負荷研究 3 位專家、消融實驗 10 篇,統計效力偏低 |
| 產出物離真正的投影片有落差 | 完全不含排版、顏色、字體,本質上輸出的是結構化文字大綱,不是能直接用的簡報 |
實驗樣本數那一列要公平地說清楚:這是「規模不足」而不是「沒有做」。論文的實驗涵蓋面其實相當完整,模組級評測、端到端評測、消融實驗、質化分析都有,只是每一項的樣本數都撐不起太強的統計結論。
7 工程落地:哪些該抄,哪些別碰
看完方法和限制,最實際的問題是:如果我明天要做一個類似的系統,這篇論文哪幾塊可以直接拿?
| 模組 | 落地可行性 | 判斷 |
|---|---|---|
| Stage 1 與 Stage 2 第二步(SFT + P-F 的四模型架構) | 低 | 訓練與維運成本隨 persona 維度乘法成長,不建議直接複現 |
| Stage 2 第一步(章節過濾:fuzzy match + SBERT fallback) | 高 | 成熟、可遷移、確實解決真實痛點(省 API 成本),跟通用 RAG 的 retrieve-then-rerank 思路一致 |
| Stage 3(摘要 + 重排,不需訓練) | 最高 | 成本最低(只多兩次 LLM 呼叫),消融實驗證實有明確效果提升,是全篇投入產出比最好的部分 |
| Decision-Transformer-style 訓練技巧 | 中(視情境) | 如果你需要做輕量版偏好對齊又想避開 PPO 的基礎設施複雜度,這個思路值得參考,但要清楚意識到它捨棄了原技術真正的多步驟決策優勢 |
具體的取捨建議:
- 可以直接借鑑:Stage 2 第一步的兩段式檢索,以及 Stage 3 的摘要重排。兩者都不需要訓練,遷移成本接近零。
- 不建議複現:Stage 1 與 Stage 2 第二步的「每種條件訓練一個獨立模型」架構。小樣本 SFT 本身風險也偏高,除非你的任務也是「教模型輸出格式或風格」而不是「教模型新知識」——前者小樣本有機會,後者基本無望。
- 整體來說,這篇論文更適合當作「問題定義」的參考,而不是「解決方案」的參考。它的價值在於把 persona-aware 生成這個任務該長什麼樣描述清楚了,而不是提供一套能直接落地的系統。
8 結論
Persona-Aware-D2S 的核心貢獻是定義了一個新任務、建立了一個新資料集:讓文件轉投影片這件事第一次把「受眾是誰」「要講多久」當成模型的輸入條件。這個問題定義本身很有價值,論文能上 EACL 2024 long paper 也主要吃在這裡。
但方法論本身沒有原創性——SFT 加上 RLHF-lite 的組合,是把 Christiano et al. (2017) 的 reward modeling 和 Chen et al. (2021) 的 reward-conditioning 拼裝起來,而且後者還只借了表層技巧。工程上更不建議整套複現:80 筆訓練樣本撐不起真實世界的 domain 多樣性,四倍模型數量的架構不 scalable,產出物也離可直接使用的簡報有明顯落差。
真正值得帶走的只有兩樣:Stage 2 第一步那套 fuzzy match 加 SBERT fallback 的兩段式檢索,以及「把 reward 當條件塞進監督學習」這個繞開 PPO 的訓練思路。前者可以明天就用,後者則要先想清楚你的任務有沒有真正的多步驟結構——沒有的話,你借到的也只是個殼。