把流程畫成圖,AI Agent 就不會迷路?Procedural Graphs 解析
 Hong-Wei Wu
收錄於 論文介紹
1 agent 做長任務,為什麼會迷路?
請 AI agent 幫你處理一個要走很多步的任務。前半段它做得好好的,到了後半段,卻又去查一遍前面已經查過的資料,或是把兩個工具的呼叫順序弄反。如果事先把「接下來該做什麼」畫成一張流程圖,每一步只挑出腳邊那一小段,轉成一句提醒交給它,它還會迷路嗎?Google 的這篇論文就是這樣做的,答案是:多半有幫助,但有代價,也有幾個地方沒幫上忙。
這篇整理 Google 的論文 Procedural Graphs: Self-Evolving Execution Structures for LLM Agents(arXiv 2609.09153v1,2026 年九月)。它的做法分兩半:
- 推論時(agent 實際在做事):把 agent 的「做事流程」存成一張可編輯的有向圖(節點是步驟,箭頭指向下一步)。每一步只取 agent 目前所在位置附近的一小段,由另一個 LLM 翻成提示。
- 離線時(事先準備、改進這張圖):讓一個 LLM 負責修改這張圖;改得有沒有用,交給獨立的驗證集(一組沒拿去訓練的題目)決定。
同一個模型、同一個 solver(負責選動作的那個 LLM),拿來對比沒有記憶的 ReAct(先想一步、呼叫一個工具、看結果、再想的 agent 迴圈,下一節細講):
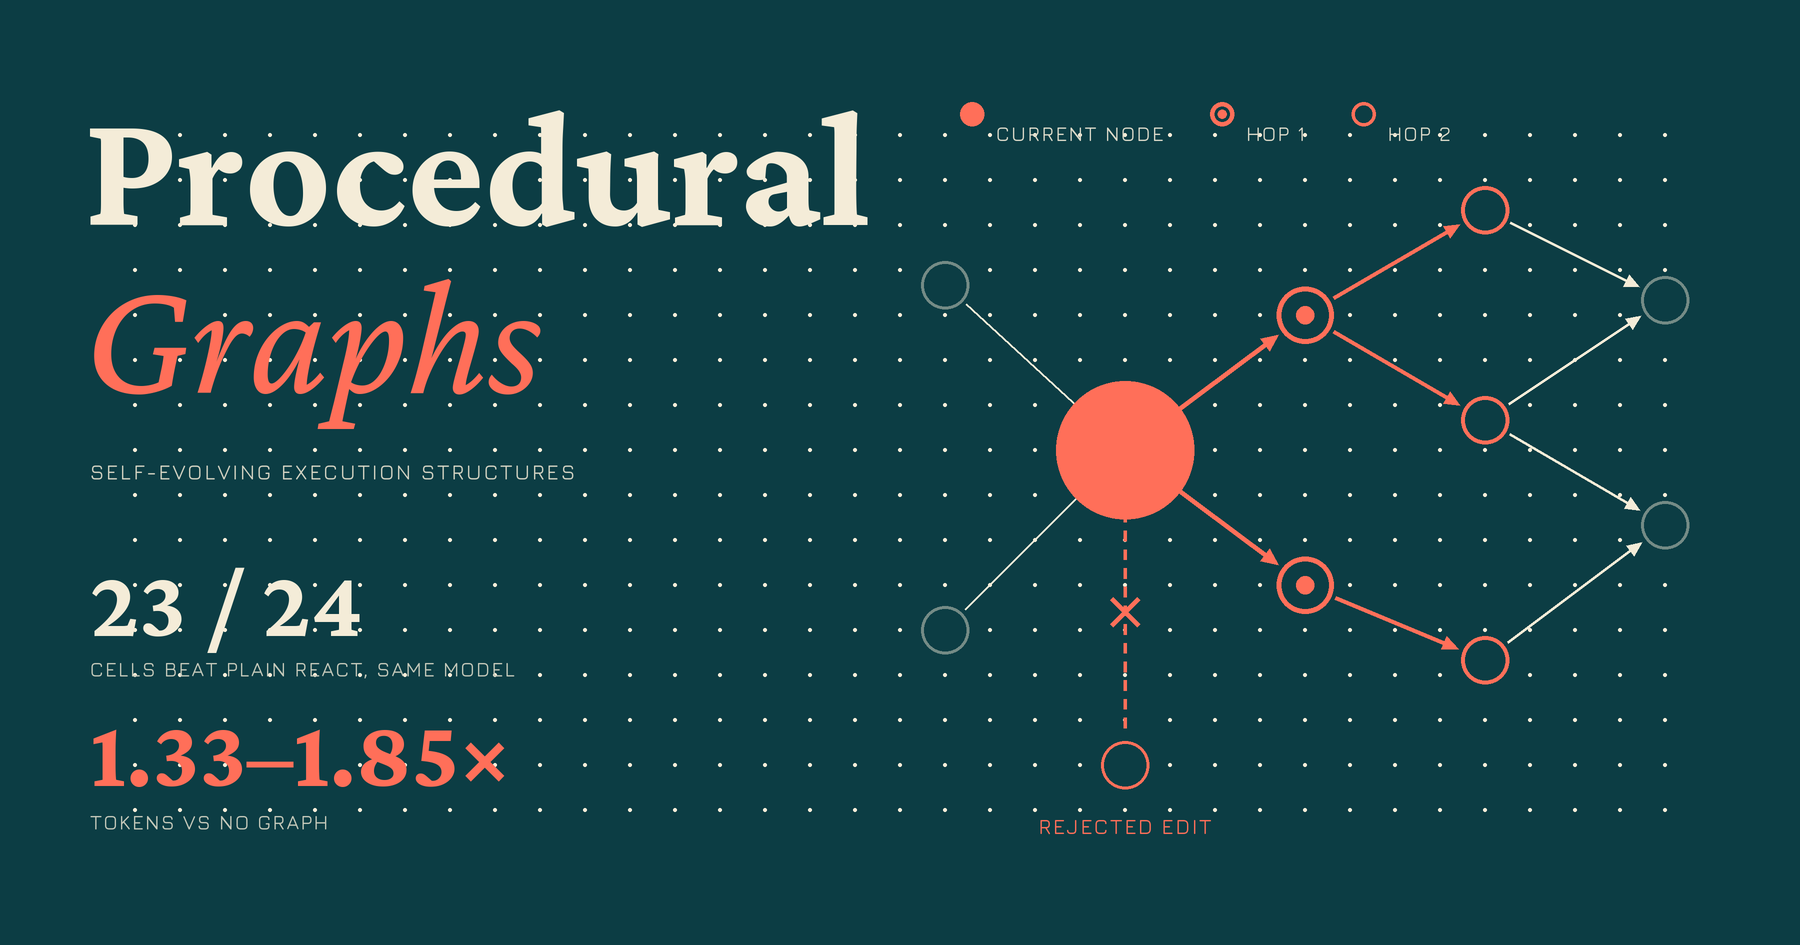
- 多數有進步:24 個「模型 × benchmark(標準測試任務)」格子中,有 23 格為正;但 HotpotQA(需要跨多篇資料推理的問答)幾乎沒有增益(最大 +1.7)。
- 有代價:每一步多一次 LLM 呼叫,token(模型處理文字的計量單位)大約是不用圖的 1.33 到 1.85 倍。
- 手寫的專家圖(人工設計的流程圖)不一定可靠:在 MultiChallenge(多輪對話中,要記得並遵守先前指令的測試)上,它比不用圖少答對 16 題(共 56 題),演化之後才回到比不用圖多 3 題。
我自己覺得最值得帶走的不是圖,而是它的改進迴圈:提案、用獨立驗證集把關、把被拒的記錄回灌給提案者。這個迴圈可以套在任何可編輯的文字資產上,文章後半會專門談。
路線是這樣:先看 ReAct 為什麼會迷路,再看論文的三段方法(圖長什麼樣、推論時怎麼用、離線時怎麼改),接著看三個實驗,最後回到值得帶走的東西。文末另有五個可以獨立閱讀的概念補充,主線提到時會指過去。
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
mindmap
  root((Procedural Graph))
    圖:步驟是節點,邊說明怎麼接
    推論時
      只取目前位置附近一小段
      另一個 LLM 翻成提示
    離線時
      LLM 提出修改
      驗證集把關
      被拒的回灌
    結果
      24 格中 23 格為正
      但有代價
2 ReAct 的痛點:每一步都在自己摸索
ReAct 是 agent 常見的迴圈:想一步、呼叫一個工具、看結果、再想。
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph LR
    t["想一步"]
    a["呼叫一個工具"]
    o["看結果"]
    t --> a
    a --> o
    o -->|再想| t
問題是每一步都得從一份越來越長的「動作+觀察」流水帳裡,自己推出下一步。長任務裡就容易忘記目標、亂序呼叫工具、重複無效的動作。
現有的補救辦法不少,各缺一塊:
- 文字記憶與反思(Reflexion、ExpeL):內容是自由文字,solver 還得自己判斷這段話如何限制後面的步驟。
- 條件式指引(AutoGuide):每條指引彼此獨立,沒有連在一起。
- 手寫工作流與狀態機:要靠人工設計。
- 自動搜尋工作流(AFlow):只在離線優化結構,推論時不隨進度調整。
論文想同時做到四件事:
- 結構夠強,能擋掉無效行為
- 保留推理的彈性
- 隨目前進度調整
- 能從經驗改進
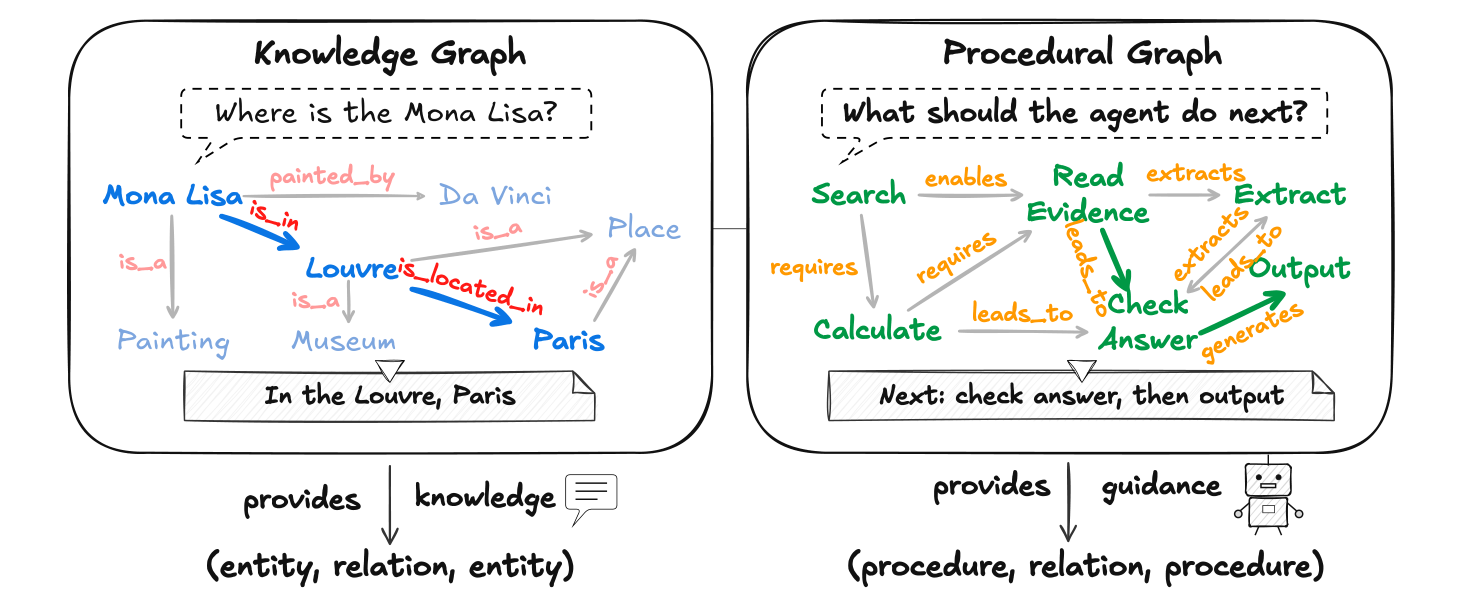
論文的出發點是一個類比,它靠的是三元組:「起點、關係、終點」三個一組的記法。知識圖譜裡可能是(巴黎、是首都、法國);換成流程,就變成(做完 A、可以接、B)。
核心類比看圖 1。知識圖譜把事實組織成三元組,回答「這是什麼」;Procedural Graph 把任務流程組織成三元組,回答「接下來做什麼」。
小結:ReAct 的問題是每一步都得自己從長長的流水帳裡推下一步。這篇的解法,是把「接下來該做什麼」事先存成一張圖。
3 核心想法:把做事流程存成一張圖
接下來三節是論文的方法:圖長什麼樣(這一節)、推論時怎麼用、離線時怎麼改。先看圖本身。
3.1 圖由什麼組成
Procedural Graph(以下簡稱 PG)是一張有向、帶屬性的圖:節點是步驟,邊(有方向的箭頭)是「這步之後可以接哪一步」,每條邊再附三段文字,說明怎麼接(論文 Section 3.1)。
這篇接下來會一直用論文裡的一個例子:EnterpriseArena,一個財務模擬環境,agent 扮演 CFO(財務長)管理公司現金,目標是撐滿 132 個月不破產。
這個任務的圖上有這樣一條邊(論文 Section 3.1 的例子):(cash_flow_forecast, LEADS_TO, fund_raising_request),意思是做完現金流預測之後,可以接提出募資申請。它附的三段文字叫 condition(什麼時候該走這條邊)、guidance(怎麼做)、pitfalls(要避開什麼),內容如下。
| 欄位 | 內容 |
|---|---|
| condition | 預估的資金跑道低於安全緩衝時 |
| guidance | 要提早送出申請,因為資金到位有延遲 |
| pitfalls | 已有一筆申請還在等待時,不要再疊一筆 |
這三句話,就是推論時要翻譯給 solver 的原料。
把剛才的例子一般化:一張 PG 由四樣東西組成,也就是節點、關係種類、邊,以及每條邊上的文字。邊是「起點、關係、終點」三個一組。
- :節點集合。每個節點代表一個工具函式、一個技能、一個內部推理步驟,或一個任務狀態。
- :關係種類的詞彙表。實際只有四種:
LEADS_TO、TRIGGERS、PROVIDES_INPUT_FOR、CONVERGES_TO(Appendix B.4)。這四種只是標籤,後面會看到推論時它們其實派不上用場。 - :邊的集合。每條邊是 ,意思是「在 之後,可以依關係 接 」。
- :把每條邊對應到一組文字欄位。論文用三個:condition(什麼時候該走這條邊)、guidance(怎麼做)、pitfalls(要避開什麼)。
3.2 實際用的圖很小
實際用的圖很小。除了 BFCL v3 因為要對應龐大的函式目錄,有 131 個節點、265 條邊,其餘每張圖都只有 7 到 17 個節點、7 到 27 條邊,數字見表 1。表 1 的七欄是六個 benchmark 加上 EnterpriseArena:它不在實驗一的六個 benchmark 主比較裡,主要用於自我演化的案例。
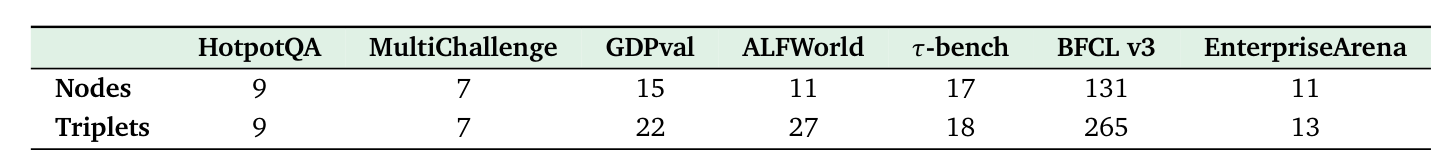
圖可以從專家手寫的版本起步,也可以從只有 Start → End 兩個節點的空圖起步,兩種起點的比較放在實驗三。
小結:PG 是一張小圖。節點是步驟,邊上寫著「什麼時候該走、怎麼做、要避開什麼」。接下來看 agent 做事時,怎麼用這張圖。
4 推論時:每一步只看腳邊兩跳
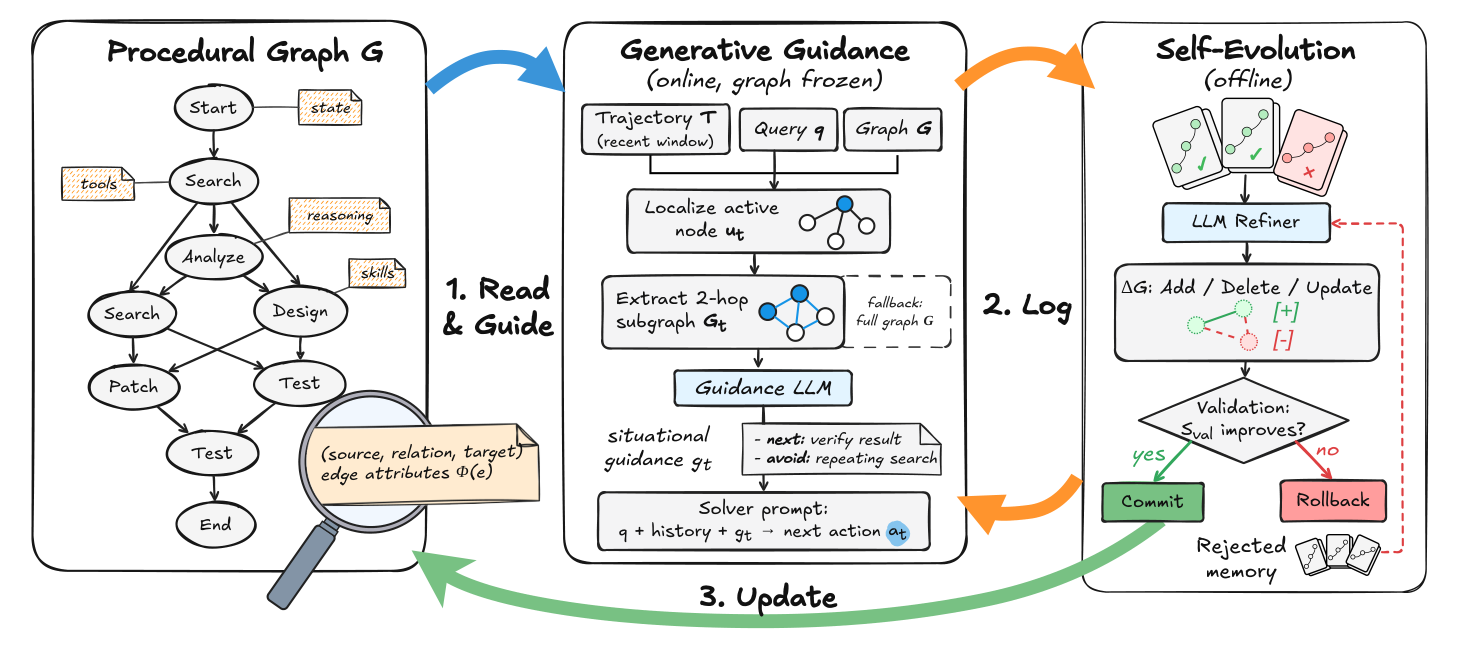
推論時的做法是:每一步決策前,先判斷 agent 剛做完圖上的哪個節點,只取那個節點往後 2 跳(沿著箭頭走兩步)的小圖,由另一個 LLM 轉成一小段「現在該做什麼、要避開什麼」的文字,附加到 solver 的 prompt。推論時圖是凍結的,不會更新(Section 3.2)。
取出來的那一小塊圖,叫子圖。先把兩個角色定義清楚:
- solver:實際選下一步動作的 LLM,也就是 ReAct 迴圈裡的 agent 本人。
- guidance model():另一個 LLM,負責把子圖翻成提示。論文說它和 solver 用同一個底層模型(Section 4)。
一步的完整流程如下(軌跡,就是到目前為止的動作與觀察記錄;括號裡是後面公式用的符號):
- 取得上一步的動作()。
- 把它比對到圖上的節點(),取 2 跳子圖()。
- guidance model()讀子圖、問題()、最近 3 步軌跡,寫出提示()。
- 提示填進 solver prompt 的
Procedural Graph Guidance:欄位。 - solver 輸出 Thought 與 Action。
- 環境執行動作並回傳觀察。
- 新的動作與觀察接進軌跡,進入下一步。
cash_flow_forecast)。系統在圖上找到這個節點,取出它往後兩跳的邊,其中一條寫著「預估的資金跑道低於安全緩衝時,要提早送出申請,因為資金到位有延遲」。guidance model 把這幾條邊寫成一段提醒,solver 讀了提醒,再決定下一個動作要不要提出募資申請。圖 2 是整個框架的總覽,重點看中間那一欄(線上推論);右邊那一欄是離線演化,下一節才講。
4.1 定位:agent 現在在圖上的哪裡
第一部分負責回答「agent 現在在圖上的哪裡」。
做法像先確認自己站在哪個路口:拿上一步的動作去圖上找對應的節點,找到了,就以它為中心往外取兩跳;找不到,退回整張圖。
- :目前是第幾個決策步。起點約定 ,所以第一步一定定位在 Start 節點。
- :agent 上一步的動作,例如一次工具呼叫。
- :把 和節點集合 比對,論文寫的是 exactly matching。
- :比對到的節點,也就是 agent 現在在圖上的位置;比對不到就是空集合。
- :從 出發,沿著往外的邊最多展開 步所得的子圖。實驗用 。
- :這一步交給 的圖。比對失敗時,退回整張圖 。
Appendix B.5 有一段 HotpotQA 的序列化(轉成文字)局部圖(節錄),可以拿來當例子。上一步動作是 first_hop_retrieve,定位到 First_Hop_Retrieve;第 1 跳是 First_Hop_Retrieve → Scan_Index,第 2 跳是 Scan_Index → Bridge_Extract。兩條邊連同各自的 condition、guidance、pitfalls 一起交給 。比對機制的細節放在文末的概念補充。
4.2 生成提示並選動作
第二部分是生成提示與選動作。
guidance model 看著子圖、問題和最近 3 步的軌跡,寫出一段提示;solver 再看著問題、完整軌跡和這段提示,選出下一個動作。
- :第 步的情境化提示,一段自然語言。
- :guidance model。
- :使用者的原始問題。
- :最近 步的軌跡,實驗用 。
- :到目前為止完整的軌跡,是動作與觀察交錯的序列。
- :solver 這一步要做的動作。實驗全部用 greedy decoding(每次取機率最高者),所以實際上是確定的。
的指令(Appendix B.5 的 Guidance Generation Prompt)要求它依邊上的 condition、guidance、pitfalls,說清楚下一步做什麼、要避開什麼、最近失敗後怎麼補救,並帶上圖裡寫到的具體指令格式、工具與參數。兩個 LLM 各自看到什麼、輸出什麼,整理在文末的概念補充。
4.3 四個要記得的性質
這套做法有四個容易忽略的性質,都是限制或成本:
- 只是偏向,不是強制。 論文摘要說提示會 bias solver 的下一步動作,但不會 dictate 它。論文沒有任何機制檢查 solver 的動作是不是真的走在圖上。
- 每一步多一次 LLM 呼叫( 本身),成本一定比不用圖高。 數字見實驗二。
- 比對失敗退回整張圖,代價很高。 實驗二顯示整張圖加生成式提示是最差的設定(主要是在 ALFWorld,也就是虛擬家庭任務上),但論文沒給比對失敗的頻率,所以不知道這條路徑實際被走到多少次。
- 四種關係種類在推論時不起作用。 Appendix B.5 說 serializer 不會把關係標籤印給 ,所以至少在這個序列化下, 只看到節點、箭頭方向和三段文字。
小結:推論時,每走一步,只有 guidance model 看到腳邊兩跳的子圖,並把它寫成一段提醒;solver 完全看不到圖,只讀這段提醒。圖在這個階段是凍結的;它怎麼變得更好,是下一節的事。
5 離線演化:讓 LLM 改圖,驗證集把關
線上那一半假設圖已經存在。圖怎麼來、怎麼變好,是離線這一半的事。
離線的部分是這樣:先讓 solver 在訓練題上跑一批,留下成功與失敗的軌跡;refiner(專門改圖的 LLM,與 solver 同一個底層模型)讀軌跡,輸出一份修改清單,套用到圖的副本得到候選圖;候選圖在獨立驗證集上不比目前的圖差才採用,被拒的記下來(這份記錄叫拒絕記憶),下一輪給 refiner 看(Section 3.3、Algorithm 1)。
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TB
    g["目前保留的圖"]
    r["在訓練題上跑 solver,留下軌跡與分數"]
    p["refiner 提出修改清單"]
    c["套用到圖的副本,得到候選圖"]
    s["結構檢查"]
    v["在驗證集上算分"]
    ok["採用候選圖"]
    no["退回舊圖,記進拒絕記憶"]
    g --> r
    r --> p
    p --> c
    c --> s
    s -->|通過| v
    s -->|沒過| no
    v -->|不比舊圖差| ok
    v -->|比舊圖差| no
    ok -->|下一輪| g
    no -->|下一輪| g
第 輪的流程:
- 用目前保留的圖 ,在一批訓練題上跑 solver,記錄軌跡與分數(0 到 1)。
- refiner 比對高分與低分的軌跡:在失敗軌跡找反覆出現的錯誤迴圈,在成功軌跡找可借用的捷徑。
- refiner 輸出修改清單 。
- 把修改套用到圖的副本,得到候選圖。
- 做結構檢查,沒過就丟,不跑驗證。
- 在驗證集上算分,與舊圖比較。
- 不比舊圖差就採用;否則退回舊圖,並把這次的候選記進拒絕記憶。
5.1 refiner 怎麼提出修改
refiner 不是重畫一張新圖,而是開一張修改清單,套用到圖的副本上,得到候選圖。
- :上一輪保留下來的圖。被拒絕的候選不會成為下一輪的起點。
- :refiner 提出的修改清單。
- :把修改套用到圖的副本;若設定要求,還會自動修掉環。
- :候選圖。
修改只有兩種:Add(補節點或邊,例如補一個驗證步驟)與 Delete(刪掉老是把軌跡帶進失敗的節點或邊)。要改邊的屬性,就是刪掉再用新屬性加回去。
add_nodes、delete_nodes、add_edges、delete_edges(Appendix B.5 的 Refiner Prompt)。套用時先刪後加。這裡有個眉角:delete_edges 會刪掉該起點到終點之間的所有邊,不分關係種類,想留其中幾條,得在 add_edges 重加。Appendix E.3 有一個實例,用的是前面那個 EnterpriseArena 的 CFO 任務。Round 1 從只有 Start → End 的空圖,一次長出整條主線;Round 7 刪掉 pass_action(什麼都不做)節點及其邊;Round 8 把 fund_raising_request → book_closing 換成直接連到 End。拓樸(節點與邊的連接方式)怎麼一步步改,看圖 3。
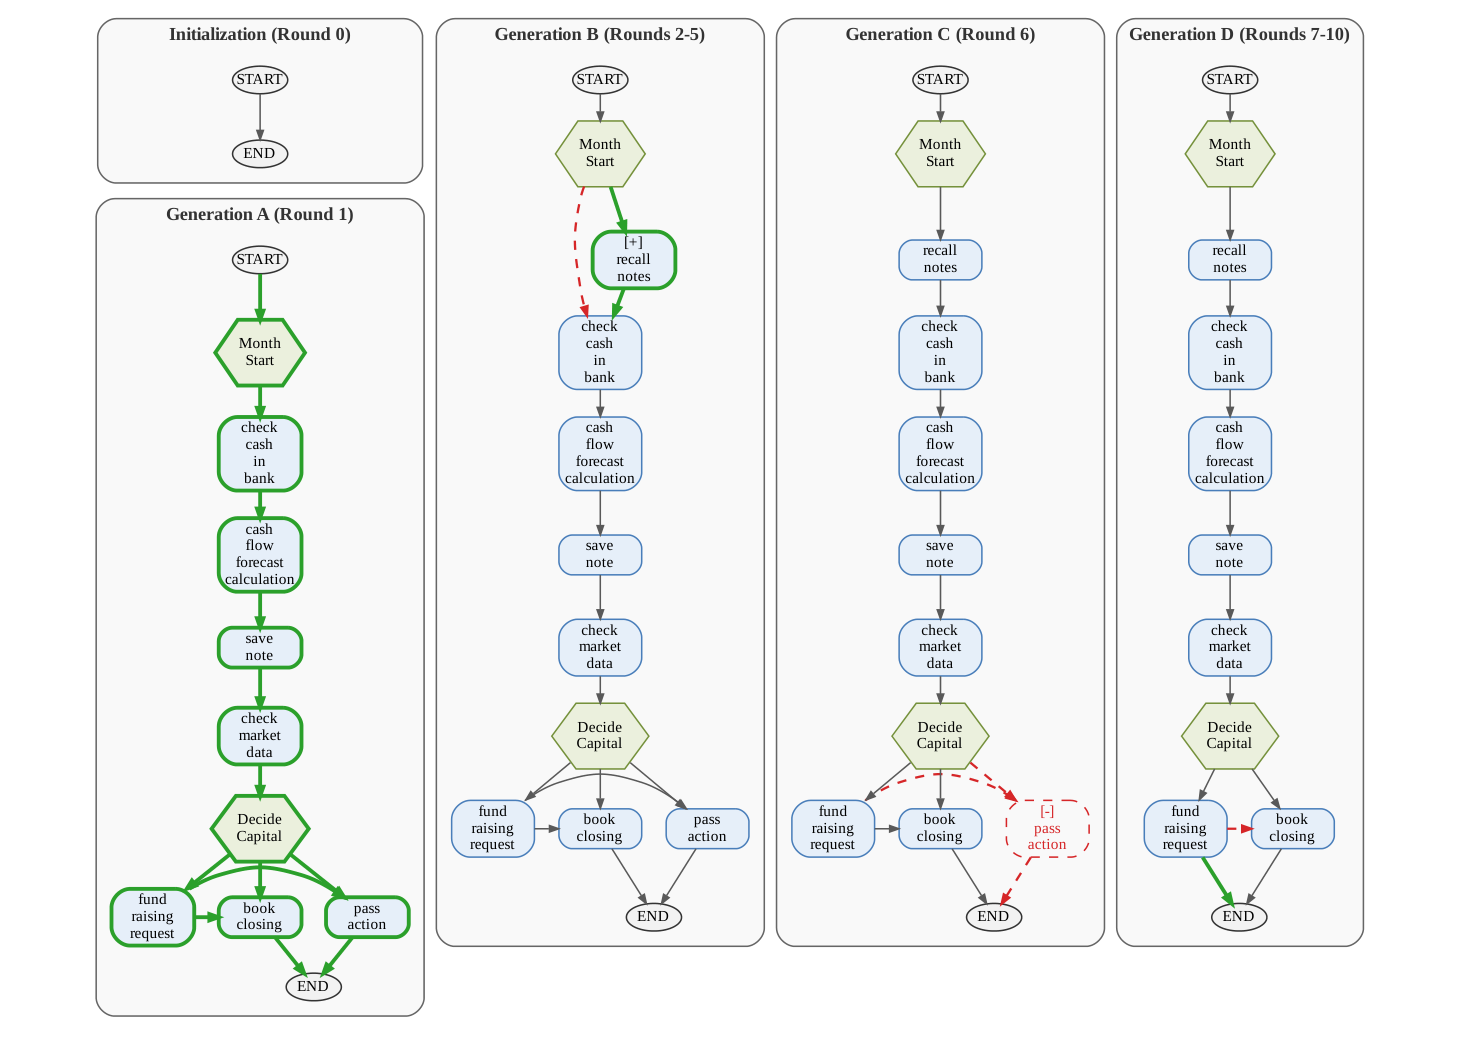
結構檢查(Appendix B.6)只看三件事:邊的端點必須存在、節點與關係型別合法、每個節點都有路徑走得到終點節點(沒有往外邊的節點才算終點)。沒通過的候選直接丟掉。
5.2 驗證閘門:決定改圖會不會越改越糟
驗證集上的分數,以及採用與否的規則(合起來叫驗證閘門),分兩步。第一步是算分:新圖在驗證集的每一題上都跑一遍 solver,把每題得分取平均。
第二步是比較:新圖的平均分不低於舊圖,就換上新圖,否則留著舊的。
- :驗證集,和訓練批、測試集都分開。
- :一題問題和它的標準答案。
- :用圖 時 solver 的輸出; 是單題分數,所以 就是驗證集上的平均分。
- 比較用的是 ,持平也收。舊圖的分數是快取的,不重跑。
為什麼要獨立的驗證集?因為 refiner 是看過訓練軌跡才提出修改的,在訓練批上有效,不代表真的有效。這就像背過考古題的人,在考古題上拿高分,不代表真的學會;要換一份沒看過的題目,才知道有沒有效。
十輪的走法。 表 2 是 Appendix E 的 Table 11,在 EnterpriseArena 上用 Gemini 3.5 Flash 做的自我演化。閘門的規則(論文沒寫指標,下面說明為什麼我推測是存活率)是:新圖的驗證存活率不低於目前保留圖的存活率就收,否則丟。分母是驗證集的 20 個 episode(一次完整的模擬),1 個 episode 等於 5 個百分點;存活率指撐滿 132 個月沒破產的比例。
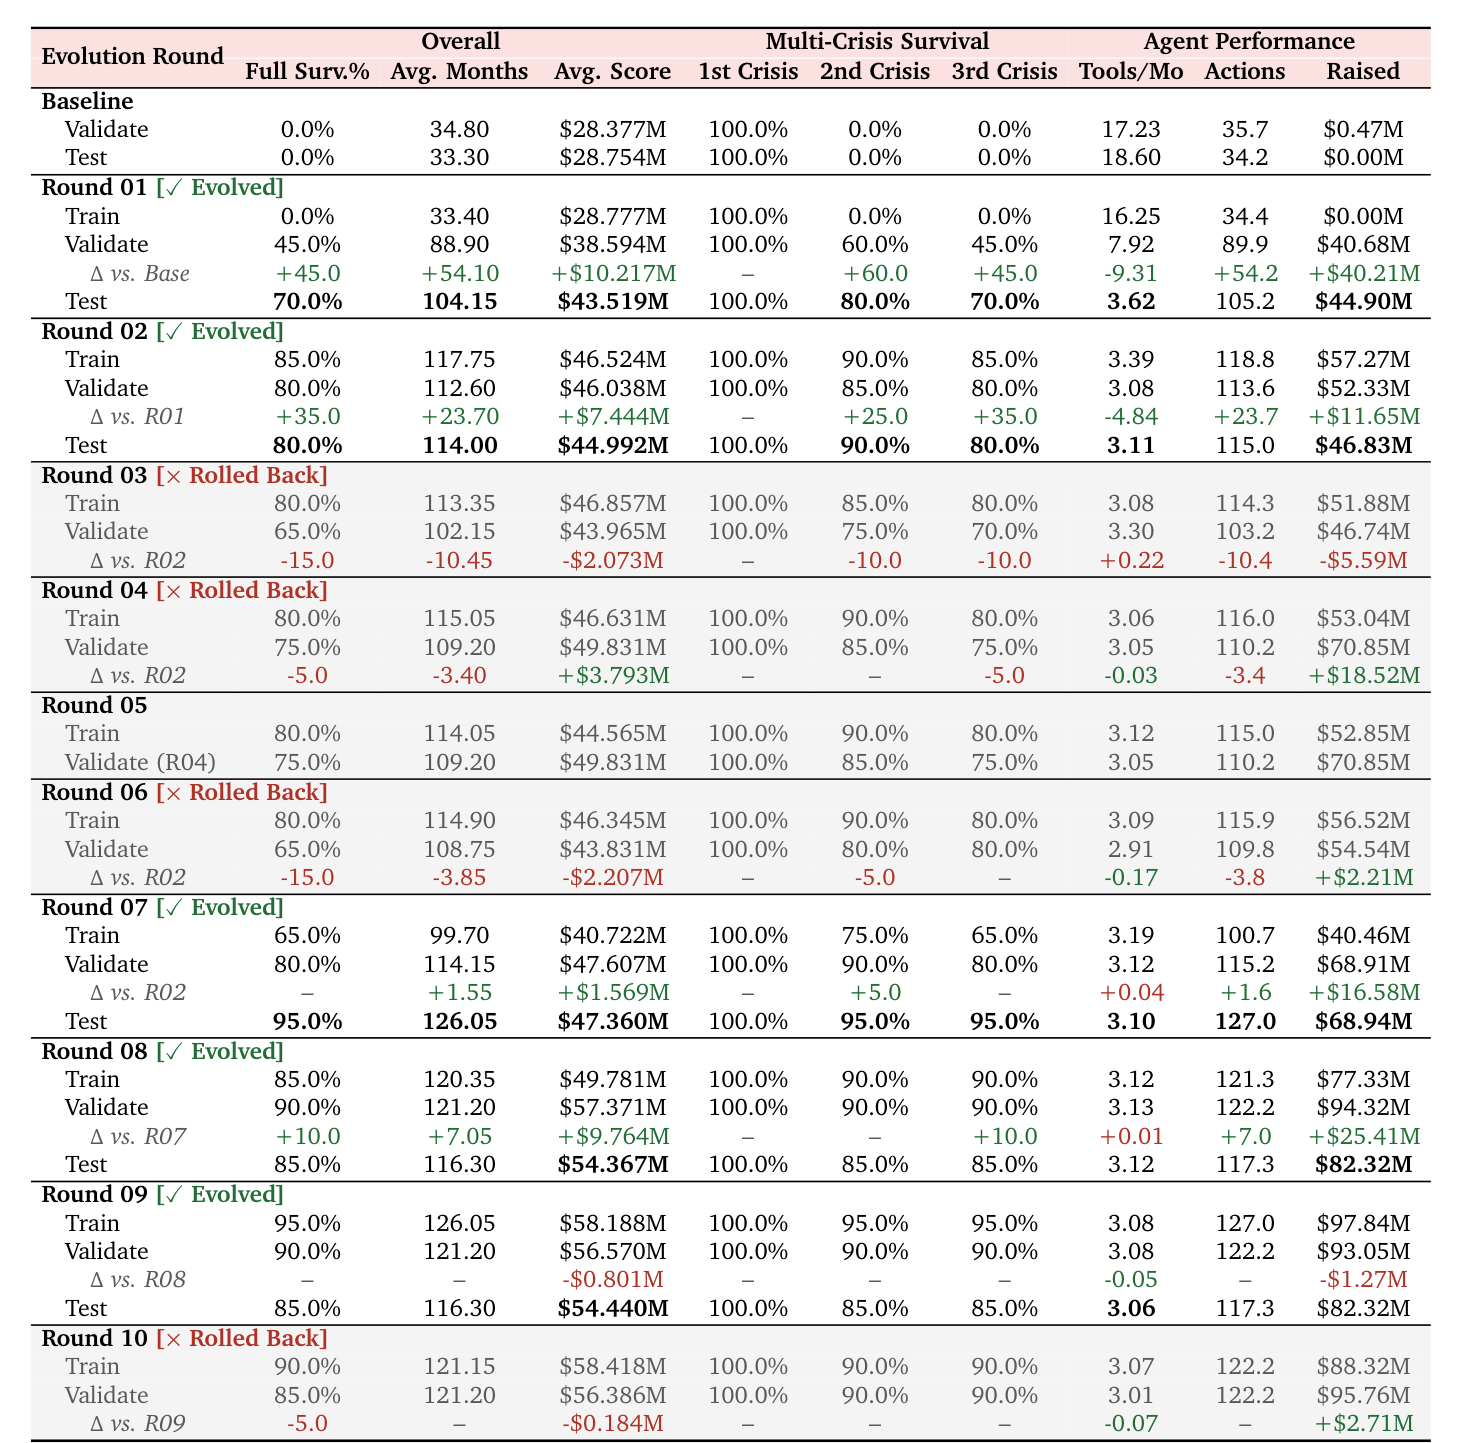
把這張表的決策過程整理一下:
| 輪次 | 新圖存活率 | 要比的對象(目前保留圖) | 結果 | 這輪之後保留的圖 |
|---|---|---|---|---|
| R1 | 45.0%(9/20) | 0.0%(起始空圖) | 收 | R1 |
| R2 | 80.0%(16/20) | 45.0% | 收 | R2 |
| R3 | 65.0%(13/20) | 80.0% | 丟 | R2 |
| R4 | 75.0%(15/20) | 80.0% | 丟 | R2 |
| R5 | 結構檢查沒過,沒跑驗證 | 80.0% | 丟 | R2 |
| R6 | 65.0%(13/20) | 80.0% | 丟 | R2 |
| R7 | 80.0%(16/20) | 80.0% | 持平,收 | R7 |
| R8 | 90.0%(18/20) | 80.0% | 收 | R8 |
| R9 | 90.0%(18/20) | 90.0% | 持平,收 | R9 |
| R10 | 85.0%(17/20) | 90.0% | 丟 | R9 |
最右欄是重點:保留的圖只會往前走,不會倒退。R3 到 R6 全被丟,所以那四輪結束時手上的圖都還是 R2。R10 的訓練存活率是 90.0%,驗證只有 85.0%,被擋下的就是只在訓練批上有效的改動(Appendix E.2)。
- 論文沒寫這個實驗的 用哪個指標。 但表 2 的決策只對得上存活率。這是我的推測:閘門實際看的是存活率。(推論的依據收在下面的摺疊區塊。)
- 驗證集太小時,接受與拒絕大半是雜訊。 20 個 episode 差 1 個就是 5 個百分點。論文自己也說,一次接受或拒絕只差一兩個 episode,只能當作搜尋過程的記錄,不能當作統計上的顯著性檢定(Section 5.4)。持平也收,所以雜訊也可能把圖往前推。
5.3 拒絕記憶:記下被丟的修改
最後一個零件是拒絕記憶:記下被丟的修改。
被拒的修改不會憑空消失。下一輪 refiner 提修改時,除了目前的圖和新一批軌跡,還會看到被拒過的候選,當作「別再提這種」的提醒。
- :目前保留的圖。
- :下一輪的訓練軌跡,超過長度上限 就砍掉開頭、保留結尾。
- :被拒絕過的候選的歷史,當作「別再提這種」的負面證據。
被拒之後的處理很單純:圖不變,記一筆,下一輪用同一張圖在下一批訓練題上重跑,再讓 refiner 重新提修改。迴圈固定跑 輪,不會因為被拒而提早停止。每筆記錄放什麼、refiner 實際看到哪些,在文末的概念補充裡細講。
再看 Appendix E.2 的一輪:R3 把觸發募資的現金門檻調低,在訓練種子(可以理解成模擬的隨機起點)上有效,在驗證集上卻造成過早稀釋與現金不足,驗證存活率從 80.0% 掉到 65.0%,被丟。
小結:離線這一半可以記成三個動作:提案(refiner 改圖)、把關(獨立驗證集)、被拒回灌(拒絕記憶)。
6 整套方法,一張表看完
把前面的零件放在一起,再看一次全貌。
整套方法有七個零件:線上階段三個、離線階段三個,加上兩階段共用的圖本身。
| 零件 | 一句話 | 輸入 | 輸出 | 時機 |
|---|---|---|---|---|
| 圖 | 步驟與可接關係,邊上附 condition / guidance / pitfalls | - | - | 兩階段共用 |
| 定位+取子圖 | 找出目前節點,取 跳子圖 | 上一步動作、 | 子圖 | 線上 |
| (guidance model) | 把子圖翻成當下提示 | 、、最近 3 步 | (文字) | 線上 |
| solver | 選下一步動作 | 、完整軌跡、 | Thought+Action | 線上 |
| refiner | 看軌跡提出改圖清單 | 目前圖、訓練軌跡、分數、 | 修改清單 (JSON) | 離線 |
| 驗證閘門 | 候選圖在驗證集分數不低於舊圖才收 | 候選圖、驗證集 | 收或丟 | 離線 |
| 拒絕記憶 | 記下被丟的修改 | 被丟的候選與其證據 | 供下一輪 refiner 參考 | 離線 |
7 實驗一:23 / 24 有進步,但要打折來看
三個實驗各回答一個問題:整體有沒有用(實驗一)、核心設計是不是真的有貢獻(實驗二)、圖從哪裡來比較好(實驗三)。先看實驗一。
這一節有兩種比法。和無記憶的 ReAct 比(同模型、同 solver):24 格中有 23 格為正,但 HotpotQA 幾乎沒有增益。和每格最強的對照做法比,是論文自己的宣稱:PG 在 24 個「模型 × benchmark」格子中,有 21 格排第一或並列第一,細節收在下面的摺疊區塊。
設定(Section 4): 4 個 LLM(Claude Sonnet 4.6、Gemini 3.1 Pro、Gemini 3.5 Flash、Grok 4.1 Fast),6 個 benchmark,7 個對照做法(baseline)。所有方法共用同一個 ReAct solver,只差經驗怎麼存、怎麼用。guidance model 與 refiner 和 solver 用同一個 LLM,全部用 greedy decoding。
七個對照做法大致可以這樣分:Vanilla ReAct 什麼都不存;MemoryBank、RAP、ExpeL、AWM 存的是經驗摘要、歷史軌跡、歸納出的心得或工作流這類文字;AutoGuide 存「在狀態 X 做 Y」的條件式指引;KnowAgent 存「哪個動作後可接哪個」的規則。逐一的對照放在文末的 baseline 概念補充。
六個指標與測試題數: 題數決定一題值幾分。GDPval 只有 44 題,一題約 2.3 分,小差距很容易只是雜訊。
| Benchmark 與指標 | 測什麼 | 測試題數 |
|---|---|---|
| HotpotQA Acc. | 多跳問答的答案是否正確(LLM 評審判斷與標準答案等價) | 1,000 |
| MultiChallenge Acc. | 多輪對話中,是否記得並遵守先前的指令(LLM 評審的整體成功率) | 166 |
| GDPval Rubric Score | 專業交付物按每題評分表打分的平均 | 44 |
| ALFWorld Success | 虛擬家庭任務的成功率,動作順序要求嚴格 | 134 |
| -bench Pass@1 | 客服情境,最後資料庫狀態是否等於標準答案的比例 | 115 |
| BFCL v3 Acc. | 多輪函式呼叫的準確率 | 100 |
表 3 括號裡的是信賴區間:可以粗略讀成「這個分數大概落在哪個範圍」,範圍越寬,越不確定。
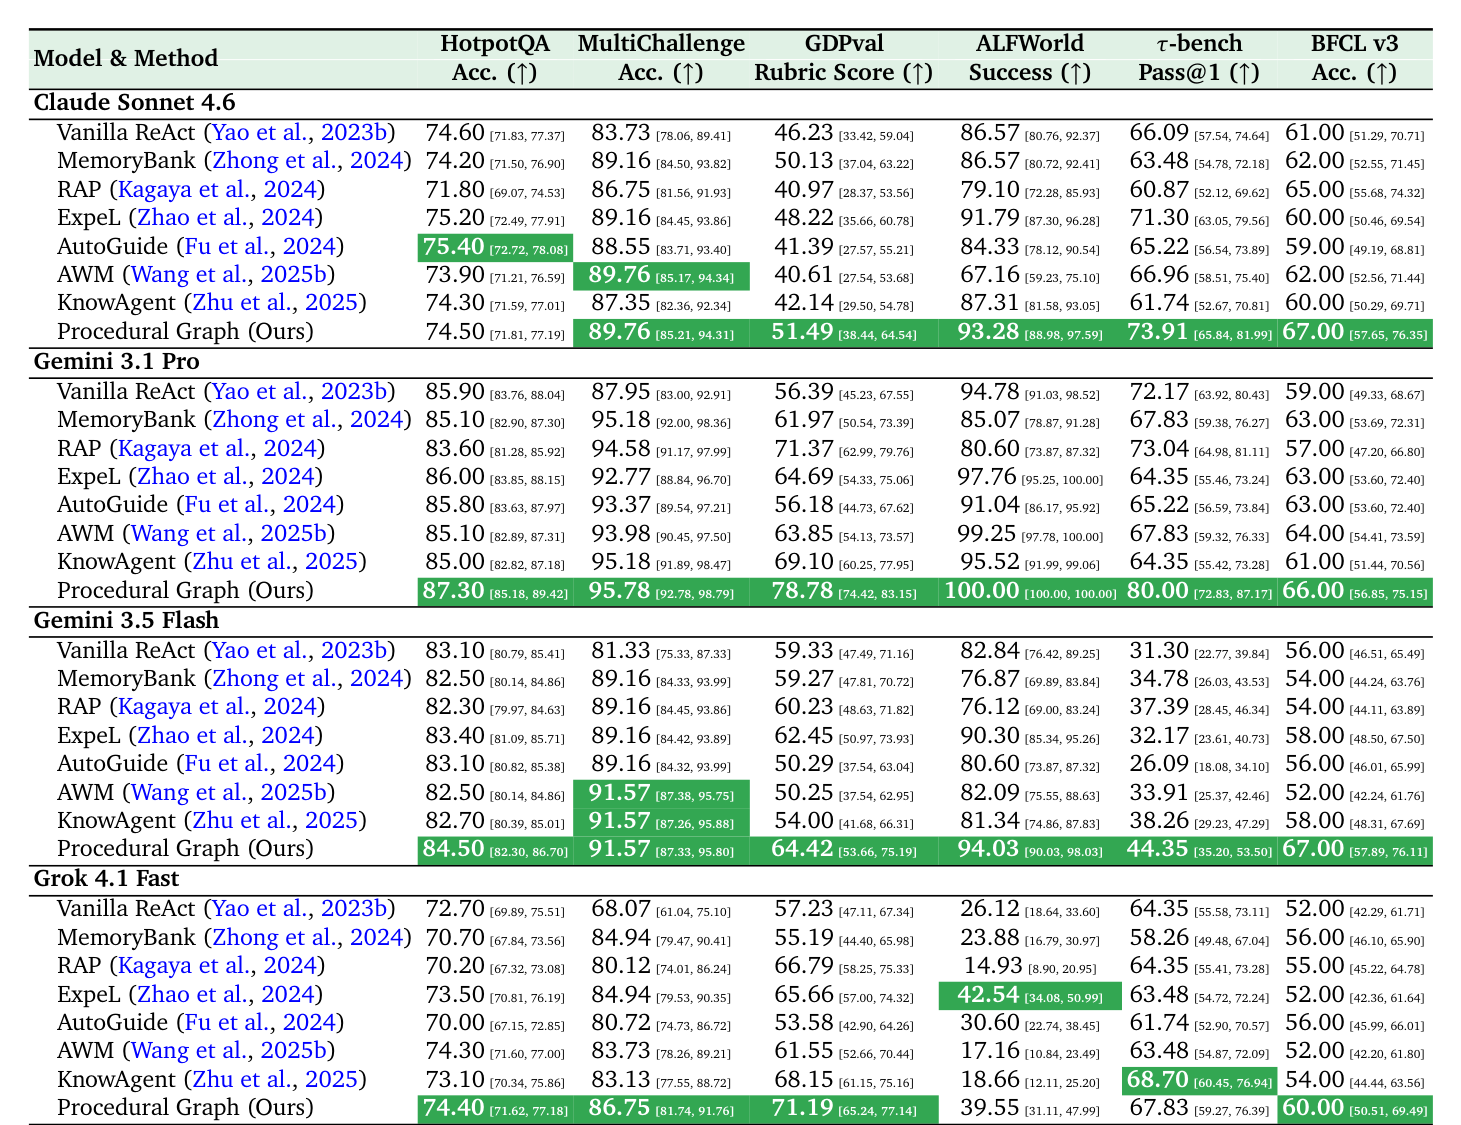
乾淨對照: 用 PG 減去無記憶 ReAct,同一個模型、同一個 solver,單位是分。
| 模型 | HotpotQA | MultiChallenge | GDPval | ALFWorld | -bench | BFCL |
|---|---|---|---|---|---|---|
| Claude Sonnet 4.6 | -0.10 | +6.03 | +5.26 | +6.71 | +7.82 | +6.00 |
| Gemini 3.1 Pro | +1.40 | +7.83 | +22.39 | +5.22 | +7.83 | +7.00 |
| Gemini 3.5 Flash | +1.40 | +10.24 | +5.09 | +11.19 | +13.05 | +11.00 |
| Grok 4.1 Fast | +1.70 | +18.68 | +13.96 | +13.43 | +3.48 | +8.00 |
從這張表可以讀出幾件事:
- 24 格中 23 格為正,唯一為負的是 Claude 的 HotpotQA(-0.10)。
- HotpotQA 幾乎沒有增益,最大只有 +1.7,小於該列的信賴區間寬度。其餘五個 benchmark 是 +3.48 到 +22.39。
- 「贏 baseline」要打折,因為不少 baseline 本身比無記憶還差。例如 Gemini 3.1 Pro 的 ALFWorld,無記憶是 94.78,MemoryBank 是 85.07,RAP 是 80.60。所以對每格最強 baseline 的 19 勝,有一部分是對手退步,和無記憶對照才看得出 PG 本身的貢獻。
小結:整體有用,但要打三個折扣:HotpotQA 幾乎沒進步;有些勝利是對手退步造成的;比較是否公平,還有一個我懷疑的潛在混淆(這是我的推測,論文沒有承認)。
8 實驗二:整張圖會傷害,只取附近才有效
局部子圖加生成式提示,在三個 benchmark 上都是最高;整張圖會傷害,尤其是需要嚴格動作順序的 ALFWorld。這是唯一直接檢驗核心設計(局部取子圖、再由 翻成提示)的實驗(Section 5.5)。
設定: 同一張圖、同一個模型(Gemini 3.5 Flash),只改兩件事:給 agent 看整張圖還是局部子圖,以及圖是原文塞進去,還是先讓 翻成提示。比較四種組合:
- 無圖:不用 PG。
- 整張圖+原文塞入:整張圖序列化後直接放進 prompt,不經 。
- 整張圖+生成式:整張圖交給 翻成提示。
- 局部子圖+生成式:論文的完整做法。
兩個成本指標都是越低越好:Avg. Tok 是每題平均用掉的 token 數(包含 的呼叫),Avg. Step 是每題 solver 平均走幾步。
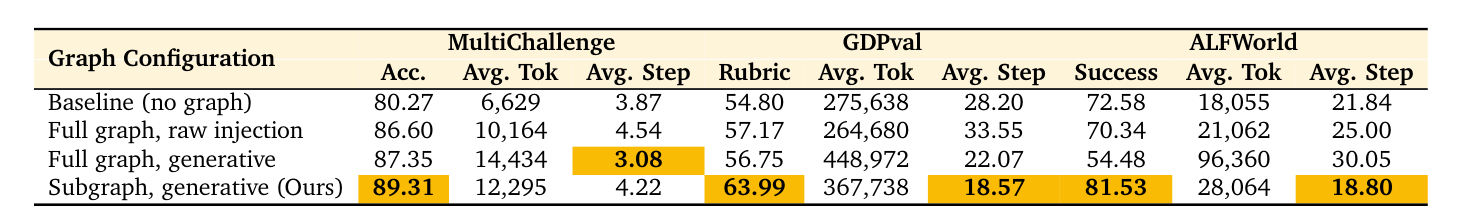
準確率(單位:分,越高越好):
| 設定 | MultiChallenge | GDPval | ALFWorld |
|---|---|---|---|
| 無圖 | 80.27 | 54.80 | 72.58 |
| 整張圖+原文塞入 | 86.60 | 57.17 | 70.34 |
| 整張圖+生成式 | 87.35 | 56.75 | 54.48 |
| 局部子圖+生成式 | 89.31 | 63.99 | 81.53 |
成本:token 相對無圖的倍數(由表 4 的原始 token 數計算):
| 設定 | MultiChallenge | GDPval | ALFWorld |
|---|---|---|---|
| 整張圖+原文塞入 | 1.53 倍 | 0.96 倍 | 1.17 倍 |
| 整張圖+生成式 | 2.18 倍 | 1.63 倍 | 5.34 倍 |
| 局部子圖+生成式 | 1.85 倍 | 1.33 倍 | 1.55 倍 |
從這兩張表可以得到三件事:
- 局部子圖在三個 benchmark 都最高,比各自的第二名高 1.96、6.82、8.95 分。
- 整張圖會傷害。 ALFWorld 從 72.58 掉到 54.48,同時 token 是無圖的 5.34 倍。我的推測是:ALFWorld 要求嚴格的動作順序,整張圖裡不相干的分支, 還是會把它們寫進提示。論文只給結果,沒給機制。
- 局部子圖的成本一直比無圖高。 它的 token 是無圖的 1.33 到 1.85 倍。步數則在 GDPval(28.20 降到 18.57)與 ALFWorld(21.84 降到 18.80)下降,MultiChallenge 反而從 3.87 升到 4.22。
小結:這就是「導航只報下一兩個路口」的證據:只取附近的子圖,比把整張圖唸給 agent 聽更好。不過就算只取附近,成本還是比不用圖高。
9 實驗三:手寫專家圖可能崩盤,演化救得回來
這個實驗檢驗兩件事:自我演化有沒有用,以及能不能修好壞掉的專家圖。穩的訊號只有一個:在 MultiChallenge 上,專家圖會讓成績崩掉,而演化救得回來。至於空圖起步能不能追平專家圖,MultiChallenge 的資料分不出來(Section 5.3)。
設定: 同一個模型(Gemini 3.5 Flash,Appendix D.3),改變「圖從哪來、怎麼更新」,比較五種組合(Appendix D.2):
| 模式 | 起點 | 更新方式 | 驗證閘門 |
|---|---|---|---|
| 1 | 手寫專家圖 | 不更新 | 無 |
| 2 | 手寫專家圖 | 跑完整個訓練集後一次大改 | 無 |
| 3 | 手寫專家圖 | 分批演化 | 有 |
| 4 | 空圖(Start → End) | 一次大改 | 無 |
| 5 | 空圖 | 分批演化 | 有 |
「分批演化」與「一次大改」的差別如下:
| 一次大改 | 分批演化 | |
|---|---|---|
| 流程 | 用起點圖跑完整個訓練集,refiner 讀全部軌跡,一次輸出大幅修改,直接採用,結束 | 訓練集切成多批,每批依序:用目前的圖跑、refiner 提修改、驗證集把關(收或丟),再用(可能已更新的)圖跑下一批,重複到最後一批 |
| 迭代 | 一輪 | 多輪 |
| 驗證閘門 | 無 | 有 |
表裡有兩個指標:HotpotQA 看答案是否和標準答案完全相同(EM),MultiChallenge 看整段對話的指令是否都遵守(Overall)。HotpotQA 測試 1,000 題,1 題等於 0.1 分;MultiChallenge 在這張表只用其中 56 題(實驗一用 166 題,論文沒說為什麼這裡只用 56 題),1 題等於 1.79 分,所以 MultiChallenge 上每一題的差距都不小。指標與分母的完整說明收在下面。
- Ans EM(Exact Match): 答案字串和標準答案完全相同才算對,只測最終答案。論文同時報 Ans F1(答案與標準答案的字詞重疊程度,比 EM 寬鬆),趨勢相同,這裡只看 EM。
- MultiChallenge Overall: LLM 評審判斷整段對話的指令是否都遵守的成功率。MultiChallenge 另有四個子指標(Inference Memory、Instruction Retention、Reliable Versioned Editing、Self Coherence),這裡只看 Overall。
- 分母: HotpotQA 測試 1,000 題,1 題等於 0.1 分。MultiChallenge 在這張表只用 56 題(Appendix B.1;實驗一的測試集是 166 題,論文沒說為什麼這裡只用 56 題),1 題等於 1.79 分。
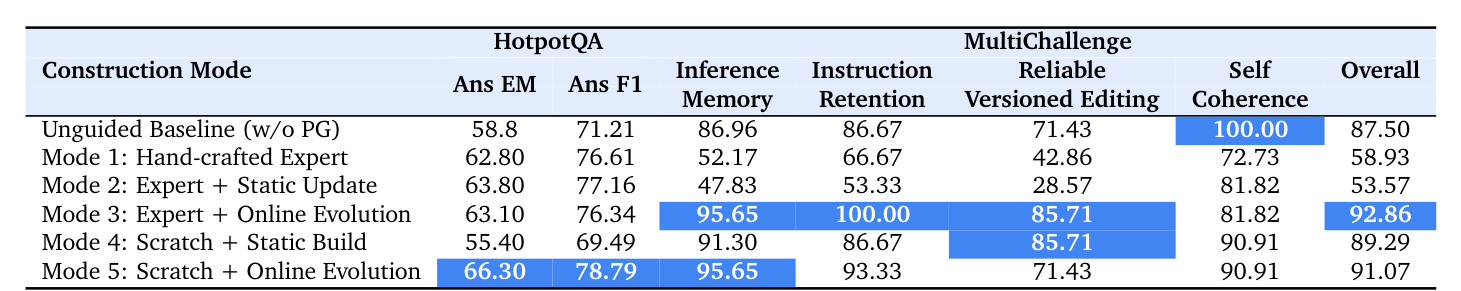
結果:
| 模式 | HotpotQA EM | 和無圖差 | MultiChallenge Overall | 和無圖差 |
|---|---|---|---|---|
| 無圖 | 58.8 | - | 87.50(49/56) | - |
| 1 手寫專家圖 | 62.8 | +4.0 | 58.93(33/56) | -16 題 |
| 2 專家圖+一次大改 | 63.8 | +5.0 | 53.57(30/56) | -19 題 |
| 3 專家圖+分批演化 | 63.1 | +4.3 | 92.86(52/56) | +3 題 |
| 4 空圖+一次大改 | 55.4 | -3.4 | 89.29(50/56) | +1 題 |
| 5 空圖+分批演化 | 66.3 | +7.5 | 91.07(51/56) | +2 題 |
三個結論:
- HotpotQA 只有模式 5(空圖+分批演化)明顯最好。 它比無圖多答對 75 題。模式 4 和 5 都從空圖出發,EM 差 10.9;比無圖還差的模式 4(空圖+一次大改),則少答對 34 題。
- 在 HotpotQA 上,專家圖起點時演化沒有額外加分。 模式 3(專家圖+分批演化,63.1)只比不更新的模式 1(62.8)高 0.3,還低於模式 2(專家圖+一次大改,63.8)。三個專家圖模式都落在 62.8 到 63.8 之間,空圖起步的模式 5 則是 66.3。
- MultiChallenge 穩的訊號是「專家圖會讓成績崩掉,而且演化救得回來」。 模式 1、2 比無圖少 16、19 題,模式 3 從模式 1 的 33 題回到 52 題,差距為 92.86 − 58.93 = +33.93,和論文報的數字一致。但模式 3、4、5 彼此只差 1 題、和無圖只差 1 到 3 題,不能據此說誰比誰好,也不能說「空圖起步追平專家圖」。
乾淨對照(方法本身的貢獻): 起點相同,只比較「加上演化與閘門」之後多了多少。
| 起點 | 比較的模式 | HotpotQA EM | MultiChallenge |
|---|---|---|---|
| 專家圖 | 模式 3 對模式 1 | +0.3 | 多 19 題 |
| 空圖 | 模式 5 對模式 4 | +10.9 | 多 1 題 |
小結:這個實驗最站得住的一句話,是手寫的專家圖在 MultiChallenge 上可能讓成績崩掉,有驗證閘門的分批演化可以救回來(這份資料只看得到結果,看不出原因)。至於空圖起步能不能追平專家圖,MultiChallenge 的資料分不出來。
10 帶走什麼
前面是這篇論文做了什麼。這一節講怎麼把它用在自己的事情上,並收尾。最值得帶走的,其實不是圖。
10.1 改進迴圈:提案、獨立驗證、被拒回灌
讓 LLM 提出對某份文字資產(prompt、規則、skill、圖)的修改,用一組它沒看過的資料量化新舊版本,沒變差才採用,被拒的記下來,下一次提案時一併給它看。這個做法與圖無關,任何可編輯的文字資產都能套。
比如你有一份常用的 system prompt:讓 LLM 根據幾次失敗的對話提出修改,用一批它沒看過的對話打分,沒變差才換上新版,被拒的修改留著,下次提案時一起給它看。
asset = 初始版本;  rejected = []
score_asset = evaluate(asset, VAL)            # 初始版本只算一次,快取
for round in 1..K:
    traces   = run(asset, TRAIN_BATCH[round]) # 用目前版本跑新一批訓練資料
    proposal = LLM_propose(asset, traces, rejected)
    cand     = apply(asset, proposal)
    if not valid(cand): rejected.append(proposal); continue
    score_cand = evaluate(cand, VAL)
    if score_cand >= score_asset: asset, score_asset = cand, score_cand
    else: rejected.append((proposal, cand, score_cand))
10.2 使用時要記得的限制
這個迴圈的限制前面都出現過:
- 爬山法走不出需要先變差才能到達的設計。
- 驗證集太小時,閘門收的多半是雜訊。
- 只寫在 prompt、驗證器不檢查的約束等於沒有約束(refiner 編出不存在的工具節點,就是例子)。
套用到自己的資產時,最先該檢查的是驗證集夠不夠大,以及約束有沒有被程式檢查。
10.3 怎麼選閘門
這是一般知識,不是論文內容:先用這種貪心(只接受不比現在差的版本)閘門;只有驗證分數連續多輪不動、而且驗證資料夠大時,才考慮能接受較差版本、或同時保留多個候選的做法。
10.4 結論
PG 把 agent 的做事流程存成帶屬性的圖,推論時只取目前位置往後 2 跳的子圖、由另一個 LLM 翻成提示,離線則靠 refiner 改圖、獨立驗證集把關。對比無記憶的 ReAct,它在 24 格中贏了 23 格,但 HotpotQA 幾乎沒有增益,成本是 token 約 1.33 到 1.85 倍。
幾個要帶走的重點:
- 局部子圖加生成式提示是最好的使用方式,整張圖會傷害,尤其是在需要嚴格動作順序的 ALFWorld。
- 專家圖在 MultiChallenge 上可能讓成績崩掉,演化加驗證閘門可以救回來;但在 HotpotQA 上,專家圖起點時演化沒有額外加分;至於空圖起步能否追平專家圖,MultiChallenge 的資料分不出來。
- 驗證集太小、閘門持平就收、約束只靠 prompt,是這套機制實際使用時最需要留意的地方。
- 最值得帶走的是改進迴圈本身:提案、獨立驗證集把關、被拒記錄回灌。它不依賴圖,可以套在任何可編輯的文字資產上。
如果只記三句話:
- 導航只報下一兩個路口。 把「接下來做什麼」存成圖,每一步只取腳邊兩跳,由另一個 LLM 轉成一段提醒給 agent;提醒只是偏向,不是強制。
- 提案、把關、被拒回灌。 改動要在沒看過的驗證集上不比舊的差才採用,被拒的記下來。
- 23 / 24,但有代價。 多數情況有進步,但 HotpotQA 幾乎沒增益,每步多一次 LLM 呼叫,手寫專家圖在 MultiChallenge 上還可能讓成績崩盤。
下次看到有人說「我們幫 agent 加了記憶」,可以問三個問題:它存的是自由文字,還是有結構的東西?推論時是整份塞進去,還是只取目前需要的?改動有沒有被沒看過的資料把關?
11 延伸閱讀:五個獨立的概念補充
以下五段各自獨立,脫離論文主線也讀得懂。它們解釋的是上面主線裡一筆帶過、但最容易再忘的環節。
11.1 定位與子圖:上一步動作怎麼對到節點
一句話:每一步先用「agent 上一步的動作」在圖上找出目前位置,再沿著往外的邊展開固定步數,只把這一小段圖交給後面使用。這一段解釋方法二第一部分裡的 與 實際在做什麼。
上一步動作 從哪來? 它不是另外算出來的,就是 solver 上一步自己寫出的那行 Action。solver prompt 規定每一步只輸出一個 Thought 和一個 Action,格式是 Action: <tool_name>(arg1=val1, ...)(Appendix B.5),這行會原樣記進軌跡。所以 就是軌跡裡最後一個動作,例如 fund_raising_request(type='equity', amount=50000000)。
「exactly matching」到底比什麼? 論文只寫 exactly match,細節沒有交代:
- 比整行(含參數),還是只比工具名?沒說。
- 節點也可以是推理步驟或任務狀態(Section 3.1),例如
Decide_Capital、Month_Start,它們不對應任何工具呼叫,怎麼比對?沒說。 - 推測: 比的應該是工具名,因為 refiner prompt 規定 ACTION 節點必須和可用工具名一致(Appendix B.5 的 Rule 1)。但 Appendix B.5 的範例裡,節點叫
First_Hop_Retrieve、工具叫first_hop_retrieve,大小寫不同,所以「exact」大概先做過正規化。
論文也只展示了比對後的結果(序列化範例裡的 Active Cognitive Node),沒有展示比對這一步。
論文實際寫了什麼,與一般實作的名稱
| 論文原文有寫 | 論文沒寫(一般知識或推測) |
|---|---|
| 把最近一個動作 exactly match 到圖上的一個節點,得到 | 用什麼資料結構比對。常見做法是字典查表:節點名稱對到節點,查得到就是 ,查不到就是空 |
| 從 沿著往外的邊,最多展開 步,收集走到的節點和邊 | 這個展開常稱為廣度優先走訪(BFS):先收完同一層,再往下一層 |
| 比對不到就用整張圖;實驗 | 比對失敗的頻率 |
字典查表與 BFS 只是常用的程式名稱,不是論文內容。比對只看字串吻合,不用 embedding(把文字轉成一串數字,好用來算相似度)、不算相似度,所以結果是確定的。
手動走一遍。 邊清單如下,前兩條來自 Appendix B.5 的 HotpotQA 節錄,後兩條是自編的例子:
First_Hop_Retrieve → Scan_IndexScan_Index → Bridge_ExtractBridge_Extract → Second_Hop_Retrieve(自編)Second_Hop_Retrieve → Answer(自編)
假設 agent 上一步的動作是 first_hop_retrieve,:
- 找節點:清單裡名字對得上的是
First_Hop_Retrieve,這就是 。 - 第 1 步:找「起點是 」的邊,得到第 1 條,收進
Scan_Index。 - 第 2 步:找「起點是
Scan_Index」的邊,得到第 2 條,收進Bridge_Extract。 - ,停止,第 3 條和第 4 條不收。
- 就是第 1 條和第 2 條邊,連同各自的 condition、guidance、pitfalls。
比對失敗時(上一步的動作在圖上找不到), 就是這四條邊全部。Appendix B.5 的序列化範例按「Hop 1」「Hop 2」分組列出邊,和這個做法一致。
展開的三個細節:
- 只沿出邊走,也就是順著箭頭方向。 走過來的節點不在子圖裡,那段歷史由最近 步的軌跡視窗補上。
- 遇到分岔,同一層的所有出邊一起收。 例如 EnterpriseArena 後期的圖,
Decide_Capital後面接fund_raising_request和book_closing,兩條都在第 1 跳。 - 自編例子: EnterpriseArena 的主線是
Month_Start → check_cash_in_bank → cash_flow_forecast_calculation → save_note → check_market_data → Decide_Capital。若 是check_cash_in_bank、,就收進cash_flow_forecast_calculation(第 1 跳)與save_note(第 2 跳),到此停;check_market_data是第 3 跳,不收。
為什麼要沿結構取,而不是依相似度取? 這是 Section 3.2 的論點:獨立做 top-k 相似度檢索(挑出最相似的前 k 筆),可能漏掉步驟之間的連接。例如檢索到 submit 的指引,卻沒有前面 check_answer 的轉移,就可能漏掉讓提交變得合理的驗證步驟。沿結構取出鄰域,可以同時帶出動作和它的程序前提。
11.2 Ψ 與 solver:各看到什麼、輸出什麼
推論時有兩個 LLM 各司其職。(guidance model)讀圖,寫出一小段提示;solver 看不到圖,只讀 寫的提示,然後選動作。下表只列論文實際給出的內容(Appendix B.5 的兩個 prompt 模板),沒寫清楚的另外標示。
| 項目 | (guidance model) | solver |
|---|---|---|
| 角色 | 把子圖翻成當下的提示 | 選下一步動作 |
| 看到的圖 | 序列化後的局部子圖:節點 ID、類型、描述,加上每條邊的 condition / guidance / pitfalls,按 Hop 1、Hop 2 分組 | 看不到圖,只看到 寫的 |
| 看到的軌跡 | 最近 步 | 完整軌跡 |
| 任務描述 | 有(模板的 task_description 欄位) | 在 system_prompt 裡(推測) |
| 使用者問題 | 有(模板的 query 欄位,見下方第 2 點) | 模板沒有獨立欄位,推測在 system prompt 或軌跡裡 |
| 指令 | 依邊上三個屬性,寫出清楚可執行的建議:下一步做什麼、要避開什麼、失敗後怎麼補救,並帶上圖裡寫到的具體指令格式、工具、參數 | 固定格式:每次只輸出一個 Thought 和一個 Action,不准自己寫 Observation |
| 輸出 | :自由文字,論文沒規定格式 | Thought: ... 加 Action: tool_name(arg=val, ...) |
整體資料流和方法二的七步流程相同,這裡不重複。
有三個容易誤會的點:
- solver 完全看不到圖本身。 圖的資訊只透過 的文字進來,所以 寫得好不好,直接決定圖有沒有用。
- 的 query 欄有兩種讀法,論文沒有釐清。 Appendix B.5 的 prompt 把它描述成 current active query / observation,論文的公式卻寫成使用者問題 。如果是原始問題, 每一步看到的都是同一句話;如果是最新的觀察, 就會針對剛發生的結果反應。後者比較能解釋圖 2 裡「avoid: repeating search」這類提示,但這是推測。
- 的實際輸出全文,論文沒有完整展示。 圖 2 中間欄的 只是示意。
下面是一個自編的 例子,根據 Appendix B.5 那兩條邊的 guidance 與 pitfalls 想像的輸出,不是論文原文:
11.3 一個 benchmark 一張圖
這一段想回答的是:如果一個 benchmark 裡有很多種任務,一張圖要怎麼服務它們?先講論文的做法:每個 benchmark 只有一張圖,演化就是把這一張圖從 改到 ;refiner 的輸入只有一張圖、輸出只有四種零件修改,所以沒有「選哪一張圖」或「要不要新增一張圖」的決策。
為什麼說只有一張圖。 表 1 的每一欄是一個 benchmark,各有一組節點數與邊數。refiner 的輸入欄位是目前保留的那一張圖(Appendix B.5 的 current_graph_json);輸出格式只有 add_nodes、delete_nodes、add_edges、delete_edges,全是改這一張圖的零件,沒有建立新圖的操作。
「從零開始」是怎麼回事。 它指的是起始圖只有 Start → End 兩個節點(Appendix D.2 的模式 4、5)。refiner 的做法仍然是對這張空圖 add_nodes 與 add_edges,EnterpriseArena 的 Round 1 就是這樣一次補出整條主線(Appendix E.3)。所以「從零生成」本質上還是修改既有的圖。
一個 benchmark 裡任務很多樣怎麼辦? 論文用同一張圖服務整個 benchmark。例如 GDPval 涵蓋不同職業的任務,也只有一張 15 個節點的圖,再靠定位機制讓每一步只取圖上的一小段。論文沒有討論依任務類型切換不同的圖,也沒有驗證過多張圖或異質任務的情況。
如果同一張圖裡有互不相關的子圖,不該有連接怎麼辦? 論文沒有討論這個情境,也沒分析過同一張圖放互不相關子圖會怎樣。下表左欄是論文有寫的,右欄是我由此推出來的:
| 論文有寫 | 推測 |
|---|---|
| 結構檢查列出的條件只有端點存在、型別合法、每個節點走得到終點,沒列出整張圖連通,或從 Start 可達(Appendix B.6) | 不該連的子圖可以保持分離,只要 refiner 不去加連接邊 |
| 第 1 步固定從 Start 定位,取 2 跳子圖 | Start 要連到各子圖的入口,所以第 1 步的子圖會把各類任務的前兩層混在一起,靠 (它有看到任務描述與 query)自己篩 |
| 定位只看上一步動作對到哪個節點 | 圖沒有路徑記憶:同一個節點,不管任務是哪一類,都吐出同一個鄰域 |
| 閘門比驗證集平均分,不低於舊圖就收 | 改動若對 A 類有利、對 B 類有害,只要平均不降就會被收;論文沒按任務類型拆開分析 |
共用節點的例子(自編): 兩類任務都會呼叫 search。A 類 search 後要 verify,B 類 search 後要 summarize。圖上只有一個 search 節點,兩條出邊都會進鄰域, 只能靠 和最近 3 步軌跡猜該用哪一條。
論文確實顯示過「無關的圖內容有害」:表 4(Gemini 3.5 Flash)裡,整張圖加生成式提示是最差設定,ALFWorld 成功率 54.48,局部子圖是 81.53。局部取子圖是它的緩解辦法,但只有在定位成功、鄰域本身不混雜時才成立。
結論: 論文沒處理異質任務,一個 benchmark 一張圖,互不相關的任務如何共存沒有說明。它靠「上一步動作 → 節點」的定位,加上 這個 LLM 過濾,沒有任務類型路由。推測: 它在流程相近的任務上最說得通,例如 EnterpriseArena 每個月跑同一條主線;異質任務混在一張圖上是否有效,沒有被驗證。
11.4 refiner 的輸入與被拒絕的歷史
refiner 每一輪看到的是「目前這張圖、這批訓練軌跡、被拒絕過的歷史」,外加任務背景; 每筆記的是「上次改了什麼、改出什麼圖、為什麼被拒」。
先定義:訓練軌跡是什麼。 它是 solver 在訓練題上實際跑出來的完整過程記錄:一題從開始到結束,每一步的動作和環境回傳的觀察,再加上最後的分數(Section 3.3 Step 1)。
- :第 輪從訓練集抽出的一批題目。
- :第 題的問題。
- :solver 解這題的軌跡,也就是 ,動作與觀察交錯排列。
- :這題的最終分數,範圍 0 到 1;二元任務就是成功或失敗。
拒絕記憶那一節出現的 ,就是把這批 裡的軌跡串接起來、必要時截斷後的結果。
白話一點:一批題各留一筆「題目、解題過程、得幾分」,refiner 拿這批資料比對高分與低分的過程。論文的公式只寫動作與觀察,但 solver prompt 的 Current Trajectory 欄位和 Appendix C.3 的 trace 都有 Thought,所以我推測 也包含 Thought。
refiner 的輸入
| # | 輸入 | 內容 |
|---|---|---|
| 1 | 目前保留的圖 | ,序列化成 JSON |
| 2 | 這一輪的訓練軌跡 | 用 在這批訓練題上跑出的軌跡串接起來,超過 就砍開頭留結尾 |
| 3 | 每題分數 | 每題的最終分數 ,供 refiner 比對高分與低分軌跡 |
| 4 | 被拒絕的歷史 | 經 SerializeRejections 整理後的內容 |
| 5 | 任務描述 | 這個 benchmark 在做什麼(只出現在 Appendix B.5 的 prompt 模板) |
| 6 | 可用工具清單 | agent 能執行的工具名稱,ACTION 節點必須對得上(只出現在 prompt 模板) |
| 7 | 模式 | static_onetime、static_incremental、scratch_onetime、scratch_incremental 之一(只出現在 prompt 模板) |
論文正文的公式只寫了第 1 項、第 2 項和第 4 項,是簡化版;第 5 項到第 7 項要看 Appendix B.5 才有。
每一筆記什麼
每筆記一次「被丟的候選」,分兩種情況(Algorithm 1):
| 欄位 | 驗證沒過 | 結構檢查沒過 |
|---|---|---|
| :refiner 當輪輸出的修改清單(JSON) | 有 | 有 |
| :套用修改後的候選圖 | 有 | 可能不存在(Appendix B.6) |
| :當輪的訓練軌跡(用被拒之前的圖 跑出來的) | 有 | 有 |
| 結果 | 驗證分數 | 錯誤診斷 (沒有分數) |
一開始是空的,之後只增不減。要注意的是,存進去的軌跡是用被拒之前的那張圖 跑出來的,refiner 就是看了這批軌跡才提出那份被拒的修改;候選圖本身在驗證集上跑出的軌跡不會存,只留下分數。所以記錄的是「當初為什麼這樣改」的證據。
真正餵給 refiner 的是哪一部分?論文有兩種說法,沒有判定:
| 位置 | 說法 |
|---|---|
| Section 3.3 Step 4 | 整筆都進 ,refiner 收到 |
| Appendix B.6 | SerializeRejections 只交「候選圖加驗證分數(或結構錯誤診斷)」,訓練軌跡留在記錄裡,沒提 |
推測: 實際餵進去的大概是 B.6 的版本,因為那是實作層的描述。這樣舊軌跡不會重複佔 context,但 沒給,refiner 得自己拿被拒圖和現在的圖比對,才看得出上次改了什麼。
會不會 context 爆炸? 論文沒處理這個問題,但在它的實驗規模下大概不會。論文有限制長度的只有訓練軌跡 (超過 就砍開頭, 的數值論文沒給); 本身沒有上限、摘要或淘汰機制,演算法裡只有 append,從不清空。
增長多快,取決於每筆實際放什麼:只放候選圖與分數時,一筆約等於一張小圖(除 BFCL 外,每張圖只有 7 到 27 條邊);連軌跡也餵時,增長會快很多。實際筆數也很少,EnterpriseArena 在 R10 開始前只累積 4 筆。推測: 增長是線性的;輪數很多、或圖像 BFCL 那麼大時,要自己加上限,例如只留最近 筆,或只留修改清單不留整圖,論文沒驗證過。
11.5 七個 baseline:各自存什麼
七個對照做法裡,1 個是不用任何記憶的 ReAct,其餘 6 個是學習型做法。它們都用同一個 ReAct solver,差別只在「從訓練軌跡存下什麼」和「推論時怎麼放進 prompt」(Section 4、Appendix B.3)。順序依論文的「結構程度」由低到高,完整對照看表 6。
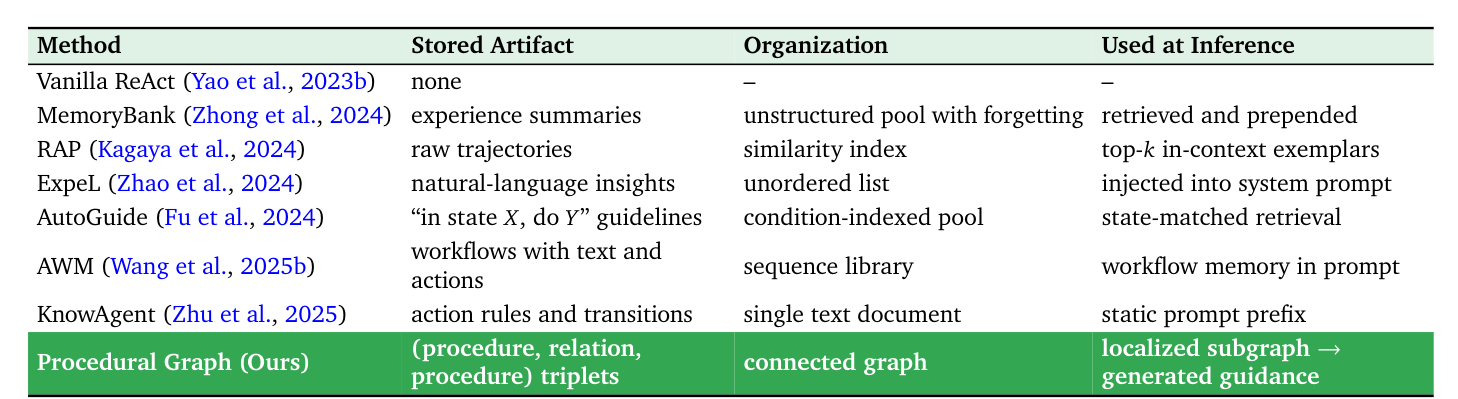
| 方法 | 存什麼 | 推論時怎麼用 |
|---|---|---|
| Vanilla ReAct | 什麼都不存 | 無,這是起點 |
| MemoryBank | 每題的經驗摘要,並依遺忘機制淘汰舊的 | 依相關度(偏重近期)取出,放在 prompt 最前面 |
| RAP | 完整的歷史軌跡 | 找最相似的幾條軌跡,當範例放進 prompt |
| ExpeL | 比對成功與失敗軌跡後,歸納出的自然語言心得 | 心得放進 system prompt,另附取回的成功範例 |
| AutoGuide | 「在狀態 X,做 Y」形式的條件式指引,也是從成功與失敗的對比中抽出 | 每步先概括當前狀態,再取出符合的指引 |
| AWM | 從成功軌跡歸納出的工作流(文字描述加動作序列) | 工作流放進 prompt |
| KnowAgent | 可用動作與「哪個動作後可接哪個」的文字規則 | 整份當固定前綴放進 prompt,每步都一樣 |
和 PG 最近的有兩個:
- AutoGuide: 論文自己說最接近(Appendix A.4)。同樣是「情境對應動作」,也是每步檢索。差別是 AutoGuide 的指引彼此獨立,PG 把它們連成圖。
- KnowAgent: 它存的「動作轉移規則」,概念上就是 PG 的邊,但它是一份靜態文字,沒有圖結構,也不會依當前位置只取一段。
這兩個如果贏過 PG,最值得細看,因為它們最接近 PG 宣稱的新東西。