Resource2Skill:只用教學影片蒸餾的技能庫,就贏過其他三種資源的總和
 Hong-Wei Wu
收錄於 論文介紹
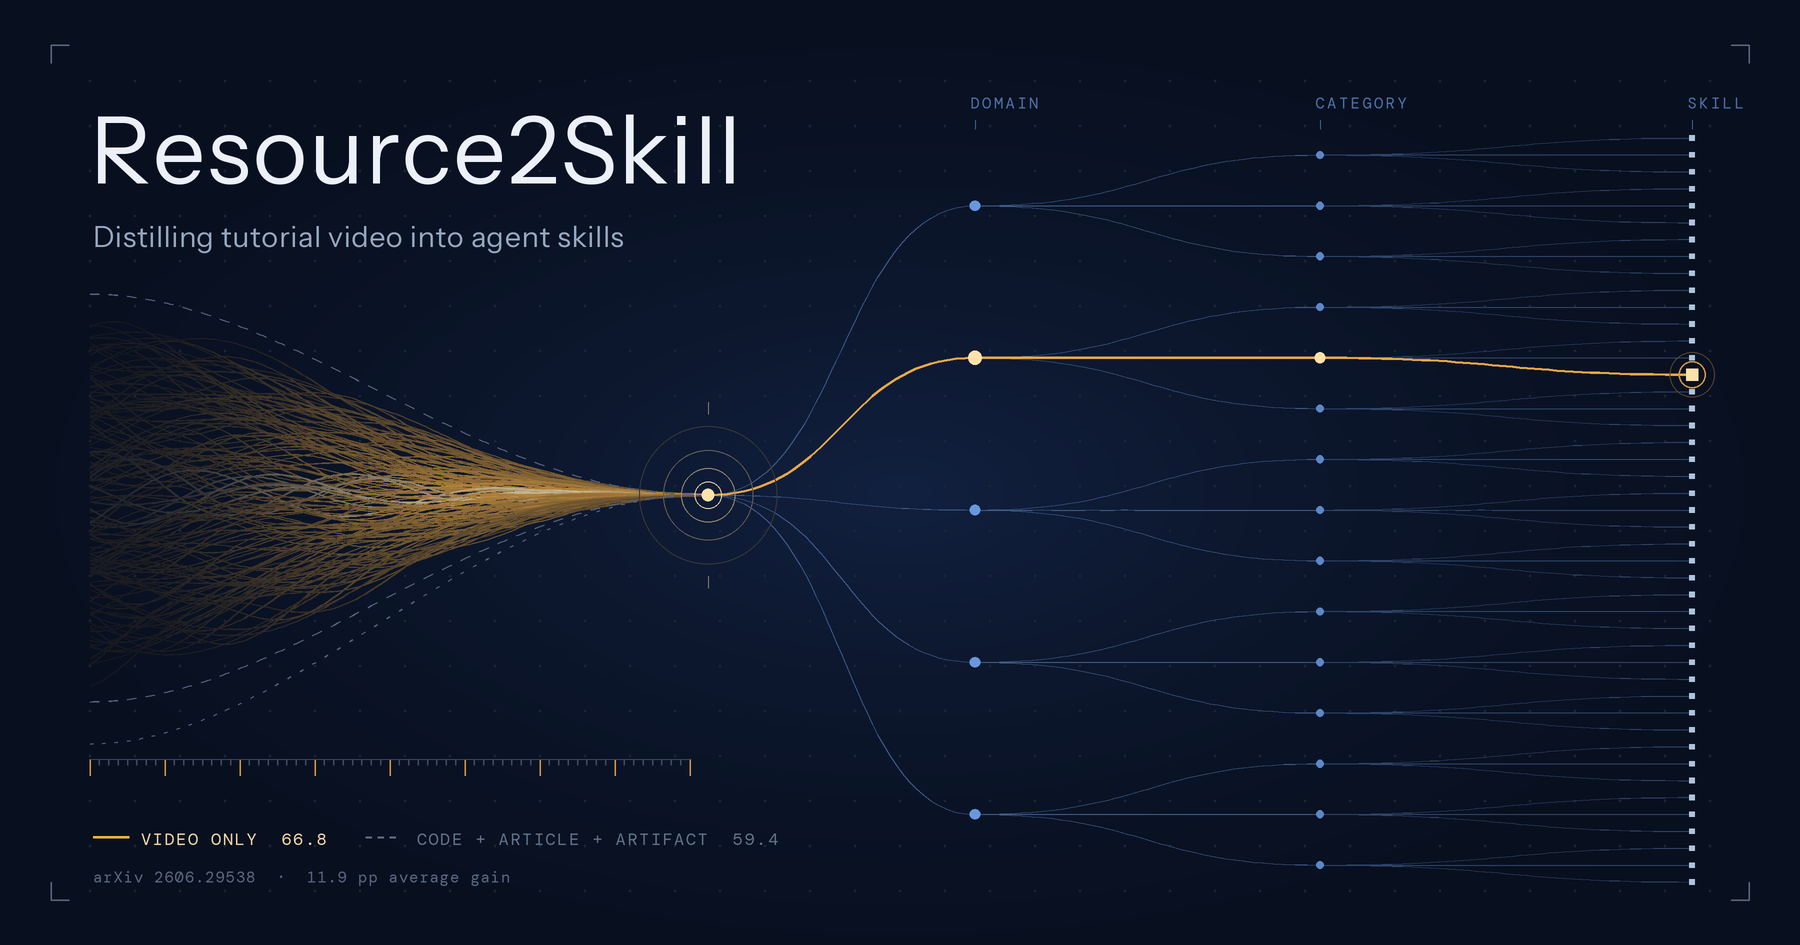
- 做了什麼:Resource2Skill 把教學影片、程式碼庫、文章、參考成品四種資源,自動蒸餾成階層式技能庫(Skill Wiki),在 7 個創作領域、4 個模型上平均提升 11.9 個百分點。
- 最紮實的發現:只用影片蒸餾出的技能庫(平均 66.8%),就贏過不含影片的其他三種資源總和(59.4%);這組資源來源 ablation 是全篇控制最乾淨的實驗。
- 兩個缺口:主結果的對照組完全沒有技能庫,拆不開「方法好」和「有技能庫」;「怎麼從原始資料蒸餾成技能」則寫得非常單薄,無法照抄。
- 最值得帶走的心法:先抓混淆因子、技能庫規模有飽和點(論文量到約 200 個)、別預設向量檢索比詞法檢索強、驗證機制該分層而不是二元丟棄。
1 前言
如果你讓一個 agent 去做投影片、算 Excel、搭 3D 場景這類「創作型」任務,它常常卡住的地方不是不知道事實,而是不知道「該怎麼做」——用哪個工具模式、任務怎麼拆、中間該檢查什麼、出錯了怎麼救。這種程序性知識,現有的技能庫大多靠人工寫,或是從 agent 自己的操作記錄裡挖(例如 SkillOpt、WikiSkill),唯獨「教學影片」——人類學這類軟體操作最自然的素材——幾乎沒被系統性用上。
Resource2Skill(Microsoft Research,arXiv 2606.29538)想解決的就是這件事:把教學影片、程式碼庫、文章、參考成品這四種資源,自動蒸餾成一個 agent 能高效檢索、執行的階層式技能庫(Skill Wiki)。論文在 7 個創作領域、4 個模型上量到平均 11.9 個百分點的提升,也贏過 Claude Code、Codex 這類現成 harness。
先講判斷:這篇論文的研究價值偏低——核心的檢索與選擇機制是既有元件的組合,不是新方法;工程參考價值中低,而且有明顯缺口——系統骨架(schema、驗收流程、執行介面)值得參考,但論文對「怎麼從原始資料蒸餾成技能」這個最關鍵的技術細節寫得非常單薄,沒辦法照抄出一套完整流程。
真正值得留下來的,反而是它用大規模實驗驗證的幾個直覺:技能庫規模有飽和點、純向量檢索不一定比詞法檢索好、驗證程式碼可執行性該分層處理而不是二元丟棄。這篇文章會照論文的方法與結果講一輪,最後也會用完整篇幅整理這些獨立於論文本身也成立的心得——這才是讀完整篇論文後最值得帶走的部分。
2 問題設定
延續前言提到的程序性知識缺口,現有的技能庫來源大致三種:人工手寫、agent 自己操作記錄裡累積出來的、從文字或程式碼資源裡挖出來的。Resource2Skill 指出一個被忽略的來源:教學影片。影片能傳遞操作的時間順序、每一步的視覺效果、難以言傳的設計選擇,這些東西文字很難完整承載;但把整段影片直接塞進 agent 的 context 又太貴太冗長。
論文要解決的核心問題是:怎麼把影片這類高維度多模態資源,自動蒸餾成 agent 可以高效檢索、執行的技能,同時不丟失影片獨有的資訊。
3 核心方法
3.1 技能的資料結構
每個技能是一個四元組加 metadata:
| 符號 | 意義 |
|---|---|
技能在該領域分類樹(taxonomy)裡的路徑,例如 blender/lighting/jewelry | |
| 名稱、機制、適用條件、輸入、預期效果 | |
| 縮圖、截圖、渲染預覽、圖表(可為空) | |
| 可執行或可改寫的程式碼片段(可為空,此時是「純參考型」技能) | |
| metadata:分類、標籤、來源類型、驗證狀態,用於篩選、稽核、追溯 |
為什麼視覺要是一等公民:一般常見的技能庫格式——例如 Anthropic 的 Agent Skills 規範,SKILL.md 加上 scripts/、references/、assets/——圖片、範例通常就丟進泛用的 assets/ 資料夾,跟其他附件在 schema 上沒有區別。
Resource2Skill 把 明確寫進技能定義的核心 tuple,是因為論文的中心論點就是「視覺與時序資訊不能被文字取代」,這個論點後面在資源來源的 ablation(下面的表 3)裡有被驗證。如果你的技能庫格式沒有把視覺當一等公民對待,設計上等於預先假設了視覺資訊不重要——這個假設不一定站得住腳。
有個實務細節值得記下來: 是「用到才解析」的。縮圖平常只是一條路徑引用,只有 agent 主動要求視覺模態時才會被載入成真正的圖片,不計入文字 token 預算。換句話說,擁有視覺內容不必然拉高每次呼叫的成本,這也是為什麼把視覺升級成一等公民在工程上是可行的,不是理想主義。
3.2 跟 Anthropic Agent Skills 格式的對照
如果你的組織已經採用 Anthropic 的 Agent Skills 標準(SKILL.md 內含 YAML frontmatter 加指令,外加 scripts/、references/、assets/),要注意這跟 Resource2Skill 不是同一套邏輯,硬轉換時有些東西會斷掉:
| 能直接搬過去 | 會斷掉、得自己重建的部分 |
|---|---|
→ scripts/ | 「用到才解析、不進文字 token 預算」的機制——Anthropic 標準沒有這個區分 |
→ SKILL.md 內文 | 階層分類樹加兩段式檢索(後面會講)——Anthropic 標準是讓模型自己讀每個技能的 description 判斷相關性,是完全不同的檢索邏輯 |
meta.json → SKILL.md 的 YAML frontmatter | exec_ok 驗收 gate——這不是檔案格式的一部分,是 Resource2Skill 自己的 pipeline 步驟,換了格式這道驗證不會自動存在 |
論文自己在 Related Work 也點名比較過:Anthropic Agent Skills 是「人工撰寫、沒有自動化獲取機制」的技能庫,Resource2Skill 的賣點正是自動蒸餾加影片來源加階層分類。兩者是不同設計哲學下的產物,不是誰取代誰的關係。
3.3 四階段 Pipeline
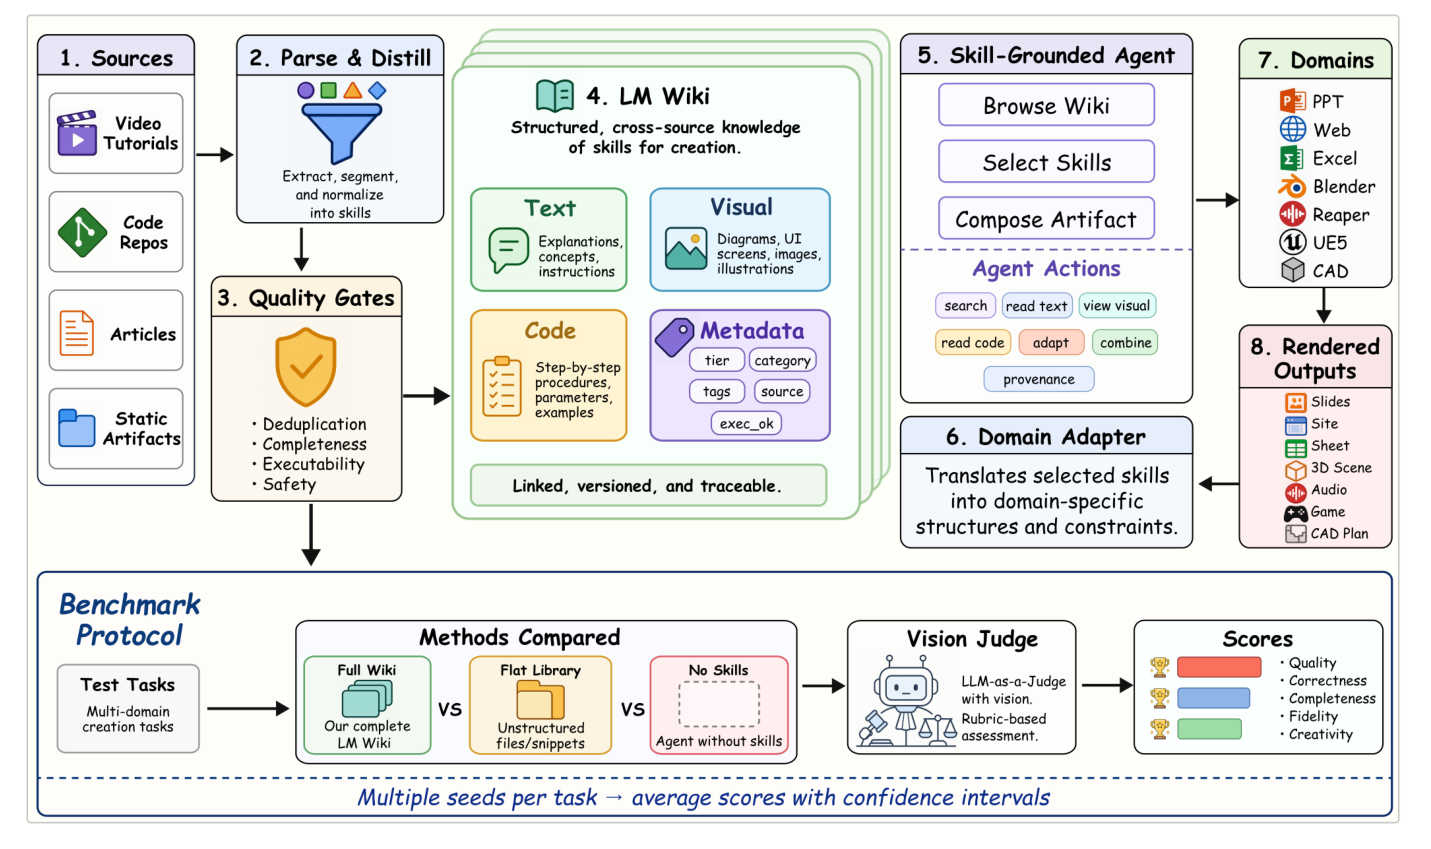
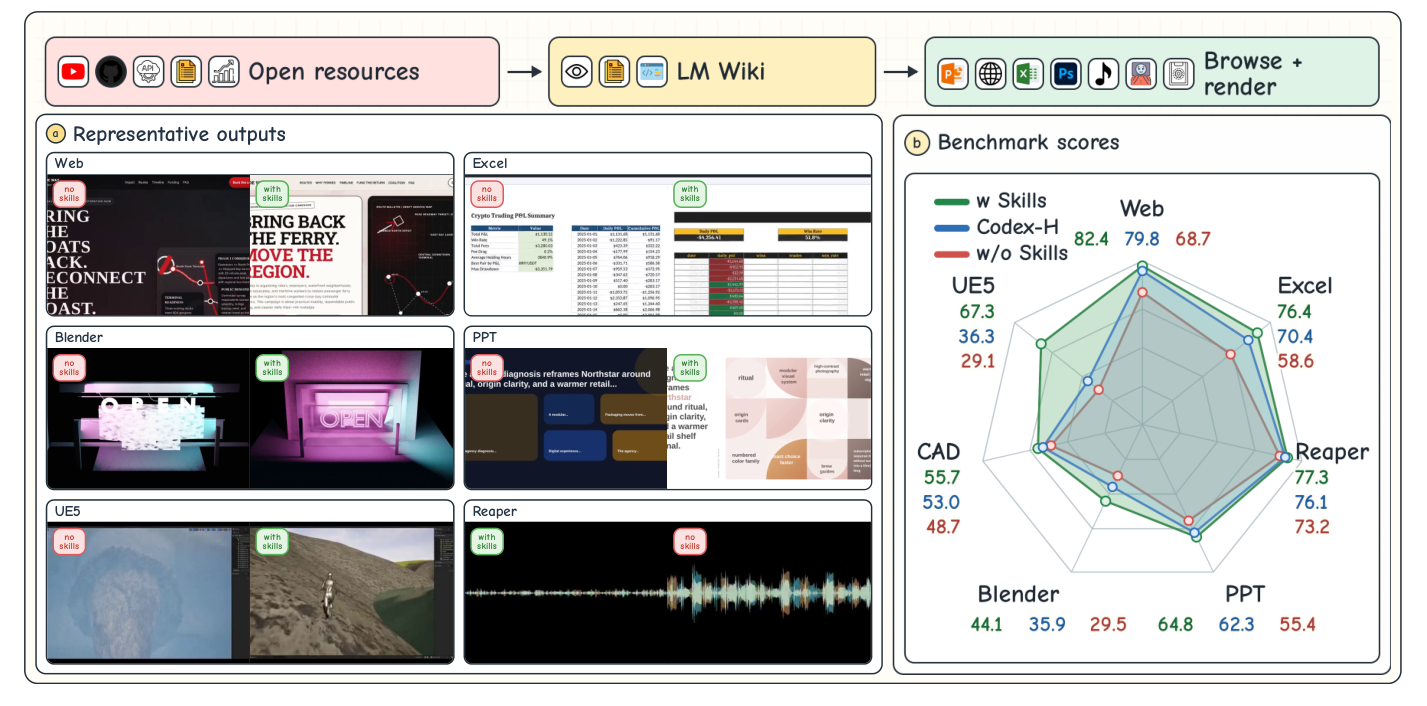
整條 pipeline 分四步:資源蒐集 → 用一次 vision-capable LM 呼叫蒸餾()→ 五道驗收 gate()→ 按分類路徑存入階層式 Wiki。執行時 agent 用 MetaBrowse 兩段式檢索挑技能,透過 MCP 套用到實際的領域軟體;候選池篩不出堪用技能時,同一套 會被即時觸發去補洞。
蒸餾步驟():本質是一次 vision-capable LM 呼叫,前面加確定性前處理——影片抽關鍵幀、程式碼庫用 AST 抓區塊、文章切段落——後面加確定性後處理:正規化輸出格式、算 SHA1 當技能 ID。論文特別強調這一步不是訓練過的模型,就是 prompt engineering 加結構化輸出。
五道驗收 gate:全部是確定性規則檢查,不是 LLM-as-judge,各自檢驗技能 tuple 裡不同的元素:
| Gate | 檢驗對象 | 檢查什麼 |
|---|---|---|
| Completeness(完整性) | 、 | frontmatter 必填欄位、 最短長度、至少一個模態非空 |
| Provenance(來源) | source_path 是否指向 connector manifest 裡真實記錄過的資源 | |
| Deduplication(去重) | SHA1(domain, source_path, node_index) 當技能 ID,撞到既有 ID 就併入既有條目 | |
| Modality consistency(模態一致) | 對 、 | 宣稱有的模態,硬碟上是否真的存在對應檔案 |
| Structural executability(可執行性) | sandbox 實際跑一次程式碼,能不能執行、有沒有產出非平凡結果 |
這五道 gate 裡最值得記住的設計,是 executability 沒過的處理方式——不是直接丟棄,而是降級成「reference-only」。程式碼沒驗證過,agent 就不會直接拿去執行(避免在正式環境跑未驗證的程式碼),但 、 描述的原理跟效果仍然可用,agent 可以照著描述自己重寫程式碼。這個設計把「這段程式碼可信嗎」跟「這個知識有沒有價值」拆成兩個獨立判斷,而不是用單一二元開關(合格/丟棄)粗暴處理。
如果你要幫自己的技能庫(例如 Anthropic Skills 格式裡的 scripts/)加驗證機制,這是一個成本不高、值得直接套用的思路:對每個技能的 script 跑一次輕量 smoke test,通過的照常執行,沒通過的在 SKILL.md 裡註明「僅供參考」,讓 agent 退回自己讀說明重寫程式碼,而不是整個技能被丟棄或帶著不可靠的程式碼硬跑。
執行階段:apply 是唯一的執行動作,透過 MCP 把選中的技能程式碼送進真正在跑的領域軟體(例如 Blender headless)執行,背後接一份「capabilities manifest」,不支援的操作會回傳結構化的「做不到」訊息,而不是直接報錯。render 則是把領域軟體實際產出的東西轉成 judge 看得懂的格式——截圖、渲染圖、音檔。judge 全程只看 render 出來的成品,不看原始檔案或程式碼,所以就算程式碼邏輯正確,只要渲染結果視覺上不理想,分數還是會被扣。
線上補洞(Online acquisition):當檢索篩不出堪用候選時,同一套 會被即時呼叫,去搜資源、蒸餾、驗收,結果存進一個獨立的「online pool」,不會併回離線 wiki——這是刻意的實驗控制,避免線上搜尋讓離線庫越用越大、混淆其他實驗對照。
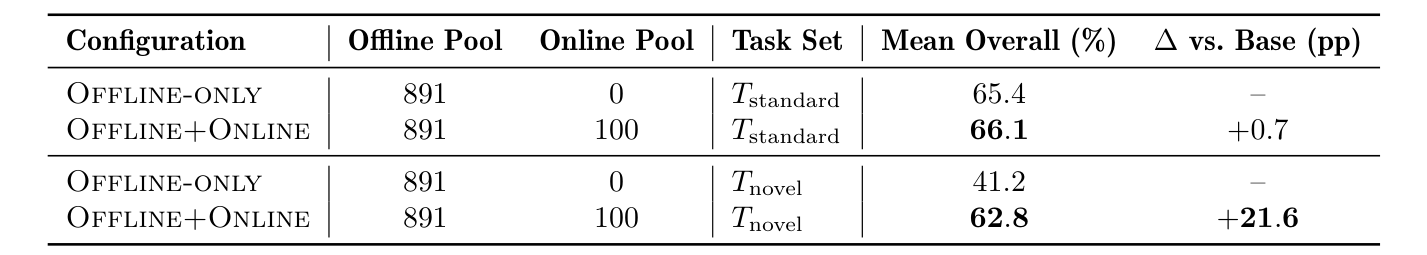
量化效果上(表 2):在標準任務集 上開啟線上補洞幾乎沒差(+0.7pp),但在專門設計來測「離線庫覆蓋不到」的任務集 上,同樣 100 個線上技能能把分數從 41.2% 拉到 62.8%(+21.6pp)。論文的結論是:線上搜尋是「補洞用」,不是「日常加分用」——如果你的離線庫已經覆蓋得夠好,指望線上補洞帶來額外提升不切實際;但當使用者真的碰到庫裡沒有的場景,這條路能救回超過 20 個百分點的表現。
3.4 技能檢索與選擇:MetaBrowse 兩段式
第一階段(詞法篩選,縮小候選池):
其中 是使用者的任務需求, 是該領域完整技能庫, 是字串串接——把技能的名稱、標籤、適用條件、分類路徑 全部接起來當一份文件跟 比對, 在論文設定裡是 20。
關鍵設計是把分類路徑 也塞進比對文字裡,讓「技能在分類樹上的位置」直接影響詞法分數,論文原話是希望讓技能庫「favour skills sitting in topically relevant subtrees」,而不是把整個 wiki 當一堆散裝技能做全庫比對。舉個例子:query 是「render a jewelry ring with dramatic lighting」,一個路徑是 blender/lighting/jewelry-macro 的技能,光是路徑裡的「lighting」「jewelry」就會跟 query 有詞頻重疊、貢獻分數;路徑是 blender/geometry/procedural-terrain 的技能則幾乎沒有重疊,連進候選池的機會都低。
第二階段(語言模型選子集):
是語言模型本身,不是專門訓練過的選擇器; 是技能 依目前設定暴露的內容(metadata 加上開放的文字、視覺、程式碼視圖);實際選出的技能數量 。這一步是「選子集」而不是「排序取 top-」——語言模型可以選 0 個技能,讓 agent 退回自己寫程式碼。這跟一般推薦系統的 top-K 排序不太一樣:選擇器有「全部拒絕」的權力。
這個兩段式設計背後有一個反直覺的實驗結果:後面「其他 Ablation」一節會用表 5 的實際數字說明,純向量檢索在這個任務上表現反而比純詞法檢索還差。
4 主結果與一個關鍵盲點
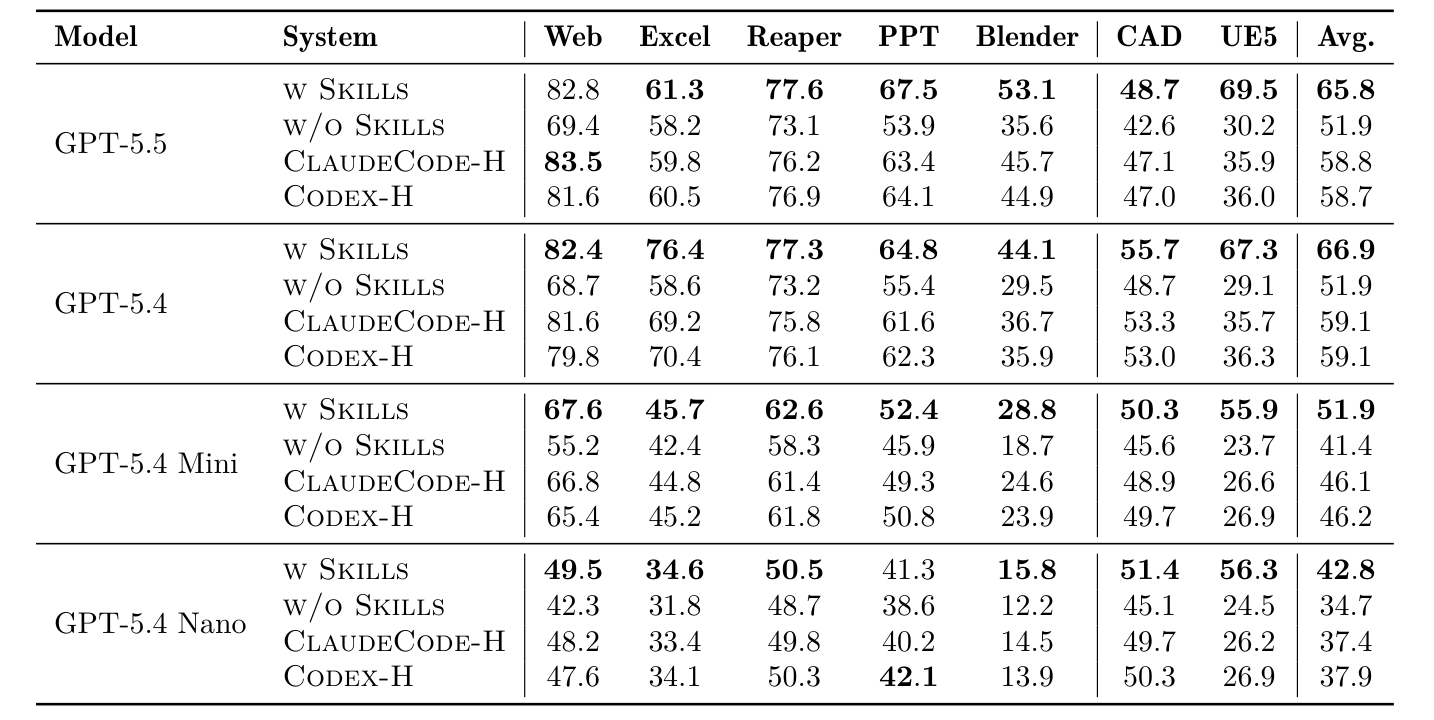
| 系統 | Web | Excel | Reaper | PPT | Blender | CAD | UE5 | 平均 |
|---|---|---|---|---|---|---|---|---|
| w Skills | 82.4 | 76.4 | 77.3 | 64.8 | 44.1 | 55.7 | 67.3 | 66.9 |
| w/o Skills | 68.7 | 58.6 | 73.2 | 55.4 | 29.5 | 48.7 | 29.1 | 51.9 |
| ClaudeCode-H | 81.6 | 69.2 | 75.8 | 61.6 | 36.7 | 53.3 | 35.7 | 59.1 |
| Codex-H | 79.8 | 70.4 | 76.1 | 62.3 | 35.9 | 53.0 | 36.3 | 59.1 |
跨 28 個 model-domain cell,w Skills 全數贏過 w/o Skills,配對 Wilcoxon 檢定在抽樣的 9 個 cell 全部 (多數 ),統計上站得住腳。w Skills 也在 26/28 個 cell 贏過兩個 harness 裡較強的那個,UE5 領域增益最大(+30~40pp)——論文的解讀是 free-form code agent 很難靠 UE5 Python API 從零組出及格場景,常直接掉到最低品質門檻以下算 0 分。
這裡有個很現實的盲點:贏的到底是 Resource2Skill 這套 pipeline 設計本身,還是單純「有沒有技能庫」這個更粗的變因,論文的實驗設計拆不開。ClaudeCode-H、Codex-H 這兩個對照組,論文自己在附錄 C 明講完全沒有掛載 Skill Wiki,也不能上網搜尋(Codex-H 甚至被設定成 web search to cached,連即時瀏覽都關掉),是純粹用通用 harness 硬做。也就是說表 1 比的其實是「有技能庫」對「完全沒有技能庫、也不准自己去找」,兩者除了技能庫之外的能力落差沒有被拆開。
論文另外有一組實驗(4.3.1 節,Flat 對照 Our Wiki 對照 w/o Skills)某種程度上回應了這個問題:Flat 條件是把技能內容做成純文字、無結構的扁平清單,拿掉分類瀏覽、metadata 篩選、視覺、程式碼。三者的分數關係如下:
w/o Skills:平均 51.9%(見表 1)Flat(純文字扁平清單):比w/o Skills高一截,落在Our Wiki往下 2.5~8.2pp 的區間,約 58.7~64.4%Our Wiki(完整階層式多模態):平均 66.9%(見表 1「w Skills」列)
這代表技能庫的「組織形式」(階層多模態對扁平文字)貢獻沒有想像中大,大部分增益來自「有沒有技能庫」這個更粗的變因。
但要注意,Flat 條件裡的技能內容仍然是用 Resource2Skill 自己的蒸餾方法產生的,只是呈現形式改了。也就是說論文測了「組織形式的貢獻」,但完全沒測「蒸餾方法本身的品質貢獻」——換一個更陽春的蒸餾方式,甚至人工寫的技能庫,最終效果會不會一樣好,這個問題從頭到尾沒被觸碰,是這篇論文在方法論上最大的 validity 缺口。
5 Ablation:資源來源混合(全篇最紮實的實驗)
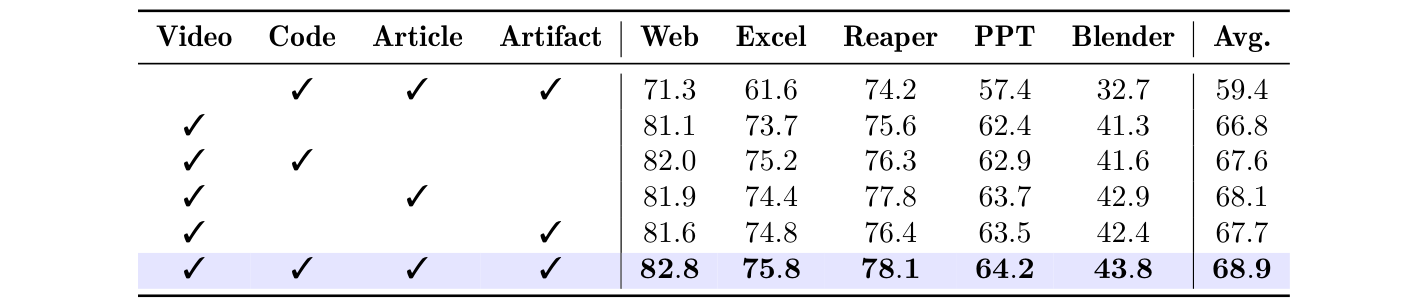
固定其他一切,只改變蒐集資源時用了哪些來源家族:
| 來源組合 | Web | Excel | Reaper | PPT | Blender | 平均 |
|---|---|---|---|---|---|---|
| Code + Article + Artifact(不含影片) | 71.3 | 61.6 | 74.2 | 57.4 | 32.7 | 59.4 |
| 只有 Video | 81.1 | 73.7 | 75.6 | 62.4 | 41.3 | 66.8 |
| Video + Code | 82.0 | 75.2 | 76.3 | 62.9 | 41.6 | 67.6 |
| Video + Article | 81.9 | 74.4 | 77.8 | 63.7 | 42.9 | 68.1 |
| Video + Artifact | 81.6 | 74.8 | 76.4 | 63.5 | 42.4 | 67.7 |
| 全部四種 | 82.8 | 75.8 | 78.1 | 64.2 | 43.8 | 68.9 |
拿掉影片,平均分從 68.9% 掉到 59.4%,掉了近 10 個百分點;更值得注意的是只用影片(不含其他三種來源)反而還贏過「其他三種來源加起來但不含影片」7.4 個百分點——影片單獨的貢獻比其他三種來源加起來還大。下降最兇的是 Excel(−14.2pp)跟 Web(−11.5pp),論文的解讀是這些領域的操作順序、畫面變化,文字難以完整承載。這是一組控制得比較乾淨的實驗,只換一個變因(資源來源),其他全部固定,是全篇最能站得住腳的發現。
6 技能庫規模:報酬遞減
固定 agent、judge、brief、wiki 介面,讓技能庫大小從 0 一路長到完整規模,測 5 個核心領域,得到的曲線很乾脆:表現隨技能庫變大單調上升,大約在200 個技能左右飽和——0 到 200 這段吃掉大部分增益(Reaper 只漲 +3.1pp,Excel 漲最多 +14.2pp),200 之後曲線變平,400 到 Full 每個領域最多再漲 +0.8pp。各領域完整規模(Full)的最終分數:Web 82.4、Excel 76.4、Reaper 77.3、PPT 64.8、Blender 44.1。
這個「存在飽和點、早期報酬遞減」的現象本身,是一個可以直接搬走的判斷框架:不需要一開始就想著蒐集海量資源、蒸餾出上千個技能才能上線,先求覆蓋核心常見操作的技能——論文的數字是「前 200 個」——性價比遠高於持續擴充長尾。但「200」這個具體數字不能直接套用到你自己的情境,這是這篇論文在 7 個特定軟體創作領域、用他們自己的分類方式量出來的數字,換到不同性質的資料(例如企業內部知識),飽和點會落在哪裡完全未知,只能借用「存在報酬遞減」這個定性觀念,不能借用具體數字。
7 其他 Ablation
還有兩組 ablation 論文做得比較簡短,但同樣值得放進來對照。
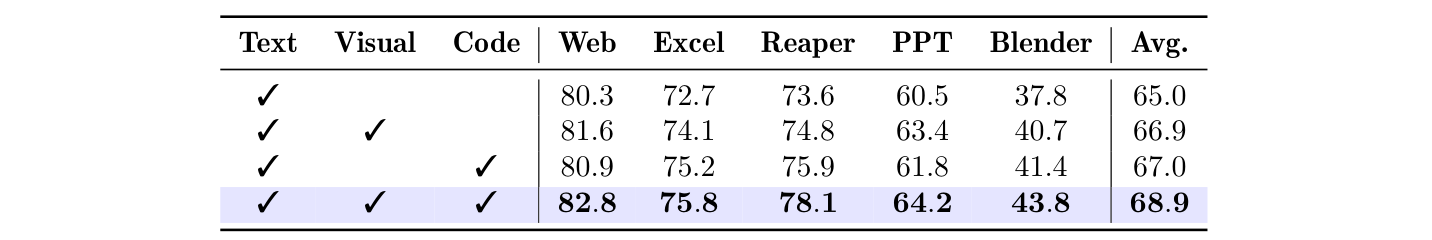
表 4(matched-budget representation ablation):固定資源池、技能 ID、metadata、檢索預算,只換「post-retrieval 讓 agent 看到哪些模態」。Text-only 65.0% → 加 Visual 66.9%(+1.9pp)→ Text + Code 67.0%(+2.0pp)→ 三者全給 68.9%。結論是多模態內容確實有貢獻,但單一模態的增量不算誇張(各約 2pp),大部分基礎價值還是來自文字。
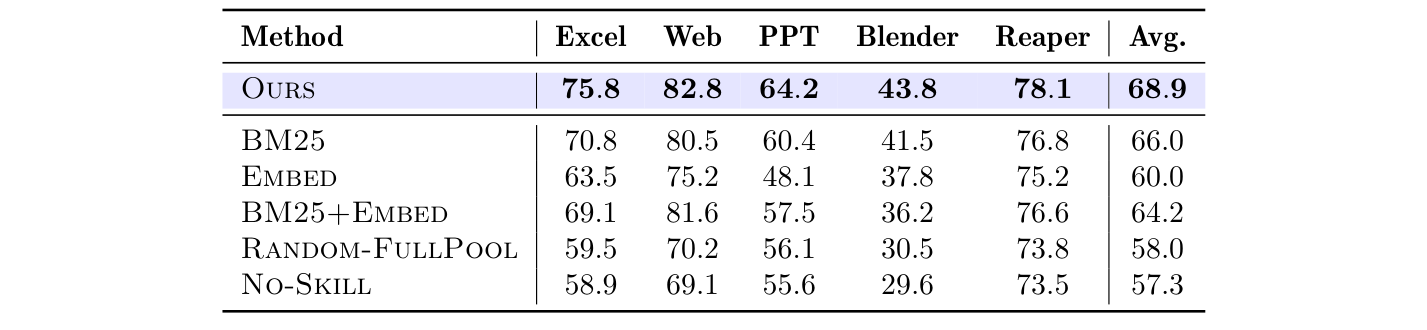
表 5(selection strategy ablation):固定技能庫、agent、judge、候選預算,只換挑技能的策略:Ours(hierarchy-then-LM)68.9% > BM25 66.0% > BM25+Embed 64.2% > Embed 60.0% > Random-FullPool 58.0% > No-Skill 57.3%。純向量檢索(Embed)是六種策略裡表現最差的之一,比純 BM25 還差——這就是前面「技能檢索與選擇」一節提到的反直覺結果:別預設 dense retrieval 天生比 lexical retrieval 好,技能跟任務之間的適配度,有時候不是純語意相似度能抓到的,需要一層額外的判斷(不管是語言模型還是規則)去把關組合性與互補性。
8 獨立於論文本身也成立的東西
這篇論文的核心方法沒什麼新意,但讀的過程中會不斷撞見幾個值得記住的判斷框架——它們不依賴 Resource2Skill 這個系統本身是否成功,換一篇論文、換一個場景照樣成立。這一節把它們獨立整理出來,是這篇筆記真正該精讀的部分。
8.1 論文本身的貢獻:幾乎接近零
核心的檢索與選擇機制是既有元件的組合,不是新方法;唯一算得上發現的「影片不可替代」(「Ablation:資源來源混合」一節的表 3),控制變因不夠乾淨(資源數量未控制),說服力有限。論文的骨架——schema、五道驗收 gate、MCP 執行介面——作為系統設計的參考範例有一定價值,但最關鍵的「怎麼蒸餾」技術細節寫得極度單薄,無法直接照抄。
8.2 心法一:先問清楚有沒有控制住混淆因子
評估任何「A 系統 vs B 系統」的比較時,先問清楚兩者除了你關心的那個變因之外,是不是還有別的東西沒被控制住。前面「主結果與一個關鍵盲點」一節的表 1 就是一個活教材:ClaudeCode-H、Codex-H 完全沒有技能庫,這個對照本身就沒有回答「Resource2Skill 設計得好不好」這個問題,只回答了「有沒有技能庫」這個更粗的問題。下次看到類似的系統對比評測,先確認被比較的兩邊除了「你關心的那個設計」之外,是不是真的只差那一個變因。
8.3 心法二:技能庫規模存在飽和點,早期報酬遞減
建自己的技能庫時,優先覆蓋核心常見場景,不要一開始就追求大而全的覆蓋率。具體飽和的技能數量因情境而異,不能照搬論文的「200」這個數字,但「早期報酬遞減、存在飽和點」這個定性判斷可以直接借用——先求覆蓋核心操作,再考慮擴充長尾。
8.4 心法三:別預設向量檢索天生比詞法檢索聰明
論文比較六種選技能策略,純向量檢索(Embed)反而是表現最差的之一,比純 BM25 還差;論文自己的兩段式 hierarchy-then-LM 方法拿到最高分。技能跟任務之間的「適配度」有時候不是純語意相似度能抓到的,需要一層額外判斷(不管是語言模型還是規則)去把關組合性與互補性——設計檢索系統時,dense retrieval 不該是預設的正確答案。
8.5 心法四:驗證機制要分層設計,不要二元丟棄
「這段程式碼可信嗎」跟「這個知識本身有沒有價值」是兩個獨立的判斷。程式碼驗證沒過,不代表整個技能條目沒用,可以降級成「參考用」而保留其說明與範例,讓 agent 自己重新產生程式碼。這個思路可以直接套用到任何技能庫(包含 Anthropic Agent Skills 格式)裡的 scripts/ 驗證機制上:跑一個輕量 smoke test,通過的照常用,沒通過的在說明檔裡標註「僅供參考」,而不是整個技能被丟棄或帶著不可靠的程式碼硬跑。
9 結論
Resource2Skill 想解決的問題很實際:軟體 agent 缺的是程序性知識,而教學影片是現有技能庫幾乎沒用上的資訊來源。論文用大規模實驗證明了影片確實有不可替代的貢獻(表 3),也交出一套系統骨架——四元組 schema、五道驗收 gate、兩段式檢索——但最關鍵的「怎麼蒸餾」技術細節寫得很單薄,照抄不出完整流程;主結果(表 1)的對照組設計也留下「贏的是方法還是有沒有技能庫」這個沒拆開的盲點。
真正該帶走的,不是這篇論文的方法本身,而是過程中驗證出來的四個判斷框架:評估系統對比時先抓混淆因子、技能庫規模有飽和點別一開始就求大而全、別預設向量檢索天生比詞法檢索聰明、驗證機制該分層而不是二元丟棄。這幾點脫離 Resource2Skill 這個系統本身依然成立,也是這篇論文除了「影片是有用的資源」之外,最耐用的部分。