會自我進化的 AI Agent,只是在背考題?Google RRSI 的護欄設計
 Hong-Wei Wu
收錄於 論文介紹
1 前言
讓一個 LLM 自動修改 agent 的 harness(模型以外的提示詞、控制流程、工具介面、記憶與 context 管理),再用任務分數當回饋反覆迭代,是這一兩年很熱門的做法。問題是每一輪都拿同一批有限的題目評分,進化用題目的分數會一路上升,換到沒看過的 benchmark,進步卻縮水甚至消失。
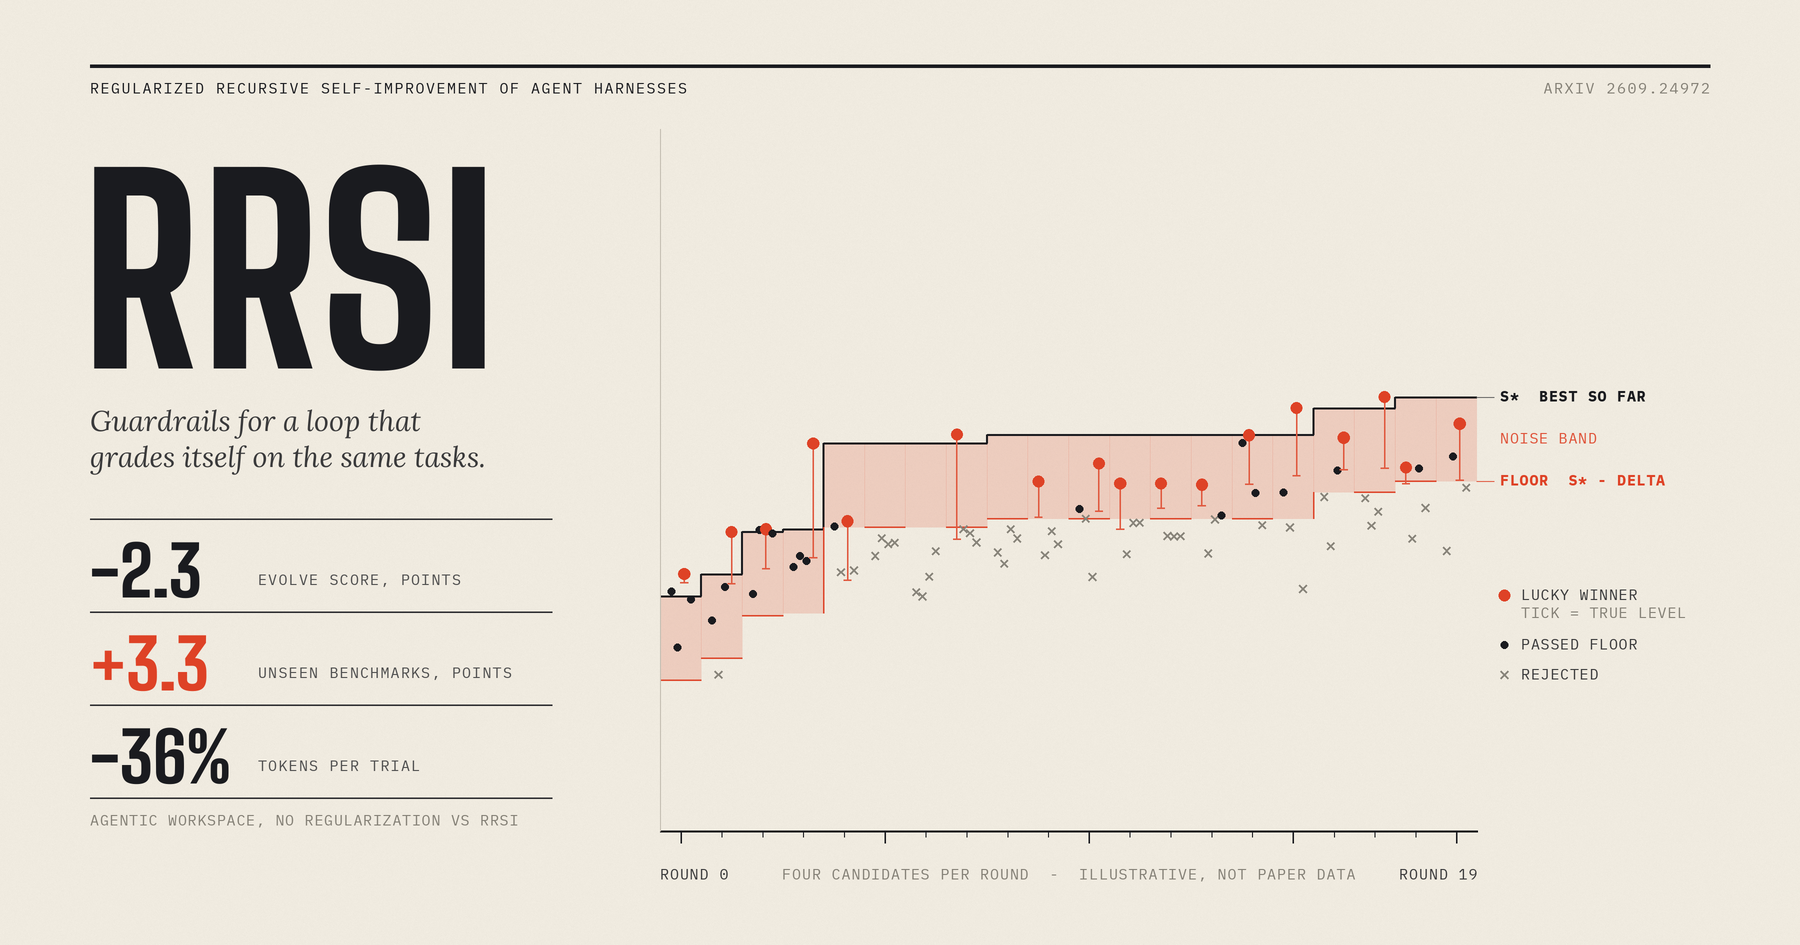
Google Cloud AI Research 的 RRSI(Regularized Recursive Self-Improvement of Agent Harnesses,arXiv 2609.24972v2)想管住這件事。它不限制 harness 能改什麼,而是管「怎麼提出修改」和「哪些修改可以被留下」,用一整包規則降低過擬合。
這篇文章分成兩塊。前半依論文順序講問題、方法、實驗與評價,我的判斷是研究價值偏低,工程參考價值中等偏上。後半是九個延伸概念。其中適應性資料重用、贏家詛咒、L0 / L1 / L2 正則化、雜訊帶等脫離這篇論文也成立,是我覺得最值得留下來的部分,其餘幾個則是這篇論文留下的疑點。
只有五分鐘的話,讀「整體評價」加「結論」。想理解方法,讀到「篩選端」為止。想判斷這篇論文值不值得信,看「實驗與結果」和「整體評價」。
閱讀標記:「自編例子」是論文沒有的數字或情境,我為了說明機制自己編的。「推論」是我的判斷,論文沒有這樣寫。「論文未說明」是論文沒交代的細節,這裡不替它補。
2 問題:Harness 自動進化為什麼會過擬合
讓 LLM 自動改進 harness,看起來是個穩定進步的迴圈,但它有個結構性缺陷:每一輪的決策都在重複使用同一批有限的題目,所以進步可能只是在背這批題目。
2.1 Agent、harness 與「進化」
論文把 agent 拆成兩塊:權重完全不動的 backbone 模型,加上包在外面的 harness。Harness 指模型以外的所有東西:
- system prompt 與任務 prompt
- 控制流程:什麼時候該規劃、行動、反思或停止
- 工具介面與工具說明
- 記憶與 skill 檔案
- context management:每一步要讓模型看到什麼
同一個模型,harness 設計得好不好,決定它會不會先讀檔案再編輯、指令失敗後能不能復原、context 會不會塞爆、最後有沒有把結果寫進交付物。過去這些都靠工程師人工檢視失敗紀錄再手動調整,進度受限於工程師一天能讀多少紀錄。
Harness evolution(harness 進化) 就是把這個人工迴圈自動化:讓另一個 LLM(稱為 proposer)讀失敗紀錄、提出修改,再用任務分數挑選。因為每一輪都是用「目前的系統」產生的回饋去改善「下一版系統」,論文把它稱為 agent 系統層級的 RSI(recursive self-improvement,遞迴式自我改善),只是改的是 harness,不是模型權重。
一輪進化的流程如下:
- 目前的 harness 在 evolve set(進化用題目集)上執行。
- 產生 trajectories(每題一次完整的執行紀錄),整理成失敗回饋 (由一個獨立的 analyst LLM 負責整理)。
- proposer 根據 產生幾個候選 harness。
- 候選們在同一個 evolve set 上重新評分。
- 在「候選加上原本的 」裡挑分數最高的,成為下一輪的 ,回到第 1 步。
寫成式子(論文 Eq. 2):
- :第 輪在位的 harness。
- (花體 H):這一輪 proposer 產生的候選集合。
- :沒有任何限制的提案分布,也就是 proposer 想怎麼改就怎麼改。
- :這一輪的失敗回饋(後面「延伸」的概念五會細講它是什麼)。
- :實測分數。帽子表示只跑了有限次,帶有隨機雜訊。
- :找出讓後面的值最大的那個候選,回傳的是候選本身,不是分數。
注意 的範圍包含 自己:如果沒有任何候選比現在的好, 留任,這一輪什麼都不改。
2.2 核心問題:適應性過擬合
上面第 1 到 4 步一直重複使用同一個 evolve set,而且下一輪要改什麼,取決於前幾輪在同一批題目上量到的結果。這在統計上叫 adaptive data reuse(適應性資料重用):這批題目不再是獨立的檢驗資料,而是被搜尋過程一步步「看過」的資料。結果是 evolve set 的分數一直漲,換到沒看過的任務,進步大幅縮水,甚至比什麼都沒改的原始 harness(記作 )還差。簡單說,每一輪的決定都建立在這批題目的結果上,這批題目的分數就不再可信,原理在文末的概念一。
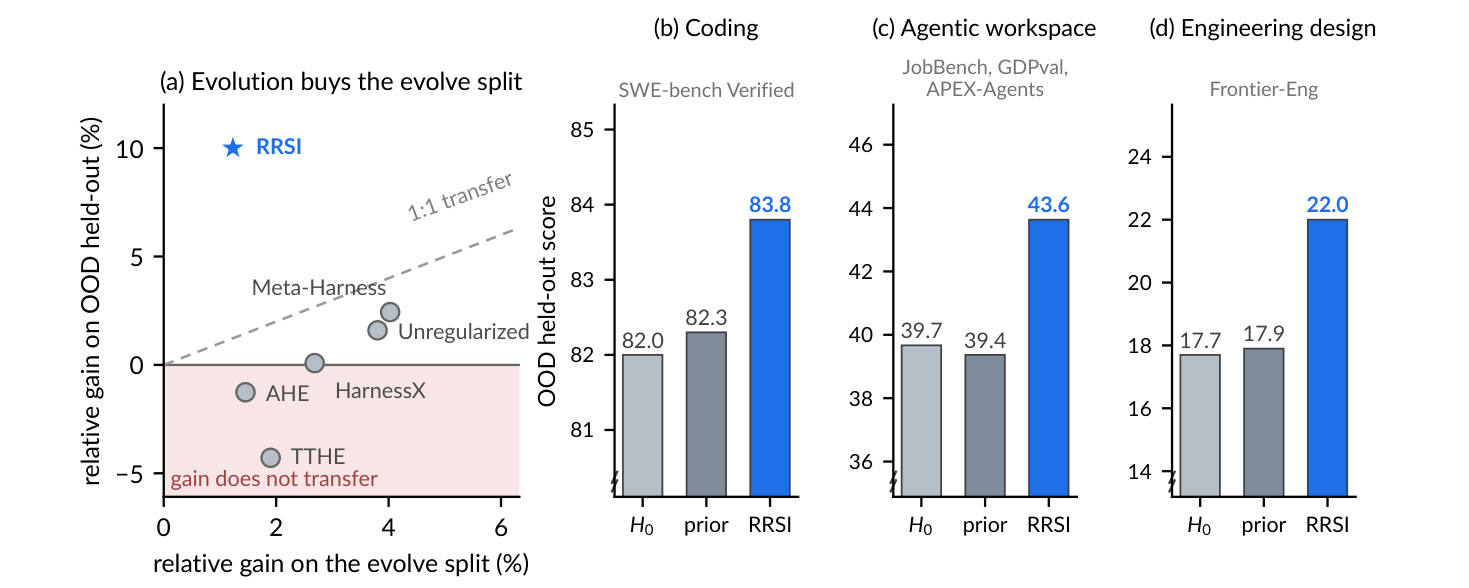
圖 1 有多個子圖,這裡看(a),是 agentic workspace 任務的結果;coding 與 engineering 的「四個對手平均」放在(b)、(d)。橫軸是在 evolve 題目上的相對進步,縱軸是在沒看過的 benchmark(OOD)上的相對進步,圖上有一條「1:1 transfer」的對角線,代表進步能完整搬過去。四個既有方法(Meta-Harness、AHE、TTHE、HarnessX)都落在線的下方,有的縱軸甚至是負的(圖上標示 “gain does not transfer”),只有 RRSI 落在上方。
2.3 三個造成過擬合的行為
論文歸納出三個互相耦合的行為,合起來把「evolve 分數」和「換題目後的分數」之間的差距越拉越大。這三個行為剛好對應後面的護欄:
| 行為 | 白話 | 自編例子 | 對應的護欄 |
|---|---|---|---|
| benchmark-specific fitting(針對特定 benchmark 的擬合) | 修改內容直接記住了這批題目的特徵 | 某題失敗是因為公司名稱格式不對,proposer 就在 prompt 裡加一句「遇到 Acme 公司的報表要用 YY 格式」。evolve 分數上升,換一批題目完全派不上用場 | D(leakage screening) |
| noise chasing(追逐雜訊) | 選中的候選只是這次評分運氣好 | 4 個候選真實實力都是 90.0,各自量到 89.7、90.4、89.9、90.1,挑最高的 90.4,看起來進步 0.4,其實一分都沒進步 | E(分數底線)、雜訊帶 |
| complexity accumulation(複雜度累積) | 越改越肥,分數靠多花運算換來,不是靠更好的機制 | 表 2 裡沒有任何正則化的進化:evolve 分數最高,token 卻是原始 harness 的 2.4 倍 | F(成本規則)、G(結構剪枝) |
兩個提醒。第一,這三個行為在概念上分得很清楚,實務上很可能同時發生在同一個修改上(推論:例如一個寫死題目特徵的修改,同時也讓 prompt 變長)。第二,論文只用一小段文字介紹這三個行為,沒有各自做實驗量出它們各佔多少,後面的 ablation 是把整組正則化一起拿掉。
2.4 後面會用到的名詞
- evolve set:進化過程中被反覆用來評分的題目集。
- ID held-out(in-distribution held-out):同一個 benchmark 裡,進化時沒用到的題目。
- OOD(out-of-distribution):進化時完全沒看過的 benchmark。
- policy:實際執行任務的那個模型。論文主實驗的 policy 固定為 Claude Opus 4.8。
- trajectory:agent 執行一題任務的完整紀錄,包含每一步的推理、工具呼叫與結果。
3 RRSI 方法總覽
RRSI 完全不縮小 harness 能改的範圍,它只管兩件事:proposer 怎麼提出修改(提案端),以及哪些量到的進步可以變成永久狀態(篩選端)。
3.1 用 code review 的流程來理解
把 harness 想成一個 repo,把每一輪進化想成一次 PR 流程:
- 不限制可修改範圍:repo 裡任何檔案都可以動,prompt、工具、記憶、控制流程、subagent 都允許改。論文用 代表「從 出發,改任意原始碼所能到達的所有 harness」,並刻意讓它保持開放。
- 提案端是對「怎麼提 PR」的規範:一個 PR 最多改幾件事(A)、提之前要看過去被退回的紀錄(B)、很久沒進展時要去動沒碰過的模組(C)。
- 篩選端是 merge 的關卡:CI 分數變高還不夠,還要沒有寫死測試答案(D)、不是 flaky test 運氣好(E)、沒有讓 build 時間暴增卻沒換到對等效益(F)。
- 永久狀態就是 merge 進 main:被選中的 會成為下一輪所有提案的起點,選錯一次,錯誤會疊在後面每一輪。
這個比喻有個不成立的地方:真實的 code review 有獨立的人和獨立的測試,而 RRSI 的「CI」就是同一批 evolve set 的評分,這批評分本身有雜訊,還會被反覆使用。所以 D、E、F 只是補洞,不能取代獨立的驗證(推論)。
3.2 七個零件
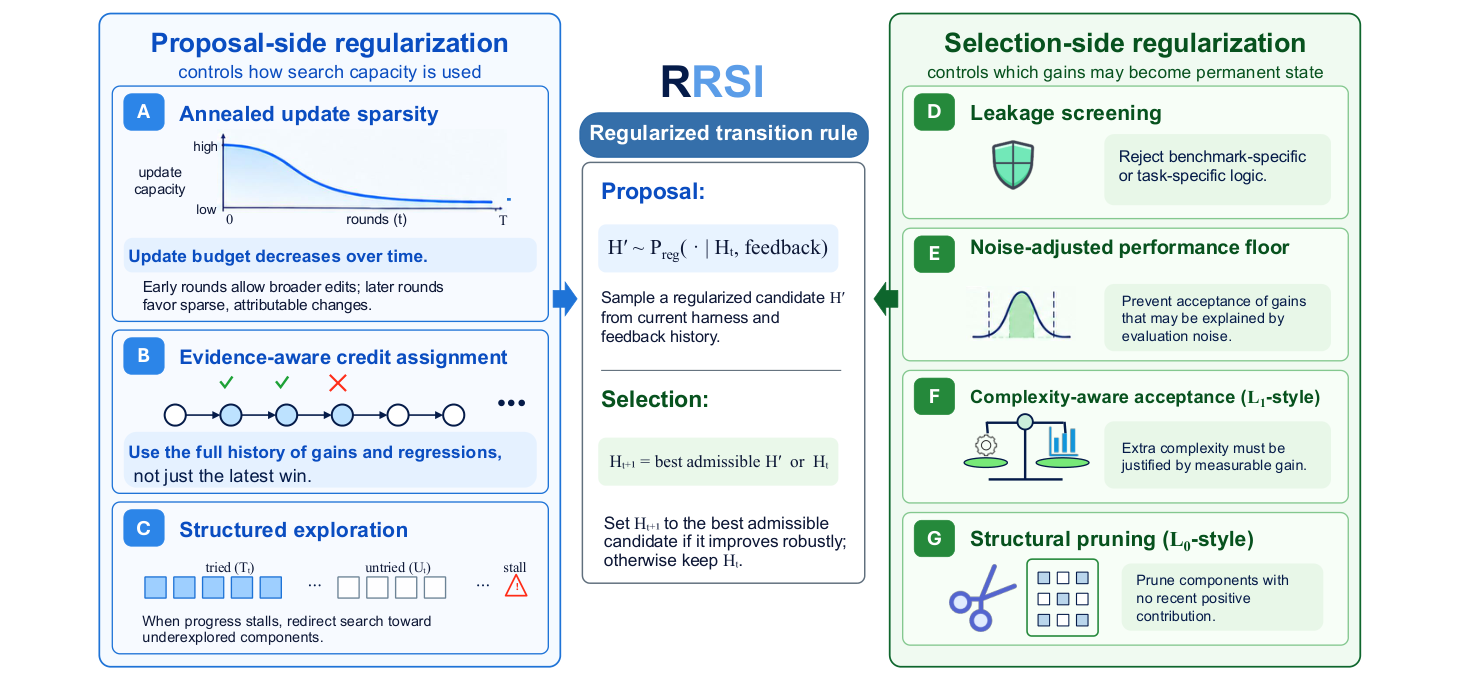
| 代號 | 名稱 | 在做什麼 | 對付的問題 |
|---|---|---|---|
| A | annealed update sparsity(退火式更新稀疏) | 限制一個候選最多綁幾個修改,隨輪數遞減 | 綁太多修改,容量高又難歸因 |
| B | evidence-aware credit assignment(證據感知的功勞分配) | 記錄每個修改的結果,之後提案要參考 | 不要一直重試已被否定的點子 |
| C | structured exploration(結構化探索) | 進度停滯時,保留名額給沒試過的元件類別 | 提案集中在同一類修改(例如一直改 prompt) |
| D | leakage screening(洩漏篩檢) | 評分前由 critic(負責審查的 LLM)讀修改內容,擋寫死題目資訊的修改 | benchmark-specific fitting |
| E | noise-adjusted performance floor(雜訊校正的分數底線) | 候選分數要 歷史最高分 | noise chasing(實際擋的是連續小退步,見概念四) |
| F | complexity-aware acceptance(複雜度感知接受) | 多花的 token 要用分數進步來換 | complexity accumulation |
| G | structural pruning(結構剪枝) | 一段時間沒有正貢獻的元件,列為刪除目標 | complexity accumulation |
D 到 G 與三個行為的對應,是論文在 Section 3.3 開頭自己講的。A 到 C 論文沒有逐項對應,只講了理由。我的推論是:A 到 C 在「源頭」降低容易過擬合的提案,D 到 G 在「出口」把關。
兩側的分法只是概念分類,不是程式分工。Algorithm 1(提案端)裡就已經包含了 D 的評分前篩檢,以及 G 的剪枝目標計算。
3.3 轉移規則:和舊規則相比只改了兩處
舊規則(Eq. 2)的選擇範圍是「所有候選加上 」。RRSI 的版本(論文 Eq. 8):
若沒有任何候選通過(交集是空集合),則 。
- :受限的提案分布。它其實就是 proposer LLM,只是輸入多了下面幾項。
- :過去所有修改的歷史紀錄(零件 B)。
- :這一輪每個候選最多綁幾個修改(零件 A)。
- :探索指令,停滯時要去試沒試過的元件(零件 C)。
- :結構剪枝的刪除目標(零件 G)。
- :admissible set(可接受集合),也就是通過所有關卡的候選,由 D、E、F 與領域 guard 決定誰進來。
- :交集。只有「候選」與「可接受」同時成立的才能參賽。
所以只改了兩處:提案分布從無限制的 換成受限的 ,挑最高分的範圍從全部候選縮成通過關卡的候選,全滅就維持原樣。
自編例子: 的分數是 90.0,本輪有三個候選。X 是 91.0,被 D 擋下(寫死題目資訊)。Y 是 90.8,被 F 擋下(成本漲太多)。Z 是 90.5,全部通過。舊規則會選 X,RRSI 選 Z。如果 Z 也沒通過,,這一輪什麼都不改。
3.4 為什麼叫「正則化」,以及為什麼不是傳統的正則化
傳統正則化在最佳化的目標函數裡加一項懲罰,限制模型「能長成什麼樣子」。RRSI 沒辦法這樣做:harness 的候選空間是異質的,一個候選改 prompt,另一個新增 subagent,第三個改控制流程,這些東西放不進同一個參數向量,也就無法定義「參數有多大」。論文在 Appendix C 也直說,它沒有在最佳化任何範數懲罰的目標函數。
所以 RRSI 改成限制搜尋「怎麼一步步走」:不動假設空間,只管提案規則和接受規則。論文把 A 稱為 L0 風格、G 稱為 L1 風格、F 稱為 L2 風格,這只是比喻,名詞不會帶來稀疏或收縮的性質,詳見概念三。
4 提案端:A、B、C
表 2 的 ablation 只有整組拿掉,沒有任何零件單獨的驗證,下面各節不再逐一重複這一點。提案端的三個零件都是交給 proposer 的輸入。只有 A 有明確的數字,B 和 C 是餵給 LLM 的資訊,論文沒有描述怎麼確保 proposer 照做。
4.1 A:退火式編輯預算
proposer 可以把很多不相關的修改綁在一個候選裡。綁越多,越容易擬合眼前這批 feedback 的特例(容量高),而且分數變了也不知道是哪個修改造成的(難歸因)。
RRSI 的做法是每一輪規定一個候選最多能綁 個「獨立可歸因的修改」,而且 隨輪數遞減。早期允許綁多個修改去探索新機制,後期逐步收緊。這就是 learning rate scheduler 式的排程,只是被排程的對象是「一次能改幾件事」。論文 Eq. 4:
是第幾輪(從 0 開始), 是總輪數, 是起始預算, 是終點預算, 是向上取整。中間那個係數會從 1 平滑降到 0,所以 從 降到 (推導見概念六)。
用表 5 的 coding 設定(、、)把 20 輪全部算出來(用公式算的,論文沒有列):
| 輪數 | 預算 | 持續幾輪 |
|---|---|---|
| 0 到 7 | 4 | 8 輪 |
| 8 到 12 | 3 | 5 輪 |
| 13 到 19 | 2 | 7 輪 |
論文裡的真實例子在表 6(Coding R0-A):第 0 輪的候選同時加了「完成前的驗證檢查」和「長時間任務的非阻塞輪詢指引」,evolve set 進步 3.93 分,被接受。第 0 輪預算是 4,允許這樣綁。
用公式與論文超參數可以推出兩個發現:
- 預算永遠到不了 。 時係數一定大於 0,向上取整前的值一定大於 1,所以最小是 2。 只會在 出現,但 Appendix C.1 說一次進化只跑 到 。agentic 與 engineering 的最後一輪也都是 2。但表 5 把 標成 “final-round edit budget”,值是 1。有兩種讀法:照公式字面,最後幾輪仍可綁兩個修改,歸因沒有論文宣稱的那麼乾淨。或者實作的取整方式或輪數編號不同,最後一輪真的是 1。論文文字無法判定。
- 餘弦形狀幾乎是包裝。 取整之後整個排程只剩 4、3、2 三個台階,跟「前 8 輪 4 個、中間 5 輪 3 個、後 7 輪 2 個」的階梯函數沒有實質差別。餘弦只決定台階在哪一輪切換,換成直線遞減會得到幾乎一樣的結果(推論)。論文也沒有單獨對排程形狀或「退火」做 ablation。
4.2 B:證據感知的功勞分配(歷史紀錄)
B 的做法是替每個被評估過的候選寫一筆「實驗紀錄」,之後每一輪都讓 proposer 讀這份紀錄,避免重試已失敗的點子,也記得已成功的點子。紀錄格式(論文 Eq. 10):
每筆紀錄是一個七元組:
- :這個修改是第幾輪提出的。
- :修改的元件類別(component),例如 prompt、control_flow、memory、subagent。
- :這個修改想驗證的假設(hypothesis)。
- :實際的程式碼差異(source diff)。
- :分數變化,候選相對在位 harness 的分數增益。
- :成本變化,token 成本增加的比例。
- :有沒有被採用。 表示這個修改所屬的候選在該輪贏了。 包含所有其他情況,包括被規則擋下的,也包括通過了規則但輸給另一個分數更高的候選(Appendix C.2 明講)。
- :第 輪之前累積的紀錄總數。
一個候選如果綁了多個修改,每個修改各寫一筆,但這些紀錄共用同一組 、 和結果。
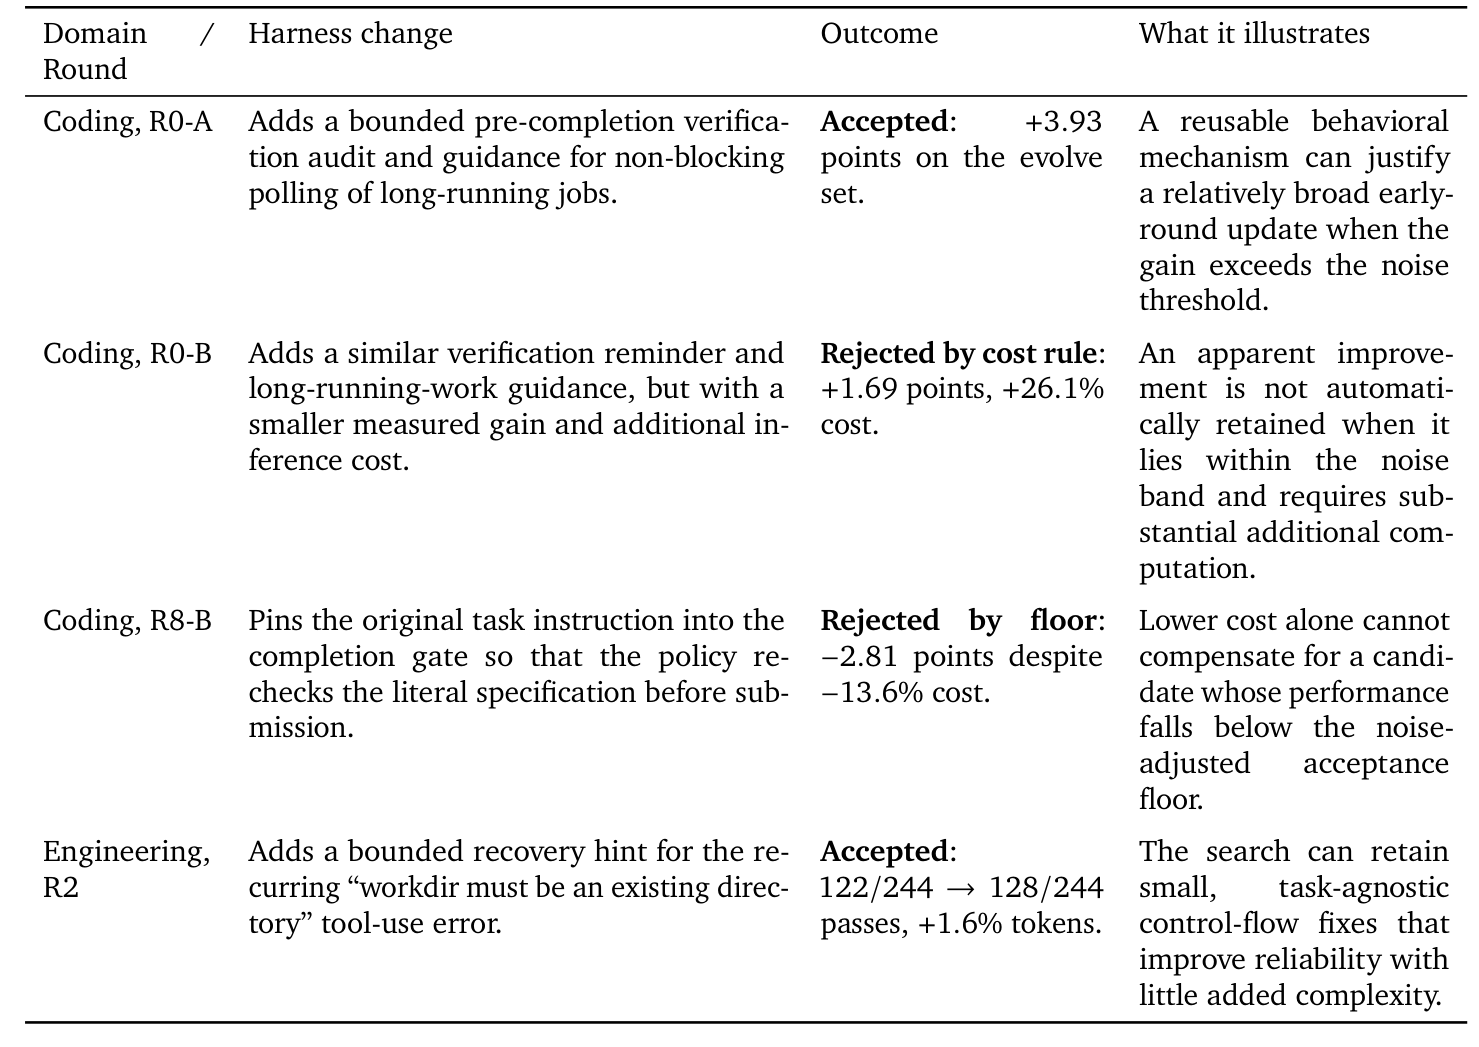
下面是表 6 其中三筆改寫成紀錄的樣子:
| 案例 | 修改內容 | |||
|---|---|---|---|---|
| Coding R0-A | 完成前的驗證檢查,加上長任務的非阻塞輪詢指引 | +3.93 分 | 論文未列 | 1 |
| Coding R0-B | 類似的驗證提醒,加上長任務指引 | +1.69 分 | +26.1% | 0(被成本規則拒絕) |
| Engineering R2 | 針對「workdir must be an existing directory」錯誤的復原提示 | 122/244 到 128/244 passes | +1.6% | 1 |
credit assignment(功勞分配)出自強化學習,問題是「一連串動作之後才拿到一個獎勵,該把功勞分給哪個動作」,常被追溯到 Minsky 1961(這是一般知識,不是論文內容)。這篇論文用得有點過頭:實際只是「保留一份實驗紀錄給 proposer 看」,並沒有計算每個修改各自的貢獻。
幾個疑點與限制:
- 綁在一起的修改,功勞沒有被真正分開。 R0-A 的兩個修改(把它讀成兩個修改是我的解讀)會各有一筆 +3.93 的紀錄,看起來像各自進步 3.93,實際只是合起來進步 3.93。這使 B 的品質綁在 A 上。
- 混了兩種意思:「規則擋下」與「輸給更好的同輪候選」。後者不代表點子失敗。R0-B 就是例子:假設方向和 R0-A 相同,被拒絕是因為只進步 +1.69、又多花 26.1%,意思是「這個版本不划算」,不是「驗證提醒沒用」。論文沒說 proposer 怎麼區分。
- 論文沒說 proposer 怎麼「條件在這份歷史上」(整份放進 prompt,還是先做摘要),也沒說 與 兩個標籤由誰標。
- 被 critic 在評分前擋掉的候選沒有量測值,可能不在紀錄裡(概念八)。
- 「把歷史給 proposer 看」不是新東西。Appendix B 描述的基線 Meta-Harness 與 AHE 已經在做類似的事,B 的差別只剩格式更結構化,論文沒有單獨量這個差別,表 2 也沒有單獨拿掉 B。
4.3 C:結構化探索
C 是一條防偏食規則:搜尋連續幾輪沒有進展時,把停滯訊號與「這次進化裡還沒碰過的元件類別」清單交給 proposer,並保留一個候選名額給探索。論文舉的例子是 proposer 一直改寫 prompt,agent 的結構性機制(工具、記憶、subagent)都沒動過。B 讓 proposer 看到歷史,但歷史本身不保證它會去試新方向。
機制在論文 Eq. 13 與 Appendix C.2:
- :第 輪在位 harness 的評分。:停滯偵測的視窗大小,看最近 輪。
- :雜訊帶(概念四)。進步不超過它,就當作跟雜訊分不開。
- :括號裡成立就是 1,否則是 0。 表示「停滯中」。
- :元件類別的全集,共 9 類:prompt、control_flow、config、output_plumbing、context_mgmt、client_tool、skill、memory、subagent。
- :到目前為止,至少有一筆被量測過的修改所屬的類別。 是 減去 ,也就是還沒碰過的類別。
- :停滯時保留給探索的候選名額數。
用表 5 的 coding 設定(、、)走一次,分數是自編的:、,差 0.012,不超過 0.017,所以 ,判定停滯。若 ,差 0.025 大於 0.017,,不觸發。假設前 8 輪碰過 prompt、control_flow、context_mgmt 三類,則 是其餘 6 類,proposer 會拿到這份清單,並被要求留 1 個候選名額給它們。
疑點與限制:
- 論文沒有描述怎麼確保 proposer 照做,用詞只有 reserved、redirect,沒有任何強制機制(概念七)。
- 「沒碰過」的判定很粗:碰過 prompt 一次就算試過,不管改的是哪一段,被拒絕的修改也算數。
- 推論: 只有 9 類,每輪又有好幾個候選, 可能很快變空,論文沒說變空時怎麼處理。
- 元件標籤由誰標(proposer、程式或另一個分析 LLM),論文未說明,而 C 的判定完全依賴這些標籤。
- 表 6 的案例也沒有停滯觸發的例子,沒有證據顯示它有作用。
4.4 提案端的整體判斷
A、B、C 是三份給 LLM 的軟性指示,只有 是明確的數字。方向都合理,工程上也容易實作,但論文沒有證明每一個各自有效。整個提案端唯一的證據是表 2 的一列 “w/o proposal regularizers”。我的推論是 B 最可能有用,因為把過去的結果給 proposer 看,是所有基線都在做的事,A 和 C 的效果最不確定。
5 篩選端:D、E、F、G 與最終選擇
篩選端是一串各擋不同東西的關卡,候選必須依序全部通過,最後在倖存者裡挑分數最高的。每一關的設計都合理,但沒有任何一關有單獨的驗證。
5.1 D:leakage screening(洩漏篩檢)
在候選被拿去評分之前,先由一個 critic(專門負責審查的 LLM)讀它的程式碼差異(diff),把「寫死題目資訊」的修改擋在門外。論文明講的部分(Section 3.3、4.1、Appendix C.3):
- 擋的東西:明確寫進任務名稱、實體名稱、任務特定數值、答案,或其他只對 evolve benchmark 成立的邏輯。另外也擋 “inert machinery”(加了但沒有作用的程式)。
- 管的是內容,不是元件類別:通用的 prompt 或工具說明改進仍然可以通過。
- 時機在評分之前。理由是被擋的候選永遠拿不到那個會讓它顯得有吸引力的 evolve set 高分。
- 執行者是 Claude Opus 4.8,和 proposer、analyst 同一個模型。
leakage 出自機器學習的 data leakage,指測試資料的資訊漏進訓練過程,讓評估失真。這裡用得貼切,不是包裝:如果候選把 evolve 題目的答案寫進 harness,就等於評分標準漏進了被評分的對象,evolve 分數會被灌水。
自編例子:候選 P 在 prompt 加一句「遇到 Acme 公司的併購合約,違約金條款固定寫 15%」,被擋(寫死實體名稱與數值)。候選 R 新增一個從沒被呼叫的輔助函式,被擋(inert machinery)。放行的真實例子是表 6 的 Engineering R2:針對「workdir must be an existing directory」這個反覆出現的工具錯誤,加一個有界的復原提示。它不含任何題目資訊,被接受了(122/244 到 128/244 passes,token 只多 1.6%),論文拿它當 task-agnostic 修正的代表。
疑點與限制:
- critic 的判準與提示詞沒有公開,也沒有可調的門檻,「通用」與「針對這個 benchmark」的界線完全是 LLM 的判斷。
- 只擋明確寫死的內容。沒有寫死名稱卻恰好貼合 evolve 題目分布的修改(例如假設每題都要附摘要表),critic 不太可能抓到(推論)。
- critic 與 proposer 是同一個模型,盲點可能高度重疊(推論)。
- 表 6 的案例裡沒有任何一個是被 critic 擋下的,也沒報告擋掉的比例。
5.2 E:雜訊帶 δ 與分數底線
進化開始前,先把沒改過的 重複評分幾次,看分數自然會晃多大,這個幅度就是 。之後任何候選的分數,都不准比「歷史最高分減去 」還低。
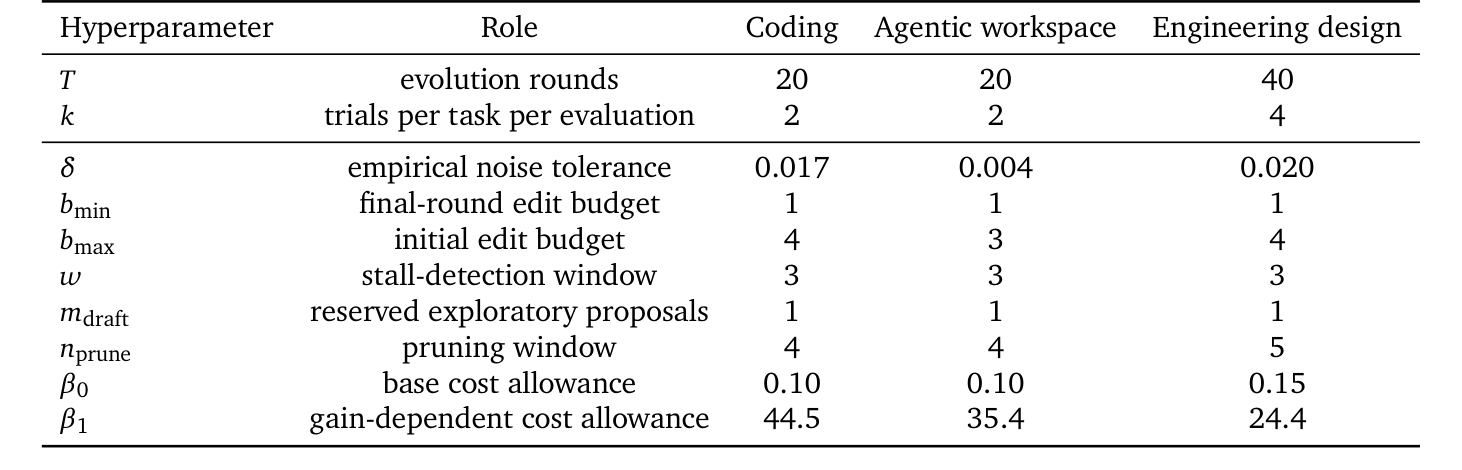
論文只給方法的一句話(進化前重複評估沒改過的 base harness,估出 empirical noise band),之後 固定不變。論文給了三個領域的結果與對應的實際數量(表 5、Appendix D.1),我驗算過:3/178 0.0169、60/14,100 0.0043、5/244 0.0205,與表上一致。
| 領域 | 對應的實際數量 | |
|---|---|---|
| coding | 0.017(1.7 分) | 3 個 pass,總共 89 題 × = 178 次試驗 |
| agentic workspace | 0.004(0.4 分) | 60 個評分項目,總共約 14,100 個 |
| engineering design | 0.020(2.0 分) | 5 個 pass,總共 61 題 × = 244 次試驗 |
表中的 是每題每次評估重複跑的次數,pass 指通過的試驗數。論文沒說進化前重複評估幾次,也沒說用什麼統計量當 (標準差、全距還是某個分位數)。
分數底線(論文 Eq. 5):
是候選 在 evolve set 上實測的分數。 是到目前為止,整個進化過程中觀察到的最高 evolve 分數,起點是 ,每輪更新成 。它是接受候選的必要條件,而且不能被其他項目抵銷(論文稱 non-compensatory)。表 6 的 Coding R8-B 是唯一實例:把原始任務指令釘進完成關卡,分數 、成本 ,coding 的 是 1.7 分,退步超過了,省成本也救不回來。
底線綁在歷史最高分,而不是在位 harness,是為了防止搜尋「連續走下坡」:每一步的退步都小到可以當作雜訊,累積起來卻很多。數字例子見概念四。
這一關有個容易忽略的事實:它防的其實不是「假進步」。 論文 Section 3.3 用 noise chasing 來描述 E,但 Eq. 5 只設了下限,擋的是連續小退步。一個靠運氣多量到 0.3 分的候選,不會被它擋住。若要真的擋掉運氣造成的假進步,統計上更合理的是要求 ,代價是會誤殺運氣差的真進步。兩種做法的取捨在概念四。
其他疑點:
- 只在 上量過一次,之後套用到所有候選,論文沒驗證這個假設。進化後的 harness 步驟更多(圖 4(b):21.2 步增加到 26.3 步),雜訊未必和 一樣(推論)。
- 記錄的是被選中候選的實測分數,而被選中的是最高的那個,所以可能被運氣墊高(贏家詛咒:從有雜訊的分數挑最高的,那個高分通常被運氣墊高,詳見概念二)。
- Algorithm 2 沒說在位 harness 的分數 是沿用當初選中時的量測,還是每輪重量。
5.3 F:成本規則(進步超過 δ 的候選)
F 的原則是:多花的 token 要用分數進步來換,進步越多,允許多花越多。先定義兩個量(論文 Eq. 6),再看規則(Eq. 7):
- :候選比目前在位的 harness 多拿了幾分(用比例表示,多過 7 題 / 178 題 = 0.039)。注意是跟在位 harness 比,不是跟歷史最高分比。
- :每次試驗平均 policy tokens 的相對變化。1.0M 變 1.5M 就是 0.5,變省則是負數。
- :基本額度,不管進步多少都先給這麼多(coding 是 0.10,即 10%)。
- :換算率,每進步一單位,額外允許多少成本增加(coding 是 44.5)。
白話:允許增加的成本 = 基本額度 + 換算率 × 分數進步。實際增加的成本沒超過這個額度就通過,超過就拒絕。
自編例子,用 coding 的設定(、):
| 候選 A | 候選 B | |
|---|---|---|
| 多過幾題 | 7 題 | 4 題 |
| 7/178 = 0.039 | 4/178 = 0.022 | |
| 允許增加的成本 | 0.10 + 44.5 × 0.039 = 1.85(185%) | 0.10 + 44.5 × 0.022 = 1.10(110%) |
| 實際增加的成本 | 50% | 150% |
| 結果 | 50% 185%,通過 | 150% 110%,拒絕 |
進步 7 題,多花 50% 划得來。進步 4 題,多花 150% 就不划算。
的實際意思(Appendix D.1,我驗算過):coding 的 相當於每多過 1 題允許多 25% token。agentic 的 是每多 100 個評分項目多 25%。engineering 的 是每多過 1 題多 10%。 分別是 0.10、0.10、0.15。
疑點與限制:額度很寬,而且是相對在位版本算的,沒有對 的絕對上限。連續接受三次各多 30% 的候選,累計是 ,約 2.2 倍(算術)。 的選法沒有敏感度分析。
5.4 進步落在雜訊帶內的候選(Eq. 17)
進步沒超過 的候選(包含小幅退步),不看成本上限,改用一個加減分數的算式決定要不要收:
- 、:同上。 進步為正, 變貴為正、變省為負。
- :這個候選碰到的結構性元件(client_tool、skill、memory、subagent 四類)裡,有幾類從來沒出現在「被採用的修改」中。
- 、、:三項各自的權重。
白話:進步加分、變貴扣分、試了沒人成功過的新結構加分,加總大於 0 就通過。coding 設 ,分數變化在這條規則裡完全不算分,算式只剩 。
自編例子,三個 coding 候選,都在雜訊帶內、都通過分數底線:
| 分數 | 成本 | 碰新結構 | 算式 | 結果 | |
|---|---|---|---|---|---|
| P | +3 題 | +26% | 沒有 | 拒絕,不管權重多少 | |
| Q | 持平 | 沒有 | 通過(只要 ) | ||
| R | 持平 | +5% | 首次加 memory | 才通過 |
P 就是表 6 的 Coding R0-B(+1.69 分、+26.1% 成本,被拒絕)。R0-B 進步 3 題,coding 的 約 3 題(1.7 分),不算「超過」,所以走的是這條規則。這是我用數字對出來的,論文沒有明寫。
疑點與限制:
- 論文說 、、 列在表 5,實際的表 5 沒有這三個,所以新奇加分到底多強無從得知。
- 分支邊界是一個懸崖。 coding 裡多過 3 題、多花 26% 被拒。多過 4 題( 超過 ,改走 Eq. 7)允許多花約 110%,多花 80% 也能過。3 題和 4 題只差 0.56 分,遠小於雜訊帶本身。
- 這條規則是論文裡比 C 更硬的探索推力,因為它直接改變誰能被收。但它只管雜訊帶內的候選,也只對四類結構性元件有效。
- 為什麼 coding 的 ,以及它是不是為了讓小進步過關,見概念九。
5.5 G:結構剪枝
如果某類元件最近幾輪的修改都沒有帶來進步,就把它列為刪除目標,交給 proposer,請它提出「把這類東西拿掉」的修改。
- :元件類別,共 9 類。:第 筆紀錄的分數變化(紀錄格式見 B)。
- :只看最近 輪的紀錄(coding 是 4,engineering 是 5)。
- :這類元件最近幾輪裡,最好的一次分數變化。
- :到目前為止至少被修改過一次的類別。 是 的那些類別,即剪枝目標。
白話:最近 4 輪裡,這類元件最好的一次也沒有進步(小於等於 0),就列入刪除目標。自編例子,第 8 輪、,只看第 4 輪以後的紀錄:
| 元件類別 | 紀錄(輪次:分數變化) | 窗口內最好的一次 | 結果 |
|---|---|---|---|
| memory | 第 3 輪 +0.02、第 5 輪 、第 6 輪 0.00 | 0.00(第 3 輪已超出窗口) | 列為刪除目標 |
| skill | 第 6 輪 +0.01 | +0.01 | 保留 |
它只是建議,不是強制刪除。 每一輪開始時,程式用歷史紀錄算出 放進 proposer 的輸入,Appendix C.2 說 proposer 被指示要移除沒有產出的機制。程式不會直接刪任何東西,proposer 提出刪除的候選之後,還是要走完全部關卡。所以誤列的代價只是 proposer 白白花了一個提案名額:如果那個元件其實有用,刪掉後分數會掉,被 E 擋下。如果刪掉沒影響又省了成本,這個候選在成本規則裡反而加分。
疑點與限制:
- 公式規定空集合的最大值是負無限大,所以「以前試過、但窗口內完全沒紀錄」的類別按字面也會被列入。而 Appendix C.2 的文字說的是「最近有被動過但沒進步」,論文未判定是哪一種。
- 「元件」在這裡是 9 個大類別,論文沒說實際刪的是整類,還是類別底下的某一段。
- G 在圖 2 與 Section 3.3 被放在篩選端,但 Algorithm 1 是在提案端算出剪枝目標,靠 proposer 執行。
5.6 領域專屬 guard 與最終選擇規則
coding 與 agentic 沒有 guard,這一關等於直接放行。engineering 的候選只要符合下面任一條就被拒絕,而且不能被分數抵銷(Appendix C.3):
- 有效輸出率(valid-output rate)比在位版本掉了超過 0.03。
- 沒有提交率(no-submission rate)比在位版本升了超過 0.02。
用意是避免「通過率上升,但基本執行有效性大幅變差」的候選被收進來。自編例子:在位版本有效輸出率 0.95,候選的通過率進步了,但有效輸出率掉到 0.90,掉了 0.05,超過 0.03,被拒絕。兩個門檻(0.03、0.02)不在表 5,論文沒說怎麼選,兩個比率也只有名稱,沒有定義。
候選要被收,依序要過這幾關(Algorithm 2):
- D:critic 檢查(評分之前)。
- 在 evolve set 上評分,得到 、。
- E:分數不能比歷史最高分低超過 。
- 走 F(Eq. 7),否則走雜訊帶內規則(Eq. 17)。
- 領域 guard(只有 engineering)。
- 全部通過的候選裡,挑分數最高的當 ,並更新 。沒有任何候選通過,。
最後一步仍然是「挑分數最高的」,所以贏家詛咒(概念二)並沒有被完全消除,只是前面的關卡先把明顯有問題的濾掉了。
5.7 整合總表
| 代號 | 零件 | 什麼時候檢查 | 檢查什麼 | 對付的問題 |
|---|---|---|---|---|
| D | leakage screening | 評分前 | critic 讀 diff,擋寫死題目資訊、擋沒作用的程式 | 針對特定 benchmark 的擬合 |
| E | 分數底線 | 評分後 | 分數 歷史最高分 | 論文說是追逐雜訊,實際擋的是連續小退步 |
| F | 成本規則(Eq. 7) | 評分後,進步 | 多花的成本 | 複雜度累積 |
| - | 雜訊帶內規則(Eq. 17) | 評分後,進步 | 不把小波動當證據 | |
| G | 結構剪枝 | 每輪開始(在提案端) | 最近沒進步的元件,建議 proposer 刪除 | 複雜度累積 |
| - | 領域 guard | 評分後(只有 engineering) | 有效輸出率、沒提交率不能明顯變差 | 防止基本品質被破壞 |
| - | 最終選擇 | 最後 | 倖存者挑分數最高,沒人倖存就維持原樣 | - |
6 實驗與結果
最扎實的證據是 agentic 領域的表 1 與表 2:RRSI 在進化用題目上進步最小,在沒看過的 benchmark 上進步最大,而且拿掉正則化後這個優勢就消失。其餘實驗都是補強,方向一致,但每個都只有一個數字、沒有變異數。
6.1 實驗設置
論文在三個領域、八個 benchmark 上實驗。每個領域只在一個 benchmark 上進化,然後把 harness 原封不動拿去跑其他 benchmark。
| 領域 | Benchmark | 角色 | 內容與分數 |
|---|---|---|---|
| coding | Terminal-Bench 2.1 | evolve | 89 個容器化終端機任務,該任務自己的單元測試通過才算解出 |
| coding | SWE-bench Verified | OOD | 真實 GitHub issue 的修復率,patch 要讓 fail-to-pass 測試轉為通過、pass-to-pass 測試仍通過 |
| agentic | Harvey LAB | evolve(120 題)與 ID held-out(40 題) | 法律工作,25 個 practice area。每題有 20 到 100 條評分準則,由 LLM judge 逐條判定,分數是通過的準則比例 |
| agentic | JobBench | OOD | 真實職場工作流程,加權評分表分數。評審是 Gemini-3.5-Flash 與 Claude Opus 4.8 的平均 |
| agentic | GDPval | OOD | 交付物與人類專家的交付物並排比較,三個評審模型多數決。分數是贏過人類專家的比例(185 題) |
| agentic | APEX-Agents | OOD | 480 題,沙盒環境裡有多種 MCP 工具,pass@1(單次執行即成功) |
| engineering | EngDesign | evolve | 61 題設計任務,各自由模擬器或 testbench 評分,結果確定,沒有評審模型 |
| engineering | Frontier-Eng | OOD | 26 個領域的工程最佳化。Medal Score 依結果達到金、銀、銅門檻給 1、0.67、0.33 分後取平均,47 題中 38 題有得分 |
其他設定:policy 固定為 Claude Opus 4.8,proposer、analyst(寫失敗回饋的)、critic 也都是 Opus 4.8。起點 是 Terminus-2(coding)與 ReAct 迴圈加 MCP 工具與 ReSum 式 context 管理(agentic、engineering)。四個基線 Meta-Harness、AHE、TTHE、HarnessX 都從同一個 出發,共用 policy、evolve set 與候選預算。超參數見前面的表 5。
6.2 主結果:與既有方法比較
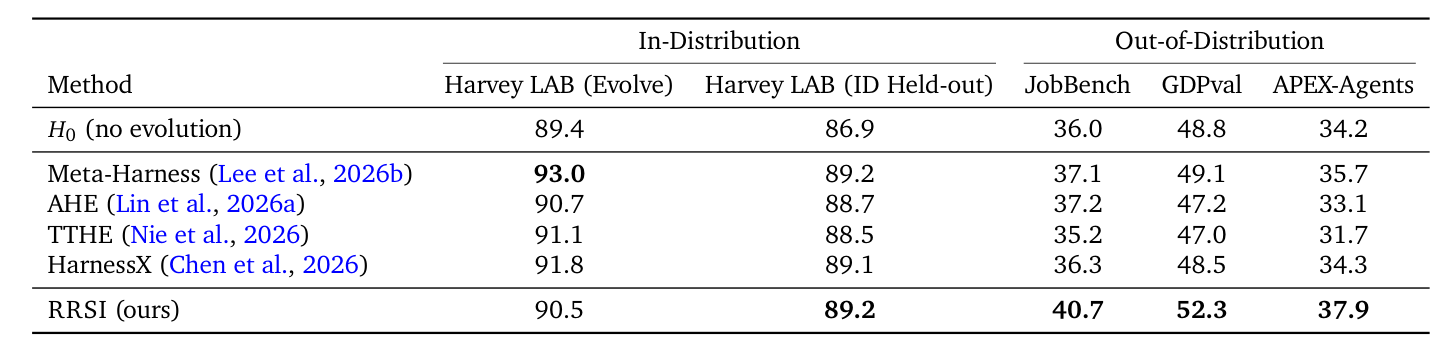
只有 agentic 這個領域有逐一對手的數字,coding 與 engineering 只在圖 1(b)、(d)有「四個對手的平均」。欄位的意思:Harvey LAB (Evolve) 是進化用的 120 題,Harvey LAB (ID Held-out) 是同 benchmark 沒用過的 40 題,JobBench、GDPval、APEX-Agents 是完全沒看過的三個 benchmark。三個 OOD 分數的意思不同(加權評分表、勝率、任務成功率),所以 OOD 平均只是方便的摘要,沒有單一含義。
下表是用表 1 算出的對照,每個數字是相對沒進化的 進步多少。OOD 平均欄是我自己算的,論文只在表 2 與圖 1 給 與 RRSI 的平均:
| 方法 | Evolve 進步 | ID held-out 進步 | OOD 平均 | OOD 平均進步 |
|---|---|---|---|---|
| (沒進化) | - | - | 39.7 | - |
| Meta-Harness | +3.6 | +2.3 | 40.6 | +0.9 |
| HarnessX | +2.4 | +2.2 | 39.7 | 0.0 |
| AHE | +1.3 | +1.8 | 39.2 | |
| TTHE | +1.7 | +1.6 | 38.0 | |
| RRSI | +1.1 | +2.3 | 43.6 | +3.9 |
這張表說三件事。在進化用的題目上,RRSI 進步最小(+1.1),Meta-Harness 最大(+3.6)。在同一個 benchmark 沒用過的題上,大家差不多,RRSI 與 Meta-Harness 並列最高(+2.3)。差距出現在完全沒看過的 benchmark:RRSI 平均進步 +3.9,比最強對手 Meta-Harness 高 3.0 分,另外兩個對手掉到 以下。三個 benchmark 上 RRSI 都是第一,比各自最強的對手高 3.5(JobBench)、3.2(GDPval)、2.2(APEX-Agents)分。換句話說,進化時進步越多的方法,換題目後越不穩,RRSI 刻意用 evolve 分數換取轉移能力。
疑點與限制:
- 論文沒說每個方法重跑幾次進化,也沒有標準差。推論:三個 benchmark 全部第一,而且差距比對手彼此的差距(最好 40.6 對最差 38.0)還大,比較不像單純運氣,但這不是統計檢定。
- 這裡的「OOD」只是同一個領域內的換題:用 Harvey LAB(法律)進化,測其他職場任務 benchmark。沒有測跨領域,例如拿 coding 進化的 harness 去測 workspace 任務。
- 對手是作者自己重跑的,論文沒說對手有沒有調參,也沒說它們的 proposer 是不是同一個模型。
6.3 主結果:三個領域
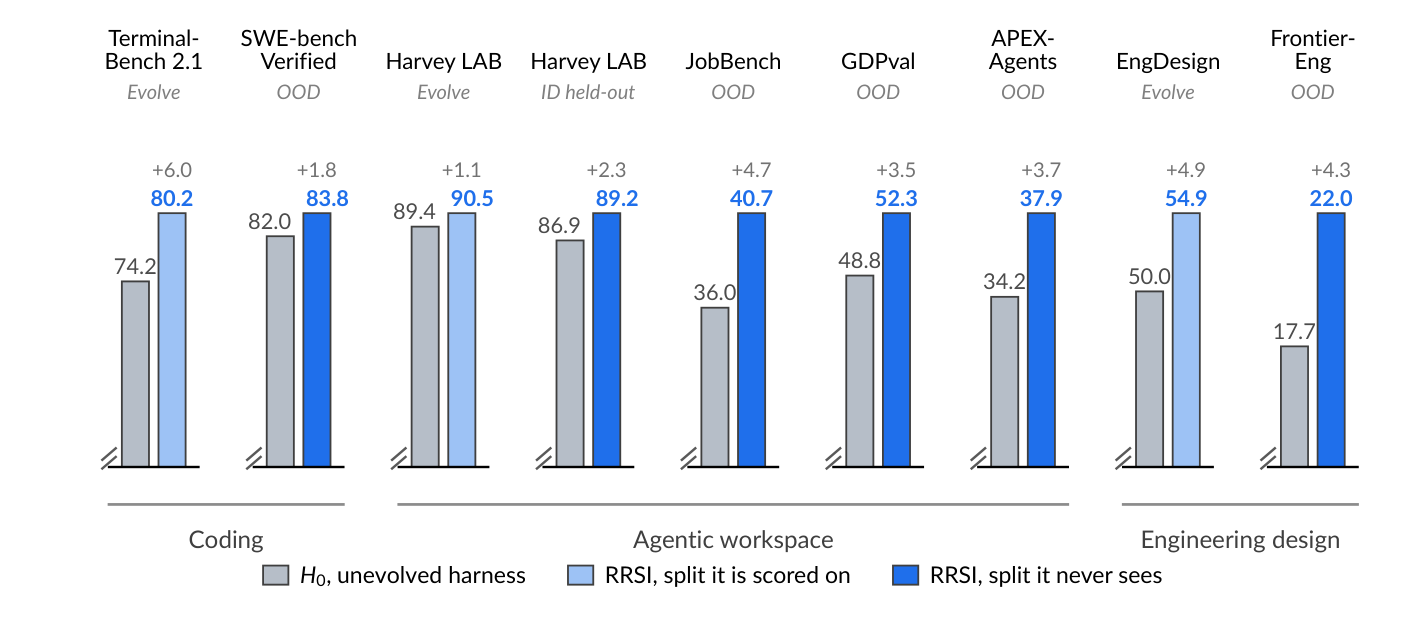
圖 3 的數字整理如下:
| 領域 | 進化用的 benchmark | 進步 | 完全沒看過的 benchmark | 進步 |
|---|---|---|---|---|
| coding | Terminal-Bench 2.1:74.2 到 80.2 | +6.0 | SWE-bench Verified:82.0 到 83.8 | +1.8 |
| agentic | Harvey LAB:89.4 到 90.5 | +1.1 | JobBench、GDPval、APEX-Agents | +3.5 到 +4.7 |
| engineering | EngDesign:50.0 到 54.9 | +4.9 | Frontier-Eng:17.7 到 22.0 | +4.3 |
- coding 的 OOD 進步很小:SWE-bench 的 +1.8 分,與 coding 的雜訊帶 1.7 分差不多大。兩者是不同的 benchmark,不能直接當檢定,但這個進步很難跟雜訊分開(推論)。
- Frontier-Eng 的 +4.3 來自很小的基期:4.3% 大約是 1.6 到 2 個金牌的分量(分母取 38 或 47 題),所以論文摘要那個「相對進步 24.3%」聽起來很大,底下只是少數幾題的差別。
6.4 Ablation:正則化本身的貢獻
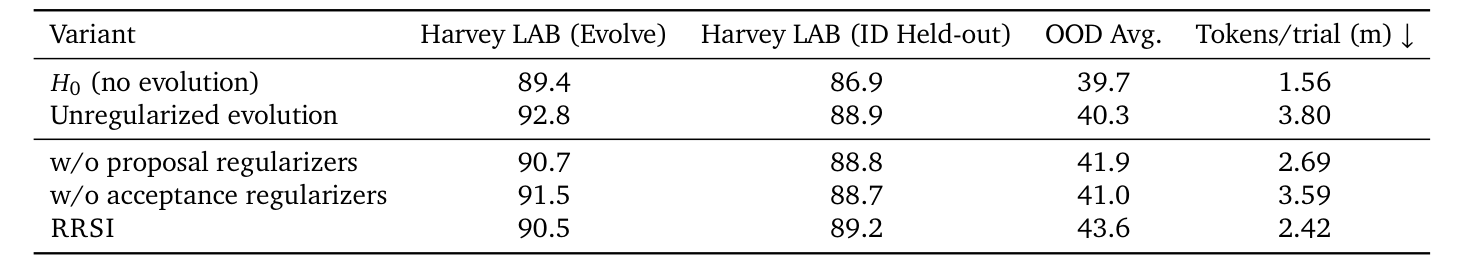
這是論文唯一能看出正則化本身貢獻的地方。最乾淨的對照是「沒有任何正則化」對「RRSI」(下表由表 2 計算,論文沒有直接列):
| 對照 | Evolve | ID held-out | OOD 平均 | Tokens/trial |
|---|---|---|---|---|
| 到 Unregularized(只靠進化) | +3.4 | +2.0 | +0.6 | 1.56M 到 3.80M(+144%) |
| Unregularized 到 RRSI(正則化的貢獻) | +0.3 | +3.3 | 3.80M 到 2.42M() | |
| 到 RRSI(總進步) | +1.1 | +2.3 | +3.9 | 1.56M 到 2.42M(+55%) |
沒有正則化的進化,evolve 分數漲最多,但換到沒看過的題目幾乎沒進步(只有 +0.6),還多花了一倍多的 token。加上正則化後,evolve 分數少拿 2.3 分,OOD 多拿 3.3 分,token 省了三分之一,ID held-out 只差 0.3。
把正則化一組一組拿掉的四列:
| 變體 | Evolve | ID held-out | OOD 平均 | Tokens/trial |
|---|---|---|---|---|
| RRSI(全部都有) | 90.5 | 89.2 | 43.6 | 2.42M |
| 拿掉 proposal 端(A、B、C) | 90.7 | 88.8 | 41.9 | 2.69M |
| 拿掉 acceptance 端(D、E、F) | 91.5 | 88.7 | 41.0 | 3.59M |
| 全部拿掉 | 92.8 | 88.9 | 40.3 | 3.80M |
規律很整齊:拿掉的正則化越多,evolve 分數越高(90.5、90.7、91.5、92.8),OOD 越低(43.6、41.9、41.0、40.3)。這正是論文要證明的取捨。
疑點與限制:
- 每一列都只有一個數字,沒有標準差,3.3 分的 OOD 差距有多穩無從判斷。
- 只在 agentic 一個領域做了 ablation,coding 與 engineering 沒有。
- 仍然沒有單一零件的 ablation,只有兩大組。G 屬於哪一組,論文的說法前後不一,表 2 也沒交代。
- 「Unregularized」沒說是否包含 analyst 回饋和歷史紀錄,只是拿掉了 A 到 G。論文摘要寫「少 30% token」,這個對照我算出來是少 36%,論文沒說 30% 拿什麼比。
- 論文摘要的數字是挑最好看的:「最多進步 14.1 分」是表 3 較弱模型在進化用題目上的進步,「OOD 最多 4.7 分」是三個 benchmark 裡最好的一個,「比既有方法高 22.9%」是 Frontier-Eng 的 17.9 到 22.0(圖 1(d)),基期很小,相對百分比被放大。這裡的基期 17.9 與圖 3 的 17.7 略有出入,論文沒說明差在哪。
6.5 其餘實驗:換模型、換成本、換評分方式
這幾個實驗都是補強,不是證據核心,因此只放結果與一句話保留。
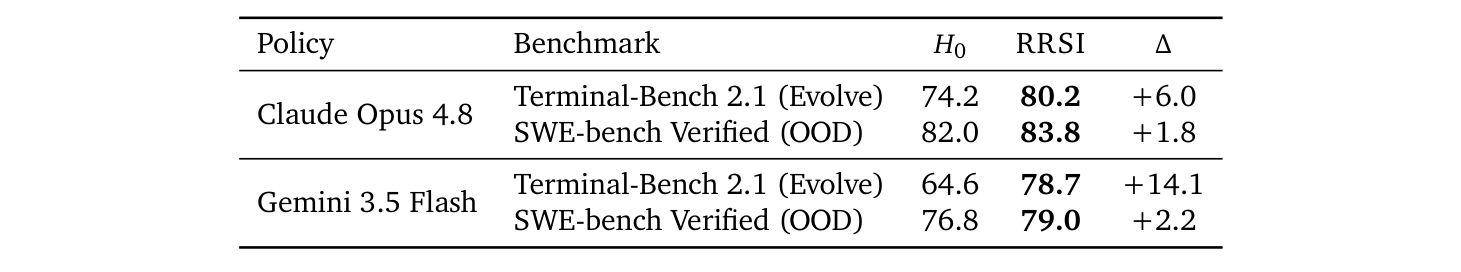
表 3 要驗證的是換一個不同家族的模型重新進化,效果是否仍在。結果如下:
| Policy | Terminal-Bench 2.1(evolve) | SWE-bench Verified(OOD) |
|---|---|---|
| Claude Opus 4.8 | 74.2 到 80.2(+6.0) | 82.0 到 83.8(+1.8) |
| Gemini 3.5 Flash | 64.6 到 78.7(+14.1) | 76.8 到 79.0(+2.2) |
疑點:論文摘要的「14.1」就是這一列(進化用題目、較弱模型)。SWE-bench 的進步都只有 +2 左右,與 coding 雜訊帶同量級。只測兩個模型,沒有標準差。
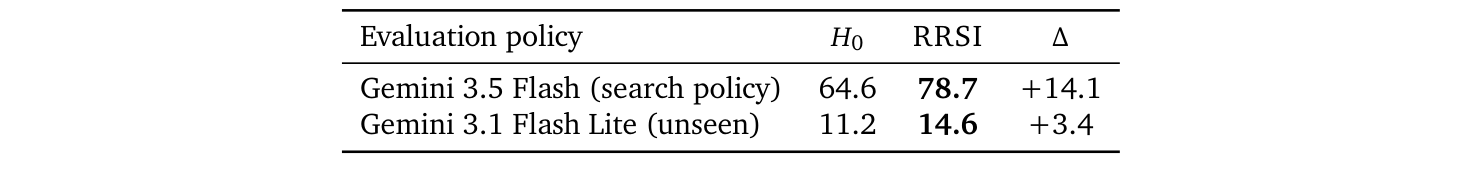
表 4 要看進化好的 harness 搬到沒參與進化的較弱模型,還有沒有幫助。Gemini 3.1 Flash Lite 從 11.2 到 14.6(+3.4)。論文寫相對進步 30.4%,但絕對進步只有 +3.4,約保留進化用模型 +14.1 的四分之一。疑點:測的是進化用的同一批題目,只驗證了換模型,沒驗證換題目。Flash Lite 與進化用的 Flash 同屬 Gemini,不是跨家族。只有一個弱模型,且只測往弱的方向。
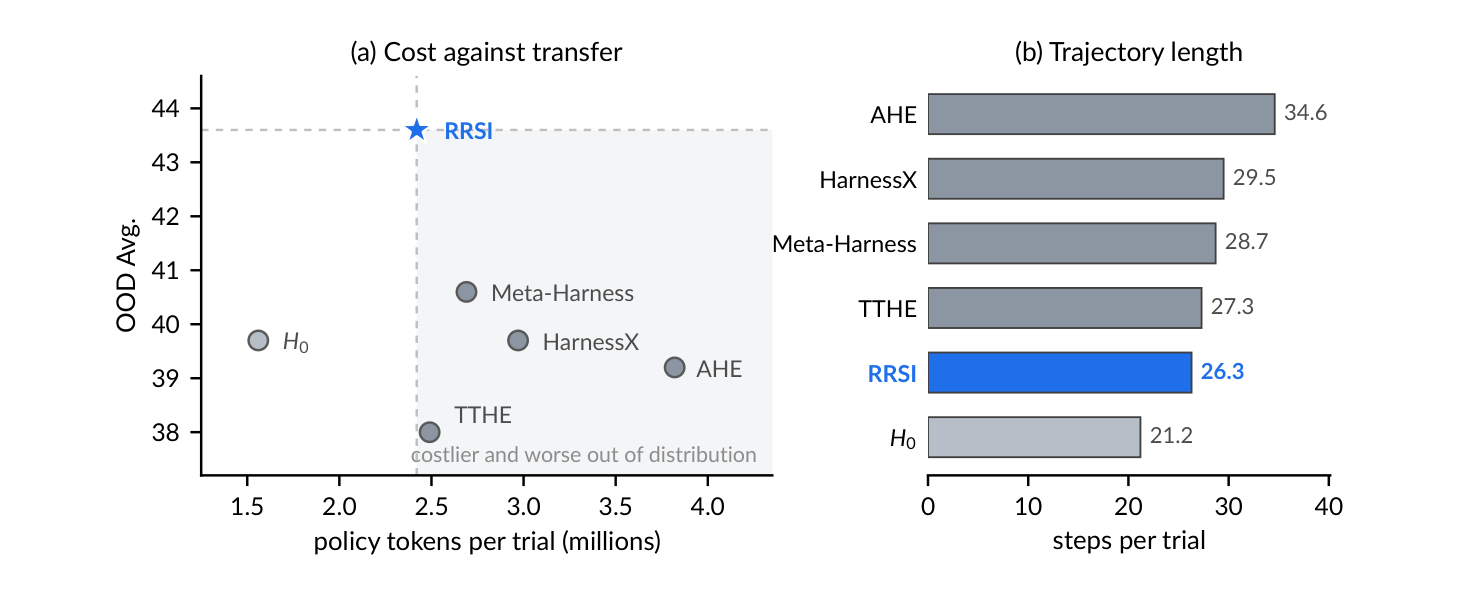
圖 4 要說的是 RRSI 是所有進化方法裡花得最少的。RRSI 每次試驗 2.42M tokens、26.3 步,對手是 27.3 到 34.6 步。AHE 最貴,3.82M tokens(多 58%),OOD 還少 4.4 分。疑點:RRSI 仍比沒進化的 (1.56M、21.2 步)貴 55%。TTHE 與 RRSI 差距不大,優勢主要被 AHE 拉開。這裡只量最後 harness 跑一次的成本,進化過程本身(20 輪、每輪多個候選、三個 LLM)花多少,論文沒報。
最後是 Section 4.2 後半的 deterministic grading:EngDesign 與 Frontier-Eng 由模擬器確定性評分,進步仍在(+4.9、+4.3),用來說明進步不是靠迎合 LLM judge 的口味。疑點:這只證明工程領域。JobBench 的評審之一與 policy 同為 Opus 4.8,GDPval 評審之一同為 Claude 家族,論文未討論評審偏好自家模型的可能。
7 整體評價
這篇的價值在於提醒「harness 自動進化很容易過擬合,要加護欄」,而不在於護欄本身有多新。我的判斷是研究價值偏低,工程參考價值中等偏上。
7.1 扣掉包裝後,它真正做到什麼
最乾淨的對照就是前面 ablation 那一節算出來的「沒有任何正則化的進化」對「RRSI」:加上護欄後,進化用的題目少拿 2.3 分(92.8 到 90.5),沒看過的題目多拿 3.3 分(40.3 到 43.6),每次試驗的 token 從 3.80M 降到 2.42M,省了三分之一。這是這篇最扎實的證據。論文摘要裡其他數字都是挑最好看的那個,真正穩的只有這一組,而且只在 agentic 一個領域。
7.2 研究價值與工程價值
研究價值偏低:研究貢獻接近「一個好的問題定義加上一組合理的工程規則」,沒有新的演算法或理論。論文也沒有推導任何泛化保證,「正則化搜尋軌跡」是設計上的框架加類比,效果靠實驗支持,不是靠理論。工程參考價值中等偏上:規則具體、可以照著實作,而且設計原則脫離這篇論文也成立。
| 面向 | 優點 | 缺點 |
|---|---|---|
| 研究 | 把「harness 進化會過擬合」講清楚,並指出三個具體行為。反覆用同一批題目評分的風險本身是真實的問題 | 各個零件大多是常見做法的組合:評分前審查、雜訊底線、成本換分數、保留歷史紀錄(這是判斷)。L0、L1、L2 只是命名(概念三) |
| 研究 | 有整組 ablation,方向與論文的說法一致。有換 policy、換模型、換評分方式的補強實驗 | 沒有單一零件的 ablation,不知道哪個零件真的有用。所有比較都沒有標準差,跨方法比較只有一個領域 |
| 工程 | 規則都很具體,可以直接照著實作。程式碼與完整的逐輪紀錄有公開(Appendix E 說在專案網站,含 proposal、critic 決定、接受決定與完整 diff) | 關鍵超參數有的沒交代、有的沒列出( 怎麼選、 怎麼量、guard 門檻、 權重)。進化本身花多少錢沒報,只報了最後 harness 的成本 |
| 工程 | 每個護欄各自對應一個明確的失敗模式,出問題時比較好排查 | critic 與 proposer 是同一個 LLM,盲點可能重疊(推論) |
7.3 最大的三個疑點
- 沒有變異數。 每個數字都是一次進化的結果,沒說重跑幾次。3.3 分的 OOD 差距有多穩,無法判斷。
- 「泛化」只是同類任務之間換題。 沒有測跨領域,例如用 coding 進化的 harness 去測 workspace 任務。
- 每個零件都沒有單獨的證據。 論文的核心賣點是「這一整包護欄有效」,不是「這個零件有效」。
7.4 值得留下的東西,依耐久度排序
| 耐久度 | 內容 | 判斷 |
|---|---|---|
| 中 | 把「harness 自動進化會過擬合」講清楚,並歸納出三個行為:擬合特定 benchmark、追逐雜訊、複雜度累積 | 問題定義本身有價值,是這篇最實在的貢獻 |
| 中低 | 一整組護欄的工程配方(A 到 G 加 guard),在 agentic 上有整組 ablation 支持 | 每個零件都是常見做法的組合,沒有任何單一零件的證據 |
| 低 | 具體數字(OOD +3.3、省 36% token)與 L0 / L1 / L2 的命名 | 數字只在一個領域、沒有變異數,會隨新模型過期。命名只是比喻,可以忽略 |
一句話:這篇接近一個好的問題定義,加上一組合理但沒被拆開驗證的工程規則。真正耐久的是後面「延伸」裡概念一到四、六那幾個通用觀念。
8 延伸:九個值得單獨拿出來講的概念
以下九段是讀這篇論文時最容易卡住、也最容易忘記的觀念,概念一到四、六是通用的觀念,脫離這篇論文也成立。概念五、七、八、九是這篇論文留下的疑點,會引用前半的方法與公式,建議讀完對應的方法章節再看。
8.1 概念一:反覆用同一批資料做決策,為什麼會製造假進步
先看最簡單的情境:你有 100 題可以評估一個系統。只評估一次,再用這個分數當成「這個系統的水準」,這是沒有偏差的估計,最多有隨機雜訊。問題出在你不只評估一次:你看了結果,根據結果改了系統,再用同一批題目評估,再改,如此反覆。
第二次修改的方向,是根據第一次在這批題目上的結果決定的,所以修改內容已經帶著「這批題目的特徵」。等到第三次評估時,你量到的分數有一部分是「我針對這批題目調整過」的成果,不是真的變強。這批題目已經不再是獨立的檢驗資料,統計上叫 adaptive data reuse,相關的研究領域叫 adaptive data analysis(Dwork 等人 2015 年是代表性的一篇,這篇論文引用它來說明問題存在,沒有自己推導)。
以下是統計的一般知識,不是論文內容。有兩個放大器:
- 每次評分帶隨機雜訊,而每一輪都是「從一堆候選挑最高分」。取最大值會系統性地挑出被雜訊墊高的那個(見概念二)。以每個候選的真實效果都是 0、雜訊標準差為 為例:4 個候選挑最好的,期望值約 。100 次評分挑最好的,期望值約 。什麼都沒改進,看起來也會進步,而且看的次數越多,假進步越大。
- 空間越大、越靈活,越容易找到「恰好貼合這批題目」的修改。harness 進化的搜尋空間是「改任意原始碼」,屬於表達力異常大的空間,所以論文說它是 adaptive empirical optimization over an unusually expressive search space,也就是在表達力異常大的空間裡做適應性的經驗最佳化。
實際做法只有一個:進化用的題目和最後檢驗用的題目要分開,而且檢驗用的題目不能參與任何決策,包括調超參數。這篇論文的超參數就只用 evolve 環境選定,沒有參考 held-out 或 OOD(表 5 的 caption)。
有問題的寫法是進化與檢驗用同一批題目:
for t in range(T):
    candidates = propose(current, feedback(current, tasks))
    current = max(candidates + [current], key=lambda h: score(h, tasks))
final_score = score(current, tasks)   # 這個數字被搜尋過程「看過」,偏高
較好的寫法是讓檢驗題目不參與任何決策:
evolve_tasks, holdout_tasks = split(tasks)
for t in range(T):
    candidates = propose(current, feedback(current, evolve_tasks))
    current = max(candidates + [current], key=lambda h: score(h, evolve_tasks))
final_score = score(current, holdout_tasks)   # 只在最後量一次
RRSI 沒有做到「進化中完全不重用同一批題目」(它做不到,evolve set 就是要被反覆評分的),而是用一組護欄降低重用造成的傷害。論文沒有推導任何泛化保證,「正則化搜尋軌跡」是一個設計框架加類比。
這也是這組觀念裡最耐久的一條:任何「自動改進、自動評估」的系統(prompt 優化、skill 進化、agent 進化)都有這個結構。
另外,沒有任何正則化的進化在表 2 裡是個有價值的負面結果:進化分數最高(92.8),沒看過的題目卻只進步 0.6(39.7 到 40.3),token 還多了 144%。評估任何自動進化系統,不要只看它在進化用題目上的分數,要看沒參與決策的題目,也要看成本。
8.2 概念二:贏家詛咒(winner’s curse)
從一堆帶有運氣成分的分數裡挑最高的,被挑中的那個,分數幾乎一定被運氣墊高了,所以它的真實水準比看到的分數低。
用一個例子看:4 個候選,真實實力完全一樣,都是 90.0 分。但每次評分都有隨機波動(LLM 每次跑結果不同,每題也只跑幾次),所以量到的分數會在 90.0 上下晃:
| 候選 | 真實實力 | 這次量到的分數 |
|---|---|---|
| A | 90.0 | 89.7 |
| B | 90.0 | 90.4 |
| C | 90.0 | 89.9 |
| D | 90.0 | 90.1 |
挑最高分,選中 B(90.4)。看起來 B 進步了 0.4 分,但 B 其實跟其他人一樣是 90.0,多出來的 0.4 純粹是這次運氣好。這個 0.4 就是「詛咒」:你選中它,是因為它運氣好,但下一次重新評分時,運氣不會跟著它走,分數會掉回 90.0 附近。
import random

def measure(true_score=90.0, noise=0.4):
    return random.gauss(true_score, noise)   # 每次評分帶隨機雜訊

scores = [measure() for _ in range(4)]       # 4 個真實實力相同的候選
best = max(scores)                           # 「贏家」
這裡的 best 平均會比 90.0 高約 1.03 倍的 noise,這個差距是運氣,不是實力。
這個詞最早來自拍賣:得標者往往是對物品估價最樂觀的人,付的價錢通常高過物品的真實價值。「贏」的人贏的原因有一部分是運氣,所以贏得的東西(那個高分)不能當真。候選越多,被墊高的幅度越大:4 個候選挑最高,期望被墊高約 1.03 個雜訊標準差,100 個約 2.51 個。
跟這篇論文的關係:
- 每一輪 RRSI 都是「一堆候選挑分數最高」,所以每一輪都有這個問題。
- 被選中候選的分數會被記成歷史最高分 ,這個被墊高的數字會影響之後的分數底線判斷(概念四)。
- 前面的關卡(critic、分數底線、成本規則)把明顯有問題的候選濾掉,但最後仍是在倖存者裡挑最高分,所以贏家詛咒沒有被消除,只是被減輕。
實務上的通則是:只要流程裡有「一堆候選挑最高分」這一步,就要假設那個最高分偏高,不要當成真實水準。
8.3 概念三:正則化,以及 L0、L1、L2 各自在做什麼
訓練資料只有有限的 筆,模型太靈活的話,會連資料裡的雜訊都背起來,訓練誤差很低,換一批資料就很差。正則化的做法是在最佳化目標裡多加一項複雜度懲罰:
- :模型的參數,可以想成一排旋鈕。
- :模型對第 筆輸入 的預測。:第 筆的正確答案。
- :單筆預測的誤差。 乘上加總,就是對 筆誤差取平均,也就是訓練誤差。
- :複雜度懲罰,例如「旋鈕總共轉多大」。
- (大於等於 0):懲罰強度,越大越偏好簡單的模型。
自編數字例子:。模型 A 的訓練誤差 0.0、複雜度 ,總分 。模型 B 的訓練誤差 0.5、複雜度 ,總分 。總分越低越好,所以選 B:A 雖然把訓練資料背得滿分,但太複雜,被懲罰扣掉了。
注意兩個關鍵:懲罰的對象是「模型本身的參數 」,作用的位置是「最佳化的目標函數」。這就是「限制假設空間」,假設空間(hypothesis space)指所有可能的模型的集合。
範數(norm)是「量一個向量有多大」的方法。設 :
第一式是不等於零的參數有幾個,第二式是每個參數的絕對值加總,第三式是每個參數的平方加總。自編例子:。L0 是 2(兩個非零),L1 是 ,L2 的平方是 。把它們放進懲罰項 ,就得到三種正則化:
| 取什麼 | 名稱 | 效果 | 備註 |
|---|---|---|---|
| L0 範數 | L0 正則化 | 直接數「開了幾個旋鈕」,限制非零參數的個數 | 「數個數」沒辦法用梯度下降,最佳化困難,實務少見 |
| L1 範數 | Lasso(Least Absolute Shrinkage and Selection Operator,最小絕對值收縮與選擇算子) | 把不重要的參數壓到剛好 0,得到稀疏的模型 | 兼具選擇變數的效果 |
| L2 範數的平方 | Ridge(嶺迴歸) | 讓所有參數一起縮小,但很少變成剛好 0 | 在 ML 裡最常見,weight decay 本質上就是它 |
為什麼 Lasso 會歸零,Ridge 不會?看斜率。把一個參數從 0.1 降到 0,L1 的懲罰少掉 0.1,L2 的懲罰只少掉 0.1 的平方,也就是 0.01。 的斜率永遠是 1,所以一路把參數推到 0。 的斜率是 ,越靠近 0 推力越小,到不了 0。
這篇論文怎麼借用這三個名字,其實只是比喻:
| 論文的名稱 | RRSI 實際在做的事 | 對應程度 |
|---|---|---|
| L0:退火式編輯預算(A) | 一個候選最多綁 個修改,形式上是個數上限 | 形式對得上,但它是硬性上限不是懲罰項,把「L0」拿掉資訊沒有損失 |
| L1:結構剪枝(G) | 近期沒有正增益的元件,列為刪除目標 | 只有「稀疏化」的意圖相同,機制更接近神經網路壓縮裡的 pruning |
| L2:複雜度感知接受(F) | 多花的 token 要有分數增益來抵 | 是一個成本效益門檻,沒有平方、沒有收縮,對應最弱 |
論文在 Appendix C 也承認這是功能上的類比,不是最佳化任何範數懲罰的目標函數。所以這些名詞不會讓 RRSI 繼承 L1 的稀疏性或 L2 的收縮性,看到「L1 風格」時,只需要理解成「剪掉沒貢獻的東西」。另外,圖 2 把 F 標成 L1、G 標成 L0,與正文(A 是 L0、G 是 L1、F 是 L2)不一致,我判斷是筆誤(推論,論文沒有明說)。
8.4 概念四:雜訊帶 δ 與分數底線,以及一個更嚴格的版本
一個系統重複評分,每次的分數都不會完全一樣(LLM 每次執行結果不同,每題只跑有限次)。把「完全沒改過的版本」重複評分幾次,分數自然晃動的幅度,就是雜訊帶 。分數的差距如果小於 ,就分不清是真的差異還是雜訊。做法本身很通用:進化前先把沒改過的版本重複評分,量出波動幅度,再決定什麼算進步。
scores = [evaluate(H0, tasks) for _ in range(R)]   # 進化前:重複評估沒改過的版本
delta = spread(scores)                             # 自然波動幅度,統計量要自己選

lenient = score >= best_so_far - delta   # 只擋連續小退步,放行運氣好的假進步(論文的做法)
strict  = score >= best_so_far + delta   # 擋假進步,但會誤殺運氣差的真進步
分數底線(論文 Eq. 5)是 :候選分數不能比歷史最高分低超過 。
為什麼底線綁在歷史最高分,而不是在位版本? 防止搜尋連續走下坡。自編例子,用 coding 的 、 分:
| 輪次 | 底線綁在「在位版本」 | 底線綁在「歷史最高分」(Eq. 5) |
|---|---|---|
| 起點 | 在位 74.2,底線 72.5 | ,底線 72.5 |
| 第 1 輪,候選 72.6 | 通過。在位變成 72.6,底線降到 70.9 | 通過。底線仍是 72.5 |
| 第 2 輪,候選 71.0 | 通過。在位變成 71.0,底線降到 69.3 | 拒絕(71.0 72.5) |
| 第 3 輪,候選 69.4 | 通過。累計已退步 4.8 分 | 不會發生 |
每一步的退步(1.6、1.6、1.6)都在 內,但累積起來很多。綁在歷史最高分,底線只會隨最高分上升,不會下降,所以整個進化過程最多比最高分低 。
Eq. 5 只設下限,不擋「運氣好的假進步」。 論文用 noise chasing 來描述這個零件,但一個真實水準沒變、只是這次評分多量到 0.3 分的候選,會輕鬆通過 Eq. 5。要擋掉這種假進步,統計上合理的做法是同時設上限:要求候選比歷史最高分高出至少 。兩種規則的取捨如下(數字自編,設 、):
| 情況 | 寬鬆版(論文,) | 嚴格版() |
|---|---|---|
| 真實水準與現在打平,但這次運氣好量到 79.5 | 通過。若這輪它最高就會被選中,成為假進步 | 不通過(79.5 79.7),假進步被擋下 |
| 真實水準高 1 分(真進步),但這次運氣差量到 77.5 | 通過,但低於 所以不會刷新 | 不通過(77.5 79.7),真進步被誤殺 |
寬鬆版的代價是 false positive(放行雜訊撐出來的假進步),嚴格版的代價是 false negative(擋掉運氣差的真進步)。兩者解決的是不同的問題:寬鬆版防連續小退步,嚴格版防假進步,論文只做了前者。我的推論是論文可能怕門檻設太嚴,20 輪下來幾乎沒有候選能通過,搜尋會卡住,但這只是猜測,論文沒有為這個選擇辯護。
選哪個,看你更怕哪種錯:搜尋預算充裕、假進步代價高,就選嚴格。預算緊、怕搜尋停滯,就選寬鬆。
另外兩個要記得的限制: 是在原始版本上量的,進化後的版本雜訊未必一樣。而且 記錄的是被選中候選的實測分數,被選中的是最高的那個,所以 本身可能被運氣墊高(概念二),之後的底線也跟著偏高,實力相同的候選可能被誤擋。
8.5 概念五:失敗回饋是什麼
是每一輪交給 proposer 的「目前這版 harness 哪裡失敗」的整理,論文只說了它是誰寫的、從什麼來的,沒有說內容長什麼樣。論文明講的三件事:
| 內容 | 出處 |
|---|---|
| 目前的 harness 在 evolve set 上跑完,產生 trajectories(一次完整的任務執行紀錄),再整理成 | Section 2 |
| 負責整理的是一個獨立的 analyst(分析員)LLM,模型是 Claude Opus 4.8 | Section 4.1 |
| 在演算法裡是 Analyze(, ) 這一步,輸出 | Algorithm 1 第 1 行 |
流程是: 在 evolve set 上跑,得到 trajectories。analyst LLM 讀 trajectories,寫出失敗回饋 。 交給 proposer,作為提案分布(Eq. 8)的條件之一。
論文沒說明的部分: 的格式(自由文字、條列,還是結構化欄位)、有沒有帶每題的分數與失敗原因、analyst 讀的是全部 trajectories 還是抽樣、proposer 除了 能不能另外看原始 trajectories。Appendix B 說基線 Meta-Harness 的 proposer 可以看執行軌跡,RRSI 有沒有這個權限,文字沒交代。
還有一個前後不一致的地方:Section 4.1 寫 analyst 產出的是 “cross-round failure feedback”(跨輪的失敗回饋),但 Appendix C.1 寫 是 “feedback from the current round”(本輪的回饋)。兩種讀法的差別:
| 讀法一:只看本輪 | 讀法二:跨輪彙整 | |
|---|---|---|
| 的內容 | 只分析 這一輪的表現 | 還會把過去幾輪的失敗模式綜合進來 |
| 後果 | 與歷史紀錄 分工清楚: 講現況, 講歷史 | 與 的功能有重疊 |
論文文字無法判定是哪一種。以下是我的推論,論文沒這樣寫:
- 內容大概是失敗模式的摘要。線索是表 6 的 Engineering R2:候選針對「workdir must be an existing directory」這個反覆出現的工具錯誤加了復原提示。要能針對它提案,回饋很可能已經把「這個錯誤重複出現」整理出來。
- 不可能是原始紀錄全文。agentic 每輪要評估 120 題 × = 240 次執行,表 2 顯示 每次執行消耗 1.56M policy tokens(可能含每一步重複讀入的 context),整批遠超一個 context window,所以 analyst 必然是壓縮過的,怎麼壓論文沒寫。
- 是題目特定資訊進入搜尋的入口。失敗回饋必然提到具體任務與具體錯誤,proposer 最省事的修法就是把這些細節寫死進 harness,這正是 D 要擋的東西,也解釋了為什麼 critic 要讀程式碼差異,而不是只看分數。
與 (零件 B)的分別:
| (零件 B) | ||
|---|---|---|
| 記錄什麼 | 現在這版 harness 哪裡失敗 | 過去每個修改的結果 |
| 誰產生 | analyst LLM 整理 | 程式記錄,標籤由誰標未說明 |
| 內容形式 | 論文未說明 | 七元組(見 B 一節) |
8.6 概念六:退火預算排程,公式怎麼算,名詞從哪來
退火預算是一個「前期放寬、後期收緊」的數值排程,本質就是 learning rate scheduler,只是被排程的對象是「一個候選一次最多能綁幾個修改」。
名詞來歷(一般知識,不是論文內容):
- 「退火」原本是冶金:金屬加熱後慢慢降溫,讓內部結構穩定。
- 進入最佳化領域後有了模擬退火(simulated annealing):用一個「溫度」隨時間下降的排程,前期允許大幅度亂走,後期只允許小幅度微調。
- 餘弦退火(cosine annealing):2016 年 SGDR 論文把餘弦形狀用在深度學習的學習率排程,現在訓練 LLM 很常見。
- 這篇論文借的只有「前期放寬、後期收緊」的形狀,沒有用到溫度或機率式接受的機制。
公式(論文 Eq. 4,符號見 A 一節)可以拆成四步:
- 是一個角度,隨 從 0 走到 ,也就是從 0 度走到 180 度。
- 隨之從 1 降到 。
- 把它變成一個從 1 降到 0 的係數,形狀是起頭平、中段陡、尾巴又平的 S 形,不是一條直線。
- ,也就是起點 與終點 之間依係數內插,最後向上取整成整數(因為是「幾個修改」)。
用 coding 的設定(、、)走三個點:
| 角度 | 係數 | |||
|---|---|---|---|---|
| 0 | 0 度 | 1 | 1 | |
| 8 | 72 度 | 約 0.309 | 約 0.6545 | |
| 19 | 171 度 | 約 | 約 0.006 |
取整帶來兩個後果(用公式推出來的,論文沒有討論)。第一,係數要到 才會是 0,但一次進化只跑 到 ,所以預算永遠到不了 ,最小停在 2。第二,取整之後整個排程只剩 4、3、2 三個台階(完整的 20 輪表格在 A 一節)。餘弦形狀只決定台階在哪一輪切換,與學習率排程不同:學習率是連續值,形狀真的影響訓練。這裡是整數,餘弦與直線遞減會得到幾乎一樣的結果。
這個排程背後還有一條更通用的設計教訓:把多個修改綁在同一個候選裡,它們共用同一組量測結果,紀錄看起來像各自貢獻,其實只是合起來的貢獻。所以每次變更盡量單一、可歸因。不得不綁時,別把共用的分數當成各自的分數。如何在不得不綁定時把功勞分給各個修改,是另一個獨立的主題,這裡沒有展開。
8.7 概念七:怎麼推動 proposer 去探索
先分清楚「探索的數量」指的是哪一個:
| 數量 | 怎麼決定 | 過程中會變嗎 |
|---|---|---|
| :每個候選最多綁幾個修改 | 由 Eq. 4 的公式決定 | 只降不升(4 到 3 到 2) |
| :停滯時保留的探索名額 | 表 5 的超參數,三個領域都是 1 | 固定不變,只有偵測到停滯時才啟用 |
| 的大小:還沒碰過的元件類別數 | 全集 (9 類)減掉已碰過的 | 只減不增,起點是 9 |
- :Appendix D.1 只說所有超參數都用 evolve 環境和實務上的考量(operational considerations)選定,沒有敏感度分析,為什麼是 1,論文沒有交代。
- :全集 是寫死的 9 類,而已碰過的類別是累積的(碰過就一直算),所以 只會縮小。元件被剪枝刪除後會不會回到 ,論文沒說。
- 每輪總共有幾個候選,論文裡找不到具體數字,所以「保留 1 個名額」佔全部候選的多少比例,無法判斷。
「強制探索」其實沒有被強制。 論文的用詞只有 reserved(保留)、redirect(導向),沒有寫任何強制機制。論文實際給了什麼:
- 檢查 :最近 輪的進步有沒有超過雜訊帶 。
- 算出 :還沒碰過的元件類別。
- 打包成 ,作為 proposer 的輸入之一(Eq. 8、Algorithm 1 第 6、8 行)。
- proposer LLM 產生候選,論文沒說它如何使用 。
- 候選照常通過 critic 與 selection。沒有任何一步檢查 proposer 有沒有照做(critic 擋的是洩漏,不是探索)。
自編例子:假設 被寫成一段文字放進 proposer 的提示:「最近 3 輪進步在雜訊內。請至少提出 1 個候選,修改下列尚未嘗試過的元件之一:skill、memory、subagent、client_tool。」proposer 是否照做,完全靠 LLM 遵守提示。論文的文字有兩種讀法:
| 讀法一:只是提示裡的一句指示 | 讀法二:程式層面另外處理 | |
|---|---|---|
| 意思 | LLM 自己決定要不要遵守 | 例如專門開一次只准改 的提案呼叫 |
| 後果 | 探索效果不保證,proposer 可以忽略 | 探索名額一定會產生 |
論文無法判定。推論:讀法一比較可能,因為 Appendix C 全部用 這種「輸入條件」的語言在描述。
論文裡比較硬的探索推力在篩選端:Eq. 17 中的 項,讓「嘗試了從來沒有出現在獲勝修改裡的結構性元件」的候選多拿一份加分,比較容易被接受。這才是真正偏袒新嘗試的規則,但有三個限制:只在分數落在雜訊帶內時才用。只對 client_tool、skill、memory、subagent 四類結構性元件有效。「新」的定義與 C 不同(C 看「有沒有被量測過」,加分看「有沒有贏過」)。而且論文說權重 列在表 5,實際沒有,所以這個加分有多強從論文無法得知。
8.8 概念八:被 critic 擋掉的候選去哪了
被 critic 在評分前擋掉的候選沒有分數,而歷史紀錄的每一筆都需要分數,所以它們大概不在歷史紀錄裡,proposer 也就看不到「哪些點子因為洩漏被擋」。
一個候選經過的順序(論文 Section 3.3 與 Appendix C.3 都寫 critic 在完整評估之前執行):
- proposer 提出候選。
- critic 讀程式碼差異,判斷有沒有寫死題目資訊。被擋就到此為止,不會被拿去跑 evolve set。
- 通過的候選在 evolve set 上完整評分,得到 、。
- 寫進歷史紀錄 。
分數(、)是第 3 步跑完才會產生的。被擋的候選停在第 2 步,從來沒被執行過,所以沒有分數。歷史紀錄的每一筆是七元組, 與 是必填欄位,沒有分數就填不完。論文 Appendix C.2 在寫出紀錄公式之前有半句 “Ignoring candidates that fail before a valid measurement is obtained”,意思是先不考慮那些還沒拿到有效量測就失敗的候選。
後果是 proposer 讀 來調整提案,被擋的候選不在裡面,它就不知道有哪些點子曾經被擋過。自編例子:某一輪候選 W 在 prompt 裡加了一句「遇到 Acme 公司的報表要用 YY 格式」,被 critic 擋掉。下一輪 proposer 讀 ,完全沒有 W 的痕跡,可能再提出類似的東西,critic 又擋一次。代價是浪費一個提案名額加一次 critic 呼叫。推論:不會浪費 evolve set 的評分預算,因為被擋的候選不會被評分。
這裡有個不確定。上面那半句是寫公式時的記法,沒有明說「critic 擋掉的候選一定不進紀錄」。論文文字有兩種讀法:
| 讀法一 | 讀法二 | |
|---|---|---|
| “fail before a valid measurement” 指什麼 | 包含被 critic 擋掉的候選 | 只指執行失敗、環境壞掉這類,沒有包含被 critic 擋掉的 |
| 後果 | proposer 看不到洩漏被擋的紀錄,可能重複提出 | 被擋的紀錄可能透過別的管道(例如本輪的 )傳給 proposer |
論文文字無法判定。旁證是 Appendix E 說專案網站公開完整的逐輪紀錄,包含 critic 的決定,所以 critic 的決定有被記錄下來,但記到哪裡、proposer 有沒有讀到,論文沒有寫。
這件事背後有個通則:能在拿到誘因之前擋掉的東西,不要等拿到之後再處理。critic 先審查,被擋的候選就永遠拿不到那個會讓它顯得有吸引力的高分,後續輪次也不會被它的高分誤導。代價就是上面說的:被擋的候選沒有量測值,不能寫進「每個修改附上分數」的紀錄。
if critic_flags(diff):
    reject(candidate)               # 先審查,沒有分數可以偏袒它
else:
    score = evaluate(candidate)     # 通過審查才拿去評分
8.9 概念九:雜訊帶內規則的兩個疑問
這裡的規則指 Eq. 17:候選進步沒超過雜訊帶 時,用 決定要不要收。
疑問一:coding 為什麼把 設成 0? 論文沒有說原因,只寫了結果:coding 的 ,所以雜訊帶內的分數進步不能單獨讓候選通過,要靠省成本或試新結構。agentic 與 engineering 用正的 ,也沒解釋為什麼三個領域不一樣。
推論(論文沒這樣寫):這條規則的目的是「不要把小幅的分數波動當成足夠的證據」(Appendix C.3), 是把這個原則做到最徹底,雜訊帶內的分數變化完全不算數。但這個推論有個破洞:coding 的 是 0.017,engineering 的 是 0.020,比 coding 還大,engineering 卻用正的 。所以「 大,所以不信分數」不能解釋三個領域的差異,找不到一致的理由。
疑問二:這條規則是為了讓小幅進步的修改也有機會被接受嗎? 只對一半。
| 說法 | 判斷 | |
|---|---|---|
| 論文寫的目的 | 避免把小幅分數波動當成充分證據 | 目的偏向防守,不是幫小進步開門 |
| 這條規則的角色 | 雜訊帶內的候選不受 Eq. 7 的成本上限約束,需要另一套規則決定收不收 | 它處理的是「分不出是真進步還是雜訊」的灰色地帶 |
| 小進步能不能被收 | 可以,但走的路不是靠進步 | 對的部分 |
小進步的候選確實有機會被收,但在 coding 裡,被收的原因是「省成本」或「試了新結構」,分數進步本身不算分。用兩個自編候選看(coding,都在雜訊帶內):
| 候選 | 分數 | 成本 | 結果 |
|---|---|---|---|
| S | 多 1 題 | 省 10% | 通過,因為省成本(只要 ) |
| T | 多 1 題 | 多 26% | 拒絕 |
兩個候選的分數進步一樣,結果不同,決定因素完全是成本。所以在 coding 裡,這條規則更像是「雜訊帶內的候選,只有更便宜或更新奇才留」。agentic 與 engineering 因為 是正的,小進步才真的有加分。
這條規則還留下一個設計教訓:兩個分支(進步超過雜訊帶走 Eq. 7、沒超過走 Eq. 17)在邊界兩側寬鬆度差很多,才會有前面那個 3 題與 4 題的懸崖。設計門檻規則時,要檢查邊界兩側是不是差太多。
9 結論
RRSI 點出了 harness 自動進化的一個真實問題:每一輪都用同一批題目評分,進化分數會漲,換題目後的進步卻會縮水。它用提案端(A、B、C)加篩選端(D、E、F、G)一整包護欄來管,在 agentic 領域的 ablation 裡,加上護欄後進化用題目少拿 2.3 分,OOD 多拿 3.3 分,token 省 36%。
我的判斷是研究價值偏低、工程參考價值中等偏上,因為這篇論文本身的證據有限:所有數字沒有變異數,「泛化」只是同類任務之間換題,每個零件都沒有單獨的 ablation。比較值得借用的是設計原則:進化與驗證用的題目要分開、先量評分雜訊再決定什麼算進步、成本要用分數來換、每個修改都留紀錄,以及評估自動進化系統時,要看沒參與決策的題目和成本,不能只看它自己的分數。