檢索索引能自己診斷、自己修嗎?拆解 SELF-INDEX 的亮點與盲點
 Hong-Wei Wu
收錄於 論文介紹
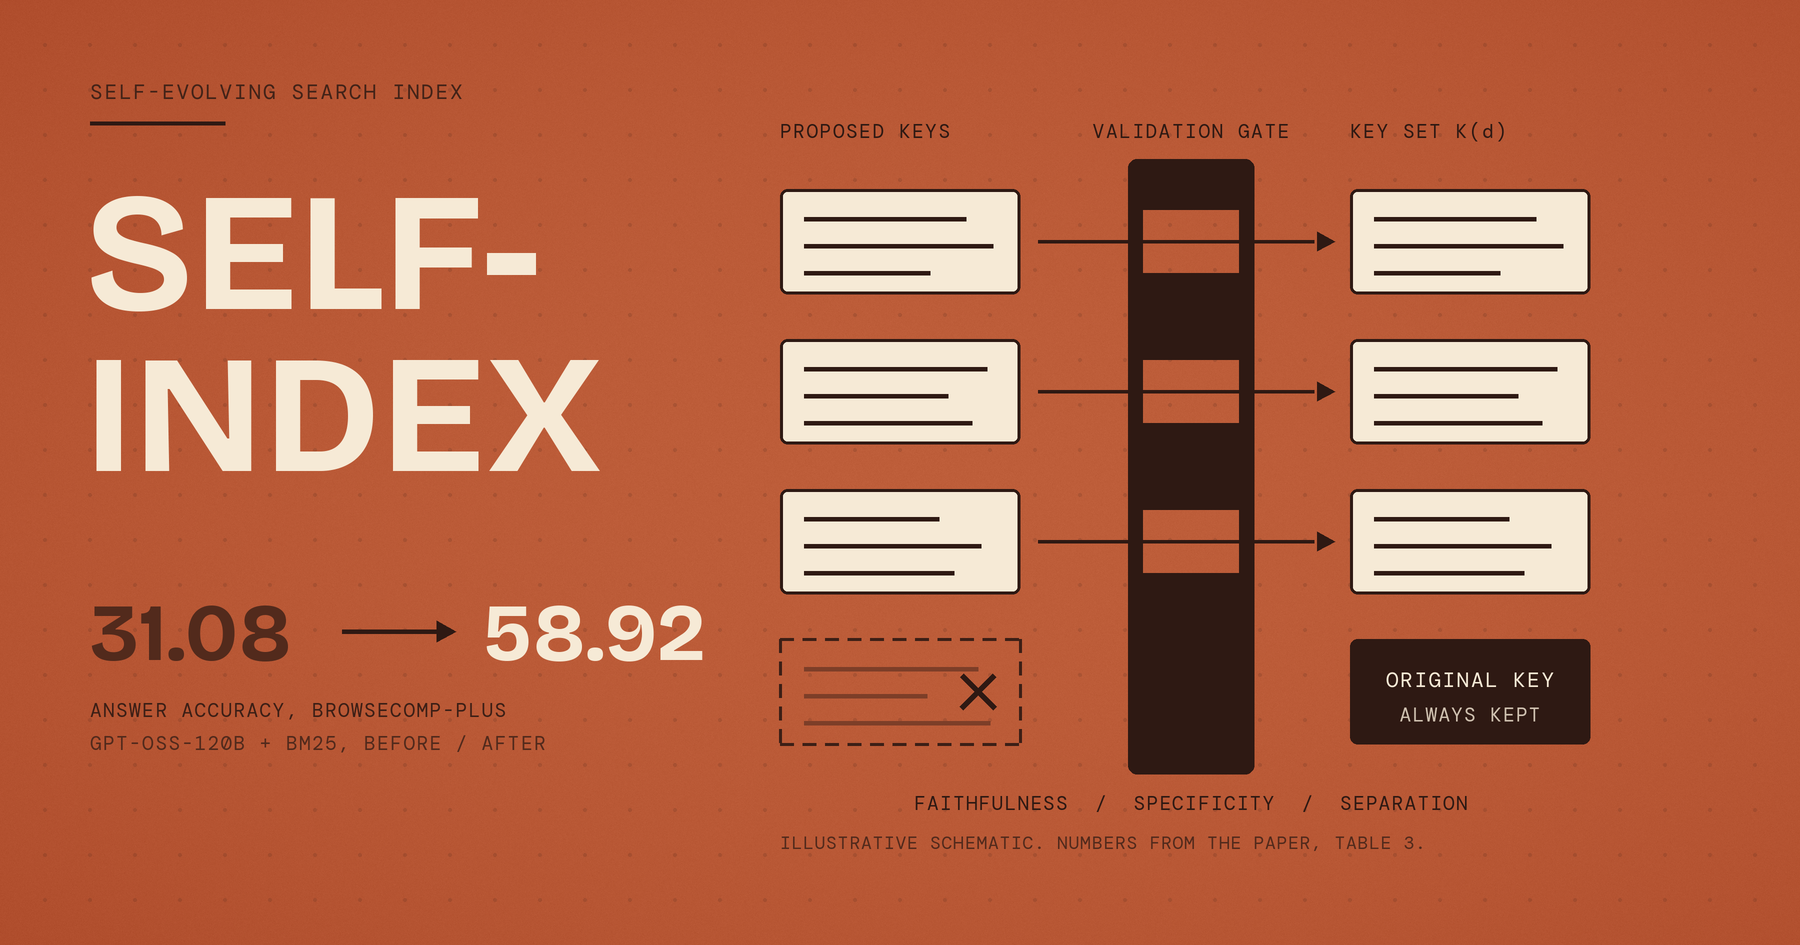
- 它做什麼:SELF-INDEX 讓一個 LLM(Optimizer)自己診斷索引的缺陷、只修有問題的那一小部分、驗證有效才寫進索引,再搭配 Query Simulator 主動生成還沒被問過的查詢,不需要人工標註,也不必重跑整個語料庫。
- 效果:在 BRIGHT 的九種組合(三種語料乘三種檢索器)全部拿下最高分,相對提升 +38.8% 到 +57.0%;BrowseComp-Plus 上 GPT-OSS-120B 搭 BM25 的答案準確率由 31.08 升到 58.92。
- 最值得帶走的設計:驗證閘門。消融實驗顯示拿掉整個 Self-Validation,效果甚至比原始索引還差。
- 保留之處:判斷 key 是否忠實的裁判,與生成 key 的 Optimizer 是同一顆 backbone;附錄案例全是精選的成功案例;與 DCI 的比較條件沒有完全對齊。
1 前言
做過 RAG 或搜尋系統的人大概都碰過這件事:文件明明在庫裡,使用者用口語一問卻撈不到,只好有人去看失敗案例、手動調整文件的索引寫法,再把整個語料庫重新處理一遍。這篇文章要介紹的 SELF-INDEX,想把這個「人工診斷、人工改策略、全量重跑」的迴圈整個自動化:讓一個 LLM 自己找出索引哪裡寫得不好、只修有問題的那一小部分,並且在修完之後先驗證,通過才真的寫進索引。
我對這篇論文的整體評價是工程價值高、研究價值中等偏低,理由在「論文速覽與整體評價」一節。文章的中段把幾個論文沒講清楚、但讀的時候很容易誤解的細節單獨拆開來談,例如「診斷是不是對全部文件都跑一次」「被保留的舊 key 要不要重新驗證」「裁判和生成者是同一顆模型代表什麼」。這些部分的資訊量,我認為不輸論文本身。
2 論文速覽與整體評價
論文是〈Self-Evolving Search Index〉(arXiv 2609.19656v1),來自 Yonsei University 與 Samsung Research,2026 年 9 月發表。核心想法是讓檢索用的「索引」自己進化。一個稱為 Optimizer 的 LLM 負責三件事:診斷索引的缺陷、只修有問題的部分、驗證修訂有效才套用。另一個稱為 Query Simulator 的元件,則主動生成「還沒被問過、但可能會被問」的查詢,讓索引不只對已知問題做反應。
工程價值高,原因有四:
- 「選擇性修訂加驗證閘門」是最實用的設計。消融實驗顯示,把整個驗證機制拿掉,效果甚至比原始索引還差,所以把關不是加分項,而是讓整套機制成立的前提。
- 下游驗證做得扎實。論文不只看檢索指標,還接到真實的 agent 任務(BrowseComp-Plus,看答案準確率與成本)與 agent memory 系統(LongMemEval-V2)。
- 論文主動做了排除混淆變因的對照:把對照組 SPIKE 的計分方式換成與自己相同,證明贏的是 key 的品質,不是計分技巧。
- 有量化成本。多數迭代點上,累積成本比對照組全語料重建索引還低,效果卻更好。
研究價值中等偏低,原因有三:
- 三個核心元件都不是新東西,後面「值得帶走的東西」會逐一拆解。
- 驗證機制有結構性弱點:判斷 key 忠不忠實的裁判,與生成 key 的 Optimizer 是同一顆 backbone 模型(Qwen3.6-35B-A3B)。論文沒有報告人工抽查裁判準確度,也沒有做「換一顆獨立模型當裁判」的對照。
- 附錄的案例研究全是精選的成功案例(作者自己在附錄開頭承認),沒有失敗案例分析,讀者只能從消融數字反推這套機制什麼時候會壞。
下面先把幾個會反覆出現的名詞講一下:
- backbone:驅動這些角色的底層 LLM。
- BRIGHT:論文的主要檢索評測集,共 12 個資料集,分成自然語言、程式碼、數學三類語料。
- nDCG@10:衡量前 10 名檢索結果排序品質的指標,越高越好。
- Doc2Query、SPIKE:兩個既有的索引優化方法,Doc2Query 用 LLM 為文件生成可能被問到的查詢,SPIKE 則為文件生成情境式的 key,並一次性對整個語料庫建構。
- 消融實驗:逐一拿掉系統的某個元件,看效果掉多少,用來判斷這個元件有沒有用。
接下來的順序是:背景與問題、整體架構、Optimizer 的三個階段、Query Simulator、實驗與消融,最後整理哪些東西值得帶走。
3 背景:這篇論文想解決什麼問題
3.1 Index key 是什麼
索引不是文件本身,而是文件的「代表」。語料庫裡每篇文件 會被賦予一組 index key,記作 ,檢索器實際拿去跟查詢比對的是這些 key。一篇文件對查詢的分數,取它所有 key 裡最相關的那一個:
這裡 是查詢, 是檢索器算出來的相關性分數。
舉個例子:一篇講「手部肌腱解剖構造」的教科書段落,最原始的做法(記作 ,也就是第 0 版索引)是把整段原文當唯一的 key。但使用者可能用口語問「為什麼無名指不能單獨動?」,這句話和教科書用詞差很遠,向量相似度不高,這篇文件就排不進前面。所以才需要多生成幾個用不同角度、不同用詞描述同一篇文件的 key,讓文件有更多被找到的入口。這整套「幫文件生成或修改 key」的操作,叫 index optimization(索引優化)。
3.2 挑戰一:沒有一種優化策略能通吃
索引優化的效果高度依賴檢索環境,包括語料類型(自然語言、程式碼、數學、表格)與檢索器(BM25 這類稀疏檢索,或向量嵌入這類密集檢索)。論文引用既有文獻指出,在一種環境有效的策略,換到另一種環境可能打折甚至變差。後面的實驗會看到,Doc2Query 在表格檢索搭配 BM25 時大幅提升,換成密集檢索器卻變成負提升。換句話說,寫死一套 key 生成規則然後到處套用,行不通。
3.3 挑戰二:進化索引完全靠人工
這是論文真正想打的痛點。現有方法要進化一個索引,人得重複做三件事:
- 人工診斷:觀察哪些查詢檢索失敗,判斷是哪些 key 出了問題。
- 人工修改優化策略:手動調規則,或蒐集新標註資料重新訓練。
- 重新處理整個索引:新策略要套用到全部文件,計算成本高。
而且這個迴圈不會做一次就結束,新的失敗案例會不斷冒出來。論文特別點出第三步的浪費:就算只發現某一小群文件的 key 設計得差,現有方法通常還是得把修改後的策略套到整個語料庫。
3.4 挑戰三:只能被動反應
假設前兩個問題都解決了,Optimizer 仍然只能對「已經收到的查詢」做反應。如果某種問法從來沒出現過,索引在這個面向上有缺陷,Optimizer 也完全不會發現。這就像客服部門只會改善「已經有人抱怨過」的問題,不會主動去想還有哪些客戶可能遇到卻沒抱怨的狀況。
3.5 解法,一句話
論文把人工迴圈換成自動、選擇性的迴圈。Optimizer 讓 LLM 自己診斷、只修有問題的 key、自己驗證修改是否有效,不需要人工介入,也不必重處理整個索引。另一個元件 Query Simulator 則主動生成沒被問過的查詢,補上「被動反應」這個缺口。
4 SELF-INDEX 的整體架構
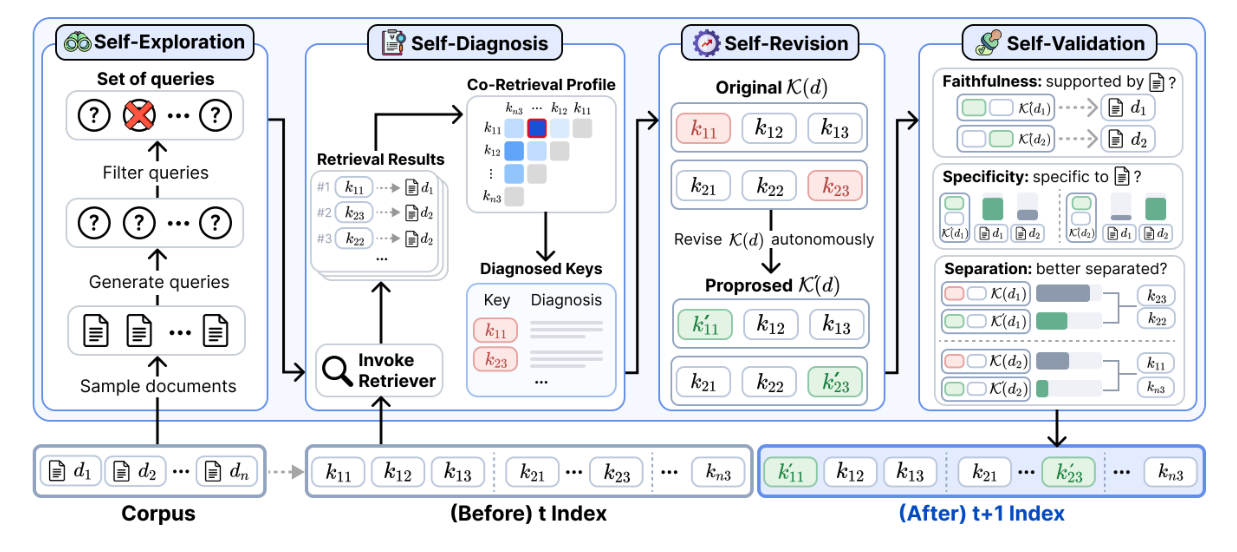
原圖還畫出了每個階段內部的資料結構(co-retrieval profile 矩陣、 到 的對照、三個驗證準則的長條圖),下面用文字走一遍一輪迭代的資料流:
- 兩個查詢來源匯流:真實使用者查詢與 Query Simulator 生成的模擬查詢合併成同一批 ,Optimizer 不區分來源,處理方式完全一樣。
- Self-Diagnosis:先看這批查詢的檢索結果,找出哪些文件的 key 表現不好。
- Self-Revision:只有被診斷出問題的文件,才會被重新設計 key。沒問題的文件完全不受影響,這就是「選擇性」的精髓。
- Self-Validation:Self-Revision 提出的新 key 要通過三重驗證,沒通過就維持原狀。
- 索引更新:只有通過驗證的修訂才會寫進索引,索引從 版本進化到 版本。
- 下一輪: 版本成為下一輪的起點,用新的一批查詢再跑一次。這就是「self-evolving」名稱的由來。
接下來三節依序展開 Self-Diagnosis、Self-Revision、Self-Validation,也就是 Optimizer 的內部機制。
5 Self-Diagnosis:沒有人工標註,怎麼發現索引有問題
Self-Diagnosis 的工作,是看著這批查詢的檢索結果,判斷索引裡哪些 key 有問題,整個過程不使用任何人工標註的相關性標籤,這就是 SELF-INDEX 敢說「不需要人工介入」的具體依據。
5.1 不是對所有文件都診斷
Self-Diagnosis 只針對「這一批查詢有檢索到其 key 的文件」做診斷,不是每篇文件都跑一次。對應 Algorithm 1 的原文邏輯:
foreach document d with a retrieval feedback record do
    diagnosis ← DIAGNOSE(feedback[d])
關鍵在 with a retrieval feedback record 這個限定詞:只有出現在 feedback 集合裡的文件才會進迴圈,而 feedback 只收錄「這批查詢的 top- 結果裡,至少出現過其一個 key」的文件。
用數字感受一下:資料庫有 100 篇文件,這一輪有 128 個查詢(論文實驗的 batch size),每個查詢取 top-30 個 key。檢索結果會集中在一小部分文件上,假設最後只有 45 篇文件的 key 曾出現,那這一輪就只呼叫 45 次診斷,不是 100 次。
跟這批查詢無關的文件,連被 LLM 看一眼的機會都沒有,成本自然壓低。這也解釋了論文附錄 Table 20(即後面的表 6)的現象:累積成本隨查詢批次數(迭代輪數)增長,不是隨文件總數線性增長。
5.2 回饋資料怎麼收集(Algorithm 2)
論文的 Algorithm 2 負責把檢索結果整理成診斷用的 feedback,步驟如下。
輸入有四項:查詢批次 (可能混合真實與模擬查詢)、語料庫 、這一輪開始前固定住的索引快照 ,以及檢索深度 (實驗設為 30)。快照要固定,是為了讓整輪診斷都根據同一個索引版本,不會因為中途索引被改動而讓比較失真。
- Step 1:對批次裡每個查詢 ,從快照取回排名前 的 key,結果記作 ,跑完得到 組 。
- Step 2:把所有查詢的 彙整起來(看整批結果,不是逐一處理),統計出每個被檢索到的 key 的 co-retrieval profile,記作 。
- Step 3:前兩步以查詢和 key 為單位,但輸出要以文件為單位。只要文件 底下至少有一個 key 出現在任何一個 裡,就為它建一筆記錄。記錄內容包含原文、目前完整的 key 集合(不只被檢索到的那一個)、這些 key 的 co-retrieval profile,以及哪些查詢檢索到了它的 key、分數多少。
輸出是一個以文件為索引的字典 feedback,送進 Self-Diagnosis 的 LLM 呼叫。
5.3 co-retrieval profile:診斷的核心訊號
先講直覺。想像幫每本書寫索引卡,讀者拿問題來查卡片找書。如果某張卡寫得太籠統(「這是一本關於機器學習的書」),幾乎任何跟機器學習沾邊的問題都會把它跟一堆其他書的卡片一起翻出來。寫得夠精準的卡片,只會在真正相關的少數查詢下,跟少數真正相關的卡片一起出現。所以「常常跟很多不同文件的 key 一起被檢索到」本身就是線索,暗示這個 key 可能太籠統。
資料結構上,對某個 key , 是一張計數表,記錄「其他文件的某個 key,跟 一起出現了幾次」。做法是把整批查詢的檢索結果掃一遍,每次看到 跟另一個 key 同時出現,那個 key 的計數加一。
下面是我自己構造的小例子,用來說明機制,論文沒有給到這麼細的走查。假設只有 3 個查詢,檢索深度 :
| 查詢 | 檢索到的 top-3 key(依序) |
|---|---|
| q1 | key A(文件 1)、key B(文件 2)、key C(文件 3) |
| q2 | key A(文件 1)、key C(文件 3)、key D(文件 4) |
| q3 | key A(文件 1)、key E(文件 5)、key B(文件 2) |
算 key A 的 profile:q1 裡跟它同現的是 B、C,q2 是 C、D,q3 是 E、B,累加起來:
也就是 key B 與 key C 各同現 2 次,key D 與 key E 各 1 次。
這張表會送給 LLM,讓它判斷「key A 幾乎每次都跟一堆不同文件的 key 混在一起,可能沒有把文件 1 特有的資訊凸顯出來」。
5.4 借來的老概念:Pseudo-relevance feedback
這一段是資訊檢索的通用背景知識,不是這篇論文的內容,論文只是借用了它的精神。以搜尋 “jaguar” 為例,這個字可能指美洲豹,也可能指 Jaguar 汽車。傳統 relevance feedback(Rocchio, 1971)的做法是先檢索一輪,請真人標記哪幾篇相關、哪幾篇不相關,再依標記調整查詢向量,往相關文件拉近、往不相關文件推遠,最後用調整後的查詢再檢索一次。問題是現實中不可能每次搜尋都找人標記。
Pseudo-relevance feedback(Lavrenko & Croft, 2001 等)乾脆跳過人工標記,假設第一輪排名最前面的少數結果大概率相關,直接拿來當「相關文件」用。走一次:查 “jaguar” 的前 5 名有 4 篇講汽車,就假設這 4 篇相關,從中抽出常見詞(engine、horsepower)加進原查詢,再檢索一次,結果就更精準地鎖定汽車,因為新增的詞已經排除了動物的歧義。「pseudo」就是這麼來的:整個機制假裝有人驗證過,實際只是拿排名當代理指標。
SELF-INDEX 沒有用 PRF 去擴展查詢,而是借用「用檢索結果的排名與共現模式當代理訊號,跳過人工標註」這個精神,轉去診斷 index key 本身寫得好不好。這是合理的延伸,不是換名詞包裝。
5.5 LLM 的輸出格式,以及論文自己承認的限制
論文附錄的 Table 6 是 Self-Diagnosis 的 prompt(這幾張 prompt 表不在本文收錄的圖表內,編號與本文的表格無關),LLM 輸出的 JSON 長這樣:
{
  "diagnoses": [
    {"key": "<某個 key 的編號 或 key_set>", "cause": "<為什麼這裡有問題>"}
  ],
  "revision": "<接下來該怎麼改,用文字描述>"
}
有三個細節:
key_set是特殊值,用在問題不是出在某個特定 key,而是整組 key 加起來都沒涵蓋某種需求時。- 這一步只給「哪裡有問題、往哪個方向改」的文字,不會直接生成新 key,生成是下一步的事。
- 如果沒發現問題,兩個欄位都留空,這篇文件這一輪完全不會被動到。
論文在 prompt 裡自己承認一個限制:多篇文件可能都能滿足同一個查詢,所以「兩個 key 常一起被檢索到」本身不能直接當成「key 有問題」的證據。搜尋「怎麼申請信用卡」同時撈到 A 銀行與 B 銀行的申請流程,完全合理。因此 Self-Diagnosis 不是「共現次數超過門檻就判定有問題」的機械規則,而是把 profile 當參考,連同文件原文、現有 key、查詢文字一起交給 LLM 綜合判斷。代價是診斷品質高度依賴 LLM 的判斷力,不是一套可驗證、可重現的規則。
5.6 一次完整診斷長什麼樣子
論文沒有給「prompt 填入真實資料、LLM 回傳什麼 JSON」的逐字範例。下面借用論文 Appendix D.1.1(肌腱與無名指的案例)的情境重建一個示範,整段是我自行構造,不是論文原文。
情境是索引演化的早期,文件的 key 集合只有原文全文()。
LLM 的輸入:
DOCUMENT:
<<<DOC START>>>
On the back of the hand, the tendons to the middle, ring, and
little fingers are connected by two obliquely placed bands...
<<<DOC END>>>

CURRENT KEYS (numbered):
1. [原始文件全文,同上]

RETRIEVAL FEEDBACK:
查詢1: "Why does the ring finger not move independently?"
  → key 1,排名第 24,分數 0.31
查詢2: "What connects the tendons of the fingers on the back of the hand?"
  → key 1,排名第 5,分數 0.52
查詢3: "why can't I move my ring finger on its own"
  → key 1,排名第 29,分數 0.22

key 1 的 co-retrieval profile:
跟「其他講手部解剖構造的文件」的 key 共同出現 4 次
跟「講肌腱損傷與修復的文件」的 key 共同出現 2 次
LLM 的輸出:
{
  "diagnoses": [
    {
      "key": 1,
      "cause": "這個 key 是純解剖學描述,只講了肌腱之間的物理連接方式,
                沒有回答『為什麼無名指不能單獨活動』這種功能性、
                因果性的提問。用比較貼近解剖學原文用詞的查詢2排名
                相對較好(5名),但用功能性、因果性語氣問的查詢1、3
                排名很差(24、29名,已經貼著前 30 名的邊緣),這種對比模式正是診斷的依據。"
    }
  ],
  "revision": "需要新增一個 key,把『肌腱物理相連』這個解剖學事實,
               明確轉譯成『為什麼手指的活動自由度會因此受限』這種
               功能性的說法,讓搜尋『為什麼』的使用者也能找到這篇文件。"
}
範例裡刻意放了 3 筆查詢,是因為 Algorithm 2 第 6 行寫的是對「每個」檢索到該文件 key 的查詢都附上查詢文字與分數,多筆全部塞進同一筆 feedback。要看到多筆查詢的排名對比,才會浮現「這個 key 對某一類問法特別弱」的規律,只給一筆就看不出來。
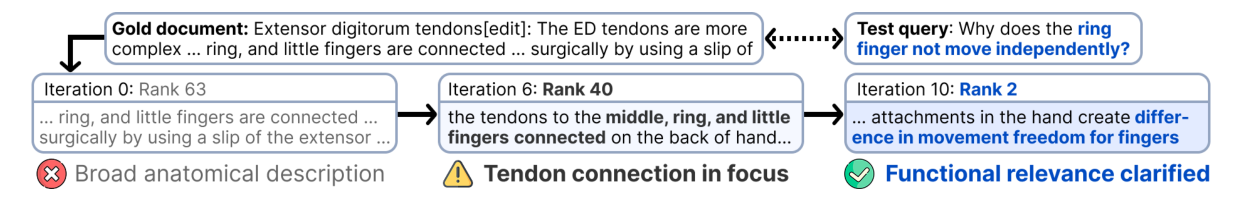
另外要注意,"key": 1 指向的是原文 key,而原文 key 本身不會被修改,它不受 Self-Revision 與 Self-Validation 約束。診斷指向它,只是說明現有表達覆蓋不到這個查詢角度,實際的補救是下一步新增一個 key,不是改寫 key 1。
5.7 原文 key 會永遠留在索引裡
不管經過幾輪迭代,每篇文件都固定保有一個原文 key。Algorithm 1 更新索引的那一行是:
是文件原文, 是這一輪通過驗證的生成 key。每一輪 都是「固定的原文 key」加上「當前有效的生成 key」,原文從頭到尾都在。論文 Appendix A.1.1 的說法是:原文 key 一直被保留,檢索時與生成的 key 一起計分,既不被修訂,也不需要驗證。
整組 key 的總數上限是 10 個(),這個上限包含原文 key,所以一篇文件最多是 1 個原文 key 加 9 個生成 key。這是一個安全網:就算所有生成的 key 全部驗證失敗,文件也不會變成完全沒有 key 可以被檢索。
6 Self-Revision:選擇性修訂
6.1 為什麼整組 key 要一起修
論文在 Section 3.2 的理由是:一篇文件的 key 集合是共同在代表它的,如果只挑被診斷出問題的那一個單獨修,修的人(LLM)看不到同組其他 key 已經涵蓋什麼,很可能寫出重複的內容。
打個比方:一篇文件的 3 個 key 分別負責回答「這是什麼」「怎麼用」「常見問題」。只單獨修「這是什麼」,修的人不知道旁邊已經有一個 key 專講「怎麼用」,很容易順手把「怎麼用」也塞進去,造成重複。所以只要文件有任何一個 key 被診斷出問題,就把整組現有的生成 key 一次攤開給 LLM,讓它判斷整組要怎麼調。
6.2 competing-key set:「別人怎麼寫」的參考資料
Self-Revision 要生成新 key,需要知道別的文件怎麼描述類似內容,才能刻意寫得不一樣。這份參考資料叫 competing-key set(競爭 key 集合)。設 是文件 被診斷出問題的 key 集合,則:
其中 是 profile 裡那些來自其他文件的 key。這一步只取「有哪些 key」,不看共現次數。論文在 Self-Validation 那段明講,共現頻率用於診斷與修訂,而這個準則比較 key 配對時不做頻率加權。
延續「co-retrieval profile」那一節的例子:假設這一輪只有 key A 被診斷出問題,則 ,次數在這一步被丟掉了。這份清單會放進 Self-Revision prompt 的 COMPETING KEYS 欄位,讓 LLM 寫新 key 時避開撞內容;之後 Self-Validation 的 Separation 準則會再用一次同一份,這是論文讓兩階段共用計算結果的設計。
6.3 保留、重寫、移除:三種命運都有
Self-Revision 不是只會新增 key。論文附錄 Table 7 的輸出格式是:
{"keep": ["<要保留的舊 key 編號>"],
 "revised": ["<新的 key 文字>", "..."]}
prompt 的指示是留下還有用的 key,把被診斷出問題的 key 砍掉或重寫,最多寫一個上限數量的新 key 或重寫過的 key。三種命運的判定方式:
| 舊 key 的命運 | 怎麼發生 |
|---|---|
| 保留 | 編號出現在 keep 清單裡,原封不動 |
| 重寫 | 沒出現在 keep,但 revised 裡有一則新文字,內容上取代它的角色 |
| 移除 | 既不在 keep,revised 裡也沒有對應的重寫版本,就這樣消失,不需要額外的刪除指令 |
那為什麼 revised 不必標明是「新增」還是「修改」?因為最終的 key 集合是用聯集組出來的(就是上面那行 ),不是用差異比對組出來的。系統只在乎這一輪結束後 裡有哪些字串,不在乎某個字串概念上取代了誰。區分新舊,只有做案例分析、回頭追溯某個 key 怎麼演化時才有用。
6.4 延續肌腱案例的修訂範例
先釐清一個細節。論文 Appendix A.1.3 說,即使診斷指出原文 key 有問題,這個診斷也會被折疊進修訂指引。原文 key 永遠不在可修改的候選名單裡,所以 CURRENT KEYS 欄位不會多出一個 key 1,診斷意見只會變成 SUGGESTED CHANGES 裡一句「該往哪個方向補」的話。第一輪迭代還沒有任何生成 key,所以 CURRENT KEYS 其實是空的,這正是論文說「第一次提案使用同一個 prompt,只是生成 key 的清單為空」的意思。
以下同樣是我自行構造的示範。Self-Revision 收到的輸入:
DOCUMENT:
<<<DOC START>>>
On the back of the hand, the tendons to the middle, ring, and
little fingers are connected by two obliquely placed bands...
<<<DOC END>>>

CURRENT KEYS (numbered; a diagnosed key is marked):
(尚無生成的 key)

SUGGESTED CHANGES FROM SELF-DIAGNOSIS:
需要新增一個 key,把「肌腱物理相連」這個解剖學事實,明確轉譯成
「為什麼手指的活動自由度會因此受限」這種功能性的說法,讓搜尋
「為什麼」的使用者也能找到這篇文件。

COMPETING KEYS(同一批查詢裡,其他文件的 key):
- "手部肌腱損傷後的修復與復健流程"(來自另一篇講肌腱受傷的文件)
- "手指關節活動範圍的一般解剖學說明"(來自另一篇通用解剖文件)
LLM 的輸出:
{
  "keep": [],
  "revised": [
    "這篇文件說明了手背肌腱之間的束帶連結結構,能解釋為什麼某些
     手指無法完全獨立活動,這種物理上的束帶連結,限制了個別手指
     的活動自由度"
  ]
}
keep 是空陣列,合理,因為沒有舊的生成 key 可以留。新 key 刻意用「無法完全獨立活動」「限制了活動自由度」這種功能性語言,而不是重複解剖學術語,回應了診斷給的方向。對照 COMPETING KEYS,新 key 講的是「為什麼受限」,跟「修復流程」是不同的資訊需求,沒有撞內容,符合 prompt 裡 SEPARATED 這條要求。
6.5 兩個保守設計:整輪不更新,與跨輪重修
論文寫道,如果新提議的 key 通過了三個準則, 變成固定的原文 key 加上所有通過的生成 key,否則維持不變。也就是說,revised 裡連一個新 key 都沒通過,這一輪的更新就整個不生效,不會因為驗證失敗而損失原本有效的舊 key。要嘛有實質進步才更新,要嘛什麼都不動。具體的判斷順序留到下一節。
另外,一篇文件不是修過一次就定型。論文 A.1.3 說,文件可以在後續迭代中,根據更新後的 key 與新收集的檢索回饋再次成為目標。假設文件在第 1 輪加了一個新 key,第 5 輪又有一批新查詢撞到它、被診斷出新問題,Self-Revision 就以第 1 輪修完的版本為起點再修一次。論文 Appendix D.1.2(暈厥機制案例)就展示了同一篇文件的 key 在第 2、3、5、6 輪被連續修訂、一輪比一輪精準。
7 Self-Validation:三準則與生效判斷
後面的消融實驗會看到,拿掉整個 Self-Validation,效果會掉到比原始索引還差,所以這一節的每個細節都值得看清楚。
7.1 三準則總覽
論文先講什麼樣的 key 才算好,三個理論依據引用自 Salton et al. 1975 與 Morris & Rush 2025 等經典 IR 文獻:
- Faithfulness(忠實度):key 講的內容要真的被原文支持,不能憑空捏造。
- Specificity(特異性):key 要捕捉這篇文件特有的知識,不能是一堆文件都通用、沒有區辨力的內容。
- Separation(區隔度):key 要跟其他競爭 key 保持區隔,不要長得太像。
三者的檢查方式不同:
| 準則 | 檢查什麼 | 誰執行 | 通過條件 |
|---|---|---|---|
| Faithfulness | key 有沒有被文件內容支持 | LLM 裁判(與 Optimizer 同一 backbone) | 分數 ≥ 2(0 到 3 分) |
| Specificity | key 能不能撈回自己的來源文件 | 檢索器的 | 排名勝過來源文件的其他文件數 < |
| Separation | key 有沒有比現有整組 key 更遠離競爭對手 | 檢索器的 | 新 key 的最大相似度 < 舊整組的最大相似度 |
只有 Faithfulness 真的要問一次 LLM,另外兩個直接用檢索器已有的相關性函式套公式算數字,不需要額外 LLM 呼叫。能用數學定義清楚的交給便宜的計算,只有需要語意理解的才動用昂貴的 LLM 呼叫。三準則都只檢查生成出來的 key,原文 key 完全不受約束。
7.2 裁判和生成者是同一顆模型
論文 Appendix B.3 明講,Optimizer(Self-Diagnosis 加 Self-Revision)、Query Simulator,以及 Faithfulness 與 Answerability(後面 Query Simulator 一節會介紹)兩個裁判角色,全都用 Qwen3.6-35B-A3B。寫出 key 的 LLM,和判斷這個 key 是否忠實於原文的 LLM,是同一顆模型,只是 prompt 不同。
這像讓學生自己批改自己的考卷。如果模型本身有某種認知盲點,導致寫出的 key 帶有某種瑕疵,用同一套認知去檢查,很可能也檢查不出來,因為問題根源是同一套判斷邏輯,不是換一雙眼睛看。如果裁判是另一個獨立訓練的模型,兩者的弱點大概率不會完全重疊。
論文完全沒有報告這個「自己人審自己人」的機制跟人工抽查比起來準確率如何,也沒有做過換獨立模型當裁判的對照。這不代表設計一定有問題,而是沒有證據排除這個疑慮,這是這篇論文可信度上的一個明顯缺口。
7.3 Faithfulness:定義與實際操作之間的落差
文字定義(Appendix A.1.4)是檢查每個生成的 key 是否被文件支持、沒有扭曲資訊,聽起來像在抓幻覺與捏造。但論文附錄 Table 8 的 prompt 實際做的是:把每個 key 當成一則「搜尋語句」,問 LLM「如果有人真的打這個搜尋語句,這篇文件能不能滿足他的需求」,用 0 到 3 分打分:
| 分數 | 意思 |
|---|---|
| 0 | 文件跟這個需求完全無關 |
| 1 | 主題相關,但沒有真正滿足需求 |
| 2 | 文件滿足了這個需求,即使答案是部分的、隱含的 |
| 3 | 文件專門針對這個需求,包含明確答案 |
通過門檻是 ≥ 2。
定義說的是「有沒有被支持、有沒有扭曲」,打分問的卻是「文件能不能滿足這個搜尋需求」,兩者不完全等價。舉例:某個生成的 key 寫成「這篇文件解釋了 X 現象的三個成因」,但文件只明確講了兩個,第三個是 LLM 自己推論補上的。拿這個 key 去問「文件能不能滿足『了解 X 成因』」,裁判很可能仍給 2 或 3 分,因為需求確實被部分滿足,即使 key 裡摻了一句文件沒講的內容。所以「滿足需求」這個判準,對 key 細節層級的捏造,篩選力道可能不夠,論文對這個落差沒有進一步討論,也沒有消融。
效率上,Faithfulness 是批次呼叫:裁判在同一次呼叫裡收到文件與所有待驗證 key 的編號清單,一次打完全部分數。
7.4 被保留的舊 key 也要重新驗證
是的,沒有例外。論文 Appendix A.1.4 原文是 Optimizer 對 裡所有生成的 key 做三準則驗證,包含被保留的 key,只有原文 key 固定不動。所以 revised 的新 key 與 keep 的舊 key 一視同仁。
不過三個準則「該不該重跑」的道理並不相同,這是我推導的觀察,論文沒有討論:
- Faithfulness:輸入是文件原文與 key 文字,語料庫不變、key 文字沒變,理論上每一輪結果都一樣,除非裁判有取樣隨機性。
- Separation:比較對象 每輪可能不同,就算 key 沒變,結果也可能變,重跑有必要。
- Specificity:比的是別的文件的原文,下一節會看到這個設計讓結果也相對穩定。
所以「三者統一重跑」比較像論文為了簡單寫死的規則,可能是為了避免追蹤「哪些東西沒變不用重跑」的快取複雜度。
7.5 Specificity:能不能撈回自己的文件
直覺是這樣:把這個 key 本身當成搜尋語句丟去檢索整個語料庫,它能不能把自己所屬的那篇文件撈回來?key 寫得太籠統,語料庫裡一大堆文章都會被撈到,來源文件排不進前面,就代表不夠 specific。公式是:
是正在驗證的 key, 是它的來源文件, 是扣掉 的語料庫, 是其中任何一篇別的文件。白話翻譯:拿別的文件跟 比誰跟 更相關,贏過或追平 的別的文件數量小於 ,代表拿 去檢索時 能排進前 名,才算通過。
要注意 比對的是別的文件的原始文字,不是它們目前的 key 集合,所以別人的 key 怎麼修訂都不會影響這個 key 的判斷,避免了「用正在變動的東西去評判正在變動的東西」的循環。
數字例子(自行構造):語料庫只有 6 篇( 加 5 篇別的),檢索深度 設成 3 方便手算(論文實際是 30)。這裡的 是檢索深度,跟 那組 key 是不同的東西。
| 文件 | 情境 A: | 情境 B: |
|---|---|---|
| (自己) | 0.55 | 0.35 |
| d1 | 0.80 | 0.80 |
| d2 | 0.62 | 0.62 |
| d3 | 0.40 | 0.40 |
| d4 | 0.30 | 0.30 |
| d5 | 0.20 | 0.20 |
情境 A 裡贏過 (0.55)的有 d1、d2 共 2 篇,,通過,用這個 key 搜尋 會排在第 3 名。情境 B 是 key 寫得比較籠統, 自己只剩 0.35,贏過它的變成 d1、d2、d3 共 3 篇, 不成立,不通過,連前 3 名都排不進去。
這個設計的好處是沒有另外訓練「特異性分類器」,直接重複利用檢索器本身的相關性函式,不需要額外的 LLM 呼叫或訓練。
7.6 Separation:有沒有比現在更遠離競爭對手
這個準則問的是新提議的 key,有沒有比現有整組 key 更能跟競爭對手拉開距離,「競爭對手」就是 。公式分兩段:
是這一輪修訂前的整組 key, 是 裡的某個競爭 key。 是現有整組 key 對任一競爭者的最高相關性, 是新 key 對任一競爭者的最高相關性。通過條件是 。
為什麼取最大值而不取平均?論文的解釋是取最大值會把焦點放在最相似的那一對,平均會被一堆不相似的配對稀釋掉。一堆完全不像的競爭對手會把平均往下拉,掩蓋「其實有一個競爭對手長得很像」的危險訊號。
延續 ,假設文件 修訂前的整組 key 是 {key A, key F},相關性如下:
| key B | key C | key D | key E | |
|---|---|---|---|---|
| key A | 0.72 | 0.58 | 0.30 | 0.25 |
| key F | 0.40 | 0.35 | 0.20 | 0.15 |
| 新 key | 0.50 | 0.45 | 0.20 | 0.10 |
是上面兩列的最大值 0.72(key A 與 key B 這一對最像)。新 key 的 ,,通過。如果反過來 對 key B 的分數是 0.80,那 ,不通過:新 key 比原本整組裡最容易混淆的那一對還更容易跟競爭對手搞混。
有個細節容易忽略:比較基準 是「修訂前的舊整組」,不是 裡任兩個 key 的相似度,也不是這一輪其他新 key 互相比。Separation 檢查的本質是「這次修訂是不是一次進步」,跟自己過去的表現比,是相對式的及格標準。這跟 Faithfulness、Specificity 使用固定門檻的邏輯不同。
7.7 閘門:逐一驗證,整體生效
驗證本身是逐一 key 進行的,每個 key 各自算三準則。但「這一輪修訂算不算數」由一個單一閘門決定,只看一次。完整判斷順序是:
- 把 keep 的舊 key 與 revised 的新 key 全部當候選,逐一跑三準則,通過的收進 。
- 檢查閘門: 裡有沒有至少一個原本屬於
revised的新 key。 - 有,這一輪生效, 更新成原文加上所有通過的 key(新舊都算)。沒有,這一輪整個不生效, 維持修訂前的樣子。
接著是一個論文沒有明講、但從邏輯上必然成立的推論。假設某個 keep 的舊 key 這一輪重新驗證失敗(例如 Separation 沒過),同一輪 revised 裡又沒有任何新 key 通過。走一次流程:舊 key 不進 ,閘門為否,走到「不生效」分支, 回到這一輪開始前的樣子,而那個樣子本來就包含這個舊 key。結論是,這個舊 key 雖然驗證不及格,卻因為整個修訂被否決而躲過一劫。
換句話說,一個 key 要真的被踢出索引,不能只靠自己驗證失敗,還得同一輪剛好有新 key 驗證成功。如果這一輪的新提議通通不夠好,早該淘汰的舊 key 也會連坐般暫時保住位置,要等到某一輪剛好有新 key 被接受,才會真的被清掉。這直接影響「這套系統多久才能清掉一個爛 key」:不是壞掉的瞬間立刻移除。
8 Query Simulator:主動探索沒被問過的查詢
Query Simulator 要解決的是前面說的「Optimizer 只能被動反應」。它執行的動作叫 Self-Exploration:抽樣文件、生成模擬查詢、過濾重複,把通過篩選的查詢送進 Optimizer,跟真實查詢一視同仁。
8.1 兩階段生成:先抽象化,再寫查詢
最直覺的做法是把文件丟給 LLM,叫它直接寫幾個可能被問的問題。論文刻意拆成兩次分開的呼叫,中間插入一個抽象化步驟:
- 第一次呼叫(論文附錄 Table 9 上半部):給 LLM 看文件原文,要求用白話講出這篇文件解決了讀者的什麼困惑,而且不能提到專有名詞、實體名稱或標題,輸出只是一句問題描述(
problem欄位)。 - 第二次呼叫(論文附錄 Table 9 下半部):完全不給 LLM 看原文,只給它那句問題描述,請它扮演還沒讀過任何資料、不懂術語的人,用像在論壇發文提問的口吻寫出 個問題。
用意在於減少直接抄原文用詞,論文的說法是抽象化描述作為 {problem} 傳進查詢撰寫階段,降低對原文措辭的直接複製。如果同一次呼叫既看原文又要寫查詢,LLM 很容易不自覺照抄原文的用詞與句型,寫出來的「查詢」只是原文改寫版,跟真實使用者的口語措辭差很遠。把原文藏起來,只留一層抽象描述,第二次呼叫就必須用「不知道術語的人會怎麼問」的方式重新組織語言。這有點像資訊瓶頸(information bottleneck):故意設一個窄的資訊通道,逼資訊在通過時被壓縮、重新表達,而不是原封不動流過去。
8.2 Algorithm 3:完整流程
論文的 Algorithm 3 輸入是語料庫 、要抽樣的文件數 、每篇文件生成的候選查詢數 、先前輪次用過的查詢 ,以及相似度門檻 (實驗設 ),相似度用的是 Jaccard,定義與例子在後面的補充一節。輸出是通過 Answerability 與 Dissimilarity 雙重篩選的模擬查詢集合 。流程如下:
- 從 隨機抽樣 篇文件,組成集合 。
- 對 裡每篇文件 ,先呼叫抽象化得到問題描述 ,再呼叫查詢撰寫(不看原文)得到 個候選查詢 。
- 對 裡每個候選查詢 ,先檢查 Answerability 分數是否 ≥ 2,沒過就丟棄。
- 通過後再檢查 Dissimilarity:跟已用過的查詢、跟這次已收進的查詢都夠不像,才加進 。
兩個檢查是依序執行、短路生效的:連 Answerability 都沒過,就不浪費力氣算 Dissimilarity。而 Dissimilarity 的比較對象不只有 ,還包含這次呼叫裡已經被接受進 的查詢,所以同一批模擬查詢內部也不會太重複。
8.3 Answerability:文件真的答得出這個查詢嗎
第二次 LLM 呼叫完全沒看過原文,純靠抽象描述去發散聯想,難免飄得太遠,所以要確認這篇被抽樣的文件真的能回答候選查詢。做法對照論文附錄 Table 10:跟 Faithfulness 幾乎同一套 0 到 3 分的評分邏輯,通過門檻同樣是 ≥ 2。
差異只有一個:Faithfulness 一次把文件所有待驗證的 key 塞進同一次呼叫(批次處理),Answerability 則是一個文件配一個查詢,一對一單獨呼叫,論文的說法是每個文件與查詢的組合各做一次裁判呼叫。裁判同樣是共用的那顆 backbone,前面討論過的可信度疑慮在這裡也適用。
8.4 為什麼用 Jaccard,不用 embedding cosine
(Jaccard 的定義與數字例子放在下一節,不熟的話可以先跳過去看。)
論文完全沒有解釋這個選擇,這是一個空白。論文的措辭是「為了限制 lexical overlap」,用的是 lexical(字面)而不是 semantic(語意),這個用詞本身就是線索:這一步鎖定要濾掉的,是用詞幾乎一樣的重複,不是意思差不多但講法不同的重複。以下是我的推論,論文沒有明講。
推論一:BM25 也在測試範圍內。 BM25 完全靠字面詞彙比對,不理解語意。兩個查詢字面幾乎一樣,對 BM25 來說送進去的結果幾乎必然雷同,提供不了新的診斷訊號,留著只是浪費一次迭代預算。反過來,語意相近但用詞差很多的兩個查詢,對 BM25 是完全不同的輸入,可能撞到不同的 key、觸發不同的診斷,不該被濾掉。所以 Jaccard 量的字面重疊,比 cosine 量的語意相似,更貼近「這兩個查詢對檢索器是不是等價輸入」。
推論二:計算成本。 Jaccard 只要斷詞後做集合的交集與聯集,純 CPU 的輕量運算;cosine 要額外呼叫 embedding 模型取向量。Dissimilarity 要把新查詢跟累積的所有歷史查詢逐一比對(實驗中每個資料集最終累積 2560 筆查詢),長期開銷差距不小。
8.5 補充:Jaccard similarity
Jaccard 與這篇論文無關,是集合論衍生的基礎相似度,去重、推薦系統、生物資訊的序列比對都會用。把兩個東西各拆成「詞的集合」,交集的大小除以聯集的大小:
數字例子(自行構造): =「為什麼無名指不能單獨活動」, =「為什麼手指不能單獨活動」。為了好算,這裡用「字」當單位(實際實作通常用斷詞後的詞):
交集有 10 個字(為、什、麼、指、不、能、單、獨、活、動),聯集有 13 個字(再加上無、名、手),所以 。這低於門檻 ,勉強通過,也說明這兩句話其實已經非常像,只差「無名指」與「手指」的用詞。
門檻值也不是論文自己調的:論文說沿用資料去重領域的做法,設 ,出處是 Lee et al. 2022 與 Li et al. 2024。這一塊直接套用現成工具,沒有創新成分,但去重本來就不必重新發明輪子,把心力留給 Optimizer 這種真正需要設計的地方是合理的。
9 實驗結果精要
方法論的細節前面都講完了,這裡只帶過實驗的關鍵數字,把篇幅留給後面的消融與混淆變因對照。
9.1 檢索效能
先看最基本的檢索指標。表 1 是 BRIGHT 上的主結果,表 2 是表格檢索資料集上的結果。
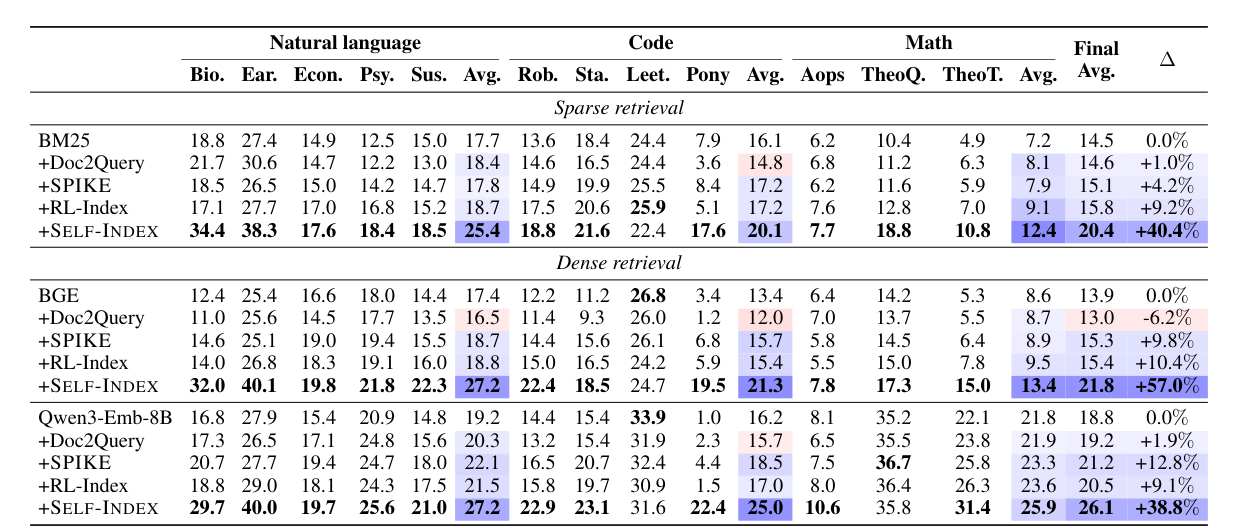
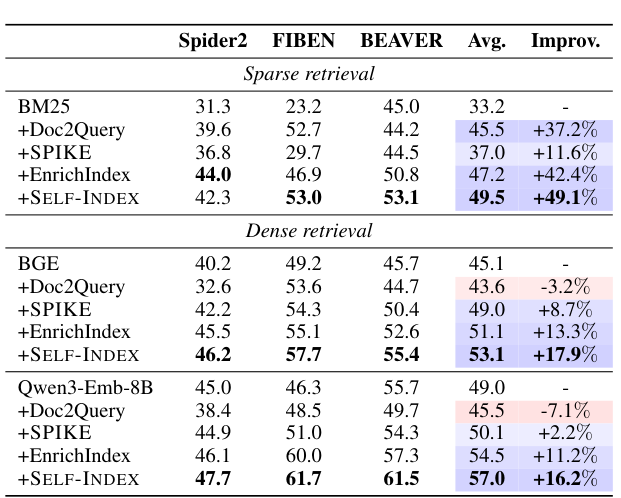
兩張表的重點可以一起讀。在 BRIGHT 的三種語料類型(自然語言、程式碼、數學)乘上三種檢索器(BM25、BGE、Qwen3-Embedding),九種組合 SELF-INDEX 全部拿下最高分,相對提升從 +38.8% 到 +57.0% 不等。表格檢索(Spider2、FIBEN、BEAVER)也是三個檢索器全贏。對照組表現不穩定,Doc2Query 在密集檢索器上甚至是負提升:BRIGHT 上搭配 BGE 是 -6.2%,表格檢索上搭配 BGE 是 -3.2%、搭配 Qwen3-Embedding 是 -7.1%;同一個方法在表格檢索搭配 BM25,卻有 +37.2%。同一個方法換個檢索器就從大賺變成倒扣,正好印證前面講的「沒有一種策略能通吃」,SELF-INDEX 則填補了這個空缺。
9.2 下游:搜尋 agent 與記憶系統
檢索指標變好之後,更重要的問題是真實任務有沒有跟著變好。表 3 是 BrowseComp-Plus 上的端到端 agent 結果。
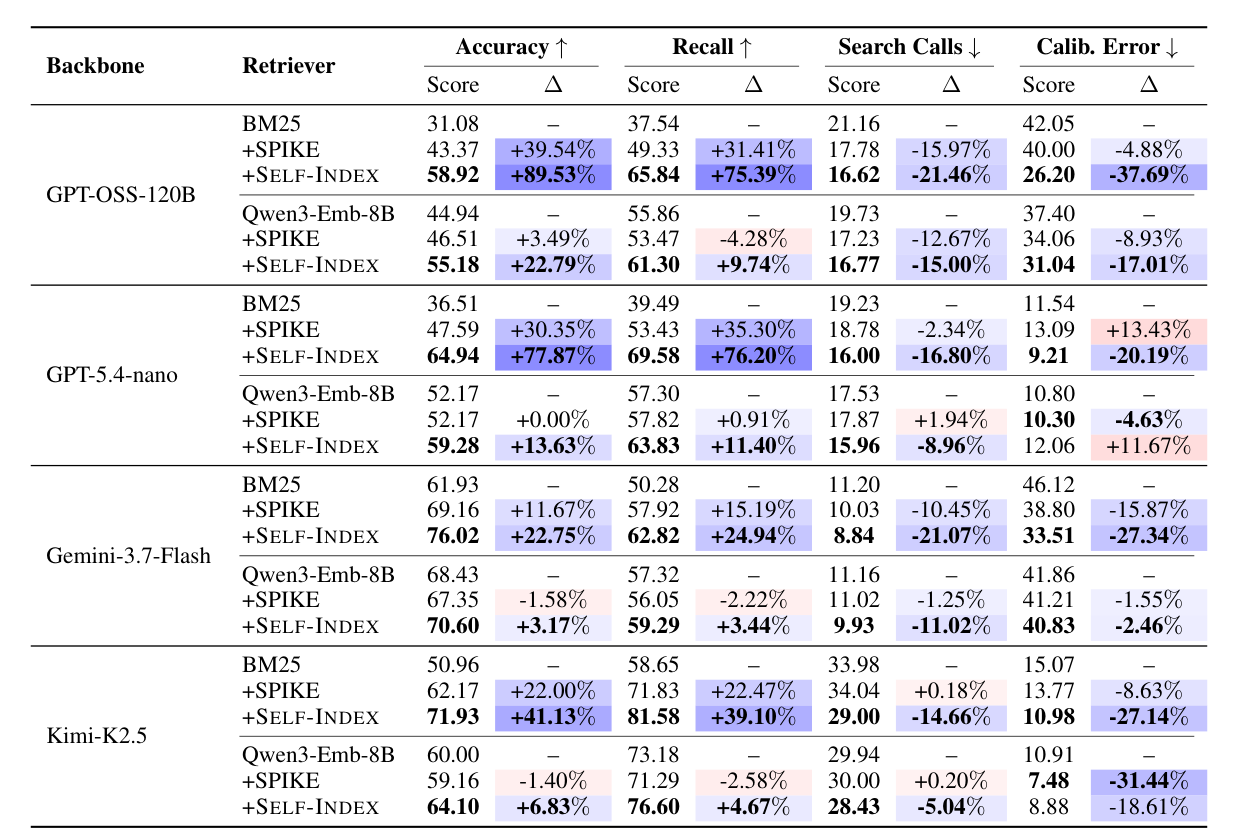
效益確實延伸到了真實任務。表 3 顯示,四種 agent backbone(GPT-OSS-120B、GPT-5.4-nano、Gemini-3.7-Flash、Kimi-K2.5)搭配兩種檢索器,SELF-INDEX 全部提升答案準確率,最高的是 GPT-OSS-120B 搭 BM25,從 31.08 升到 58.92(+89.53%),同時減少搜尋次數、通常也降低成本。圖 3 把準確率與線上成本畫在同一張圖上,方便看出「準確率升、成本降」同時發生。
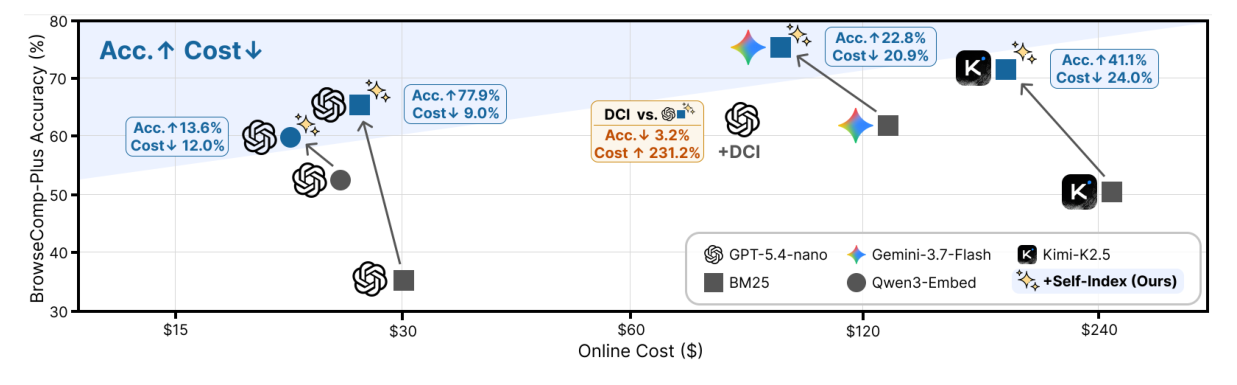
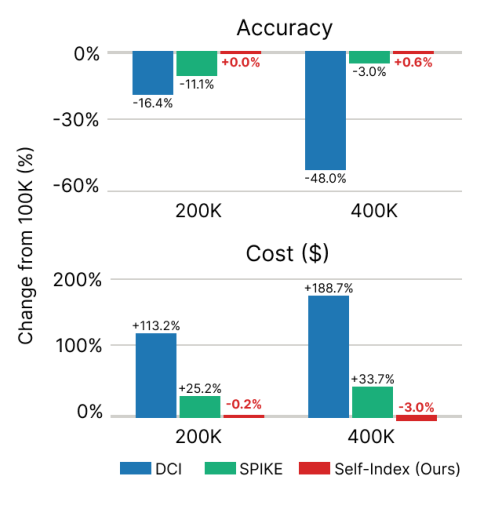
圖 4 則在問語料庫變大之後還撐不撐得住:語料庫從 10 萬篇擴大到 40 萬篇時,SELF-INDEX 的準確率與成本都維持穩定(準確率 +0.6%,成本反而降 3.0%),對照組 DCI 的狀況留到後面的 DCI 對照組一節再談。
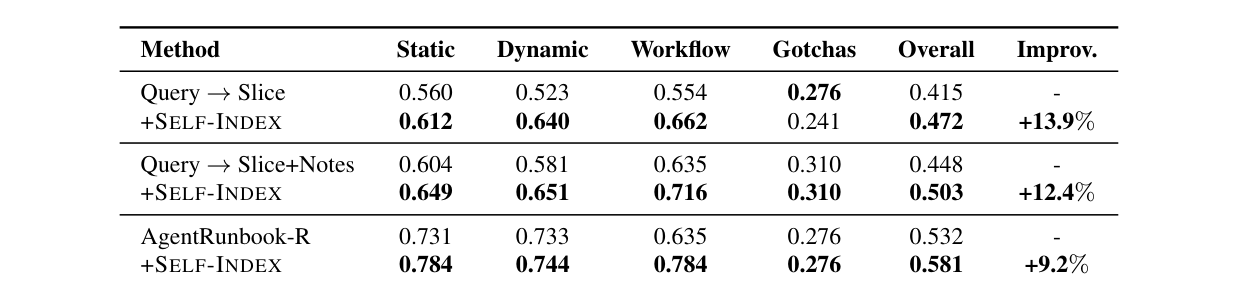
表 4 換到 agent memory(LongMemEval-V2)上,三種記憶系統設計(Query→Slice、Query→Slice+Notes、AgentRunbook-R)套用 SELF-INDEX 後,準確率都提升 9% 到 14%。這說明機制不只對文件檢索有效,對「記憶檢索」這種更廣的場景也能遷移。
9.3 DCI 對照組:數字要打折看
DCI(Direct Corpus Interaction,出自 Li et al. 2026)是一種不建索引、讓 agent 直接跟整個語料庫互動的方法,已被證明在 BrowseComp-Plus 上打贏既有基於索引的 search agent。論文拿它當對照組,是想證明基於索引的做法也能追上不建索引的做法。
論文在兩處引用 DCI 的數字,用的卻是兩個不同的 DCI 變體、不同的評測子集:
| 引用位置 | DCI 變體 | 評測條件 | 數字來源 |
|---|---|---|---|
| 準確率對成本散佈圖 | DCI-Agent-Lite | 已發表的 GPT-5.4-nano 結果與成本 | 直接搬 Li et al. (2026) 已發表的數字,不是自己重跑 |
| 語料規模擴展測試與其對應的數值表 | DCI-Agent-CC | 100 題子集,加 FineWeb 干擾文件 | 同樣取自 Li et al. (2026),與 SELF-INDEX 自己跑的完整 830 題不同 |
比較結論如下:
- 準確率:相近。GPT-5.4-nano 搭 BM25 加 SELF-INDEX,準確率可追平相同 backbone 的 DCI。
- 成本:SELF-INDEX 遠低於 DCI,散佈圖顯示 DCI 成本比 SELF-INDEX 高出 231.2%,準確率反而低 3.2%。
- 規模擴展:語料從 10 萬擴到 40 萬篇時,DCI 準確率暴跌 48%、成本暴漲近 3 倍,SELF-INDEX 幾乎不受影響(準確率 +0.6%,成本反而降 3.0%)。
- 可信度限制(論文自己承認):DCI 的數字全是引用原論文,不像 SPIKE、Doc2Query 等對照組有「用官方實作與相同 backbone 公平重現」。兩處引用的 DCI 版本與題目集也不一致,所以論文自己限定只比較各方法相對於自己 10 萬篇基準線的相對變化,不比較跨方法的絕對準確率或成本。
整體來看,「SELF-INDEX 打贏 DCI」這個方向大致可信(不建索引的方法隨語料擴大會吃力,符合直覺),但具體數字大小要打折扣,因為評測條件沒有完全對齊。
10 消融實驗:這套機制為什麼必要
消融回答的不是「有沒有效」,而是「為什麼有效、拿掉哪裡會壞」。
10.1 元件消融
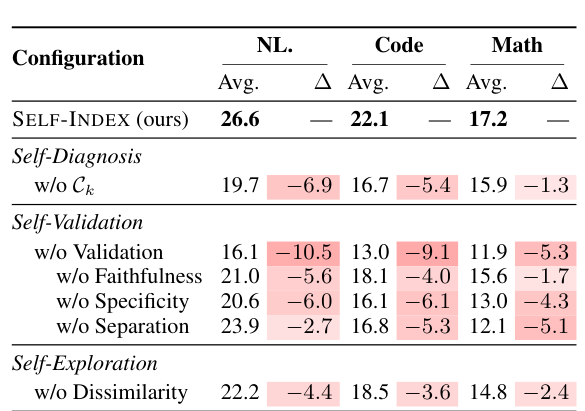
表 5 是完整的消融結果,下表摘錄其中各元件被拿掉後,相對於完整 SELF-INDEX 的 nDCG@10 點數差(數字越負代表傷害越大):
| 拿掉的元件 | 自然語言 | 程式碼 | 數學 |
|---|---|---|---|
| 整個 Self-Validation | -10.5 | -9.1 | -5.3 |
| co-retrieval profile(Self-Diagnosis) | -6.9 | -5.4 | -1.3 |
| Specificity(單獨拿掉) | -6.0 | -6.1 | -4.3 |
| Separation(單獨拿掉) | -2.7 | -5.3 | -5.1 |
| Faithfulness(單獨拿掉) | -5.6 | -4.0 | -1.7 |
| Dissimilarity filter(Query Simulator) | -4.4 | -3.6 | -2.4 |
從這張表可以讀出三個判斷:
驗證閘門不是錦上添花。 拿掉整個 Self-Validation 的傷害(-10.5、-9.1、-5.3)遠大於拿掉任何單一準則,論文還提到這樣做甚至會比原始索引更差。沒有閘門,LLM 自己生成的東西就會被無條件接受,品質完全失控。
三個準則都有用,但重要性隨語料類型不同。 自然語言最怕少了 Specificity(-6.0),數學最怕少了 Separation(-5.1),程式碼兩者都傷得重(Specificity -6.1、Separation -5.3),Faithfulness 在三類裡相對最小(數學只有 -1.7)。這可以遷移成一個判斷:如果資源有限、只能簡化驗證,數學或邏輯密集的語料應該先保區隔度(避免跟相似概念混淆),自然語言語料先保特異性(避免內容太籠統),程式碼語料則兩者都不能省。
co-retrieval profile 在自然語言(-6.9)比在數學(-1.3)有用得多。 這暗示靠共現模式診斷,在語意豐富、表達多樣的自然語言裡更管用;數學的措辭高度標準化,說法的變化空間本來就小,共現模式能提供的額外資訊有限。這一點論文沒有明講,是我從數字反推的。
10.2 查詢來源:Query Simulator 值不值得
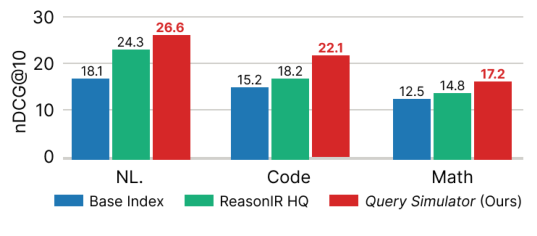
圖 5 比較的是優化所用的查詢來源。把整個 Query Simulator 換成既有的 ReasonIR HQ 合成查詢集,效果仍然比基礎索引好,這證明 Optimizer 本身不靠 Query Simulator 也能運作。但每個語料類型下,Query Simulator 生成的查詢都帶來更大的提升,差距約 2.7 到 2.9 個百分點。可見「主動探索沒被問過的角度」確實有加分,不是裝飾。
10.3 迭代動態與成本
圖 6 看的是索引在連續迭代中的演化過程,表 6 則把同一批檢查點的累積成本列出來。
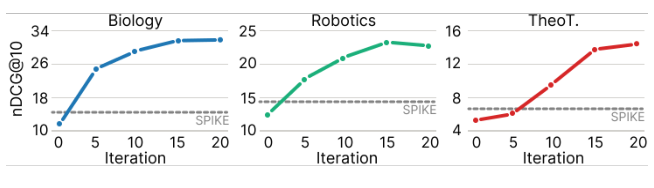
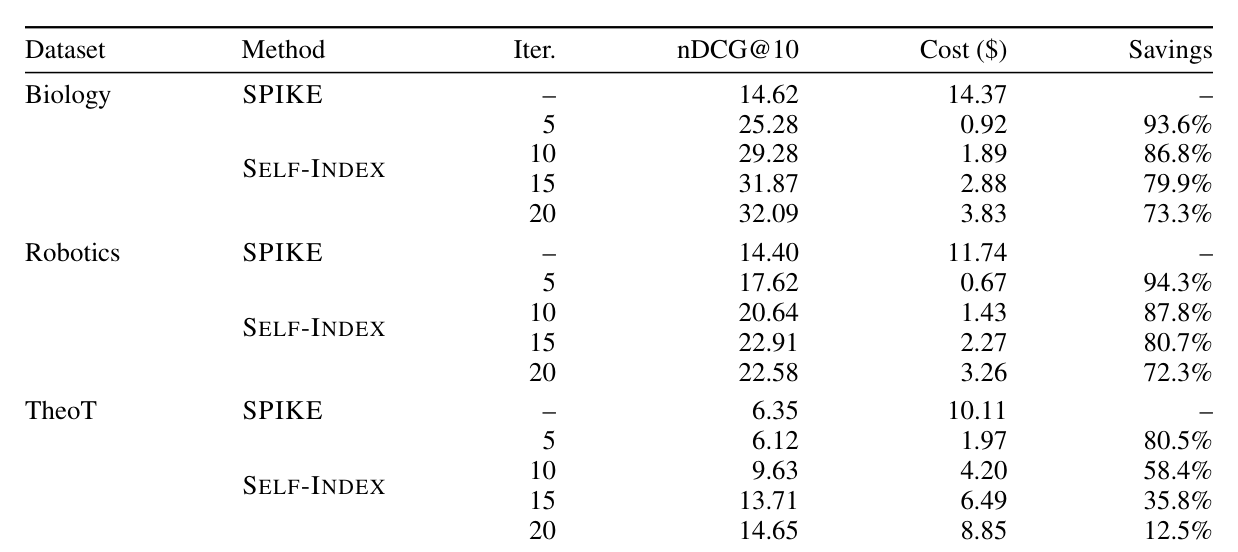
論文挑了三個代表性資料集(Biology、Robotics、TheoremQA-Theorem)來看迭代過程。SELF-INDEX 在早期幾輪就超越 SPIKE,累積成本在多數檢查點都低於 SPIKE:SPIKE 是一次性全語料建構,成本一開始就砸下去,SELF-INDEX 則是逐步疊加,早期成本很低。開頭評價提到的成本優勢,數字出處就在這裡。
11 貢獻拆解:排除計分方式這個混淆變因
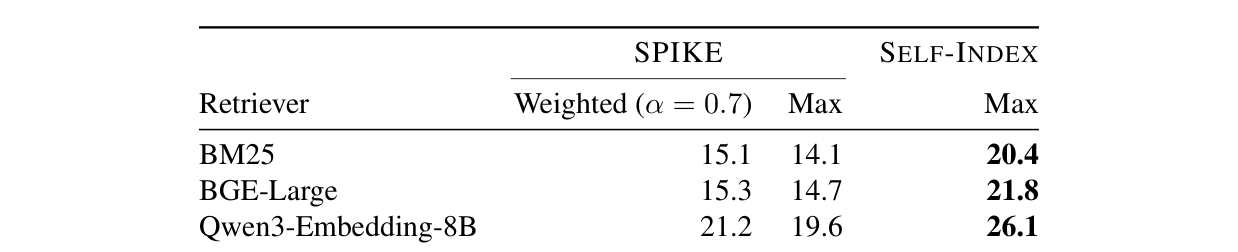
這一節的問題是:SELF-INDEX 贏過 SPIKE,會不會只是因為計分方式比較好?SPIKE 原本把「原文分數」與「情境 key 的最高分」用調過的權重合併(原文 0.7、情境 0.3),SELF-INDEX 則是直接取原文與所有生成 key 的最大值,不需要調任何權重。如果「取最大值」本身就比加權好,勝負就跟 key 生成的好壞無關了。
論文的做法是把 SPIKE 的計分方式也換成取最大值,讓兩者用同一套規則比較(BRIGHT 三種語料類型平均的 nDCG@10)。表 7 是原始結果,下表把三欄數字並排:
| 檢索器 | SPIKE(原本的加權合併) | SPIKE(換成取最大值) | SELF-INDEX |
|---|---|---|---|
| BM25 | 15.1 | 14.1 | 20.4 |
| BGE-Large | 15.3 | 14.7 | 21.8 |
| Qwen3-Embedding-8B | 21.2 | 19.6 | 26.1 |
有兩個發現。第一,SPIKE 換成取最大值後,自己的分數反而下降,代表它原本的加權設計確實是針對自己的方法特性調過的。第二,也是重點:就算 SPIKE 讓自己分數下滑,跟 SELF-INDEX 的差距不但沒縮小,反而拉大(原本約 5 到 6 分,換成同一套計分後擴大到 6 到 7 分)。結論是 SELF-INDEX 贏的是 key 本身的品質,不是計分取巧。
這個對照本來可以輕易不做,而且結果中 SPIKE 換算法後分數下滑,代表原本的比較某種程度上對 SELF-INDEX 有利,論文也老實攤出來了。這是作者自己把方法功勞與其他變因拆開的具體示範,不需要額外質疑。
12 值得帶走的東西
我把能帶走的東西分成兩個桶子:一個是這篇論文自己的貢獻,一個是脫離這篇論文也成立的設計心法。後者是我認為最大的收穫。
12.1 這篇論文自己的貢獻
老實講,原創成分不高,貢獻主要在組裝與應用。三個核心元件分別是:Self-Diagnosis 的 co-retrieval profile,精神上是 1971 年就有的 pseudo-relevance feedback;Self-Validation 的「LLM 自我批評加驗證閘門」,在 LLM agent 自我改進的文獻裡已經很常見;Query Simulator 的合成查詢,Doc2Query(2019)就在做類似的事;去重用的 Jaccard 更是直接搬資料去重領域的慣例。
這篇論文真正做的,是把這幾塊組起來,套在 index key 優化這個具體問題上,並做了扎實的下游驗證(agent 任務與 agent memory)。沒有人把「自我診斷、選擇性修訂、驗證閘門」系統性地用在 index key 優化上,這個組合填補了一個實務空缺,工程上有用,但不是概念上的突破。
如果一定要挑一個這篇論文獨有、值得記住的設計,我會選「逐一驗證,整體生效」一節講的驗證閘門:至少一個新 key 通過才整批生效,否則整批不動。這是可以直接搬到別的系統上的工程細節。
12.2 脫離這篇論文也成立的四個心法
第一,生成者與裁判是同一顆模型,驗證就要打折。 前面「裁判和生成者是同一顆模型」一節講過這篇論文的具體狀況,這個原則則不限於它:設計自動修 prompt 或技能檔(例如 SkillOpt)、自動編輯知識庫、自動調整 agent 記憶(例如 Mem0、MIRIX 這類記憶系統)這類自我改進系統時,只要看到同一顆模型身兼球員與裁判,就該提高警覺,並意識到報告出來的效果數字,可能高估了驗證機制真正把關得住的程度。
第二,「拿掉安全機制會比什麼都不做還糟」是一種值得記住的負面結果模式。 元件消融的結果顯示,沒有驗證閘門,LLM 生成的雜訊與錯誤會隨每一輪迭代疊加,把原本堪用的索引越改越糟,不是打折,是主動變差。在自我修改型系統裡,安全機制決定整體是加分還是倒扣,設計時應該先想清楚驗證怎麼做,而不是先把生成迴圈做出來、驗證留到最後補。
第三,診斷與生成分成兩步。 Self-Diagnosis 只給「哪裡有問題、往哪走」的文字建議,不直接生成修正內容,生成是下一步 Self-Revision 的事,兩者是分開的 LLM 呼叫。道理在於發現問題與想出好答案是兩種不同的認知負擔:診斷要批判地審視現狀、找出落差,生成要建設性地想像更好的版本,還得兼顧跟既有內容不衝突。硬塞進同一次呼叫容易顧此失彼,一心想提解法時會對現狀問題輕描淡寫,太專注挑錯又可能想不出建設性的方向。這個「先診斷、再生成」的模式,可以套用到任何「LLM 自我檢查加修正」的 pipeline,例如自動 code review 後修復、自動內容審核後改寫。
第四,用抽象化當資訊瓶頸,避免生成內容照抄原文用詞。 「兩階段生成」一節講的兩階段設計,可以推廣到任何「不想讓生成內容太像原文」的合成資料任務:生成測試案例、生成訓練用查詢、做 paraphrase,或任何需要「站在不知情者角度重新表達」的場景。做法是刻意把原文從生成那一步藏起來,只留一層抽象描述,逼內容在通過窄通道時被重新表達。
13 結論
SELF-INDEX 把「人工診斷、人工改策略、全量重跑」換成「診斷、選擇性修訂、驗證閘門」的自動迴圈,再用 Query Simulator 補上主動探索,在 BRIGHT、表格檢索、BrowseComp-Plus 與 LongMemEval-V2 上都有穩定的提升。消融實驗顯示驗證閘門是整套機制成立的前提,表 7 的對照也排除了「贏在計分方式」這個疑慮。
它的保留之處同樣清楚:元件本身都不新,裁判與生成者共用同一顆模型而沒有任何獨立驗證,案例只選了成功的,DCI 的比較條件也沒有完全對齊。把它當成一份工程上值得參考的組裝範例,比當成概念突破更貼切。