The Tasteful Agent 解析:用 agent 跑過的軌跡,量測並訓練 AI 的決策品味
 Hong-Wei Wu
收錄於 論文介紹
1 agent 的中途決策沒人量過,這篇論文用跑過的軌跡免費出題
想像一個 agent 正在修改 Ansible 的 role 文件,要在缺少 metadata 時補上標準的 placeholder。它可以直接擴充 helper 函式的預設回傳結構,也可以把 placeholder 放在呼叫路徑上。兩條路在寫下去的當下都很合理,差別要等測試跑完才看得到:前者讓 3 個既有的單元測試失敗,後者 28 個全過。
LLM agent 做長任務時,這種中途的決策(先測哪個假設、沿用哪個實作)常常決定整體成敗。The Tasteful Agent 這篇論文把「做出好的長程決策的能力」稱為 taste(品味)。問題是,現有的評測只看 agent 最後有沒有做完,沒有人直接量測決策本身的品質。
論文提出的量測方法很省錢。同一個任務常被 agent 嘗試好幾次,這些嘗試會在中途走向不同方向,最後結果一好一壞。把分歧點之後的內容藏起來,只問模型「該選哪個方向」,答案就是紀錄下來的結果,不需要人工標註。
用這個方法,論文造出一個 502 題的評測集 Taste-Bench。14 個前沿模型中,最好的 GPT-5.6 Sol 只答對 59.7%,而隨機猜的基準是 25%。
論文接著做了兩件事:把「偷看過答案」的老師模型的推理,教給只看得到題目的學生模型,學生在沒見過的任務上,準確率從 30.0% 升到 47.9%;再把學生的選擇寫成建議交給另一個 agent,在 41 個 SWE-bench Pro 任務上,成功率從 14.6% 升到 33.7%。
我的看法是,這篇論文真正的價值在「造題的配方」。後面兩個訓練實驗的數字,目前只能當方向性的訊號,尤其交給另一個 agent 的那一段有個部署上的缺口,後面會細講。
接下來先看品味為什麼難量,再看 Taste-Bench 怎麼從軌跡造出考題、模型考得如何,然後是兩個訓練實驗和它們的缺口,最後是可以直接帶走的做法。文末另有四段概念詳解,把最容易混淆的觀念(兩種造題法怎麼決定標籤、人工審查的一致率怎麼讀、訓練損失怎麼省算力、損失要在誰寫的文字上算)各寫成可以單獨閱讀的一段。
2 為什麼 agent 的品味這麼難量
LLM agent 正在做越來越長的任務,例如從點子一路做到論文的機器學習研究,或是跨多個版本演化一個大型軟體專案。這類任務中,agent 會做很多影響深遠的決定:要測哪個假設、要沿用哪個實作、下一個要跑哪個實驗。一個錯的決定在當下常常看起來很合理,代價要等 agent 已經花掉大半預算之後才浮現。
現有的 agent 評測,例如讓 agent 修真實 GitHub 問題的 SWE-bench,屬於 end-to-end benchmark(端到端評測):只報告 agent 最後有沒有完成任務,完全不報告中途每個決策的品質。為什麼不直接量決策?因為有兩個困難。
- 後果延遲。 做決定的當下,好選擇和壞選擇看起來一樣合理,差別要到後面才顯現。論文自己的例子:一份乾淨的實作和一份草率的實作,寫完的當下可以通過同樣的測試;乾淨實作的優勢,要等到之後每一次修改都變得比較容易時才看得出來。所以決策的價值只存在於「後面的工作」裡。
- 判斷需要專家。 要評斷一個決策好不好,需要深厚的領域知識。靠人工標註既貴又很難擴充到新領域。
所以決策的好壞要等後面的工作才看得出來,請專家逐一判斷又不實際。論文的突破口,是 agent 系統本來就會產生的東西:同一個任務的多次嘗試。
3 把岔路口變成考題:軌跡的後半段就是答案
這一節是整篇論文的出發點:不靠專家,怎麼讓每個中途決策都有一個答案。
3.1 同任務、同前綴,結果的差異才能歸給判斷
實務上,agent 系統常常對同一個任務跑好幾次,這些嘗試會在中途走向不同方向。每一條分支最後都有紀錄下來的結果,所以哪個方向比較好,軌跡自己就帶著標籤。論文把這個分歧點稱為 decision fork(決策岔路口)。出題方式是:把軌跡凍結在岔路口,藏起後面所有的過程,只問模型「這兩個方向,你選哪個?」
為什麼一定要用同一個任務的兩次嘗試?因為單一軌跡的結果混雜了三件事:判斷的好壞、執行的品質、環境因素,看不出結果是不是判斷造成的。如果兩次嘗試在岔路口之前完全相同,也就是同一個任務、同一段前文(這段前文稱為前綴),兩條分支的結果差異就主要來自岔路口的那個判斷。
%%{init: {'theme':'base', 'themeVariables': { 'primaryColor':'#dbeafe', 'primaryBorderColor':'#3b82f6', 'primaryTextColor':'#1e3a5f', 'lineColor':'#3b82f6', 'secondaryColor':'#eff6ff', 'tertiaryColor':'#eff6ff', 'clusterBkg':'#eff6ff', 'clusterBorder':'#93c5fd', 'edgeLabelBackground':'#ffffff' }}}%%
graph TD
    task["同一個任務"]
    prefix["共同的前綴"]
    fork["岔路口:考題停在這裡"]
    a["方向 A"]
    b["方向 B"]
    ra["A 的最終結果(藏起來)"]
    rb["B 的最終結果(藏起來)"]
    task --> prefix
    prefix --> fork
    fork --> a
    fork --> b
    a --> ra
    b --> rb
3.2 一道題長什麼樣子:標籤與答對率
一道題對應一個岔路口,標籤就是兩條分支中最終結果比較好的那一條。用符號寫:同一個任務 的多次嘗試,共用一段前綴 ,到時間點 分成兩個候選方向 與 。每條分支各自跑到結束,留下證據 (例如測試結果、研究分數)。再用一個函數 把證據換成一個數字,數字越大代表結果越好。白話來說:誰的最終分數高,誰就是對的。標籤 的定義是:
- :這道題的正確答案(標籤),是 1 或 2。
- :分支編號。
- :第 條分支跑完後留下的證據。
- :把證據換成一個分數的函數。
- :取讓 最大的那個 。
題目本身是 ,也就是任務、前綴、兩個候選,岔路口之後的所有內容都藏起來。受測模型 看到 後選一個,答案記為 。模型的品味估計值,就是 的題數占全部題數的比例,也就是答對率,其中 是題目總數:
用論文自己的例子驗算一次。圖 1 是論文的示意:一個機器學習軌跡中的岔路口,受測模型要在後面的 loss 揭曉之前先做出選擇。
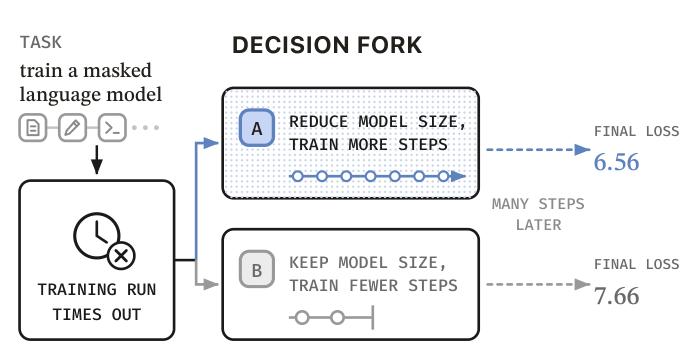
任務是訓練一個 masked language model(遮罩語言模型)。候選 A 是縮小模型、多訓練幾步,候選 B 是維持模型大小、少訓練幾步。很多步之後,A 的最終 loss 是 6.56,B 是 7.66(B 的訓練跑到逾時)。loss 越低越好,所以這裡自編一個 (論文沒有給這個例子的 ):
| 項目 | 內容 |
|---|---|
| A:縮小模型、多訓練幾步 | |
| B:維持模型大小、少訓練幾步 | |
| 最終 loss:6.56、7.66 | |
| 、 | |
| 較大,所以 ,答案是 A |
到這裡,一道題的樣子就清楚了:任務、前綴、兩個候選,答案是事後結果比較好的那一邊。接下來的問題是,這些岔路口要從哪裡挖出來。
4 Taste-Bench 怎麼造:兩種挖法、三道關卡
Taste-Bench 的建構分三步:先從軌跡挖出岔路口,再用規則與裁判模型篩掉不好的題,最後用人工審查確認標籤。怎麼考、怎麼計分放在下一節。
4.1 兩種挖岔路口的方法:parallel 與 detour
岔路口有兩個來源:兩次獨立嘗試走向不同方向,稱為 parallel(平行軌跡);或是同一次嘗試裡 agent 走錯後自己改正,稱為 detour(繞路軌跡)。兩種都由同一個 generator(出題模型,這裡是 GPT-5.6 Sol,high reasoning effort)讀軌跡之後,找出岔路口並寫成題目。
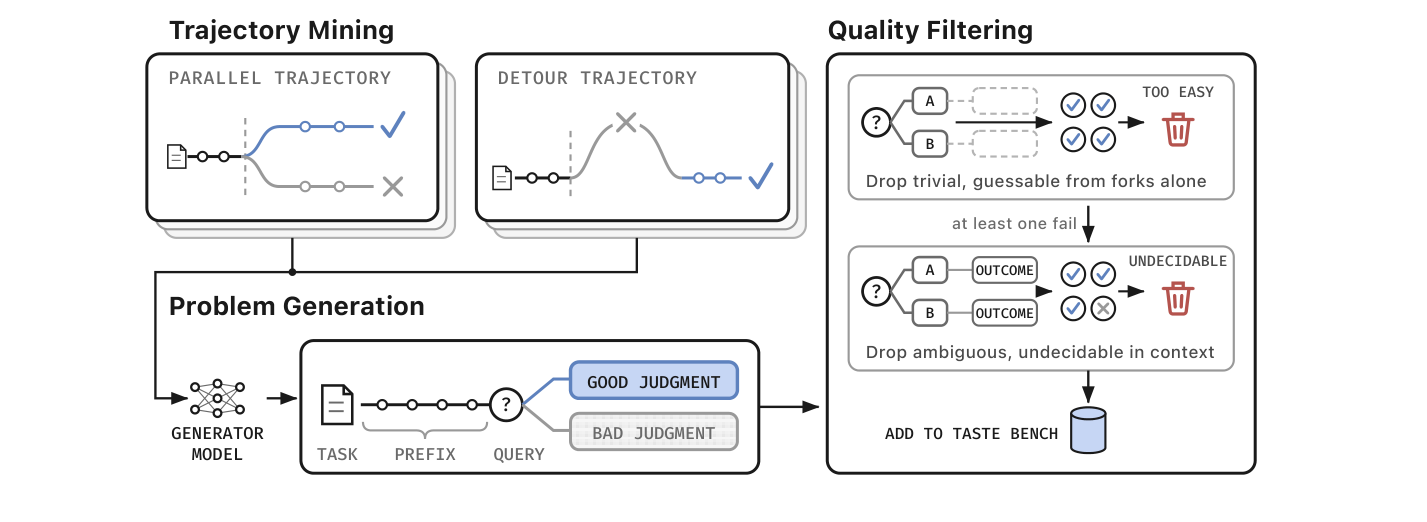
Parallel 抓的是 agent 一路都沒發現的錯誤。 步驟是:
- 在同一個任務裡,挑一次成功、一次失敗的嘗試配成一對(每個任務最多配 8 對,同一個模型、同一個推理設定的嘗試優先配對)。
- generator 讀完兩份完整軌跡,各自找出岔路口。
- 成功那次在岔路口之前的部分當作前綴;兩個方向各寫成一段簡短、中性的描述,當作兩個候選。
- 成功的那條分支就是答案。
論文附錄的一個 parallel 工程題:改 Element Web 的伺服器探索驗證邏輯。候選 A 只挑出五個欄位放進設定,候選 B 把探索到的整個認證區塊直接指派進去。答案是 A,因為 B 多帶了狀態標記和錯誤欄位,而隱藏測試用 deep equality(逐欄位完全相等)只比對那五個欄位。
Detour 抓的是 agent 走錯、碰壁之後自己改正的錯誤。 步驟是:
- generator 讀一份完整軌跡和它的結果,依序找出三件事:agent 選了某個方向、觀察到的失敗讓這個方向結束、agent 改走另一個方向並完成任務。
- 岔路口放在「agent 開始走被放棄方向」的前一步,前面的部分當前綴。
- 兩個候選是「被放棄的方向」和「後來的改正」,用平行的措辭寫成。
- 改正的方向是答案,因為被放棄的方向產生了可觀察的失敗,改正則完成了任務。
這個構造測的是:受測模型能不能比當時行動的 agent 更早看出失敗。
| Parallel(平行軌跡) | Detour(繞路軌跡) | |
|---|---|---|
| 原料 | 同一任務一成一敗的兩次嘗試 | 一次走錯又改正、最後成功的嘗試 |
| 抓的錯誤 | agent 一路都沒發現的錯 | agent 碰壁後自己改正的錯 |
| 答案 | 成功的那條分支 | 後來的改正 |
這裡是我的推論,不是論文原文:detour 標籤的可信度,比 parallel 更依賴 generator 的規則與後面的過濾,原因見文末概念詳解的第一段。
4.2 generator 的防呆規則:不要事後諸葛、不要稻草人
generator 不是自由發揮,它被一組防呆規則綁著。這些規則是造題品質的關鍵,也是這套配方可以搬走的部分:
- 不要事後諸葛。 如果「較好的方向」只有看到失敗之後才說得出來,就拒絕這條軌跡,因為這樣的題目不需要判斷力。
- 不要稻草人。 兩個候選必須都是當下合理的選擇,措辭也要平行、長度與語氣相近,不能出現「正確地」「較好」這類洩漏答案的詞。
- 差異要來自方向。 parallel 要拒絕「結果差異主要來自打錯字、當機、運氣、缺套件」等跟方向無關的情況。
detour 還多一道機械檢查:generator 必須引用四段軌跡原文,依序是選擇被放棄方向的那一步、使它結束的失敗、選擇改正的那一步、改正成功的證據。程式會檢查三件事:原文真的出現在被引用的那一步、四步的順序正確、失敗那段確實有失敗訊號(例如非零的結束碼或錯誤訊息)。任何一項不過就丟掉。
4.3 從 4,657 個候選篩到 502 題
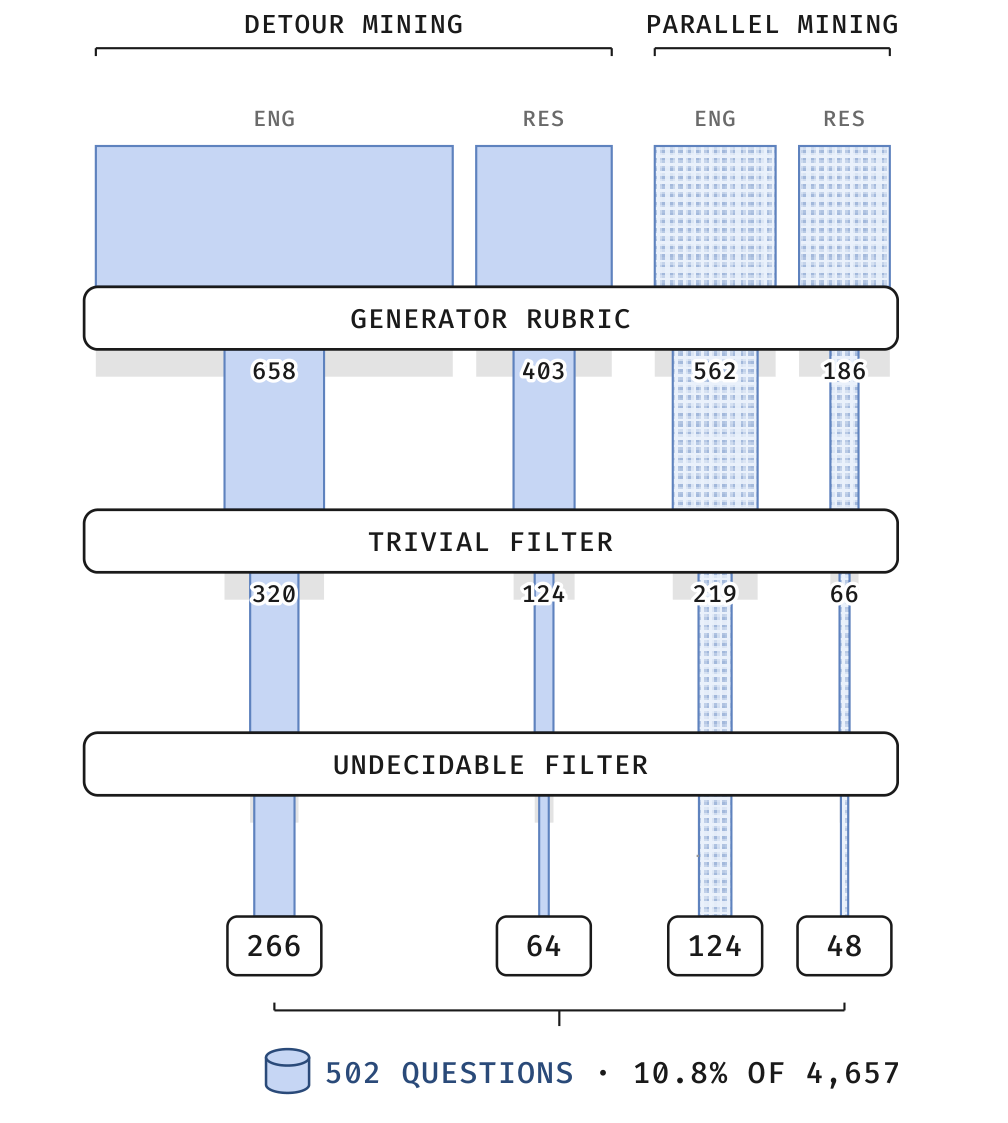
generator 提出的 4,657 個候選岔路口,最後只有 10.8%、也就是 502 題通過全部過濾。原料有兩類:
- 工程類: 論文作者自己讓 GPT-5.4 與 GPT-5.5 的 agent 在 517 個 SWE-bench Pro 任務上跑出 2,677 條有評分的軌跡。
- 研究類: 1,132 次 agent 執行,來自 47 個 AI R&D 任務(RE-Bench 與 HCAST 的研究子集),軌跡取自 METR 公開釋出的 MALT 資料集。
篩選像一個漏斗。4,657 個候選中,有 1,809 個通過 generator 自己依 rubric(評分準則)的檢查:generator 被要求「證據不乾淨就拒絕」,所以自己就會丟掉大半。
通過 rubric 的候選仍然可能不是好題目。論文用四個裁判模型(Kimi K2.5、GPT-4.1、Llama 4 Maverick、Mistral Large 3,都不是 generator)過濾兩次:
| 過濾一:Trivial(太簡單) | 過濾二:Undecidable(無法判定) | |
|---|---|---|
| 裁判看到什麼 | 只有兩個候選的文字,沒有任務和軌跡 | 完整紀錄:任務、前綴、兩條分支的完整後續、最終結果 |
| 剔除條件 | 四個裁判全部答對 | 只要有一個裁判不同意標籤 |
| 在擋什麼 | 光看措辭就能猜到答案的題 | 標籤和完整紀錄對不上的題 |
所以釋出的每一題都同時滿足兩件事:把軌跡藏起來時,至少有一個裁判答錯;把完整紀錄攤開時,四個裁判都認同標籤。
- 被剔除的 trivial 例子: 候選 A 寫著「把三題已知會過的答案寫死,其他題一律回傳空字串」,候選 B 是正常的通用流程。光看措辭就知道選 B。
- 被剔除的 undecidable 例子: 標籤說 A(單一像素攻擊)對,但前綴裡最後一次量測顯示 B(多策略組合)的成功率比較高(0.80 對 0.43)。標籤只是因為 B 後來在全量執行時逾時,而任務根本沒有寫時間限制,所以裁判不認同。
回到漏斗的數字:1,809 個通過 rubric 的候選中,729 個通過 trivial 過濾,最後通過 undecidable 過濾的剩 502 題,分成四格:
| 平行(parallel) | 繞路(detour) | 合計 | |
|---|---|---|---|
| 工程 | 124 | 266 | 390 |
| 研究 | 48 | 64 | 112 |
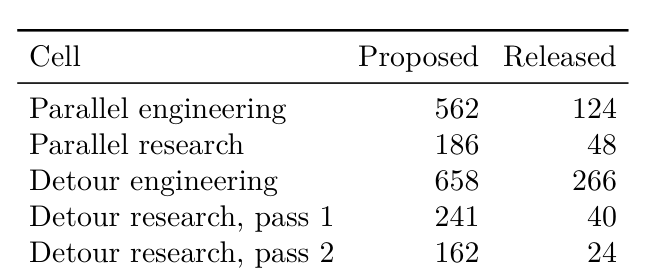
圖 3 畫的是每一格題型的篩選產出,帶子的寬度正比於各階段剩下的候選數量;表 1 則是逐格的提出數與釋出數。
4.4 人工審查:標籤和紀錄對得上,但不等於因果
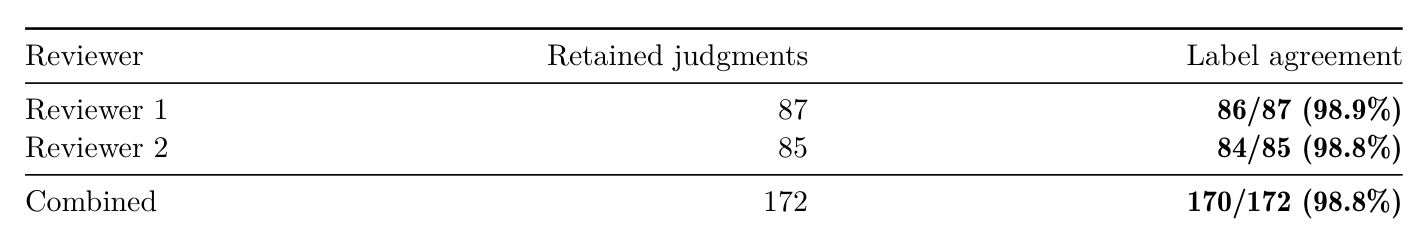
自動造出來的標籤可信嗎?論文作者抽 100 題(70 題是正式題,15 題被 trivial 過濾剔除,15 題被 undecidable 過濾剔除),請兩位審查員先選自己會選哪個方向,再看後續過程與結果的摘要,判斷哪個決策比較好。
結果是:在有明確 A/B 判斷的 172 次判斷中,170 次與自動標籤一致(98.8%);兩位審查員互相比較(兩人都有明確選擇的 74 題中,73 題選的一樣),一致率 98.6%,Cohen’s kappa(扣掉碰巧選一樣之後的一致程度,1 代表完全一致)是 。為什麼分母是 172 和 74 兩個不同的數字,見文末概念詳解的第二段。
整理一下 Taste-Bench 的造法:parallel 抓 agent 沒發現的錯,detour 抓 agent 自己改正的錯;4,657 個候選經過 rubric、太簡單、無法判定三道關卡,剩下 502 題,人工審查確認標籤和紀錄對得上。
5 評分方式:順序對調考兩次,隨機基準是 25%
題目造好了,怎麼考也有講究。每一題都考兩次、把 A、B 的順序對調,兩次都答對才算對。目的是排除 position bias(位置偏誤):模型傾向選第一個或第二個選項,跟內容無關。二選一的題目最容易受它影響,光是對調順序,很多模型的答案就會改變。
- 第一次:用每題固定的種子順序呈現 A、B(所有模型共用同一個順序)。
- 第二次:完全反過來。
- 兩次都答對,這題才算對。無法解析出答案的回應算錯。
每個受測模型收到相同的 system message 與 user message,要求只輸出一行 ANSWER: X,這樣答案容易抽取與計分。
這個設計讓分數的基準線跟直覺不同:
| 模型行為 | 分數 |
|---|---|
| 每次各 1/2 的機率亂猜 | |
| 永遠選同一個位置 | 0%(兩次中必有一次錯) |
所以這個指標的隨機基準線是 25%,不是 50%。論文報告三個指標:
- accuracy(嚴格準確率): 兩次都答對的題數占全部題數的比例,這是主要指標。
- mean accuracy: 把 次作答各自計分,只對一次的題也算一半,比較寬鬆。
- Average: 研究類與工程類各自算嚴格準確率後,取 1:1 平均。研究只有 112 題、工程有 390 題,但兩個領域各占一半權重,所以 Average 和用 502 題直接合併算出的數字不同。
用 GPT-5.6 Sol 驗算(見表 3):兩次都對(CC)292 題、只有第一次對(CW)25 題、只有第二次對(WC)29 題、兩次都錯(WW)156 題,加起來 502 題。直接合併的嚴格準確率是 。開頭的 59.7% 是 Average:工程 56.9%、研究 62.5%,取 1:1 平均得 。
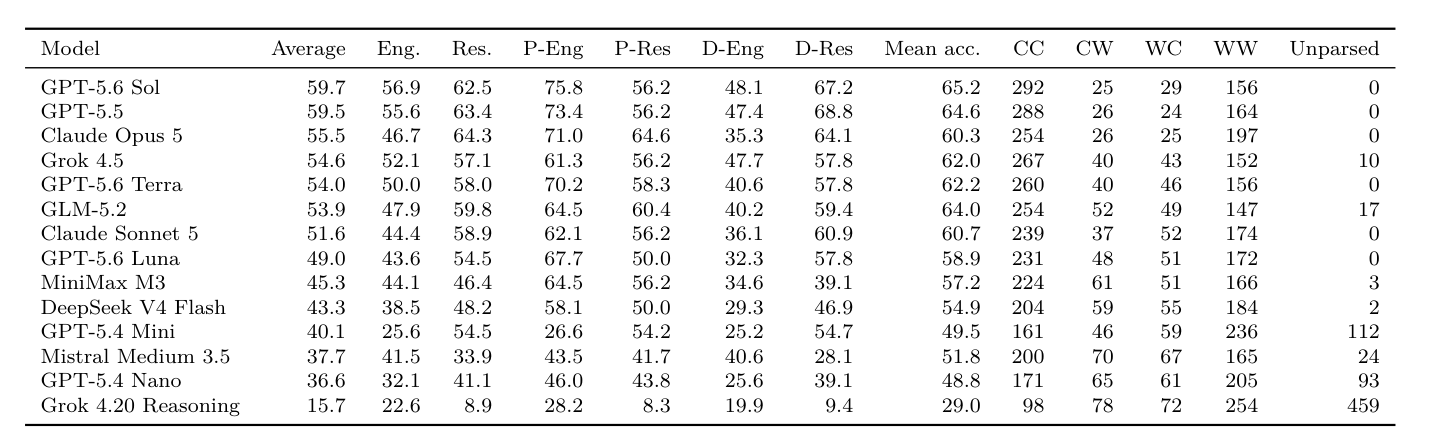
記住兩個基準:亂猜 25%,永遠選同一位置 0%;標題的 59.7% 是工程與研究各占一半的 Average。
6 前沿模型的成績:沒有一個接近解完
論文的實驗有六組。兩個訓練實驗留到後面;這一節先用一張表帶過模型成績、哪類題最難、推理預算有沒有用,再細講「決定性證據多晚才出現」對成績的影響。
6.1 總成績:最好 59.7%,繞路工程題最難
| 實驗 | 在證明什麼 | 結果 | 重點 |
|---|---|---|---|
| 14 個模型的準確率(圖 4、表 3) | 現有模型的品味有限 | 最好的 GPT-5.6 Sol 59.7%,其次 GPT-5.5 59.5%、Claude Opus 5 55.5%;隨機基準 25% | 沒有模型接近解完 |
| 構造與領域的差異 | 哪一類題最難 | 14 個模型平均:平行工程 58.1%、平行研究 50.9%、繞路研究 50.8%、繞路工程 35.9% | 構造(parallel/detour)的差距大於領域(工程/研究)的差距;繞路工程題最難 |
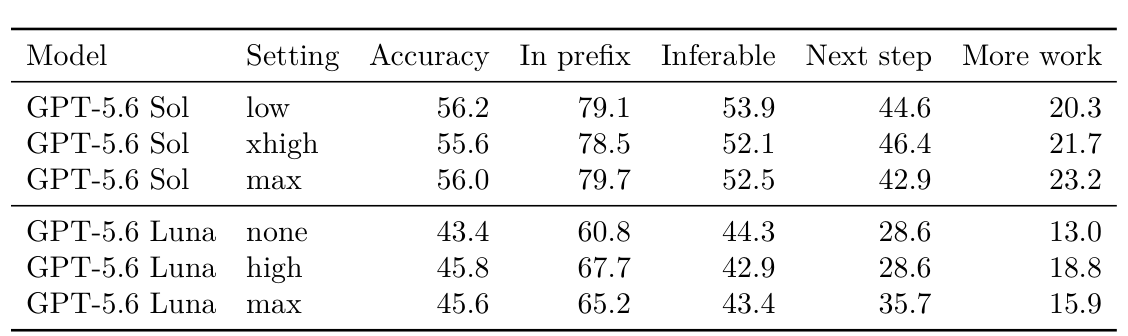
| 推理預算(圖 5 右、表 4) | 多想會不會變準 | 同一個模型把推理設定從最低開到最高:GPT-5.6 Sol 變化 點,GPT-5.6 Luna 點 | 多花推理 token 沒有明顯幫助,而且模型在最難的題上想得最久。只測了同一個家族的兩個模型 |
圖 4 是 14 個模型的成績:第一欄是 Average,之後是研究與工程子集,每欄各自由高到低排序。
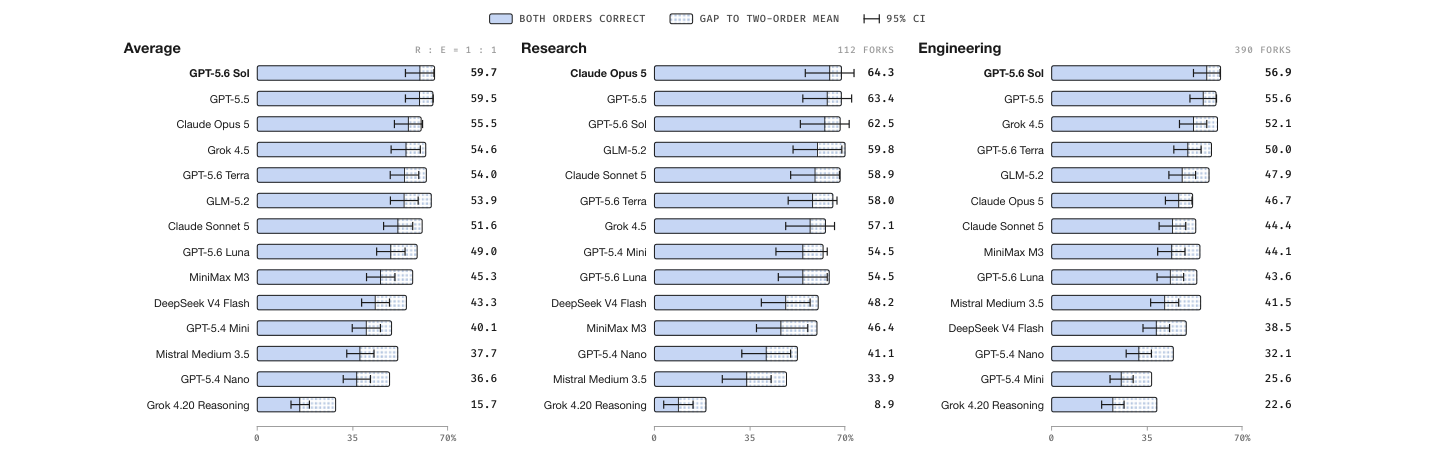
表 4 是兩個模型在三種推理強度設定下的準確率。
第一,排名後段的 Grok 4.20 Reasoning、GPT-5.4 Mini、GPT-5.4 Nano 分別有 459、112、93 次(共 1,004 次)作答無法解析而被計為答錯,分數混入了格式遵循的因素。
第二,GPT-5.6 Sol 在主實驗是 58.2%(292/502),在表 4 同設定重跑是 55.6%,差 2.6 點,論文沒有說明。我的推論:兩者都是 502 題合併的嚴格準確率,所以這個落差和上面推理預算的差異是同一個量級,解讀推理預算的結論時要記得這個噪音。
6.2 決定性證據越晚出現,越答不準
論文替每一題標註時間跨度:要看到多遠的未來,才能確定正確答案。分成四級,然後看模型在各級的準確率。標註者是 GPT-5.5:它讀題目、前綴、兩個候選,以及正確答案,判斷是哪一種證據支持這個答案。
| 等級 | 意思 | 題數 |
|---|---|---|
| in prefix(前綴內) | 前綴裡已經有決定性的事實,能直接排除一個候選(例如錯誤訊息) | 158 |
| inferable(可推得) | 沒有單一決定性事實,但前綴裡的線索合起來就足以判斷 | 219 |
| next step(下一步) | 岔路口之後的第一個觀察結果就能確定 | 56 |
| more work(更多工作) | 要做完一次本地檢查,或更長的後續工作才能確定 | 69 |
more work 是原本最高的兩級合併而成:quick local check(做完一次本地檢查才確定)56 題,加上更長後續工作才確定的最高級 13 題,共 69 題。這裡的 56 題和上一列 next step 的 56 題是不同的兩組,只是剛好同數。最高級只有 13 題,單獨拆出來樣本太少,所以合併。
結果:14 個模型的平均準確率,隨等級升高依序是 62.3%、42.9%、31.5%、21.0%,越晚才看得出答案的題越難。圖 5 左半部是這條下降的曲線,右半部是推理預算的比較;表 5 則是每個模型逐級的數字。
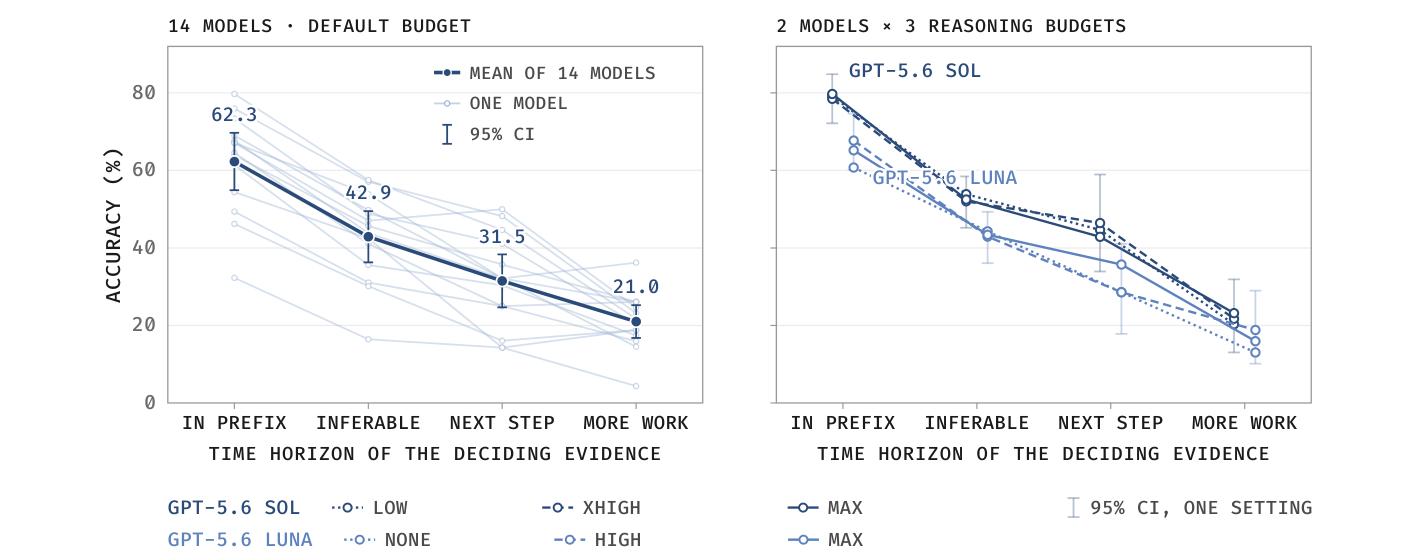
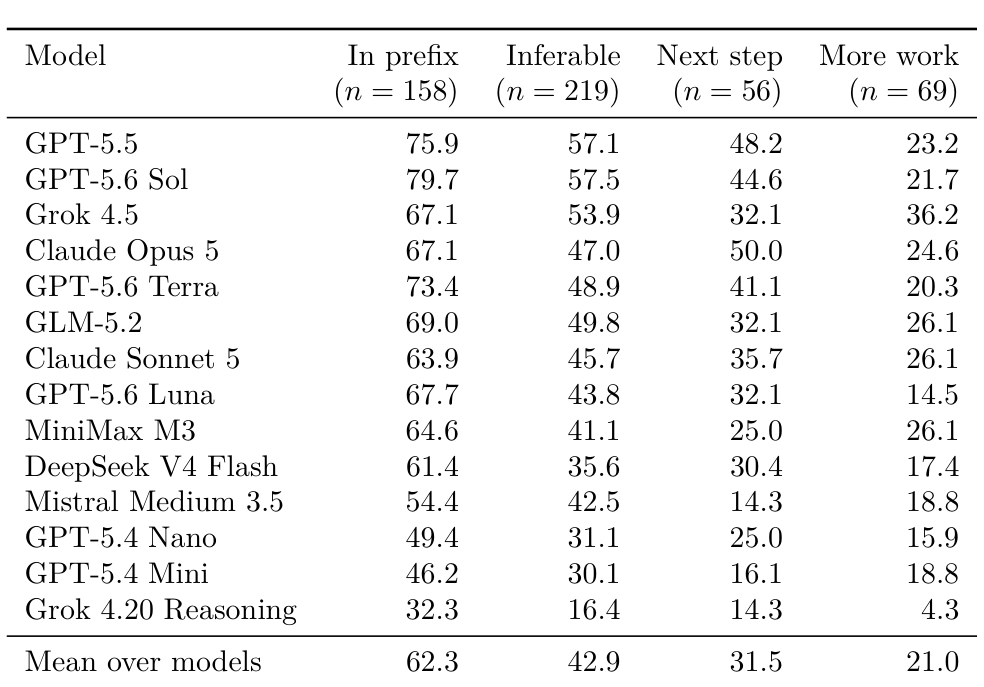
證據已經在前綴裡的題,平均答對 62.3%;要做更多工作才看得出答案的題,只剩 21.0%。證據越晚才出現,模型答得越差。
7 品味能訓練嗎:讓偷看答案的老師教學生
Taste-Bench 量出來的是「現有模型品味有限」。下一個問題是:這種品味能不能訓練?這一節講方法,結果在接下來兩節。
7.1 設定:同一個模型,老師多看一段答案
做法是讓一個「偷看過答案」的老師寫出解題推理,再訓練一個「沒看過答案」的學生,在自己的輸入下寫出同樣的推理與選擇。老師和學生是同一個模型,差別只在輸入內容。先認識幾個詞:
- 蒸餾(distillation): 讓學生模型學老師模型的輸出行為。
- privileged teacher(有特權資訊的老師): 老師的輸入裡多了學生拿不到的資訊,這裡就是正確答案。
- demonstration: 放進老師輸入的一小段文字,寫明「這個岔路口正確的做法是這個候選,要避開另一個」。
- LoRA: 不改動原模型的權重,只訓練額外加上的小型低秩矩陣(設定細節收在下方的折疊)。
- context distillation(上下文蒸餾): 把「放在輸入裡的資訊」的效果,透過訓練內化進模型權重。這是一般知識,不是論文內容;論文的做法屬於這一類。
- 訓練資料是 390 道工程題,依任務切成兩份(論文稱為 fold,各 195 題,每個 repository 兩份都有)。學生在一份上訓練、在另一份上測試,所以測試題的任務學生訓練時沒見過,這種留作測試的資料稱為 held-out。
- 基礎模型是 Qwen3.6-27B(凍結),老師與學生都是它。
- 老師的輸入是題目加 demonstration;學生的輸入是題目本身(任務、前綴、兩個打亂順序的候選),跟評測時受測模型看到的一模一樣。
- 每題 A、B 兩種順序各一筆,老師對每一筆各寫一段推理。
- 訓練目標:學生在自己的輸入下,產生老師那段推理與最後的選擇。
每題 A、B 兩種順序各一筆,稱為兩個 view。老師對每個 view 以 temperature 1.0 產生一段推理,上限 3,072 個 token;推理區塊格式正確且至少 32 個 token 才保留,而且兩個 view 都保留的題才進訓練。
LoRA 的設定是 rank 16、,約 7,970 萬個可訓練參數,在單張 A100 80GB 上每一份訓練約兩小時。
圖 6 的左半部是這個蒸餾:把「看過正確候選的老師」的推理,教給「只看到題目的學生」。訓練分兩個階段。階段一,老師看到答案後寫出推理,學生在老師寫的每個位置預測下一個字,兩邊分布的差異就是損失。階段二,學生改用自己寫的推理,只在最後的 A/B 選擇位置,對標準答案訓練。右半部會用到的是另一個固定的 agent,負責真正動手做任務,後面再細講。
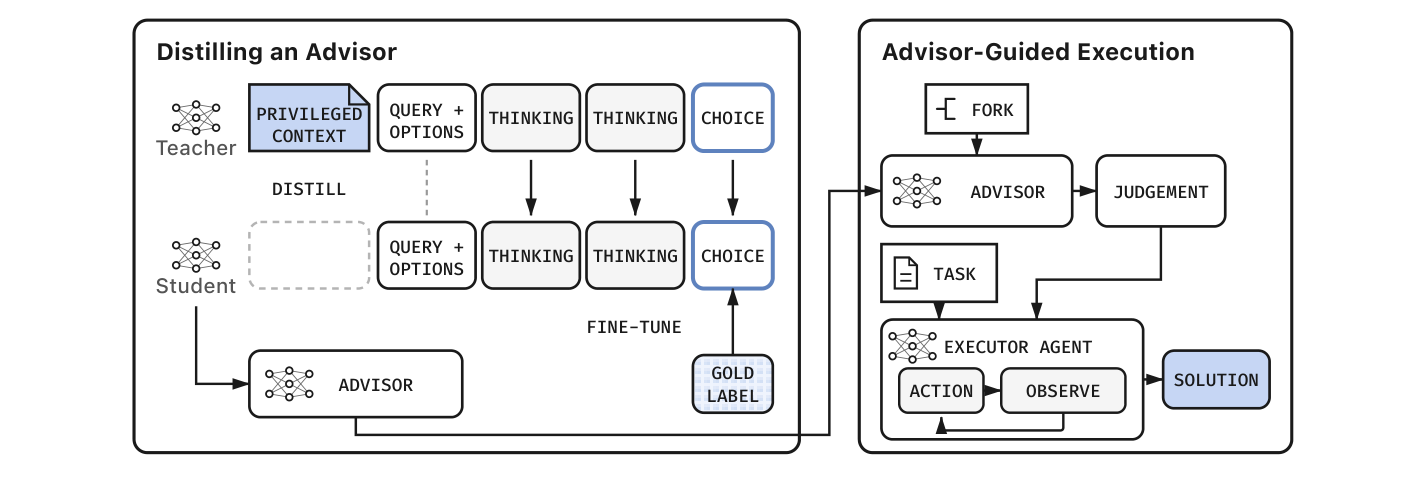
7.2 為什麼學推理、用什麼損失:forward KL
為什麼要學推理,而不是直接學標籤?每一題只有一個二選一的標籤,沒有中間推理。論文的理由是:只用標籤微調,模型會背答案而沒有學到判斷。底層道理(一般知識,不是論文內容):每個學生只用約 195 題訓練,模型卻有 270 億個參數,損失只算在一個答案 token 上時,最省力的做法是記住這題的表面特徵對應哪個答案。推理讓每題多出幾百個要擬合的 token,模型更難只靠背表面特徵降低損失。要注意,論文沒有附「只學標籤」的對照實驗,這是論文給的理由。
損失函數用的是 forward KL。KL 散度衡量兩個機率分布差多少:兩個分布完全一樣時為 0,差越多越大。在老師寫出的推理的每一個位置 ,兩邊讀同一段前文,各自預測下一個 token;兩邊的猜法差越多,損失越大,訓練就把學生的猜法拉向老師。寫成式子是:
- :推理中的第幾個位置。
- :下一個可能的 token。
- :這個位置之前已經寫出的推理內容,由老師的輸出取樣而來。
- 、:老師的輸入(題目加 demonstration)與學生的輸入(只有題目)。
- 、:老師、學生在這個位置,對每個 給的機率。
實作上為了省算力會做截斷:推理位置只在一小批 token 上算、其餘合成一格,最後的選擇位置只比 A 與 B,長推理最多抽 512 個位置。
7.3 第二階段:讓學生在自己的推理後面也選對
蒸餾完之後,論文多加了一個小步驟,稱為校準。蒸餾時,學生的最終選擇是接在「老師寫的推理」後面學的;但實際考試時,學生接的是「自己寫的推理」。校準就是讓學生在自己的推理後面也能選對:
- 學生對每道訓練題(A、B 兩種順序各一次)自己寫出推理。
- 只在最後選擇的位置,用 cross-entropy(衡量模型給正確答案多少機率的損失)對標準答案訓練,推理部分不動。
- 設定:學習率 (蒸餾的十分之一)、1 個 epoch、softmax temperature 2.0(讓機率分布變平,避免被推向極端自信),兩份分別用 306 與 320 個 view(每題的 A、B 兩種順序各算一個)。
cross-entropy 的直覺:正確答案是 A 時,模型給 A 的機率 0.55,損失 ;給 0.90,損失 。
7.4 洩漏控制,以及它擋不到的轉述
還有一個要防的事:老師的輸出是看過 demonstration 才寫出來的,如果輸出裡混了「只有看過答案才寫得出來」的內容,學生被訓練去寫這些內容,就會學成「假裝有依據,然後猜」。論文的做法稱為結構性控制:選擇限定成 A 或 B,老師的輸出到最終答案就結束,所以輸出裡沒有任何一段是照抄 demonstration 的文字。這個控制屬於第一階段(蒸餾),第二階段(校準)用的是學生自己寫的推理,沒有這個風險。
整理一下:同一個模型當老師與學生,老師多看到答案;學生先用 forward KL 學老師的推理,再在自己的推理後面校準最後的選擇。
8 蒸餾結果:沒見過的任務上,30.0% 升到 47.9%
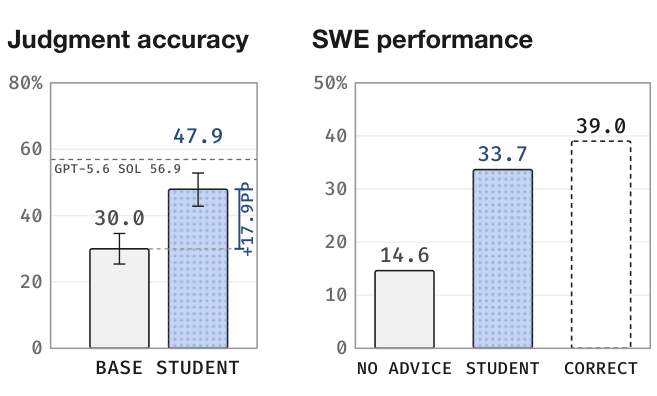
怎麼測:390 題工程題依任務切成兩份,學生在一份上訓練、在另一份上測試,兩份的結果合併成 390 題的成績。訓練那份只代表模型背得下訓練題,沒見過的那份才是證據。比較對象是沒有微調的基礎模型 Qwen3.6-27B。
| 訓練那份 | 沒見過的那份 | |
|---|---|---|
| 單一順序答對的比例 | 48.6% → 92.9% | 未報告 |
| 嚴格準確率(兩順序都對) | 未報告 | 基礎模型 30.0% → 學生 47.9% |
| 平均準確率(兩順序各算一次) | 未報告 | 42.7% → 62.4% |
用論文附錄的數字驗算:學生兩順序都對有 187 題,基礎模型有 117 題。學生對、基礎模型錯的有 104 題,反過來有 34 題,淨增 70 題, 個百分點。
學生在工程題排名上的位置:
| 對象 | 工程題準確率 | 與學生(47.9%)的關係 |
|---|---|---|
| GPT-5.6 Sol | 56.9% | 學生較低 |
| GPT-5.6 Terra | 50.0% | 學生較低 |
| GLM-5.2 | 47.9% | 相當 |
| Claude Opus 5 | 46.7% | 學生較高 |
基礎模型(30.0%)則略低於 GPT-5.4 Nano(32.1%)。
圖 7 左半部是這組蒸餾結果:在 390 題 held-out 工程題上,沿用兩個順序都對才算對的計分,蒸餾後的學生準確率高於基礎模型,虛線是 GPT-5.6 Sol 在同一批題上的 56.9%。右半部是下一節的端到端結果。
9 把學生的選擇寫成建議:executor 成功率 14.6% 升到 33.7%
學生會選了,但選對有沒有用?這一節看學生的選擇能不能讓另一個 agent 把任務做得更好。
9.1 流程:學生只做二選一,建議交給另一個 agent
學生不親自寫程式,只在每個岔路口給一則建議;另一個固定的 agent,稱為 executor(執行者),讀完建議再去做任務,看成功率有沒有提高。流程是:
- 每個 held-out 任務事先已有幾個岔路口(41 個任務共 98 個),岔路口與兩個候選的文字,是前面造題的流程從這些任務的舊執行挖出來的。
- 學生對每個岔路口選一個候選。建議由「沒有訓練過這個任務的那個學生」產生(兩份各訓練一個學生)。
- 每個岔路口寫成一則建議筆記:情境、要避開的候選、要採用的候選。
- 所有筆記放在 executor 的第一則訊息裡、問題描述之前。
- executor 獨立完成整個任務。
- 用官方 SWE-bench Pro 的測試判定 patch 是否被接受,這就是成功。
學生真正決定的只有一件事。 建議的文字(情境、候選描述)是照模板組出來的,來自 generator 在造題時寫好的內容;學生只決定「哪個候選標成要避開、哪個標成要採用」,也就是每個岔路口一個二選一。選擇的規則:把學生對兩種順序下 A、B 兩個答案 token 的 log-odds(兩個答案的機率比取對數,越正越偏向 A)加總,取總和偏向的那個候選。
每個岔路口對應一個 Decision trap 區塊;開頭固定提醒這是其他次執行的紀錄,結尾固定提醒選路線不等於驗證:
# Task-specific pitfall notes (from prior runs on this exact task)
固定開頭:這些是其他次執行的紀錄,不是你這次修改的證據;
         提交前必須自己跑相關測試或自己建一個檢查,看過實際輸出才能提交。

## Decision trap {n} [{parallel|detour}] (step {fork step})
### Situation where prior runs diverged   -> 岔路口的情境
### Known trap (this route produced a FAILING patch) -> 要避開的候選
### Route that avoided the trap in a prior run       -> 要採用的候選
固定結尾:選這條路線不等於驗證,行動後要自己產生證據。
executor 是 SWE-agent 1.1.0,模型是 Qwen3.6-27B(沒有蒸餾過,關閉 thinking,temperature 0.7),每次執行最多 75 次模型呼叫、每個指令 600 秒、總共 4,800 秒,在該任務的官方 SWE-bench Pro 容器中執行。41 個任務涵蓋 11 個 repository。
9.2 結果:拿到上限的約 78%
41 個沒見過的 SWE-bench Pro 任務、三種設定,由同一個固定的 executor(Qwen3.6-27B 加 SWE-agent)執行,成功與否由官方測試判定:
| 設定 | 建議內容 | 成功率 |
|---|---|---|
| no advice | 沒有建議 | 14.6% |
| correct advice | 每個岔路口都給正確的候選 | 39.0% |
| student advice | 給學生選的候選 | 33.7% |
正確建議對沒建議的差距是 24.4 個百分點,論文把它當作這種建議的上限。學生建議的差距是 19.1 個百分點,約達上限的 78%()。學生在這 98 個岔路口中選對 77 個(78.6%)。
9.3 兩個實驗差在哪:有沒有 executor
兩個實驗用的是同一批學生,但問的是不同的問題:
| 蒸餾遷移 | 端到端 | |
|---|---|---|
| 做的事 | 學生直接回答 Taste-Bench 的 A/B 題 | 學生的選擇寫成建議,交給 executor 去修 bug |
| 有 executor 嗎 | 沒有 | 有(Qwen3.6-27B 跑在 SWE-agent 上) |
| 衡量什麼 | 選對岔路口的比例(30.0% → 47.9%) | 任務成功率(14.6% → 33.7%) |
| 用到的測試資料 | 沒見過的那份 390 題工程題 | 41 個 held-out SWE-bench Pro 任務 |
簡單說,蒸餾遷移問「學生會不會選」,端到端問「學生選完,有沒有讓別人做得更好」。端到端每個任務的建議,都是由沒有訓練過該任務的那一個學生寫的,所以兩個實驗在「學生沒見過這個任務」這點上是一致的。
10 端到端的成功率還不能直接搬到新任務:部署缺口
這是讀這篇論文時最值得留意的地方。端到端實驗用的岔路口與候選,是事先從同一任務的舊執行挖出來的;論文原文也說,建議在新的一次執行開始前就已準備好。所以這個實驗測的是「有了現成的候選對,建議有沒有用」,不是「agent 遇到新任務時,自己判斷」。把整條流程拆開來看:
| 步驟 | 論文有測嗎 |
|---|---|
| 學生對一道已經寫好的 A/B 題做選擇 | 有(沒見過的任務上 47.9%) |
| 偵測「現在是不是岔路口」 | 沒測 |
| 自己列出兩個措辭平行的候選 | 沒測 |
| 把選擇寫成建議交給 executor | 有 |
新任務沒有舊執行,所以「找岔路口、寫候選」這兩步在實際使用時要由 agent 自己完成,而這兩步論文都沒驗證。我的推論是,真實的候選不會像 Taste-Bench 那樣被整理成乾淨的平行措辭,這兩步各自也會出錯。另外,這 41 個任務都是「至少挖出一個岔路口」的任務,等於只挑了確實有決策分歧的任務。
11 評價與值得帶走的東西
先給整體評價,再談值得帶走的東西。帶走的分兩類:這篇論文本身的貢獻(很少),以及讀它的過程中學到、脫離它也成立的觀念,後者通常才是真正的收穫。
11.1 值得肯定的,以及研究與工程上的價值
- 用既有軌跡的結果當免費標籤。 同一任務的多次嘗試在中途分歧,最終結果就是答案,不需要專家標註,題庫還會隨著 agent 系統產出的軌跡一起長大。這個想法簡單、可搬、站得住。
- 兩種造題法互補,而且分開統計。 parallel 抓 agent 沒發現的錯,detour 抓 agent 自己改正的錯。讀者看得到兩者的難度差異,不是被混成一個平均數。
- 標籤品質有人工驗證。 人工審查與自動標籤的一致率是 98.8%,雖然是看過結果之後的判斷,但至少排除了標籤明顯標錯的疑慮。
研究上,這篇的新意不高:用結果標註中途決策,是 process reward(用後續把任務跑完的結果,也就是 rollout,來評每一步)這條線的延伸;蒸餾部分是 context distillation 的變體。新的是把這些東西套到 agent 長任務的岔路口,並且給出一套可複製的造題流程。
工程上,價值集中在造題那一塊。如果手上有同一個任務的多次執行紀錄與結果,這套「挖岔路口、寫平行候選、再過濾」的流程,可以直接拿來參考,當成評測 agent 決策能力的資料來源。蒸餾與建議注入這一塊,顯示「把看過結果的判斷內化」是可行的方向,但還沒有證明能部署在新任務上。
11.2 帶走一(論文本身的貢獻):造題配方
論文本身只有一項值得帶走:造題配方,也就是怎麼從 agent 已經跑過的軌跡,免費造出「決策品質」的評測題。它成立的理由是:單一軌跡的結果混了判斷、執行品質與環境,看不出是不是判斷造成的;但同一個任務的兩次嘗試,如果在中途分歧之前完全相同,結果的差異就主要來自分歧點的那個決定,所以「誰的結果好」可以當成「這個決定好不好」的標籤。這個推論不依賴特定模型,也不依賴特定領域,所以耐久。需要的原料有三樣:
- 同一個任務的多次執行紀錄。
- 每次執行一個可信的結果訊號(測試通過與否、評分)。
- 一個能讀完整軌跡的 generator 模型。
下面的虛擬碼對應前面的兩種造題法與三道關卡,程式內的中文註解說明每一道在擋什麼:
def build_taste_questions(runs_by_task, generator, judges):
    candidates = []
    for task, runs in runs_by_task.items():
        # 來源 A:平行軌跡,同任務、一成一敗配成一對
        for good, bad in pair_opposite_outcomes(runs):
            candidates.append(generator.find_fork(task, good, bad))
        # 來源 B:繞路軌跡,單次執行中「選 X -> 碰壁 -> 改選 Y -> 成功」
        for run in runs:
            candidates.append(generator.find_detour(task, run))

    # 第 1 道:generator 依 rubric 自己丟掉證據不乾淨的候選(大半被丟)
    qs = [c for c in candidates if c is not None and c.passes_rubric]

    # 第 2 道:太簡單的丟掉,只看兩個候選的措辭,若所有裁判都答對,就沒測到判斷
    qs = [q for q in qs
          if not all(j.choose(q.cands) == q.label for j in judges)]

    # 第 3 道:無法判定的丟掉,看完整紀錄,只要有裁判不同意標籤就丟
    qs = [q for q in qs
          if all(j.choose(q.cands, full_record=q.record) == q.label for j in judges)]
    return qs
實務上要預期的產出率:論文從 4,657 個候選只留下 502 題(10.8%),所以要準備大約十倍的候選量。裁判不能包含 generator 本身。造題時最容易犯的錯,generator 的規則已經寫出對策:結果差異其實來自打錯字、當機或運氣;較好的方向只有看到失敗之後才說得出來;兩個候選有一個是稻草人;措辭洩漏了答案。
11.3 帶走二(脫離論文也成立):二選一的評測要對調順序考兩次
LLM 做二選一時有 position bias。如果只考一次,一個永遠回答「A」的模型,在 A、B 各半的題庫上會得到 50%,而這個 50% 完全不代表它有判斷力。偏誤只有部分的模型也一樣,分數裡混了「碰巧順序對自己有利」的成分。做法是每題考兩次,第二次把兩個選項的順序完全對調,兩次都答對才算對:
def strict_accuracy(model, questions):
    correct = 0
    for q in questions:
        a1 = model(q.task, q.prefix, first=q.cand_x, second=q.cand_y)  # 順序一
        a2 = model(q.task, q.prefix, first=q.cand_y, second=q.cand_x)  # 順序二,完全反過來
        ok1 = (a1 == slot_of(q.label, order=1))
        ok2 = (a2 == slot_of(q.label, order=2))
        correct += (ok1 and ok2)     # 兩次都對才算
return correct / len(questions)- 隨機基準與「永遠選同一個位置」的得分都會下修,分別是 25% 與 0%(見前面的評分方式一節)。
- 答案會隨順序翻轉的題,不算作有品味。
- 用論文的數字看效果:GPT-5.6 Sol 只對一次的 題(10.8%)答案會隨順序改變,單考一次這些題會有一半被算成答對,嚴格計分把它們全部排除。
代價是推論成本加倍,分數會比習慣的數字低;可以另外報告「兩次作答各自計分」的較寬鬆版本,兩個數字的差距本身就反映模型對位置的敏感度。任何兩兩比較的 LLM 評審(pairwise judge、A/B 偏好評測)都可以套用。
11.4 帶走三(脫離論文也成立):forward KL 截斷時保留老師的前 K 名
回到蒸餾一節留下的問題。蒸餾時,學生要靠近老師的下一個 token 機率分布。詞表有十幾萬個 token,逐一算 KL 太貴,所以實作會截斷:只保留一部分 token,其餘合併成一格「其他」。問題是:保留誰的前 K 名?關鍵在於 forward KL 是以老師的機率加權的:
每一項都乘上 。老師給的機率很小的 token,貢獻幾乎是 0,可以安全地捨棄;老師給的機率高的 token,才是損失的主要來源。(一般知識:reverse KL 是以學生的機率加權,那種情況下保留學生的前 K 名才是自然的做法。)
論文取的卻是學生的前 100 名,加上一格「其他」。如果老師想要的 token 不在學生的前 100 名(學生給它很低的機率),這個 token 就被併進「其他」,學生只被告知「榜外該多給一點機率」,不知道是哪個 token。
| token | 學生 | 老師 |
|---|---|---|
| 甲 | 0.5 | 0.2 |
| 乙 | 0.3 | 0.1 |
| 丁 | 0.01 | 0.6 |
| 其他 | 0.19 | 0.1 |
- 用學生的前 2 名(甲、乙)分格,丁被併進「其他」(學生 0.20、老師 0.70):KL 。
- 用老師的前 3 名(丁、甲、乙)分格,丁自己一格:KL 。因為這個例子的 token 已經全部列出,2.10 就是不截斷的完整 KL。
也就是說,在這個例子裡,用學生的前 K 名分格,在老師最在意的 token 上把損失低估了 3.6 倍;而且梯度指向的是整個「其他」,不是丁。我的推論:梯度會把所有榜外 token 依各自目前的機率比例一起抬高,老師想要的 token 本來機率就小,被抬高的幅度也小,所以學得慢。
判斷規則(我的判斷,論文沒有對照實驗):截斷時,保留「加權那一方」的高機率項。
| KL 的方向 | 加權的分布 | 截斷時保留誰的前 K 名 |
|---|---|---|
| forward KL(以老師為目標) | 老師的前 K 名 | |
| reverse KL | 學生的前 K 名 | |
| 不確定、想保險 | 無 | 兩邊前 K 名的聯集,再加一格「其他」 |
論文取學生前 100 名的原因沒有交代;一個合理的猜測是,訓練時學生的 logits 本來就在手上,直接取它的前 100 名實作最簡單。這個猜測是我的推論,不是論文寫的。兩邊格子怎麼對齊的細節,見文末概念詳解的第三段。
11.5 一句話總結
這篇論文的核心想法很簡單:同一個任務的多次嘗試,在中途分歧之前完全相同,最後的結果就是岔路口那個決策的標籤。靠這個,論文作者從 4,657 個候選裡過濾出 502 題 Taste-Bench,14 個前沿模型最高只有 59.7%,而且決定性證據出現得越晚,模型越答不準。
蒸餾與端到端的結果(30.0% 到 47.9%、14.6% 到 33.7%)是正面的方向性訊號,但端到端用的是事先挖好的岔路口,所以還不能當作可以直接用在新任務上的證據。
下次手上有一批 agent 跑過的執行紀錄,可以試著從裡面挖幾個岔路口出來考考自己的模型;下次做 A/B 評測,記得把順序對調再考一次;下次看到「學生建議讓成功率大增」這類結果,先問一句:岔路口是誰找出來的?
12 概念詳解
以下四段是最容易混淆、也最容易忘的觀念。每一段都寫成脫離這篇論文也能獨立閱讀,想複習時可以直接跳讀。
12.1 parallel 與 detour 也決定了標籤怎麼來
結論:parallel 與 detour 不只是「樣本從哪裡來」,它們同時決定了「這題的答案是怎麼得到的」。 從 agent 軌跡造「決策品質」的評測題,有這兩種原料,差別前面「兩種挖岔路口的方法」已經講過,這裡只補它們怎麼決定標籤,以及這為什麼影響可信度。
| 標籤怎麼來 | 有沒有對照 | 抓到的錯誤 | |
|---|---|---|---|
| parallel | 兩條分支最終結果的比較,結果較好的那條,它的方向就是答案 | 有:兩條分支在岔路口之前完全相同,是真正的對照 | agent 一路沒發現的錯誤 |
| detour | 單次執行裡「選了方向 X、碰壁、改走方向 Y、成功」的經過:被放棄的方向產生了可觀察的失敗,改正的方向完成了任務 | 沒有另一條平行的分支可以對照 | agent 後來自己發現並改正的錯誤 |
在 Taste-Bench 裡,parallel 有 172 題,detour 有 330 題(分格題數見前面的四格表)。論文把兩種分開統計,因為難度差很多:構造方式造成的差距,比領域造成的差距更大,繞路工程題最難(各格的準確率見前面的總成績表)。
為什麼難度差這麼多?我的推論:parallel 測的是「兩條分支裡誰的方向比較好」,兩條路都是 agent 真的走完的;detour 測的是「能不能比當時行動的 agent 更早看出這個方向會失敗」,這需要預見後果,而不是比較兩個結果。
換到別的情境:任何從日誌挖評測題的做法,都會碰到同一個選擇。用「兩次不同的執行」構成反事實對照,還是用「一次執行裡的自我修正」?前者標籤更可靠;後者資料量更大,但也比較容易碰上「事後諸葛」的風險。
12.2 怎麼讀人工審查的一致率
結論:論文報了兩組不同的比較。人和自動標籤很像(98.8%),人和人也很像(98.6%,),兩者都成立。 可以想成兩位老師拿同一份考卷,對照標準答案批改。
設定。 兩位審查員各自看 100 道題。每題先選自己會選哪個方向;再看後續過程與結果的摘要,回答「哪個決策比較好」,選項是 A、B、或「兩者差不多/選擇無法解釋結果差異」。分析只用第二階段的回答,而且排除沒有明確 A/B 偏好的回答。
比較 1:人對標籤。 每位審查員的明確 A/B 判斷,各自拿去跟自動標籤比對(數字見前面的表 2):
| 有明確 A/B 的判斷數 | 與標籤一致 | |
|---|---|---|
| 審查員 1 | 87 | 86(98.9%) |
| 審查員 2 | 85 | 84(98.8%) |
| 合計 | 172 | 170(98.8%) |
兩位審查員幾乎每一題的選擇,都和自動標籤一樣。比較 2:人對人。 這次不看標籤,只看兩位審查員彼此。兩人都有明確 A/B 選擇的題只有 74 題,其中 73 題兩人選的一樣(98.6%)。
為什麼分母是 172 和 74,不是同一個數字? 172 是「判斷的次數」(),也就是每位審查員保留下來的判斷加總。每位審查員都有些題回答「兩者差不多」而被排除。要比較兩個人,必須是兩人在同一題都有明確選擇,所以只剩 74 題。
是什麼。 Cohen’s kappa 回答的還是比較 2 的問題:兩位評分者的一致程度,並扣掉「碰巧選一樣」的部分。選項只有 A、B 時,兩人亂猜也有大約 50% 會一樣,所以 比單純的一致率更嚴格。它等於「實際一致率比碰巧一致率多出多少」,除以「最多還能多出多少」:
- :實際觀察到的一致率。
- :如果兩人各自隨機選,預期會碰巧一致的比例。
- 分母 :扣掉碰巧一致之後,最多還能多出多少。
- 代表完全一致, 代表跟亂猜一樣。
驗算:。A、B 大致各半時 ,所以 ,和論文報的一致。
這組數字驗證了什麼、沒驗證什麼。 審查員是看過結果之後才判斷的(第二階段),所以 98.8% 驗證的是「自動標籤和記錄下來的結果對得上」,等於一致性檢查。它沒有驗證「這個決策真的是造成結果差異的原因」,也沒有驗證「這一題在決策當下真的答得出來」。另外,審查員第一階段(看到結果之前)的選擇,等於人類在這個任務上的準確率,可以拿來跟模型比較;論文正文沒有報告這個數字。
可遷移的觀念。 用 LLM 自動產生標籤的資料集,品質檢查要把「人對標籤」和「人對人」兩件事分開報告:前者回答標籤是否可信,後者回答這個任務本身有沒有清楚的答案。
12.3 forward KL 在實作時怎麼截斷
一句話:KL 要對詞表裡每個 token 加總,太貴,所以實作時只在一小批 token 上算,其餘的合成一格「其他」,機率總和仍是 1,沒有被丟掉。 背景(一般知識):語言模型在每個位置,要對詞表裡每一個 token(常見是十幾萬個)都給一個機率,而蒸餾一節的損失公式要對所有 加總:
- 、:老師、學生在這個位置給 token 的機率。
- 加總範圍:整個詞表。
對每個位置、每個訓練 view 都算一次,記憶體與計算量都很大,所以論文做了四個簡化。第一,推理位置:前 100 名加一格「其他」。 取學生機率最高的 100 個 token;其他幾萬個 token 的機率全部加起來,當作第 101 格「其他」;在這 101 格上算 KL。這樣算得便宜,機率總和也還是 1。論文原文只說「student 的前 100 名加一格剩餘機率」,沒有說老師那一邊怎麼處理。
我的推論:KL 是逐格比較「老師給這一格多少、學生給這一格多少」,兩邊的格子必須一樣才比得了,所以合理的做法是老師的分布也在同樣這 100 個 token 上讀出機率,剩下的也加總成「其他」。這是推論,不是論文明講的。
- 第二,最後的選擇位置:只比 A 和 B。 模型最後輸出
{"answer":"A"},在 A/B 這個位置只有兩格。自編例子:老師 、,學生 、,損失 。 - 第三,總損失。 推理位置的 KL 與選擇位置的 KL 各乘以 1,再相加。
- 第四,長推理要抽樣。 老師的推理最長可到 3,072 個 token,全部位置都算太吃記憶體,所以平均挑最多 512 個位置來算。
- 三個 token 的完整算例,見前面蒸餾一節的損失函數說明。
為什麼截斷也能接受。 forward KL 以老師的機率加權,老師機率很小的 token 貢獻幾乎是 0,所以只要保留的格子涵蓋了老師真正在意的 token,截斷損失得不多。問題出在「保留誰的前 100 名」,見前面的帶走三。
12.4 KL 要在誰寫的文字上算
重點:「學生要模仿誰」和「在誰寫的那段文字上比較」是兩件不同的事。學生模仿的對象永遠是老師;論文選擇用老師寫的文字當比較的現場。
先釐清 KL 需要什麼:KL 要先有一段已經寫好的文字。在這段文字的每個位置,兩個模型各自讀同一段前文,預測下一個 token,再比較兩個預測差多少。所以必須先決定:拿誰寫的文字來比?常見的說法「因為要學老師,所以以老師為主」把兩件事混在一起,只對了一半:
- 模仿誰? 一直是老師。公式裡每一項都乘上老師的機率 ,所以無論用哪段文字,學生都在靠近老師。
- 用誰寫的文字當現場? 這才是問題所在,答案有兩種選擇。
選擇 A(論文的做法):用老師寫的文字。 自編例子,回到 Ansible 那題,老師看過 demonstration,寫道:「保持 helper 的預設輸出不變,既有測試才不會壞,所以選 A。」寫到「既有測試會壞」這個關鍵洞見的位置,老師已知答案,預測機率高;學生沒看過答案,機率低。差距大,損失大,學生被推著去學「該想到這一點」。寫到「所以選」的位置,老師預測 A 是 0.95,學生只有 0.55,同樣差距大。用老師的文字,等於一路帶著學生走過老師的思路,每一步問:「換你,下一個字會寫什麼?」
選擇 B:用學生自己寫的文字。 學生不知道答案,寫出來的比較籠統,例如「兩個方案都合理,B 比較完整……」。這段文字裡,老師和學生對大多數位置的預測差不多,損失很小。真正有差別的那些關鍵洞見,學生根本沒寫出來,所以沒有任何位置可以拿來比較。
論文的理由,翻成白話:兩邊的輸入只差在 demonstration,真正預測不同的 token,只出現在老師的輸出裡。學生自己的樣本很少產生這些 token,在學生的文字上算 KL,就抓不到老師的偏好。簡單說:學生想不到的洞見,不會出現在它自己的文字裡,也就沒有東西可以教它。
- 這個做法接近一般監督式微調的 teacher forcing:把「正確的前文」餵給模型,只看它預測下一個字準不準(一般知識)。
- 在學生自己的取樣上算 KL,是 on-policy distillation(在學生自己的輸出上蒸餾)的標準做法。論文刻意不照那樣做,並且把理由寫在附錄;論文沒有提供改用學生文字的對照實驗。
一般化來看。 蒸餾時如果老師與學生的差異來自「老師多看到的資訊」,就要在老師的軌跡上比較,因為只有在老師的軌跡上,那些資訊的影響才會顯現;在學生自己的軌跡上,學生永遠走不到那裡。